위키를 만들고 나니, 이번엔 "검색 결과를 믿어도 되나"가 문제였다
2026.06.08
지난 글 ▶ 「여러 봇이 같이 보는 위키를 만들었더니, 매번 똑같은 설명을 안 해도 됐다」 의 다음 이야기입니다.
한 줄 요약
봇 공유 위키를 만들어 운영해보니, 다음 벽은 "어떻게 찾고, 찾은 걸 믿을 것인가" 였다. 검색 결과를 정답처럼 쓰지 않고 후보를 찾고 → 원문을 읽고 → 위키에 검증해 남기는 흐름으로 정리했고, 이번 주엔 그 위에 의미 검색층(OpenViking)을 로컬로 직접 깔아 같은 질문에 검색 종류별로 어떻게 다른지 실측까지 해봤다.
0. 지난 이야기에서 이어서
지난번에 여러 봇이 똑같이 참조하는 공유 위키(LLMWiki) 를 만들었다. "한 군데만 보면 다 같은 답이 나오게" 하는 게 목표였고, 작게 시작해 운영 규칙(SCHEMA)을 v0.1 → v0.2로 키웠다.
그런데 자료가 쌓이자 새 문제가 생겼다. 저장은 됐는데 막상 찾아서 쓰는 단계에서 사고가 났다. 그래서 지난 글의 마지막 교훈("위키의 가치는 작성보다 유지보수에서 나온다")을 한 발 더 밀어붙여야 했다. 이번 주제는 그 유지보수의 핵심 = 검색과 검증이다.
1. 새로 부딪힌 문제 — 검색 결과를 그냥 믿었다가 데였다
가장 크게 데인 건 봇이(그리고 가끔은 나도) "내 기억/검색에 없으니 그건 없는 일" 이라고 단정해버리는 순간이었다. 실제로 "그건 안 한 작업"이라고 자신 있게 답했다가, 막상 폴더를 뒤져보니 멀쩡히 있었던 적이 있었다.
핵심은 이거였다: 검색에서 안 나온다 ≠ 존재하지 않는다. 한 번 검색해보고 결과(또는 결과 없음)를 결론처럼 써버리면, 그럴듯하지만 틀린 답이 만들어진다. 그래서 운영 규칙에 한 줄을 못 박았다 — "없다 / 안 했다 / 못 한다" 같은 단정은 반드시 직접 찾아본 뒤에만 한다.
2. "찾기"와 "믿기"를 분리했다
핵심 전환은 이거였다: 검색에 걸렸다고 정답이 아니다. 검색 결과는 일단 후보다. 그래서 흐름을 나눴다.
후보 찾기 — 검색으로 "이쯤에 있을 것 같은" 문서를 건진다.
원문 읽기 — 후보를 곧장 믿지 않고, 실제 원문을 열어 확인한다.
검증 버퍼를 거쳐 남기기 — 확인된 것만 정본으로 승격한다.
3번이 이번에 또렷해진 부분이다. 쿼리해서 얻은 답을 바로 위키 본문에 붓지 않고, 먼저 임시 보관함(queries/)에 출처·확신도와 함께 적어둔다. 거기서 검증을 통과한 것만 확정 폴더(decisions/, 도메인 폴더)로 올린다. "질문해서 찾은 것"과 "확정된 사실"을 폴더 단위로 분리한 것이다. 위키 형식으로도 강제했다.
정리 문서엔
confidence: high / medium / low를 단다. 여러 근거로 확인된 것만high.단일 출처나 추론은 본문에
확인 필요 / 가설로 표시한다.마지막 도장은 사람이 — "AI가 후보를 모아주면, '이게 정본이다'는 사람이 결정한다." 찾는 건 봇이 잘하지만, 믿어도 되는지의 판단은 사람이 쥔다.
"찾기는 봇, 믿기는 사람" — 이게 이번 주차에 가장 크게 남은 원칙이다.
3. 질문이 다시 위키를 키운다
한 번 헤맨 질문은 두 번 헤매지 않게 했다. queries/ 폴더에 "그거 어딨지 / 뭐였지 / 언제였지"의 답을 찾으면 그 자리에 박아둔다. 다음에 같은 걸 찾을 땐 검색을 다시 돌릴 필요 없이 그 문서만 열면 된다. 못 읽은 자료는 정직하게 status: 목록만 확인 / 본문 미열람, confidence: medium으로 남긴다. 모르는 걸 안다고 쓰지 않는 게 위키가 썩지 않는 비결이었다.
4. 이번 주 실제로 한 것 — 의미 검색층을 로컬로 깔았다
지금까지 "찾기"는 이름·키워드 검색(정확히 일치하는 단어 찾기)에 의존했다. 약점은 분명했다: 단어가 조금만 달라도 못 찾는다. "인건비"라고 저장돼 있는데 "월급 얼마"라고 물으면 헛친다. 그래서 의미가 비슷하면 찾아주는 의미 검색(임베딩 기반) 층을 붙였다 — 오픈소스 컨텍스트 DB OpenViking.
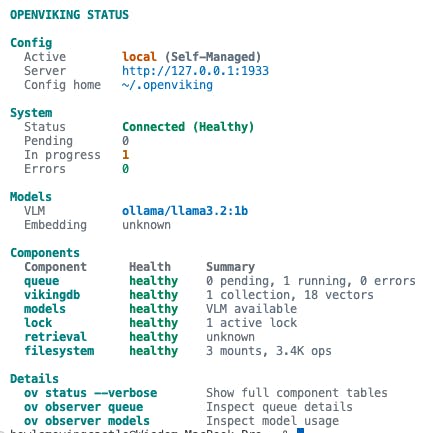
가장 신경 쓴 건 거버넌스였다. 우리 위키엔 조직·예산 기준·계약 규칙 같은 회사 핵심 지식이 들어있다. 이걸 외부 클라우드에 임베딩하려 보내면 회사 지식이 통째로 밖으로 나간다. 그래서 임베딩 모델을 로컬(Ollama)로 돌려 데이터가 한 줄도 외부로 나가지 않게 구성했다. 클라우드 API 키 없이, 노트북 안에서 전부 도는 형태다.
5. 실측 — 같은 질문, 검색 종류별로 이렇게 다르다
위키를 의미 검색층에 넣고(20개 문서), 질문 하나로 직접 비교했다. 질문: "직원 한 명 더 뽑으면 인건비 예산을 얼마로 잡지?" (위키엔 '인건비 단가 표준'이라는 제목으로 저장 — 질문과 단어가 거의 안 겹친다.)
정확 검색(키워드 "인건비"): 즉시 9곳 매치, 정확히 그 정본 문서를 가리켰다. → 단어가 그대로 있으면 압도적으로 빠르고 정확.
의미 검색(자연어 질문): 결과 없음. → 솔직한 결과다. 한국어 + 가벼운 로컬 임베딩 조합에서는 의미 검색이 약했다. 이건 스터디 자료도 예고한 한계("한국어↔영어 교차 검색은 보강 필요")와 정확히 일치했다.
원문 확인: 정확 검색이 가리킨 문서를 직접 열어 실제 기준값을 확인했다. (검색 결과를 그냥 믿지 않고 원문을 읽는 단계.)
최종 판단: 그 문서엔
confidence: high와 함께 "이 값은 추정 기준이며 외부 공식 문서엔 그대로 박지 말 것" 이라는 경고까지 적혀 있었다. 그래서 "정본으로 채택하되, 외부엔 그대로 쓰지 않는다"로 결론냈다. 검색이 찾아준 것(hit)을 넘어, 원문의 단서까지 읽고 판단한 것이다.
배운 점: 검색 종류마다 잘하는 질문이 다르다. 이름·용어가 정확하면 키워드 검색, 말이 바뀐 개념 질문이면 의미 검색 — 하나로 다 처리하려 하면 한쪽이 샌다. 그리고 검색을 더 깐다고 무조건 좋아지지 않는다. 의미 검색은 임베딩 모델·언어 궁합이 받쳐줘야 한다는 걸 직접 확인했다.
6. 검색층을 늘려도, 정본의 권한은 따로다
의미 검색층을 붙이면서 원칙을 하나 더 분명히 했다: 검색층은 "후보를 넓혀주는 보조"일 뿐, 정본에 직접 쓰는 권한은 없다. 의미 검색이 무언가를 찾아줘도 그건 읽어볼 후보이고, 위키 본문(정본)에 반영하려면 사람 검증을 거쳐야 한다. 이건 평소 우리가 봇 권한을 다루는 방식(레이어마다 권한을 나누고, 민감한 판단은 기본적으로 사람에게)과 같은 철학이다. 검색이 강해진다고 판단 권한까지 검색에 넘기지 않는다.
배운 점
검색에 안 나온다 ≠ 없는 일. 단정하기 전에 직접 찾아본다.
검색 hit는 후보지 정답이 아니다. "찾기"와 "믿기"를 분리하니 그럴듯한 오답이 확 줄었다.
검색은 만능이 아니다. 이름으로 찾기 / 의미로 찾기는 잘하는 구간이 다르고, 의미 검색은 언어·모델 궁합을 탄다(직접 실측).
회사 지식엔 거버넌스가 먼저다. 편하다고 외부로 보내지 않고, 로컬로 돌려 데이터를 안 내보내는 선택을 했다.
위키는 질문을 받을 때마다 자란다. 한 번 헤맨 걸 답으로 남기는 루프가 검색보다 강했다.
로그인하고 댓글을 남겨 주세요

저는 이 글에서 제일 중요한 장면이 “의미 검색이 안 됐다”가 아니라, 학습자료에서 예고했던 의미 검색의 약점이 실제 회사 위키 질문에서 재현된 순간이라고 봤어요. 한글 질의, 도메인 용어, 문서 제목과 질문 표현의 차이, 로컬 임베딩 모델의 언어 궁합 때문에 의미 검색이 기대처럼 안 뜰 수 있다는 이야기가 그냥 이론으로 남지 않고, “직원 한 명 더 뽑으면 인건비 예산을 얼마로 잡지?”라는 실제 질문에서 확인된 거니까요.
그래서 오히려 이번 결과는 실패 기록이라기보다 좋은 검증 로그에 가까워 보였습니다. 키워드 검색은 “인건비”라는 단어를 통해 정본 문서를 바로 잡았고, 의미 검색은 같은 의도를 가진 자연어 질문을 못 잡았습니다. 이 대비가 선명해서, OpenViking을 붙였다는 사실보다 “검색 방식마다 잘하는 구간과 놓치는 구간이 다르다”는 운영 기준이 생긴 점이 더 의미 있어 보였어요. 특히 수업에서 다뤘던 한계를 실제 데이터에서 다시 만난 장면이라, 다음 실험의 기준점으로 쓰기 좋겠다는 생각이 들었습니다.
queries/와 decisions/를 나눈 구조도 이 관점에서 더 중요하게 느껴졌습니다. 검색 결과를 바로 정본으로 넣지 않고, queries/에 출처·confidence·본문 미열람 여부를 남긴 뒤 원문 확인을 거쳐 decisions/나 도메인 폴더로 승격하는 흐름이 있으니, 검색 실패도 그냥 사라지지 않고 다음 평가 데이터로 남을 수 있겠더라고요. “찾기는 봇, 믿기는 사람”이라는 문장이 선언으로 끝나지 않고, 실제 폴더와 상태값으로 구현된 점이 좋았습니다.
다음에는 “잘 찾아야 하는 질문”만 모으기보다, 이번처럼 못 찾을 수 있다고 예상되는 질문도 같이 평가 세트에 넣어보시면 좋을 것 같습니다. 예를 들면 기대 정본, 키워드 검색 결과, 의미 검색 결과, hybrid retrieval 결과, confidence 판단, 최종 채택 여부를 한 줄씩 남기는 방식입니다. 그러면 검색 성능 개선이 감으로 좋아지는 게 아니라, 학습자료에서 예고한 한계가 실제로 줄었는지 확인하는 작은 검색 평가표가 될 것 같아요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


쿼리해서 얻은 답을 바로 위키 본문에 붓지 않고, 먼저 임시 보관함(queries/)에 출처·확신도와 함께 적어두고 거기서 검증을 통과한 것만 확정 폴더(decisions/, 도메인 폴더)로 올리는 프로세스가 위키의 신뢰도를 매우 향상시키는 핵심인 것 같습니다. 여기서 인사이트를 얻고 갑니다.