자료수집 '자동화'부터 동향파악 '파이프라인'까지 — Claude Code와 이틀간의 대화 기록
2026.03.30
1. 소개
시도하고자 했던 것과 그 이유
관심 분야의 동향을 파악하려면 3일(약 17.5시간)이 걸렸습니다. 유튜브, 웹페이지, 뉴스를 일일이 돌아다니며 자료를 찾고, 비교 정리하고, 팩트를 검증하는 데 대부분의 시간을 소비했습니다. 조사한 자료는 있는데 정리가 안 된 상태로 마감을 맞이하는 일이 반복됐습니다.
문제는 하나가 아니었습니다. 수집한 자료 자체도 체계가 없었습니다. 유튜브에서 본 영상 메모는 inbox에, 뉴스 기사 링크는 브라우저 북마크에, PDF는 다운로드 폴더에 — 나중에 다시 찾으려면 또 시간이 걸렸습니다. "보고 흘려보내는 정보"를 "축적되는 자산"으로 바꾸고 싶었습니다.
GPTers 20기 학습자료에서 "출처주의" 개념을 접한 것이 전환점이었습니다. "내가 만든 지식"과 "외부에서 가져온 자료"를 분리해야 한다는 원칙인데, 이 한 문장이 이틀간의 작업을 촉발했습니다.
Day 1: 외부 자료를 체계적으로 수집하는 인프라 구축 (폴더 5개 + 커맨드 5개)
Day 2: 그 인프라 위에 자료조사 전체를 자동화하는 파이프라인 구축 (커맨드 4개 + Agent 4개)
2. 진행 방법
1) Day 1: 수집 인프라 구축 — "출처주의"에서 5개 슬래시 커맨드까지
설계 과정
GPTers 학습자료의 시스템 아키텍처 문서를 분석하면서, 내 워크스페이스에 맞는 구조를 설계했습니다. 처음에는 기존 50-resources 폴더 안에 넣으려 했는데, 70번대가 비어있어서 독립 폴더로 결정했습니다.
핵심 설계 원칙 3가지:
출처주의: 내가 만든 것(30-knowledge) vs 외부에서 가져온 것(70-collected)
커맨드 번호 = 폴더 번호:
/72-youtube-collect는72-youtube/에 저장 → 외울 필요 없음요약(73) vs 변환(75) 분리: PDF "분석·요약"과 "원본 마크다운 변환"은 완전히 다른 용도
구축한 5개 커맨드
# | 커맨드 | 폴더 | 용도 | 예시 |
|---|---|---|---|---|
1 |
|
| 웹페이지 크롤링 + 요약 | 기사, 블로그 글 |
2 |
|
| 유튜브 자막 추출 + 요약 | 슈카월드, 강연 |
3 |
|
| PDF 분석 + 요약 | 업무 보고서 |
4 |
|
| 키워드 뉴스 검색 + 브리핑 |
|
5 |
|
| hwpx/pdf/이미지 → 원본 마크다운 변환 | 한글 문서 |
파일명 규칙의 진화 (3번 변경)
1차: YYYYMMDD_제목.md          → 날짜가 너무 길다
2차: YY-MM-DD_제목.md          → 하이픈이 제목과 섞인다
3차: YYMMDD_제목_(YYMMDD).md   → 수집일 + 원본날짜 병기 (최종)
실제로 써봐야 불편한 점이 보였습니다. 처음부터 완벽하게 정하려 하지 말고, 빨리 만들고 빨리 써보는 게 낫다는 것을 배웠습니다.
뉴스 브리핑 품질 개선
처음 만든 뉴스 브리핑(v1)은 기사 3~5개에 요약 2~3문장으로, 깊이가 부족했습니다. WebSearch 1회로는 한계가 있었습니다.
v1: 기사 3~5개, 요약 2~3문장
v2: 기사 5~7개, 요약 4~6문장 + 배경 맥락 + 핵심 수치 표 + 전문가 의견 + 단기/중장기 전망 구분
검색 2~3회 + 기사 본문 직접 추출로 바꾸니 브리핑 품질이 확 올라갔습니다.
Day 1 실제 수집 결과
첫날 바로 테스트로 11개 파일을 수집했습니다:
유튜브 4개 (슈카월드, 북토크 등)
웹클립 2개 (기회타운, 북수원TV)
뉴스 3개 (나스닥, 코스피, 비트코인)
PDF 요약 1개 + 마크다운 변환 1개
2) Day 2: 자료조사 자동화 파이프라인 — 27번의 인터뷰로 만든 6단계 시스템
Day 1에 만든 수집 도구들을 기반으로, "동향파악 자료조사" 업무 전체를 자동화하는 파이프라인을 구축했습니다. /automation-pipeline-design 스킬의 6단계 흐름을 따랐습니다.
1단계: 인터뷰 (27개 질문, 약 40분)
Claude가 인터뷰 가이드(업무정의 자동화 위임설계서)를 기반으로 한 번에 1개씩 질문을 던졌고, 저는 솔직하게 답했습니다. 처음엔 "동향파악을 자동화하고 싶다"는 막연한 생각이었는데, 27번의 대화를 거치면서 구체적인 파이프라인으로 발전했습니다.
대화의 전환점 4가지:
전환점 1 — 팩트 검증 → 출처 신뢰도 5단계 태깅
Claude: "자료의 사실 여부를 검증할 때 어떤 방식으로 하시나요?" 나: "정부 보도자료, 공식 통계, 공신력 있는 언론... 출처가 분명해서 바로 확인할 수 있으면 좋겠어"
이 한 마디가 나중에 출처 신뢰도 5단계 자동 태깅 시스템의 씨앗이 되었습니다.
전환점 2 — 보고서 3단계 구조 확정
Claude: "풀버전 5장이면 각 섹션별 어느 정도 깊이를 원하시나요?" 나: "세 가지를 다 받아볼 수 있을까? 욕심일까?" Claude: "욕심이 아닙니다!"
요약본(1장) + 풀버전(5장) + 심화버전(10장+), 3단계 보고서 구조가 확정된 순간이었습니다.
전환점 3 — AI에게 의견을 물었을 때
Claude: "하나의 명령으로 끝까지 갈지, 별도 명령으로 할지?" 나: "너는 어떻게 생각해?" Claude: "3개 분리를 추천합니다. 세션이 끊겨도 이어갈 수 있고, 보고서만 다시 다듬는 것도 가능합니다." 나: "세 개로 분리하되, 통합 명령도 만들어줘"
4개 명령 구조가 확정되었습니다. AI와의 대화는 일방적 지시가 아니라 쌍방향 설계 세션이 될 수 있습니다.
전환점 4 — 사용자의 디테일한 피드백
나: "폴더 네임에도 번호를 붙여줘" 나: "79번 폴더는 필요없는 것이 아닐까?" 나: "기존 76-hwpx-export의 내용을 새로 생성되는 77번에 통합하면 좋겠어"
작은 지적들이 최종 결과물의 완성도를 높였습니다. 사용자가 구체적으로 요구할수록 결과물이 좋아집니다.
2단계: 워크시트
인터뷰 27개 답변을 구조화된 워크시트로 정리했습니다. 참여자 매핑, 고통 분석, 위임 선언서, 업무 플로우, 예외 정책까지 빠짐없이 채웠습니다. 자가 점검 체크리스트 16개 항목 중 15개 통과, 1개(API 키)만 [확인 필요]로 남겼습니다.
3단계: 자동화 설계
워크시트를 바탕으로 설계한 보고서 출력 구조:
배경 → 검토사항 → 전문가 의견 → 장단점 → 대안 → 향후 계획 → AI 의견
소스 간 내용이 충돌할 때의 처리 규칙도 정했습니다: "모두 병기하되, 장단점을 밝히고, 전문가 의견을 곁들이고, 마지막으로 AI의 의견을 제안한다."
4단계: 도구 연결
작업공간의 실제 스킬을 탐색하여 12개 단계에 도구를 연결했습니다.
즉시 사용 가능: 9개 (75%)
추가 설정 필요: 1개 (pandoc)
그레이 영역: 1개 (ppt 생성)
5단계: 오케스트레이션 실행
4가지 준비 작업을 즉시 실행:
폴더 3개 생성 (76-research-md, 77-refine-docx-hwpx, 78-present-ppt)
기존 76-hwpx-export → 77-refine 이관
커맨드 파일 4개 생성
pandoc 3.9 설치
6단계: Agent 변환
자료조사의 핵심인 "웹/유튜브/뉴스 동시 수집"을 위해 orchestrator agent 1개 + sub-agent 3개를 생성했습니다.
trend-research-orchestrator (총괄)
  ├── trend-web-collector     (웹 기사 수집)
  ├── trend-youtube-collector  (유튜브 자막 추출)
  └── trend-news-collector     (뉴스 검색·브리핑)
3개 sub-agent가 병렬로 자료를 수집하고, orchestrator가 통합 보고서를 생성합니다.
그레이 영역 해결
마지막으로 3가지 미해결 항목을 모두 처리했습니다:
python-pptx 설치 → ppt 자동 생성 가능
출처 신뢰도 5단계 태깅 → 76-research 커맨드에 내장
팩트체크 경고 시스템 → 76-research + 77-refine 커맨드에 내장
그레이 영역 0개 — 모든 기능이 즉시 실행 가능한 상태로 완성되었습니다.
사용한 도구
Claude Code (CLI) — 전체 대화·설계·구현의 중심
Claude
/automation-pipeline-design스킬 — 6단계 자동화 설계 프레임워크Firecrawl API — 웹페이지 크롤링 (Day 1)
pandoc 3.9 — 문서 변환 md → docx (Day 2)
python-pptx — 발표자료 자동 생성 (Day 2)
최종 시스템 구조
사용자 입력: "AI 반도체 동향 조사해줘"
  │
  ▼
/76-research (자료 수집 + 보고서 3버전 생성)
  ├── trend-web-collector     → 71-web-clips/ 활용
  ├── trend-youtube-collector → 72-youtube/ 활용
  └── trend-news-collector    → 74-news/ 활용
  │
  ▼ 출처 신뢰도 태깅 + 팩트체크 경고
  │
/77-refine (인간 검토 + 보완 반복 → docx/hwpx 변환)
  │
  ▼
/78-present (발표자료 ppt 생성)
  │
  ▼
/79-deep-research (위 3개를 한 번에 통합 실행)
3. 결과와 배운 점
결과 (수치)
항목 | Day 1 (수집 인프라) | Day 2 (자동화 파이프라인) | 합계 |
|---|---|---|---|
커맨드 | 5개 (71~75) | 4개 (76~79) | 9개 |
Agent | - | 4개 | 4개 |
폴더 | 5개 | 3개 | 8개 |
설치 도구 | Firecrawl | pandoc, python-pptx | 3개 |
인터뷰 질문 | - | 27개 | 27개 |
테스트 수집 | 11개 파일 | - | 11개 |
핵심 결과:
3일(17.5시간) → 1일: 주당 2일, 연간 약 100일 절약 기대
수집 → 보고서 → 문서변환 → 발표자료 원스톱 파이프라인 완성
그레이 영역 0개: 모든 기능이 즉시 실행 가능
배운 점
(1) 좋은 질문이 좋은 설계를 만든다
27개 인터뷰 질문이 많아 보이지만, 하나하나가 설계의 품질을 결정했습니다. "팩트 검증을 어떻게 하시나요?" 한 질문이 출처 신뢰도 시스템이라는 결과물로 이어졌습니다. 급하다고 인터뷰를 줄이면 설계가 약해집니다.
(2) AI에게 "너는 어떻게 생각해?"라고 물어라
몇 번 Claude에게 의견을 물었고, 매번 합리적인 제안을 받았습니다. 명령 구조를 3개로 분리하자는 제안이 대표적입니다. 지시만 하지 말고 대화하세요. AI와의 작업은 쌍방향 설계 세션이 될 수 있습니다.
(3) 출처주의로 분류하면 워크플로우가 자연스럽게 생긴다
"내 지식(30)" vs "외부 원본(70)"으로 나누니 "수집 → 소화 → 지식 승격" 흐름이 저절로 만들어졌습니다. 분류 원칙이 곧 워크플로우입니다.
(4) 빨리 만들고 빨리 써보는 게 낫다
파일명 규칙을 3번 바꿨습니다. 뉴스 브리핑도 v1에서 v2로 개선했습니다. 처음부터 완벽할 수 없고, 완벽을 기다리면 시작할 수 없습니다.
(5) 3일 → 1일은 도구의 힘이 아니라 구조의 힘이다
수집을 자동화한 것보다, 인터뷰 → 수집 → 통합 → 보완 → 변환이라는 흐름을 설계한 것이 핵심입니다. 도구는 바뀔 수 있지만 구조는 남습니다.
시행착오
파일명 규칙 3번 변경: YYYYMMDD → YY-MM-DD → YYMMDD_제목_(YYMMDD). 실제로 파일을 만들어봐야 불편한 점이 보입니다.
뉴스 브리핑 품질 부족: v1은 WebSearch 1회로 기사 3~5개, 요약 2~3문장. 검색 2~3회 + 본문 직접 추출로 바꾼 v2에서야 만족할 만한 깊이가 나왔습니다.
ppt 생성 도구 부재: 그레이 영역으로 남았다가 python-pptx로 해결. 완벽한 도구를 기다리지 말고, 있는 것으로 먼저 돌리는 게 답이었습니다.
폴더 번호 충돌: 기존 76-hwpx-export와 새 76-research가 겹쳤는데, 기존 기능을 77-refine에 통합하는 아이디어를 제가 제안해서 해결했습니다.
앞으로의 계획
단기 (이번 주)
/76-research로 첫 실제 드라이런 실행결과물 품질 검증 후 커맨드 미세 조정
중기 (1개월)
수집 → 지식 승격 루틴 만들기 (70-collected → 30-knowledge)
뉴스 브리핑 고정 관심사 자동화 검토 (매일 아침 AI/투자/뇌과학)
ppt 디자인 템플릿 라이브러리 구축
장기 (3개월)
축적된 보고서 데이터로 트렌드 메타 분석
수집된 자료 간 연결점 분석 (zettelkasten-linker 활용)
동료 피드백 반영하여 보고서 구조 진화
4. 도움 받은 글
GPTers 20기 학습자료(안상영&정혜지 스터디장님) — "출처주의" 개념과 Structure → Collect → Connect → Expand 4주 커리큘럼. 이 학습자료를 분석한 것이 이틀간의 작업을 촉발한 촉매였습니다.
GPTers 21기 학습자료(안상영 스터디장님) — Claude Code
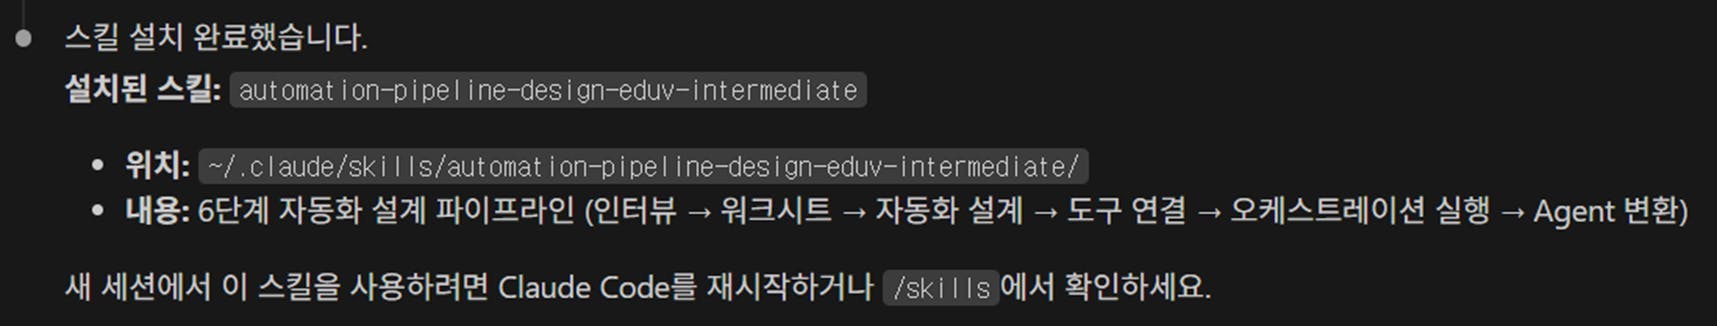
/automation-pipeline-design스킬 — 인터뷰 → 워크시트 → 설계 → 도구 연결 → 실행 → Agent 변환의 6단계 프레임워크.
로그인하고 댓글을 남겨 주세요

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


야호심님 멋집니다!!
1보 후퇴하고 구조를 잡은 다음에
10걸음을 나가셨네요!!👍
인터뷰에서 27번의 대화를!!!
끊기로 탄탄한 구조를 잡으셨네요
없던 스킬까지 만드셔서 자동화 완성!!
이제 뚝딱 뚝딱
단순 자동화를 목표로 하는 것이 아니라
어떻게 AI구조화를 하고 자동화할 것인지
야호심님만의 AI 철학까지 담으신 듯합니다!!
이제 하산을 하셔야 할 때입니다.