문서가 많다는 진단을 그대로 믿지 않았다: 팩트체크로 실행 순서를 다시 짠 과정
2026.07.28
소개
서버 구축보다 문서 작성에 치우쳤다는 외부 진단을 검토한 뒤, 문서를 폐기하거나 도구를 즉시 설치하는 대신 실제 dependency에 따라 작업 순서를 다시 설계했습니다. 결과는 “Hermes core를 먼저 경험하되 backup·권한·외부 입력은 단계적으로 연다”는 Hermes-first·backup-first 구조였습니다.
이 작업의 출발점은 몇 일 동안 저장소와 운영 규칙은 크게 늘었지만 핵심 agent runtime은 아직 설치되지 않았다는 문제의식이었습니다. 이 글은 비판 의견의 수치·인용·실행 제안을 다시 검증하고, 사용자가 먼저 경험하고 싶은 기능을 안전 gate와 연결해 새 순서를 확정한 과정까지 다룹니다. 실제 Hermes 설치와 backup 실행 결과는 각각 별개의 사례입니다.
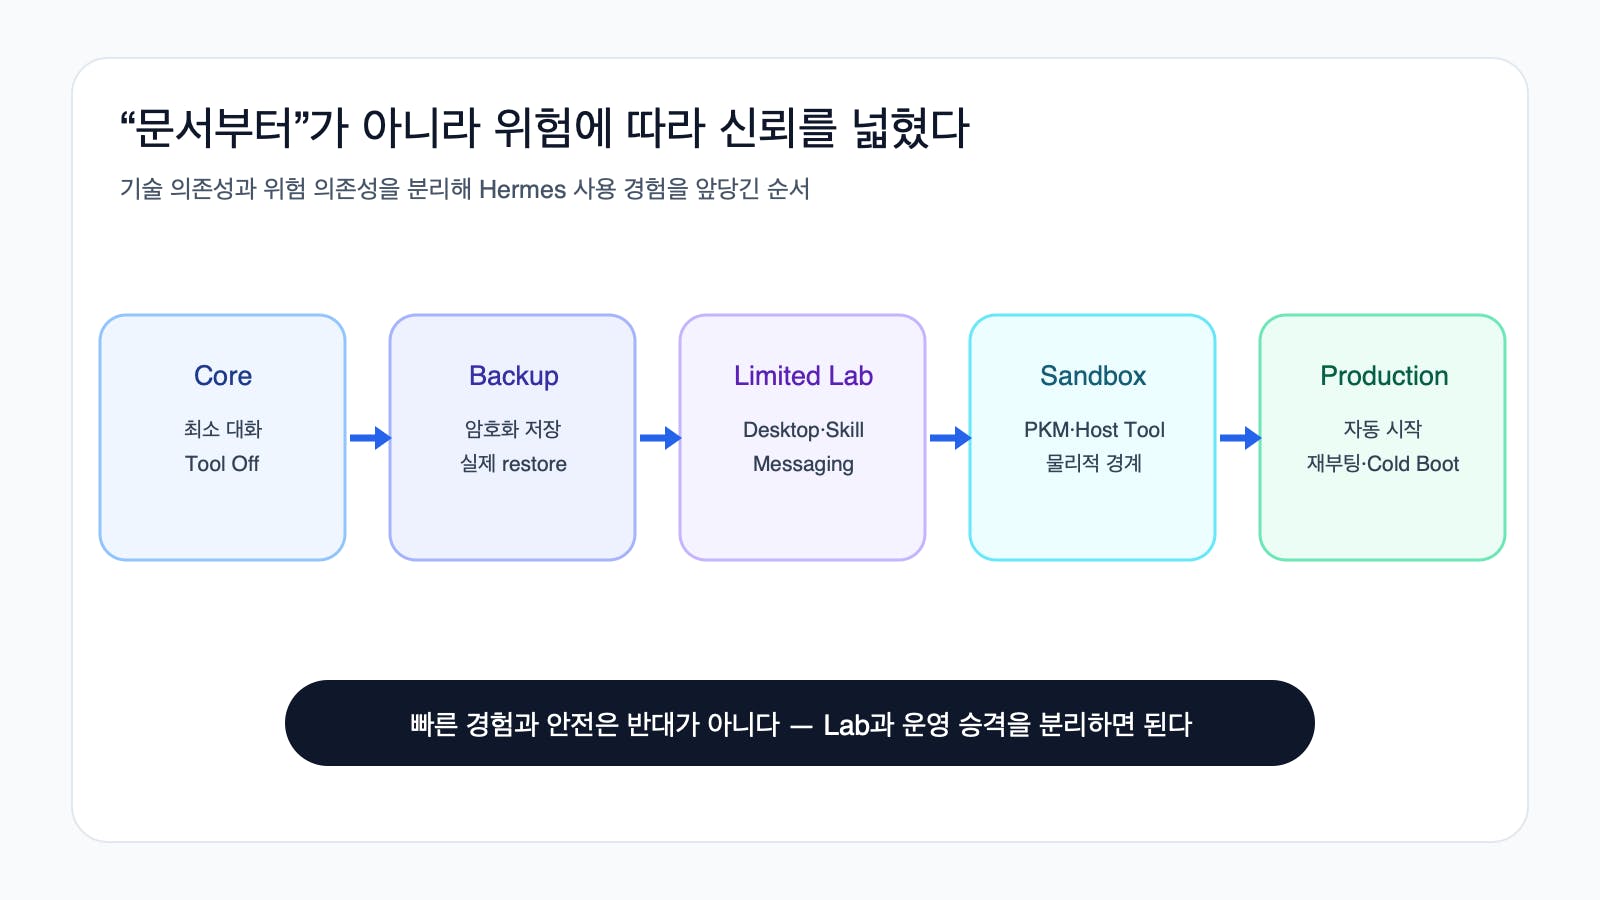
기술 설치 순서가 아니라 권한과 데이터 위험에 따라 신뢰 범위를 넓힌 구조입니다.
한눈에 보는 흐름: Core → Backup → Limited Lab → Sandbox → Production
진행 방법
Claude Code는 저장소 규모와 작업 방식에 대한 비판적 검토를 제공했고, Codex는 그 의견을 저장소 원문·공식 자료·현재 runtime 증거와 다시 대조했습니다. 저는 AI가 제시한 결론을 바로 승인하지 않고, 원하는 사용 경험과 허용할 위험 범위를 결정했습니다.
실제로 사용한 대표 prompt는 다음과 같습니다.
지금 24시간 서버를 VS Code와 AI 확장으로 Phase별 구축하고 있는데 이 방식이
효율적인지, 더 좋은 방식이 있는지 냉철하게 검증해줘.
숫자와 결론을 분리해서 검증했다
첫 검토는 Markdown 비중이 크고 실제 provisioning 자산은 상대적으로 적다는 점을 지적했습니다. 저장소의 문서 비중이 크다는 관찰 자체는 맞았습니다. 하지만 “문서가 많다”와 “문서가 순수 낭비다”는 같은 명제가 아닙니다.
일부 인용은 공식 자료와 맞지 않았고, 현재 후보 검증 스크립트를 바로 사용한 뒤 Hermes를 즉시 설치하자는 제안도 안전하지 않았습니다. 그 스크립트는 실제 설치된 runtime이 아니라 미래 Docker 경계를 가정한 후보였기 때문입니다.
그래서 다음 세 가지를 따로 판정했습니다.
측정값이 실제 저장소와 일치하는가
그 측정값이 제안한 원인을 정말 증명하는가
제안한 실행이 현재의 backup·secret·rollback 조건을 만족하는가
이 구분을 적용하자 살아남은 결론은 분명했습니다. 문서 전체를 버릴 이유는 없었지만, 실제 사용 경험을 더 일찍 확보할 필요는 있었습니다.
기술 dependency와 위험 dependency를 나눴다
Hermes의 기본 CLI 대화와 session 재개는 PKM, messaging, n8n에 기술적으로 의존하지 않았습니다. 따라서 core를 앞당길 수 있었습니다. 반면 중요한 session, skill과 token을 보존하려면 검증된 backup이 필요했고, host file·terminal·browser 같은 도구를 열려면 sandbox 경계가 필요했습니다.
이 차이를 바탕으로 작업을 한 덩어리 설치가 아니라 단계적인 신뢰 확장으로 바꿨습니다.
공식 source를 고정한 최소 Hermes core와 tool-off 대화
암호화 backup과 실제 restore
제한된 Desktop·skill·messaging Lab
PKM과 host-effect tool의 물리적 sandbox
Gateway 자동기동과 재부팅·cold boot
설치 전에 Mac mini의 현재 상태와 공식 installer를 read-only로 조사했습니다. 이 과정에서 비대화형 shell의 PATH 때문에 설치된 도구를 absent로 오판하는 문제도 발견했습니다. 상태 수집기는 명령 실패와 실제 빈 목록을 각각 unknown과 0으로 구분하도록 고쳤습니다.
사용 순서와 운영 승격을 분리했다
처음 새 순서는 core 뒤 backup, 그다음 PKM이었습니다. 이후 저는 PKM보다 먼저 MacBook Desktop, 직접 만든 skill, 검토된 외부 skill과 Telegram·Discord·Slack을 경험하고 싶다고 요청했습니다.
다시 dependency를 그려 보니 이 기능들은 PKM이 없어도 시험할 수 있지만, config·session·skill·token이라는 새 상태를 만들기 때문에 backup은 먼저 필요했습니다. 그래서 backup 뒤에 Desktop·Skills Lab과 Messaging Gateway Lab을 배치하고 PKM을 그다음으로 옮겼습니다.
동시에 “연결됐다”와 “24시간 운영된다”를 분리했습니다. Lab에서는 disposable profile, owner-only 입력, foreground process와 host-effect tool off를 유지합니다. production 승격은 별도 재검증, 자동기동, 재부팅과 cold boot 증거를 요구하도록 했습니다.
짧은 학습 일정의 목표도 수십 개 기능 완성에서 하나의 수직 흐름으로 줄였습니다. 대표 목표는 러닝 공지 초안을 요청하고, 근거를 검증하고, 사람이 수정한 이유를 다음 실행에 반영하는 반복 가능한 loop였습니다.
결과와 배운 점
이번 작업에서 확정한 것은 runtime 성공이 아니라 실행 순서와 안전 경계입니다.
완료된 과거 증거는 보존하면서 Hermes core를 앞으로 옮겼습니다.
backup, client·skill·messaging Lab, PKM sandbox와 production 자동기동을 서로 다른 gate로 분리했습니다.
상태 수집기는 명령 실패를 정상적인 빈 결과로 축약하지 않도록 교정했습니다.
짧은 기간의 목표를 기능 개수가 아니라 검증 가능한 하나의 수직 loop로 정의했습니다.
이 설계 변경 중에는 runtime, bot account, token, Gateway나 PKM 상태를 변경하지 않았습니다.
이번 경험에서 얻은 교훈은 다음과 같습니다.
정확한 숫자도 그 숫자에서 끌어낸 원인과 처방까지 자동으로 증명하지는 않습니다.
작업 순서는 익숙한 기술 목록보다 실제 dependency와 실패했을 때의 영향으로 정하는 편이 낫습니다.
빠른 경험과 안전은 반대말이 아닙니다. 제한된 Lab과 production 승격을 분리하면 먼저 써 보면서도 권한 범위를 늦게 열 수 있습니다.
다음 단계는 이 순서를 문서로만 남기지 않고, core 설치와 backup·restore를 각각 독립된 검증으로 통과시키는 것입니다.
로그인하고 댓글을 남겨 주세요

‘연결됐다’와 ‘24시간 운영된다’를 따로 놓은 대목이 이번 재설계의 중심축으로 보였어요. Jon님은 ‘문서가 많다’는 외부 진단을 받아들이거나 반박하는 데서 멈추지 않고, 측정값→원인 해석→처방의 안전 조건을 한 단계씩 분리했습니다. 후보 스크립트가 미래 Docker 경계를 가정했다는 이유로 지금 당장 실행하지 않은 선택도, 비판을 팩트체크한다는 말이 실제 승인 기준으로 작동한 장면이에요.
그 뒤 실행 순서를 기술 목록이 아니라 두 종류의 의존성으로 다시 그린 과정이 좋았어요. Hermes core 대화와 session resume는 PKM·messaging·n8n 없이도 먼저 경험할 수 있지만, Desktop·skill·messaging은 config·session·token이라는 새 상태를 만들기 때문에 backup이 앞서야 했죠. 그래서 ‘빨리 써보기’는 tool-off·owner-only·foreground의 제한된 Lab으로 앞당기고, production 승격은 자동기동·reboot·cold boot 증거가 생길 때까지 뒤로 보냈습니다. 사용 순서와 운영 승격을 분리하니 속도와 안전이 같은 설계 안에 들어왔어요.
짧은 일정의 성공을 기능 수가 아니라 하나의 수직 loop로 다시 정의한 점도 의미 있었어요. 러닝 공지 초안→근거 확인→사람의 수정 이유 반영이라는 흐름은 어떤 기능을 더 붙일지보다 실제로 학습이 다음 실행에 남는지를 보게 합니다. 상태 수집기에서도 PATH 때문에 도구를 absent로 오판한 뒤 명령 실패와 빈 목록을 unknown과 0으로 나눈 교정이 있었고요. 앞선 원격 복구 글에서 listener와 재부팅 증거를 구분했던 태도가, 이번에는 문서·후보 코드·실행 증거를 구분하는 계획 원리로 이어진 것 같아요.
이 글 시점에는 실제 Hermes core 설치와 backup·restore가 모두 미확인이었지만, 후속 글에서는 공식 source를 고정한 tool-off core의 대화와 같은 session 재개까지 통과했어요. 아직 확인 전인 남은 경계는 durable encrypted backup을 만든 뒤 격리된 disposable 환경에서 restore 결과를 대조하는 일입니다. core 경험과 복구 증거를 한 성공 표시로 합치지 않는 것이 이 글이 만든 기준을 그대로 지키는 방법이겠어요. 이 글이 독자에게 주는 건 ‘무엇부터 설치할까’ 목록이 아니라 기술적 선행성, 새로 생기는 상태, 실패 영향, 승격 증거를 따로 묻는 판단법입니다. 외부 진단을 숫자 그대로 따르지 않으면서도 그 비판이 가리킨 실행 지연은 살려낸 덕분에, 방어도 맹신도 아닌 재설계 사례가 됐어요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



AI의 비판을 그대로 믿지 않고 '문서가 많다'와 '문서가 낭비다'를 구분해 팩트체크하신 부분에서 완전 몰입해서 읽었습니다. Jon님이 직접 원하는 경험의 우선순위와 실제 위험 범위를 기준으로 실행 단계를 다시 조율해 가는 과정이 정말 정교하네요. 그냥 지나칠 수 있었던 상태 수집기의 미세한 판정 오류까지 꼼꼼히 잡아가며 개발하시는 모습에 큰 배움을 얻었습니다. 진짜 탄탄하고 뚝심 있는 설계 방식에 절로 고개가 끄덕여집니다. 👍