


📝 한 줄 요약 (바쁘면 이것만)
1주차 글 마지막에 저는 **"신호검색 스킬을 여러 개 만들어 각각 데이터로 검증하고, 겹치는 부분을 쪼개고 합쳐 우산 스킬로 재합성하겠다"**고 썼습니다. 그 약속을 이행했습니다. 성격이 다른 신호 4종을 만들고, 해외시장 라이브 데이터 평가점 26,400개로 나란히 쟀습니다. 결과는 1개 채택, 2개 보류, 1개 배제 — 4개를 다 합치지 않았습니다. 그리고 이 글의 진짜 이야기는 첫 측정에서 승률 **71%**로 보였던 신호가, 표본을 44배로 늘리자 **60%**로 내려앉은 장면입니다.
🎯 이런 분께 추천해요
AI가 만들어준 지표·룰·프롬프트가 "잘 맞는 것 같다"까지는 왔는데 그다음을 못 정하신 분
스킬이 여러 개로 늘었을 때 뭘 남기고 뭘 버릴지 기준이 필요한 분
승률·정확도 같은 숫자를 봤는데 그게 믿을 만한 숫자인지 판단이 안 서는 분
자동매매·신호검색을 해외/24시간 시장으로 넓히고 계신 분
😫 문제 상황 (Before)
1주차에 만든 건 통합형 신호검색 스킬 1개였습니다. RCI 저점집결·MACD 골든크로스·EMA 정배열을 한 번에 판정해서 "신호 있음/없음"을 뱉는 구조였죠. 첫 라이브 스캔에서 신호 0건이 나왔고, 저는 그걸 "조건이 원래 드문 거니 정직한 결과"라고 썼습니다.
그건 맞는 말이었지만, 동시에 아무것도 증명하지 않은 말이었습니다.
신호가 0건인지 8건인지는 알 수 있어도, 그 신호가 뜬 자리에 실제로 들어갔으면 돈을 벌었는지는 여전히 몰랐거든요. 게다가 조건 세 개를 "or"로 묶어놨으니, 신호가 떴을 때 그게 셋 중 누구 덕인지도 분리가 안 됐습니다.
그래서 2주차 목표를 이렇게 잡았습니다.
하나를 성격별로 쪼갠다 → 각각 따로 잰다 → 통과한 것만 다시 합친다
🛠️ 사용한 도구
Claude 기반 로컬 AI 에이전트 (터미널·파일 작업 가능)
MetaTrader 5 데모계좌 (모의) + 자체 수집 스크립트
Python (지표 계산, 부트스트랩 신뢰구간 — 외부 라이브러리 없이 표준 라이브러리만)
🔧 작업 과정
1막 — 하나를 넷으로 쪼갰다
성격이 서로 겹치지 않도록 네 갈래로 나눴습니다.
이름
성격
한 줄로 말하면
A. 역추세
떨어질 만큼 떨어졌다
RCI 4선이 바닥 부근에 동시 집결
B. 추세추종
올라가기 시작했다
MACD 골든크로스 + 이동평균 정배열
C. 평균회귀
밖으로 튀었다 돌아왔다
볼린저 하단 이탈 후 복귀 + 과매도
D. 돌파
박스를 뚫었다
20봉 신고가 돌파 + 변동성 확장
A와 B는 기존 엔진에 이미 있던 함수라 새 코드 0줄, C와 D는 새로 짰습니다.
여기서 제약을 하나 걸었습니다: 판정 규칙을 결과 보기 전에 확정한다.
성능을 재는 방식은 이렇게 정했습니다. 신호가 뜬 시점에 들어가서 5봉 뒤 승률을 보되, "아무 때나 그냥 들어갔을 때의 승률"(기준선)과 비교합니다. 그리고 그 차이에 신뢰구간을 붙여서:
신뢰구간 하한이 0보다 크면 → 채택
신뢰구간 상한이 0보다 작으면 → 배제
0을 걸치면 → 보류 (계산은 하되 "신호"라고 부르지 않음)
이걸 먼저 못 박은 이유는 단순합니다. 결과를 본 뒤에 기준을 정하면, 사람은 반드시 자기가 만든 것에 유리한 기준을 고르거든요.
2막 — 첫 측정: 승률 71%가 나왔다
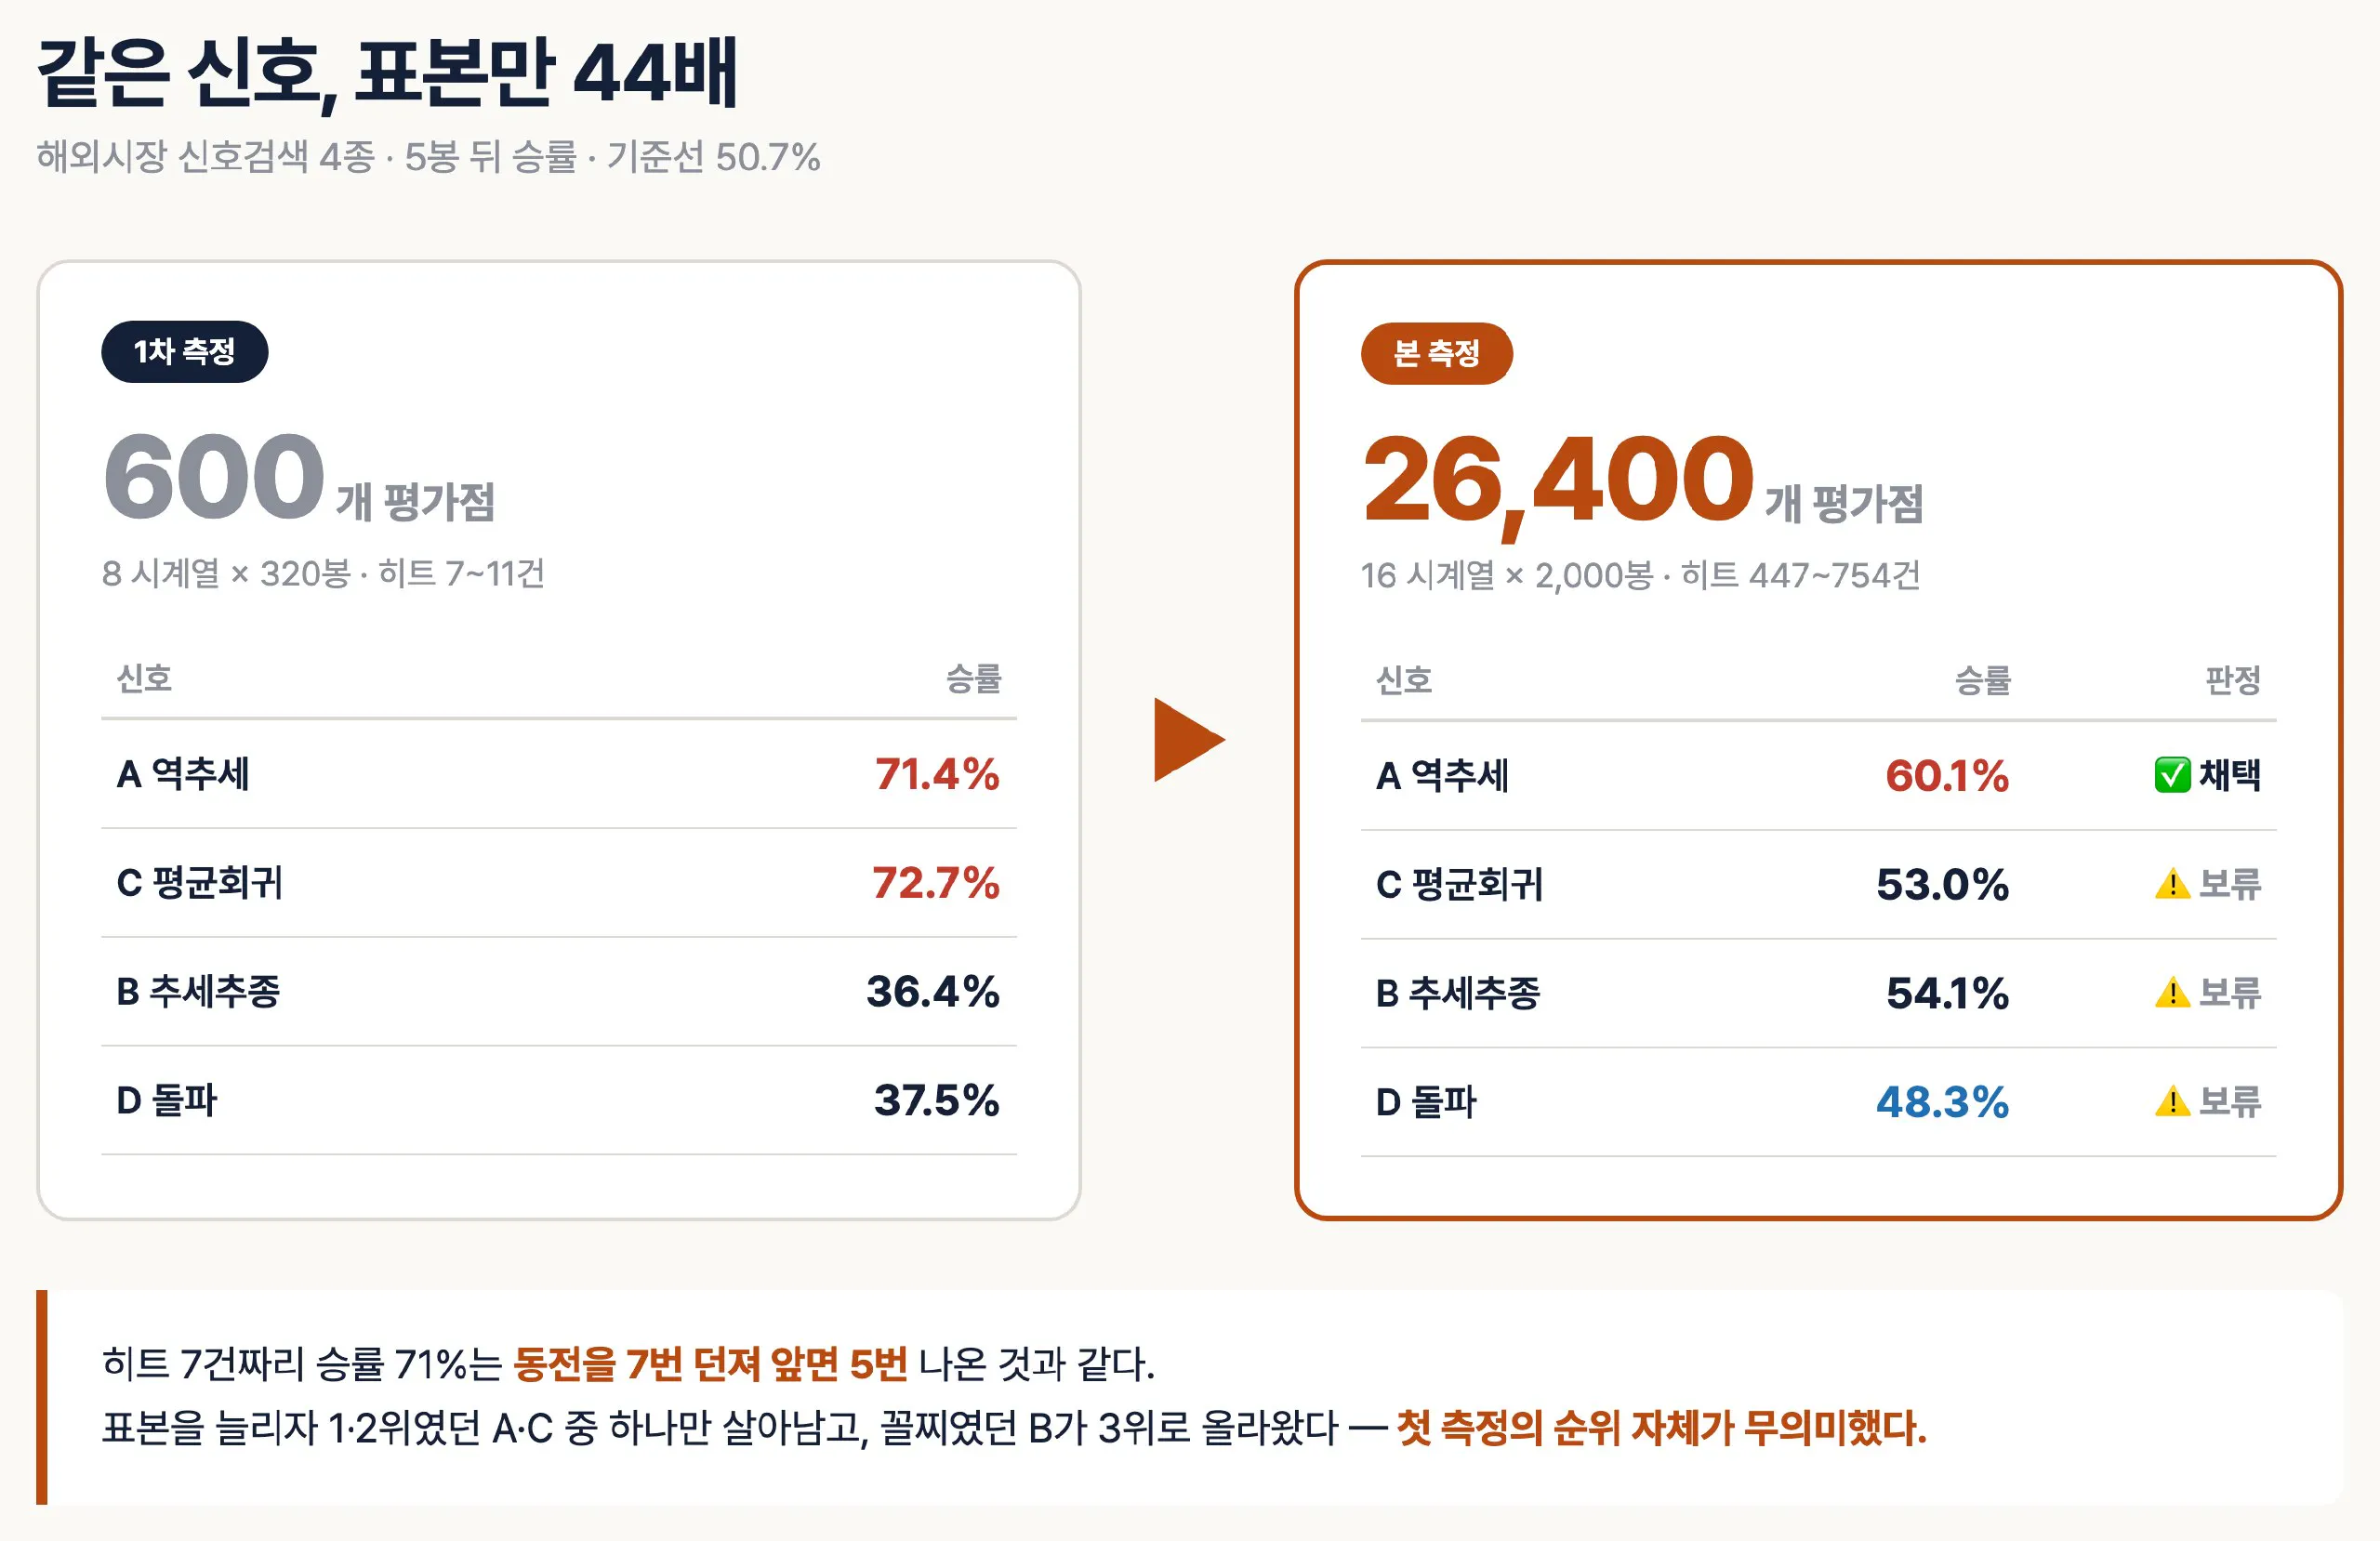
기존 수집 설정 그대로 돌렸습니다. 8개 시계열 × 320봉 = 평가점 600개.
detector
5봉 뒤 승률
발생 건수
A. 역추세
71.4%
7건
C. 평균회귀
72.7%
11건
B. 추세추종
36.4%
11건
D. 돌파
37.5%
8건
기준선이 50.5%였으니 A와 C는 20%p 넘게 앞선 셈입니다. 솔직히 여기서 멈추고 싶었습니다. "A와 C 채택, B와 D 폐기" — 깔끔하잖아요.
그런데 오른쪽 열을 보세요. 7건. 11건.
동전을 7번 던져서 앞면이 5번 나오면 71%입니다. 그걸 두고 "이 동전은 앞면이 잘 나온다"고 말하지는 않죠. 1주차 글에서 제가 "느낌상 잘 맞는다가 아니라 숫자로 잰다"고 써놓고, 정확히 그 함정 앞에 서 있었습니다.
3막 — 막힘 1: 데이터를 늘리려는데 EA가 말을 안 듣는다
표본을 늘리려면 수집기가 더 많은 봉을, 더 많은 타임프레임으로 내보내야 했습니다. 수집 스크립트의 설정값 두 줄만 고치면 되는 일이었죠.
고치고, 1주차에 정리해둔 절차("터미널을 재시작하면 전체 재컴파일된다")대로 재시작했습니다. 그런데 출력 파일은 계속 옛날 봉 수 그대로였습니다.
원인을 캐보니 이랬습니다. 컴파일 결과물이 이미 존재하면 터미널은 재컴파일을 건너뜁니다. 1주차에 정리한 절차는 "처음 만든 파일" 기준이었고, "이미 있는 파일을 수정한 경우"는 다루지 않았던 겁니다. 제가 쓴 문서가 제 발목을 잡은 셈이죠.
우회는 단순했습니다 — 컴파일 결과물을 백업 위치로 치우고(지우지 않고) 재시작. 90초 뒤 새 결과물이 생겼고, 16개 시계열 전부 2,000봉으로 확장됐습니다.
평가점이 600개 → 26,400개(44배) 가 됐습니다.
4막 — 다시 재보니 71%가 60%였다
detector
320봉 기준
2,000봉 기준
최종 판정
A. 역추세
71.4% (7건)
60.1% (569건)
✅ 채택
C. 평균회귀
72.7% (11건)
53.0% (447건)
⚠️ 보류
B. 추세추종
36.4% (11건)
54.1% (468건)
⚠️ 보류
D. 돌파
37.5% (8건)
48.3% (754건)
⚠️→❌
작은 표본은 항상 더 좋아 보입니다.
한국의 인구수를 보여주는 표
A는 살아남았지만 우위가 절반으로 줄었고, C는 "20%p 압승"에서 "2%p, 신뢰구간이 0을 걸침"으로 내려앉았습니다. B와 D는 반대로 올라왔고요 — 즉 첫 측정의 순위 자체가 거의 무의미했던 겁니다.
1차 측정 600개 vs 본 측정 26,400개 — 표본을 44배로 늘렸을 때 승률 순위가 뒤바뀐 대비표
기준선 대비 차이에 신뢰구간을 붙이니 이렇게 정리됐습니다.
detector
기준선 대비
95% 신뢰구간
판정
A. 역추세
+9.4%p
[+5.4, +13.5]
✅ 채택
B. 추세추종
+3.4%p
[-1.1, +7.9]
⚠️ 보류
C. 평균회귀
+2.3%p
[-2.1, +6.8]
⚠️ 보류
D. 돌파
-2.4%p
[-6.1, +1.1]
⚠️ 보류
B와 C는 방향은 플러스인데 신뢰구간이 0을 걸칩니다. "좋은 것 같긴 한데 우연일 가능성을 못 지웠다"는 뜻이죠. 미리 정한 규칙대로 보류했습니다. 아쉬웠지만 규칙을 결과 보고 고치면 규칙을 만든 의미가 없습니다.
5막 — 쪼개서 봤더니 판정이 하나 더 강해졌다
여기서 한 걸음 더 갔습니다. 위 표는 M15·H1·H4·D1을 한 통에 섞어 잰 값입니다. 타임프레임마다 성질이 다른데 섞으면 서로를 상쇄하죠. 그래서 분해했습니다.
detector
M15
H1
H4
D1
A. 역추세
+3.6 ⚠️
+13.9 ✅
+10.0 ✅
+12.0 ✅
B. 추세추종
+0.8 ⚠️
+6.7 ⚠️
+5.8 ⚠️
-1.8 ⚠️
C. 평균회귀
-0.2 ⚠️
+0.7 ⚠️
+2.1 ⚠️
+8.0 ⚠️
D. 돌파
+0.7 ⚠️
-13.1 ❌
+1.1 ⚠️
-2.2 ⚠️
두 가지가 드러났습니다.
하나. A는 세 개 타임프레임에서 나란히 채택됐습니다. 한 군데서 운 좋게 나온 게 아니라는 뜻이라, 통합 결과보다 훨씬 믿을 만해졌습니다.
둘. D는 통합에서 "보류"였는데, H1만 떼어 보니 승률 36.2%, 신뢰구간 [-20.4, -5.0] — 구간 전체가 음수입니다. "기준선보다 나쁘다"가 통계적으로 확정된 유일한 케이스였습니다. 심지어 D는 4종 중 가장 자주 터지는 신호(발생율 2.86%, 최다)였습니다. 제일 부지런히 신호를 뱉는 놈이 제일 해로웠던 거죠.
섞어 보면 "보류", 쪼개 보면 "배제". 분해가 더 강한 판정을 준다는 걸 여기서 배웠습니다.
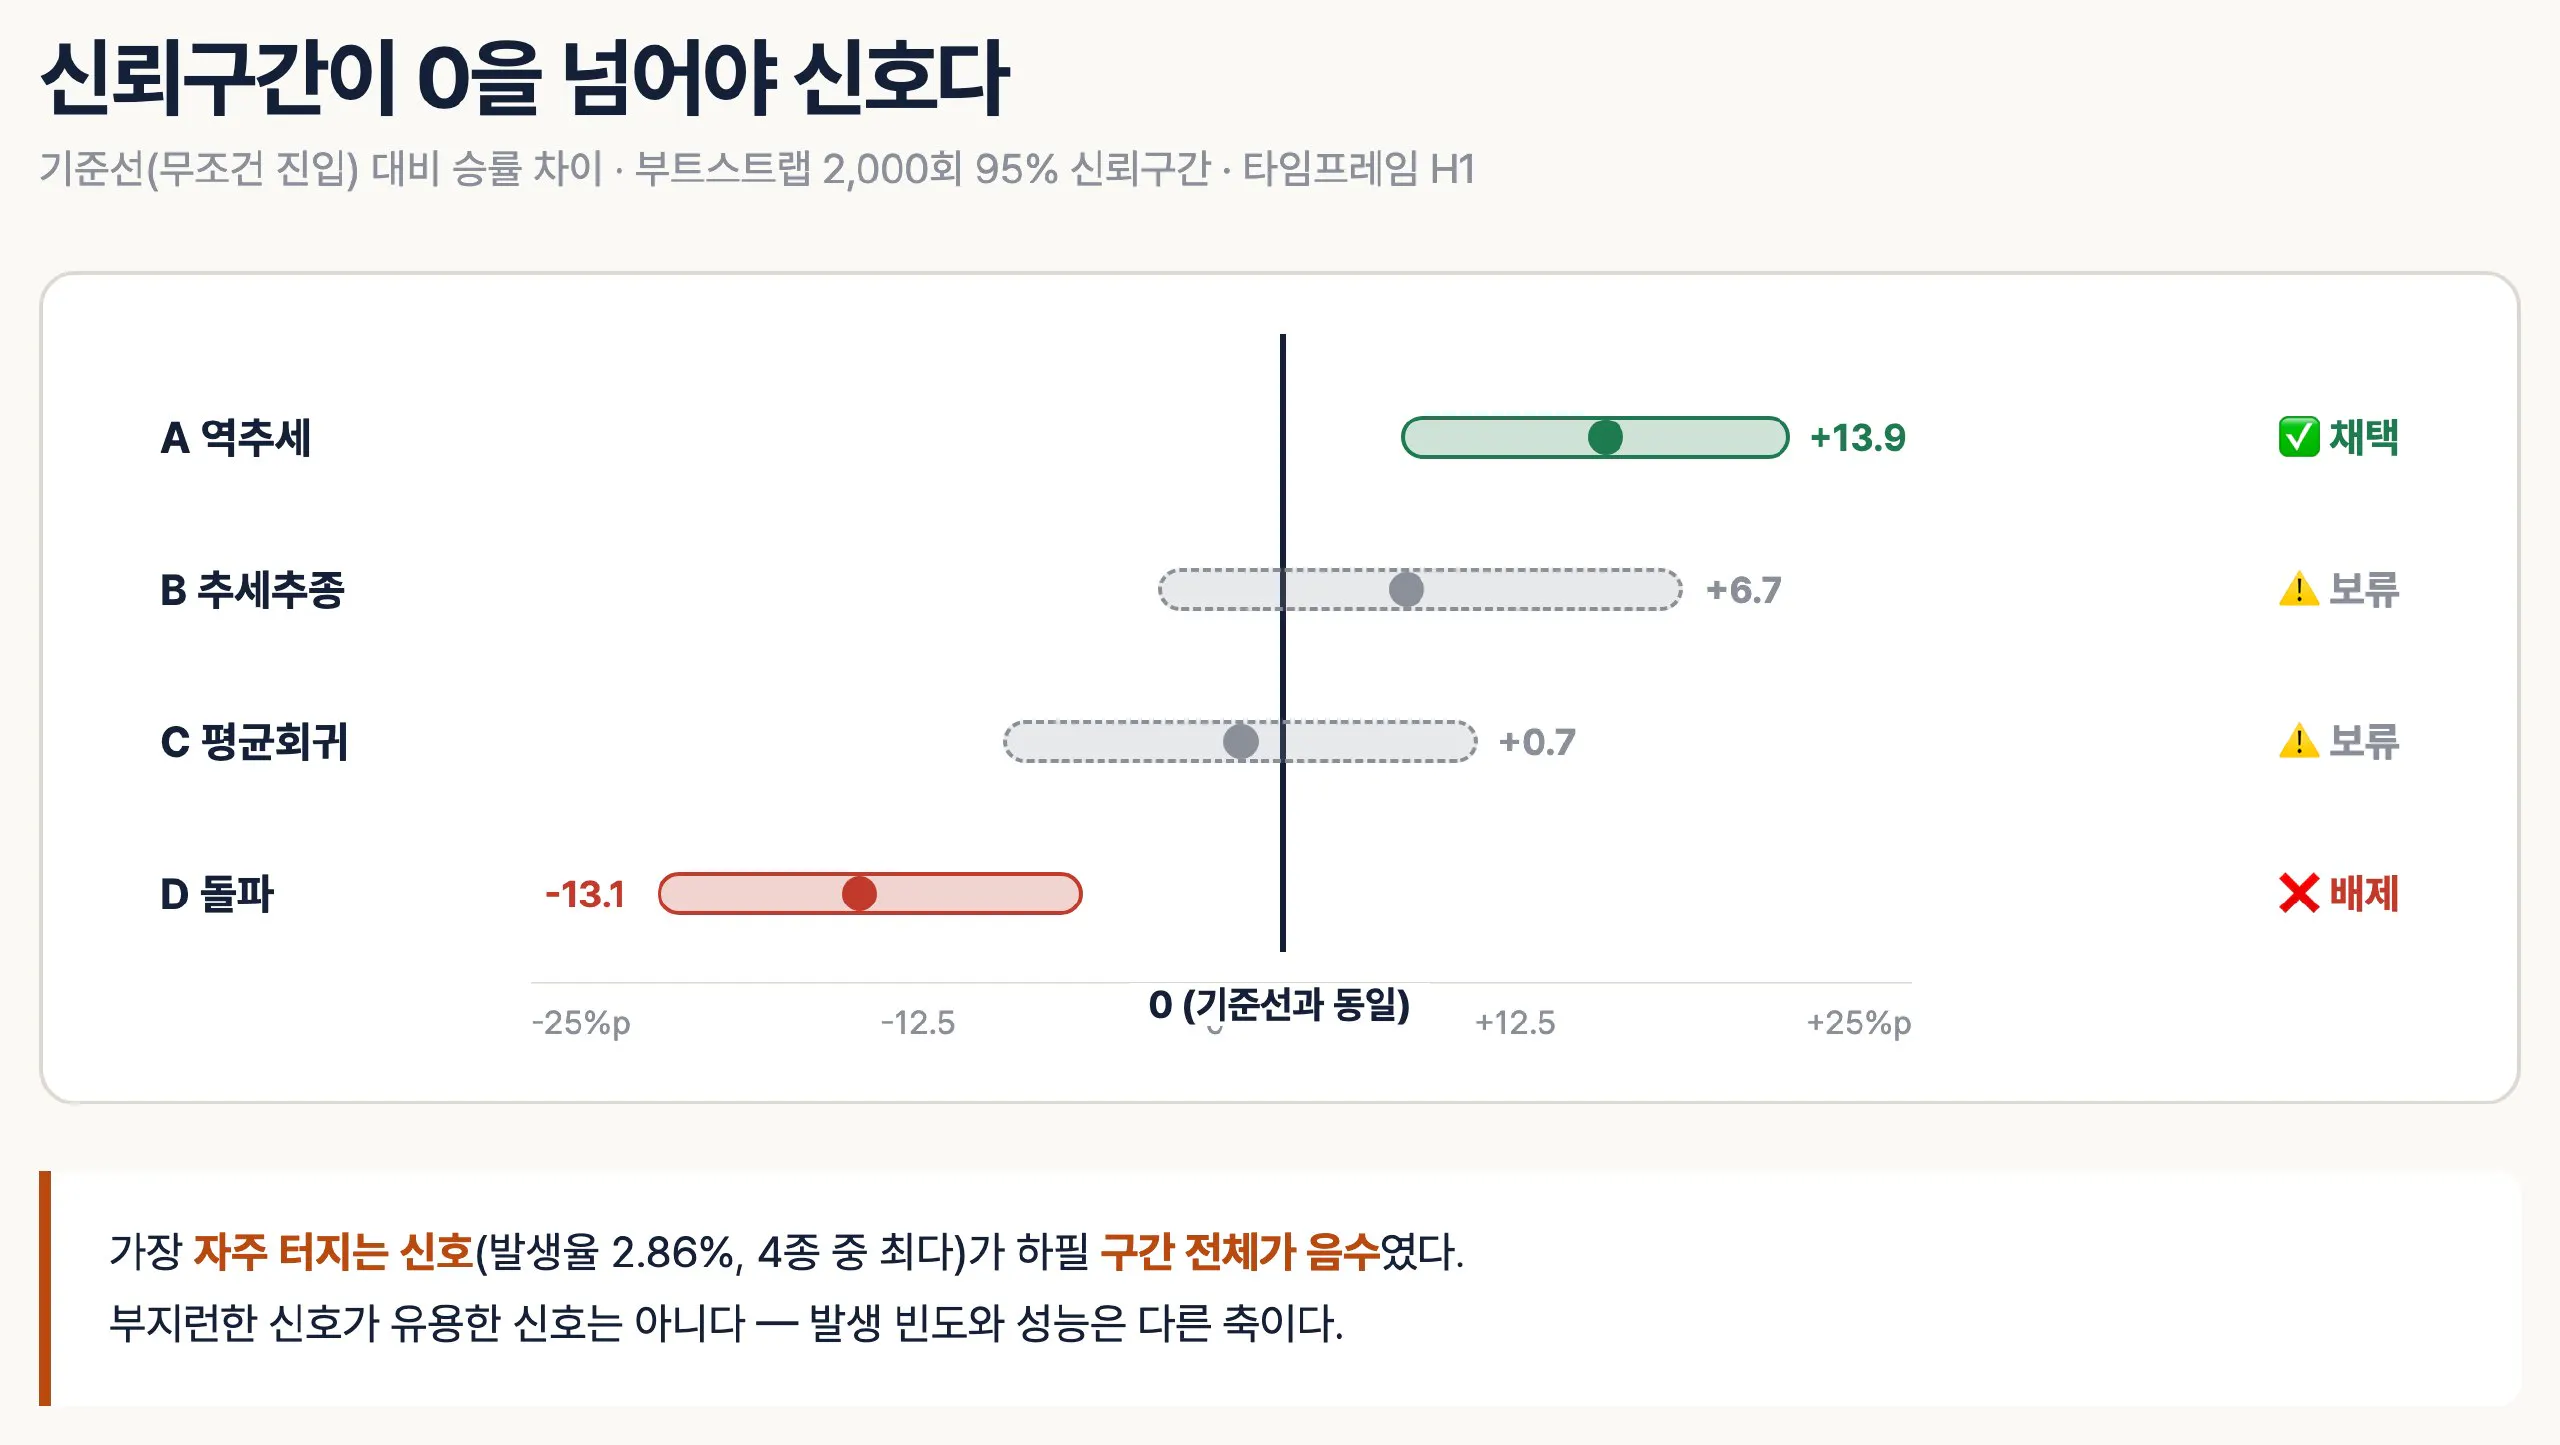
신호 4종의 기준선 대비 승률 차이와 95% 신뢰구간 — A는 구간 전체가 양수라 채택, D는 구간 전체가 음수라 배제
6막 — 그래서 쪼갠 게 옳긴 했나 (겹침 측정)
"성격이 다르게 설계했다"는 것도 제 주장일 뿐이라, 실제로 서로 다른 자리에서 신호를 내는지 쟀습니다. 두 신호가 같은 시점에 얼마나 함께 뜨는지를 보는 지표(Jaccard)입니다.
쌍
함께 뜬 횟수
Jaccard
A ∩ C
86
0.092
B ∩ D
35
0.029
나머지 4쌍
0
0.000
전부 0.1 미만 — 중복이 거의 없습니다. 4개로 쪼갠 설계 자체는 검증됐습니다.
재밌는 건, 같은 측정법을 다른 작업(검증 스킬 4종)에 썼을 땐 Jaccard 0.9가 나와서 하나를 없앴다는 겁니다. 같은 자로 쟀는데 이번엔 정반대 결론이 나왔죠. 측정이 결론을 정하는 것이지, 결론이 측정을 정하는 게 아니라는 걸 두 번 확인한 셈입니다.
7막 — 막힘 2: 우산이 목차가 될 뻔했다
우산 문서에 "D는 H1에서 배제"라고 적어놨습니다. 그런데 실제 스캐너 코드는 여전히 4개를 다 계산해서 다 출력하고 있었습니다.
문서엔 규칙이 있고 코드는 안 따르면, 그건 우산이 아니라 목차입니다.
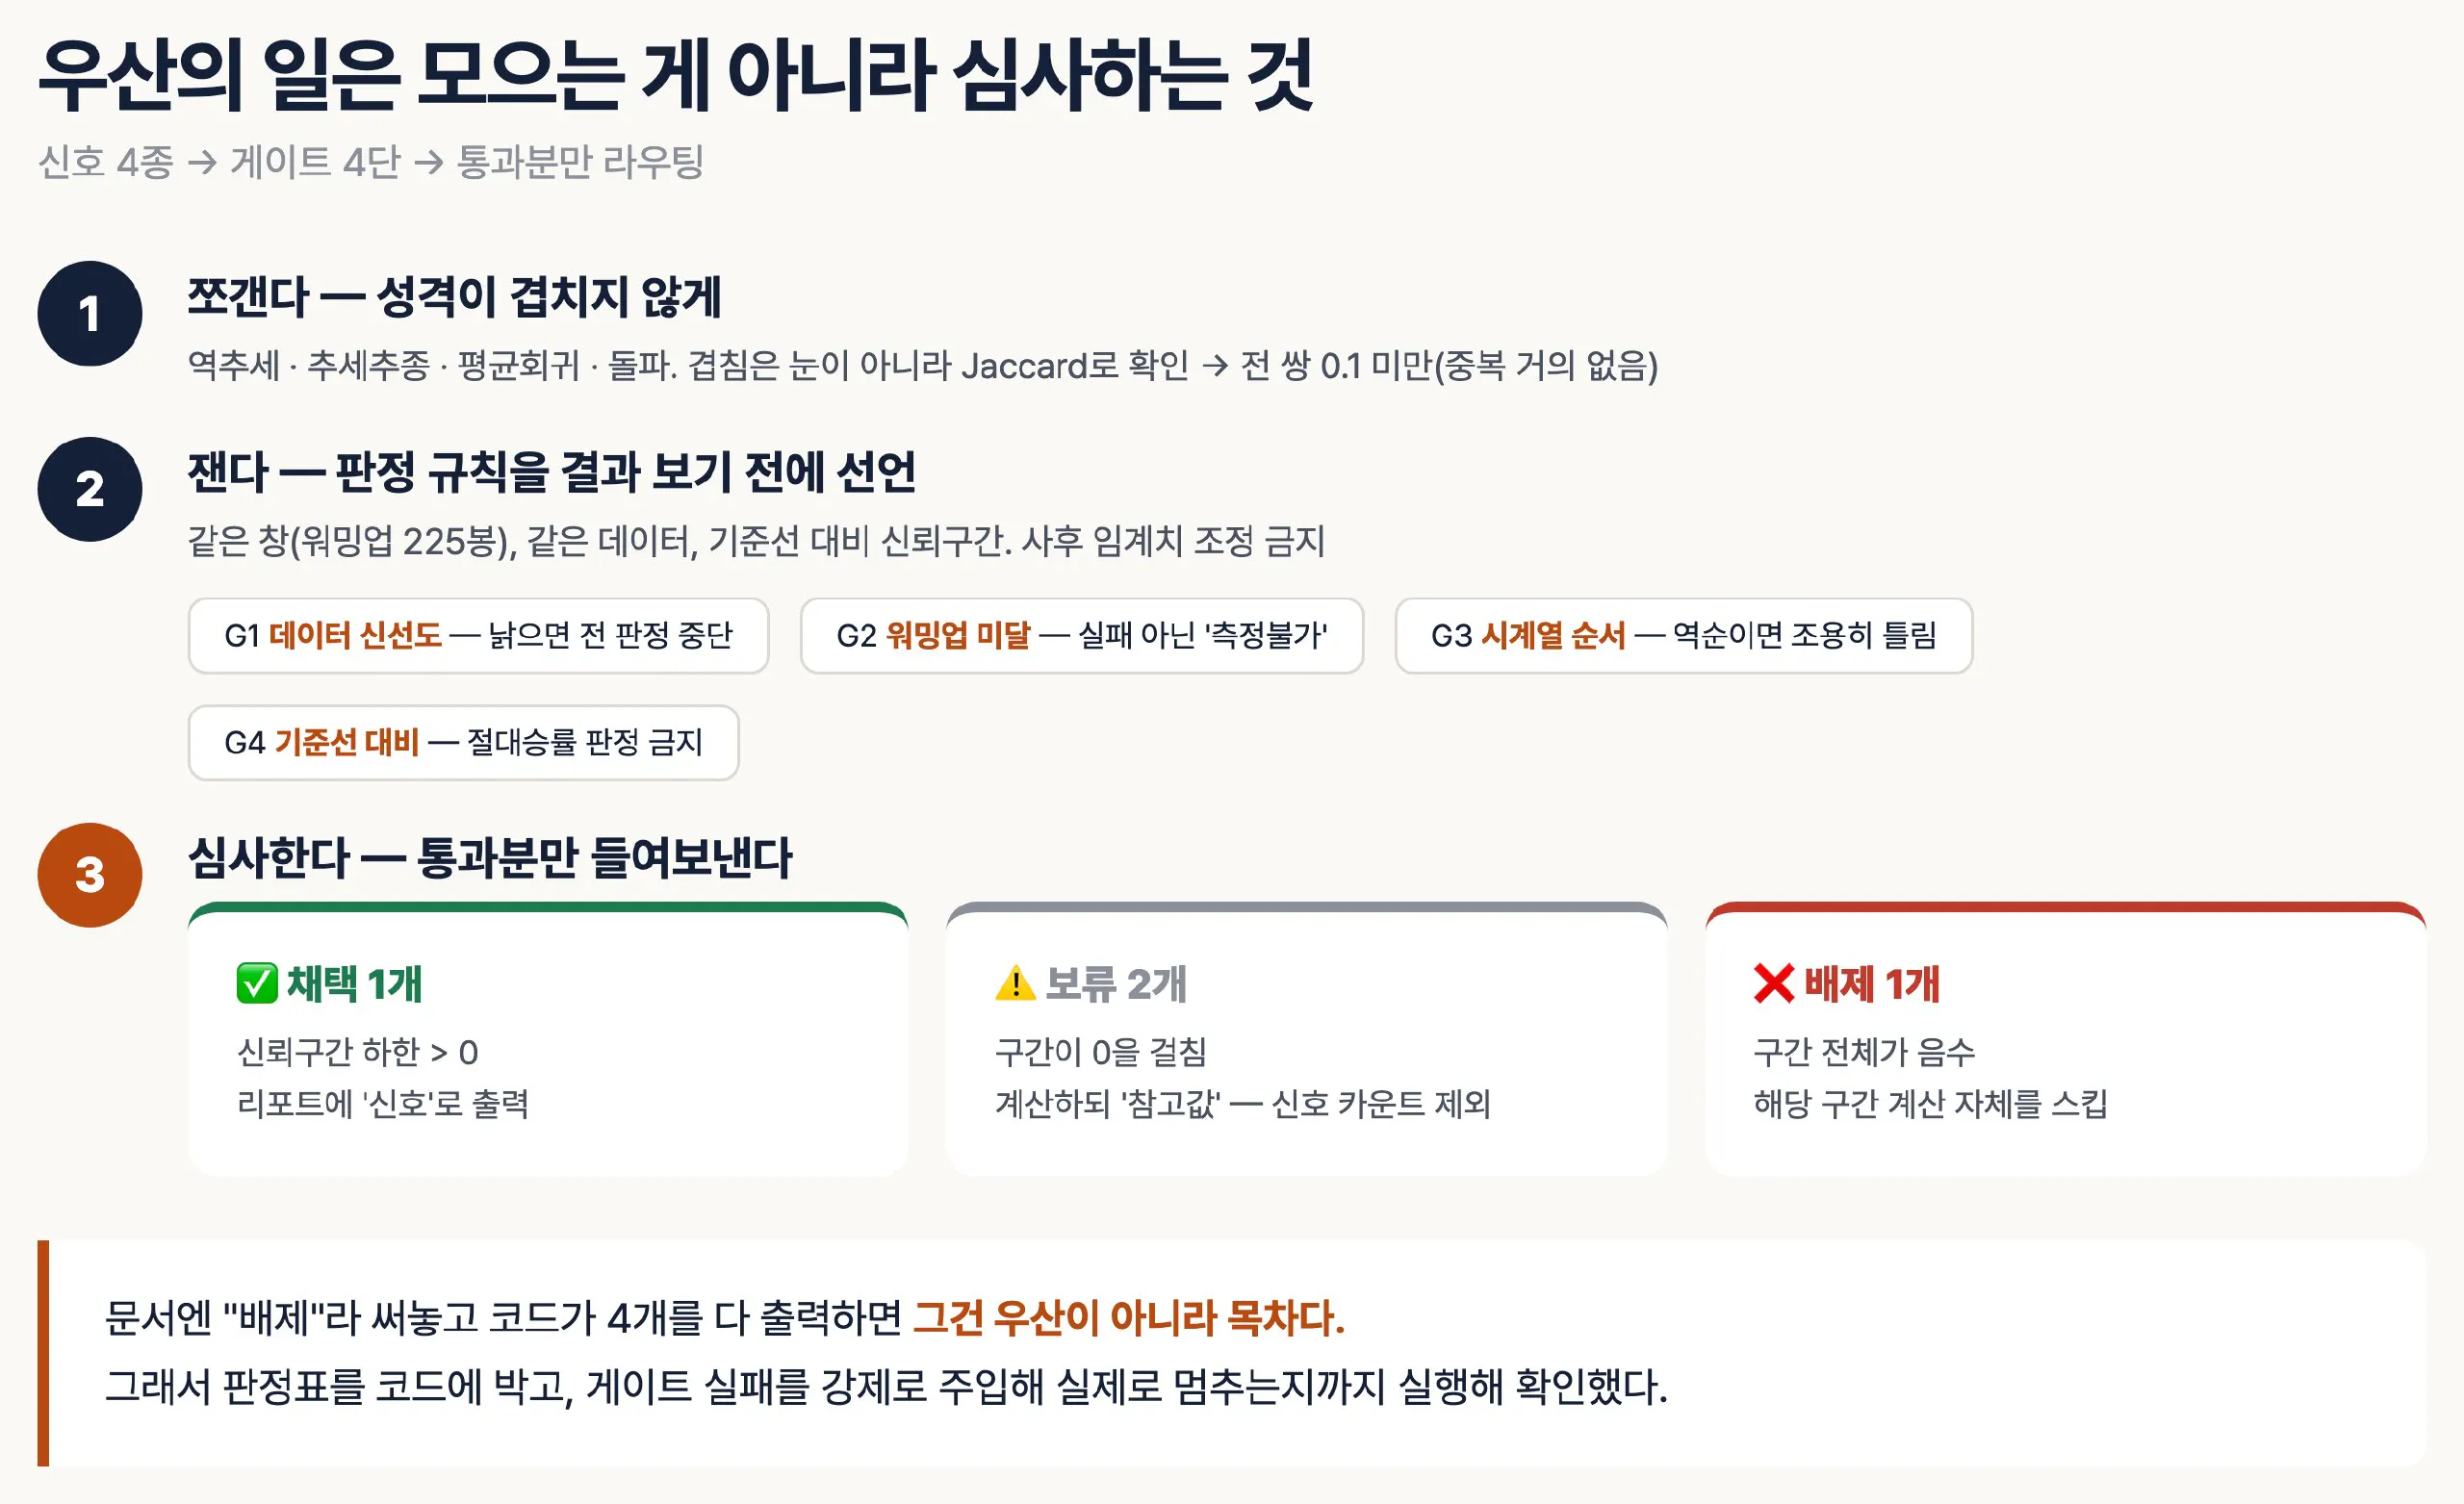
그래서 판정표를 코드 안에 직접 박고, 세 가지를 실제로 돌려 확인했습니다.
게이트 실패 주입 — 데이터가 낡았다고 강제로 속였을 때 전체 판정이 멈추는가 → 멈춤 ✅
판정표 대조 — 코드에 박힌 라우팅이 실측 결과 파일과 4/4 일치하는가 → 일치 ✅
라이브 실행 — 배제 규칙에 걸린 조합이 실제로 계산에서 빠지는가 → 4건 스킵 확인 ✅
그리고 우산을 실제 스킬 폴더에 배치했습니다. 1주차에 제가 "기록은 검증이 아니다"라고 써놓고 문서만 만들어둔 적이 있어서, 이번엔 배선까지 끝냈습니다.
우산 구조 3단계 — 쪼갠다·잰다(게이트 4단)·심사한다(채택1 보류2 배제1)
한국어 웹사이트 스크린샷
✅ 결과 (After)
Before (1주차)
After (2주차)
신호 스킬
통합형 1개 (조건 3개를 or로 묶음)
성격별 4개 + 우산 1개
성능 근거
없음 ("신호 0건" 관찰만)
평가점 26,400개, 기준선 대비 신뢰구간
판정 기준
—
결과 보기 전 사전 선언
채택된 신호
(판정 개념 없음)
1개 (역추세, 기준선 +9.4%p)
배제된 신호
—
1개 (돌파 @H1, 신뢰구간 전체 음수)
겹침 검증
—
Jaccard 전 쌍 0.1 미만
자동주문
없음
여전히 없음 (의도적 유지)
💬 배운 팁
효과적이었던 것
판정 규칙을 결과 보기 전에 못 박기. 이번에 B와 C는 "방향은 좋은데 신뢰구간이 0을 걸치는" 애매한 자리에 떨어졌습니다. 규칙을 미리 안 정했으면 저는 분명히 "그래도 플러스니까 채택"이라고 했을 겁니다.
절대 성능이 아니라 기준선 대비로 재기. "승률 60%"는 그 자체로 아무 의미가 없습니다. 아무 때나 들어가도 50.7%가 나오는 시장이었으니까요. 비교 대상 없는 숫자는 숫자가 아닙니다.
섞지 말고 쪼개서 재기. 통합 결과만 봤으면 D를 "보류"로 남겨뒀을 겁니다. 쪼개니 "특정 구간에서 확실히 해롭다"가 나왔습니다.
문서의 규칙을 코드가 강제하게 하기. 지키는지 안 지키는지 실행해서 확인할 수 없는 규칙은 규칙이 아니라 다짐입니다.
하지 말아야 할 것
표본 10건짜리 승률로 판정하기. 이 글의 절반이 이 이야기입니다. 71%가 60%였습니다.
"4개 만들었으니 4개 다 합치기". 우산의 가치는 모으는 데 있는 게 아니라 들여보낼지 심사하는 데 있었습니다.
좋은 결과를 본 뒤에 기준 정하기. 순서가 바뀌면 그건 측정이 아니라 사후 정당화입니다.
검증 안 된 신호를 자동주문에 연결하기. 채택된 A조차 승률 60%지 100%가 아닙니다.
🌍 다른 업무에 적용한다면
AI 프롬프트/룰이 여러 개로 늘었을 때: "느낌상 이게 낫다" 대신 ①같은 조건에서 나란히 돌리고 ②아무것도 안 했을 때(기준선)와 비교하고 ③표본이 충분한지 먼저 보세요. 순서만 지켜도 절반은 걸러집니다.
분류·검출을 하는 모든 자동화: 가장 자주 발동하는 규칙이 가장 도움이 되는 규칙은 아닙니다. 이번에도 발생 1위가 성능 꼴찌였습니다.
지표를 집계해서 보고하는 업무: 전체 평균만 보면 상쇄돼서 사라지는 신호가 있습니다. 세그먼트별로 쪼개면 "애매함"이 "확실한 문제"로 바뀝니다.
문서화된 규칙이 있는 모든 팀: 그 규칙이 실제로 지켜지는지 자동으로 확인할 방법이 없다면, 규칙은 문서 안에서만 살아 있습니다.
🚀 앞으로의 계획 — 보류를 판정으로 바꾸는 3주차
이번 우산은 채택 1 / 보류 2 / 배제 1로 끝났습니다. 보류 2개는 실패가 아니라 **"아직 못 정했다"**는 정직한 상태고, 3주차는 이 미결 상태를 줄이는 작업입니다.
보류 2종을 판정으로 확정한다 — 표본을 2배로 늘려 재측정합니다. 신뢰구간 하한이 0을 넘으면 채택, 여전히 걸치면 "표본을 늘려도 안 되는 신호"로 결론 냅니다. 어느 쪽이든 미결은 없앱니다.
배제된 돌파 신호를 고쳐서 재도전한다 — 되돌림 필터를 붙인 뒤 다시 잽니다. 개선 못 하면 그대로 폐기합니다.
하네스로 올린다 — 지금은 제가 명령을 쳐야 도는 스캔입니다. 정기 실행으로 옮기고, 채택된 신호가 실제로 발생했을 때만 알림이 오게 합니다. 조용한 게 기본값입니다.
판정 기록을 쌓는다 — 이번 결과는 2026년 7월 30일 시점 스냅샷입니다. 시장이 바뀌면 채택된 A도 무너질 수 있으니, 재측정할 때마다 판정 이력을 남겨 성능이 언제 꺾였는지 나중에 되짚을 수 있게 합니다.
자동주문은 여전히 붙이지 않습니다 — 승률 60%는 40%는 틀린다는 뜻입니다. 주문 단계는 검증이 더 쌓인 뒤, 그것도 승인제로 갑니다.
