


소개
안녕하세요. 22기 에이전틱AI투자 스터디에 참여중인 찰스림입니다.
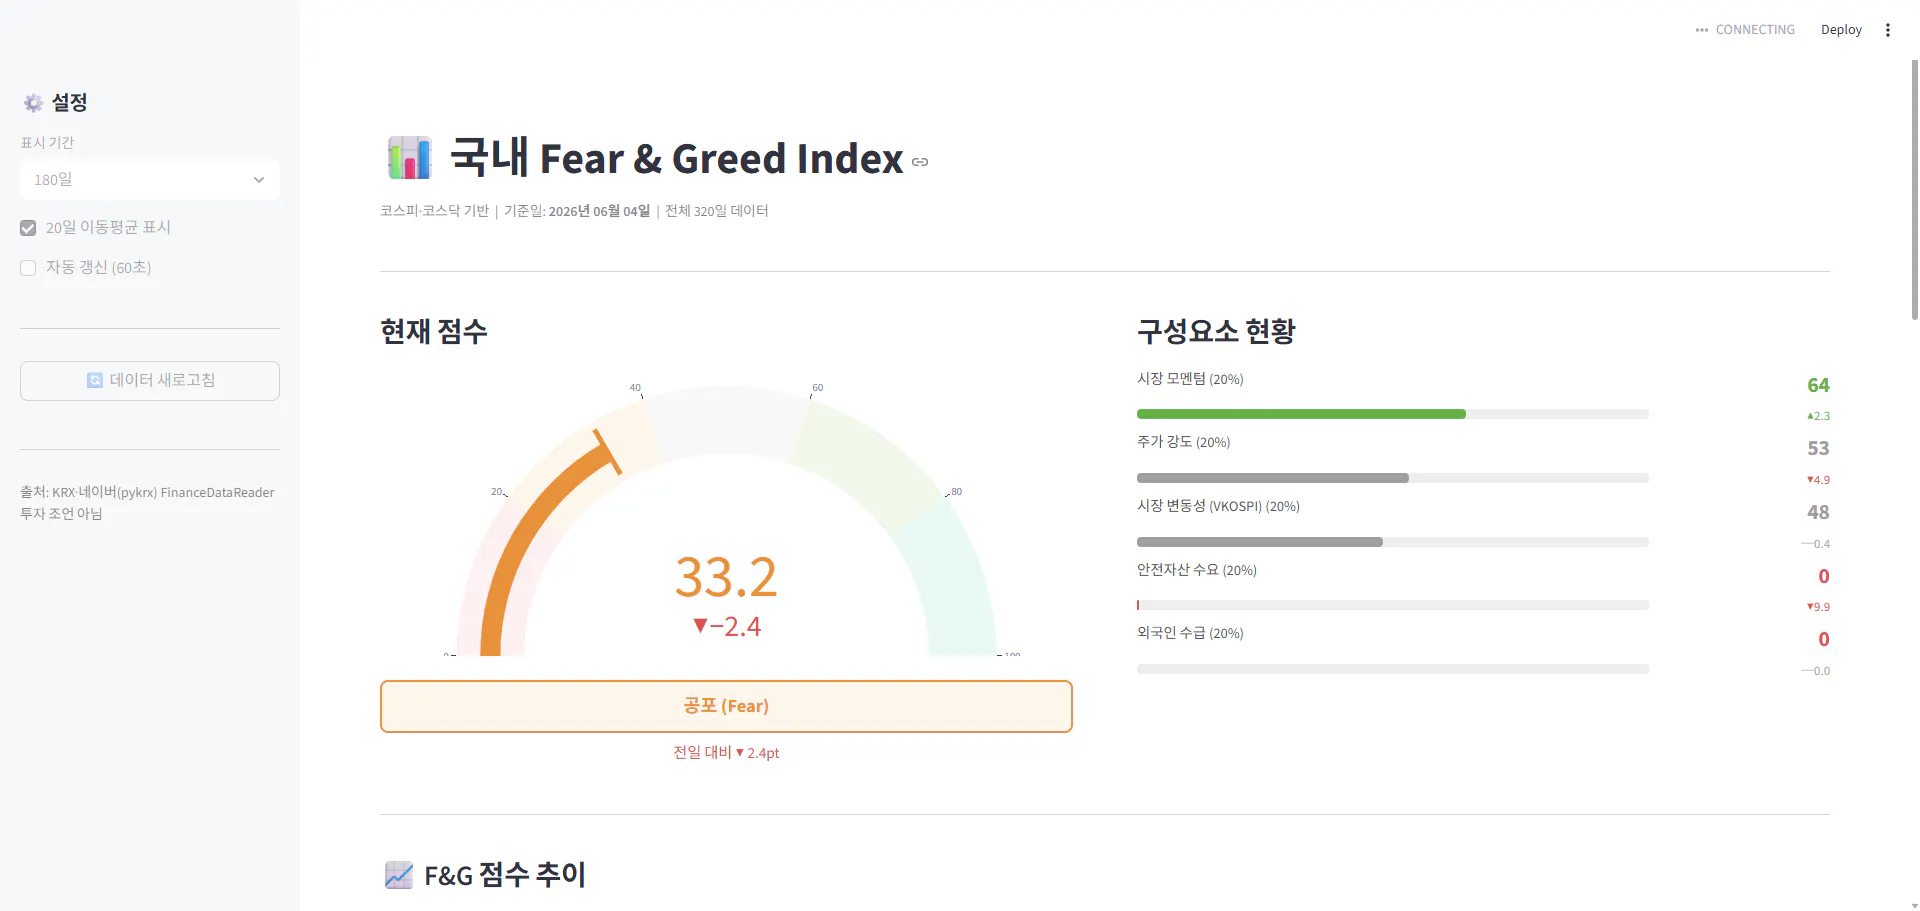
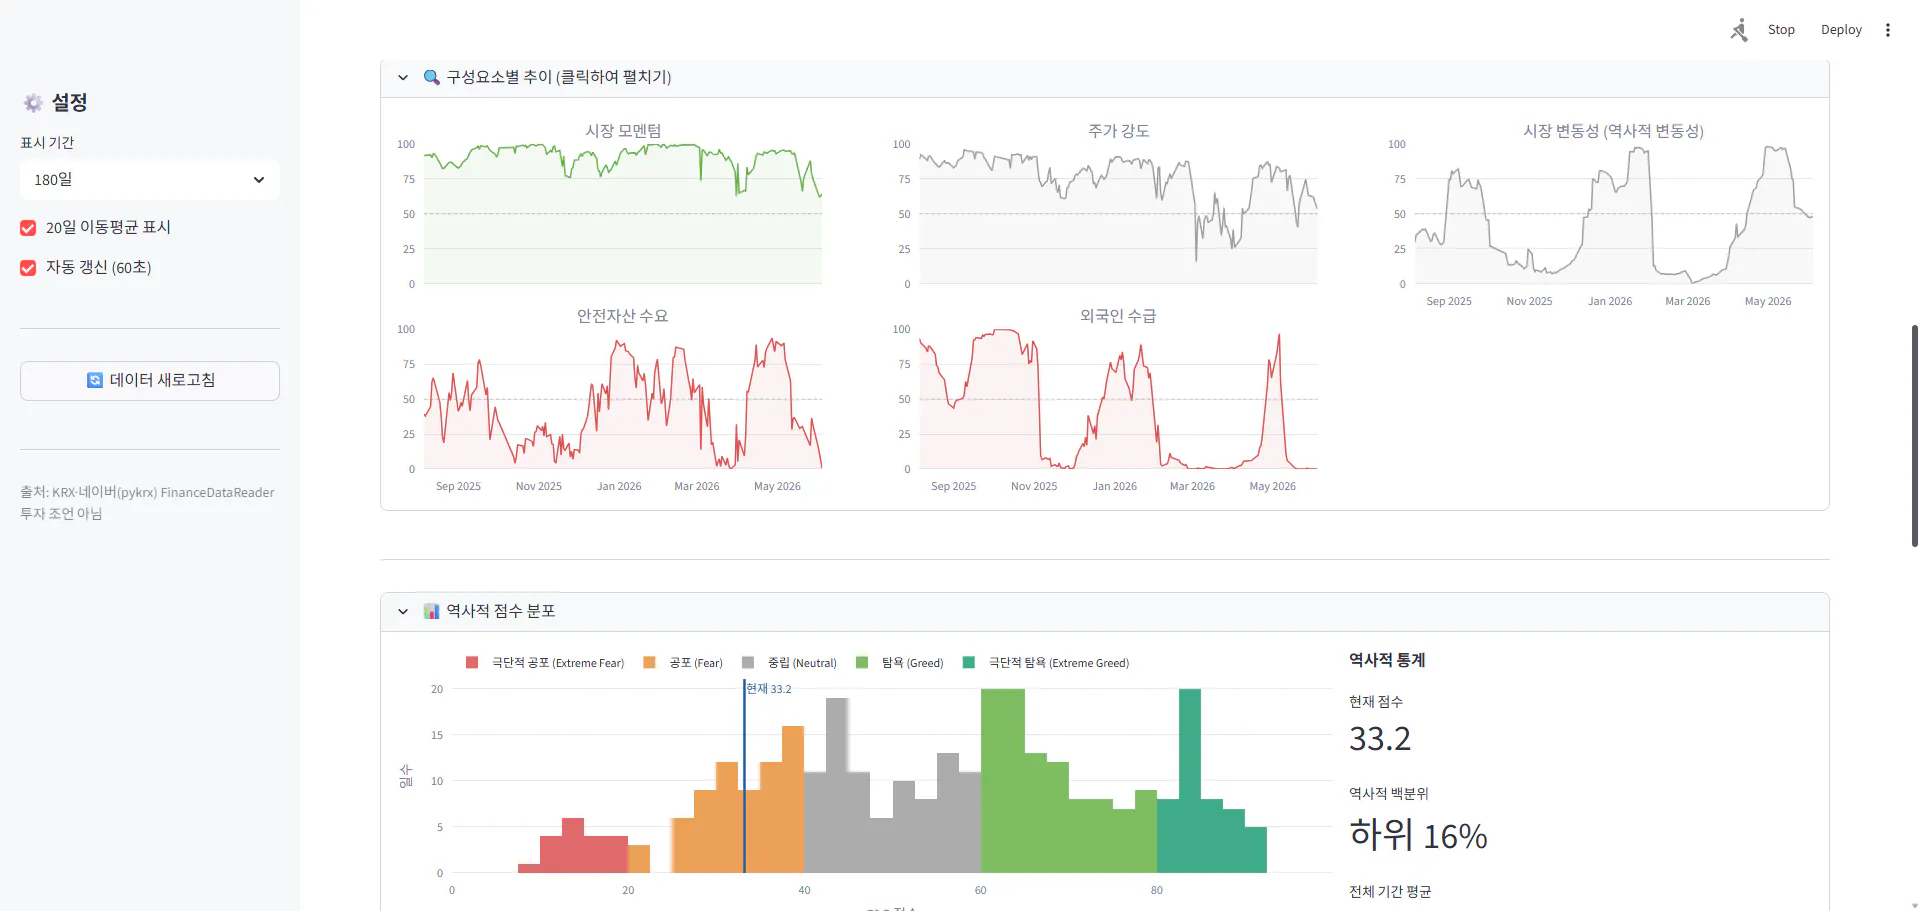
이번에는 공포탐욕지수를 클로드 및 구글 안티그래비티를 활용하여, 재구성해보았습니다. 시중에 좋은 사이트들이 있는데, 이 원리들을 탐구하고, 지표를 만들기까지의 수많은 DB의 출처들을 배우고자 유사하게 만들어보았습니다. 실행 과정 중 발생한 오류에 대해 잠시 이야기 나누고자 합니다.
코스피·코스닥 데이터를 기반으로 국내 시장의 공포와 탐욕 수준을 0~100 점수로 나타내는 '국내 Fear & Greed 지수(공포탐욕지수)' 계산 파이프라인(build_history.py)이 갑자기 실행되지 않는 문제가 발생했습니다.
파이프라인은 5가지 구성 지표 — 시장 모멘텀, 주가 강도, 시장 변동성, 안전자산 수요, 외국인 수급 — 를 각각 0~100으로 정규화(롤링 백분위 방식, 504거래일 기준)한 뒤 가중 합산하는 구조였습니다.
오류의 원인은 두 가지였습니다.
첫째, 한국거래소(KRX) 웹 API 보안 정책 강화입니다. 기존에 지수 시세와 외국인 수급 데이터를 담당하던 pykrx 라이브러리가 비인증 요청에 대해 400 Bad Request 및 세션 로그아웃을 반환하기 시작했고, 그 결과 KeyError: '지수명' 오류가 발생했습니다.
둘째, Yahoo Finance의 ^VKOSPI 데이터 제공 중단입니다. 변동성 지표의 핵심 소스였던 yfinance의 코스피200 변동성 지수(VKOSPI) 데이터가 404 오류를 반환하며 수집이 불가능해졌습니다.
두 외부 의존성이 동시에 무너지면서 전체 시스템이 구동되지 않는 상태가 되었습니다.
진행 방법
사용 도구: Python 3.12, Pandas, Requests, BeautifulSoup4, FinanceDataReader
수행 과정:
1단계 — 오류 분석 터미널에서 전체 빌드 프로세스를 실행해 오류 로그를 확인했습니다. pykrx 호출 시 400 Bad Request, yfinance 호출 시 404 Not Found가 각각 발생함을 확인하고, 두 라이브러리 모두 현재 환경에서 정상 동작이 불가하다는 결론을 내렸습니다.
2단계 — 대체 아키텍처 설계 로그인 인증을 요구하게 된 pykrx와 서비스가 중단된 yfinance를 완전히 걷어내고, 무인증으로 안정적으로 데이터를 수집할 수 있는 구조로 전면 전환하기로 결정했습니다.
지수 시세 →
FinanceDataReader(FDR) 로 대체외국인 수급 → 네이버 금융 투자자별 매매동향 페이지 직접 스크래핑
VKOSPI → KOSPI 종가 기반 20일 역사적 연화 변동성(HV) 자체 계산
3단계 — 외국인 수급 크롤러 직접 구현 네이버 금융의 투자자별 매매동향 일별 페이지(investorDealTrendDay.nhn)에 직접 HTTP 요청을 보내 파싱하는 전용 스크래퍼를 구현했습니다.
4단계 — 변동성 지표 재설계 CNN Fear & Greed Index의 VIX vs 50일 이동평균 이격률 방식을 준용하되, 외부 API 없이 KOSPI 종가로 직접 계산하도록 공식을 변경했습니다.
5단계 — 전 모듈 연동 검증 config.py → collectors.py → indicators.py → engine.py → build_history.py로 이어지는 파이프라인 전체를 검토하며 잔여 VKOSPI 참조, 구버전 pykrx 코드 등을 일괄 정리했습니다.
핵심 코드
collectors.py — 네이버 금융 외국인 순매수 크롤러
python
def fetch_foreign_netvalue_naver(market: str, start_iso: str, end_iso: str) -> pd.Series:
    sosok = "01" if market.upper() == "KOSPI" else "02"
    start_dt = datetime.strptime(start_iso, "%Y-%m-%d")
    end_dt   = datetime.strptime(end_iso,   "%Y-%m-%d")
    bizdate  = end_dt.strftime("%Y%m%d")

    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"}
    records, page, finished = [], 1, False

    while page <= 100:
        url = (
            f"https://finance.naver.com/sise/investorDealTrendDay.nhn"
            f"?bizdate={bizdate}&sosok={sosok}&page={page}"
        )
        resp = requests.get(url, headers=headers, timeout=10)
        if resp.status_code != 200:
            break

        dfs = pd.read_html(BytesIO(resp.content), encoding="euc-kr")
        df  = dfs[0].dropna(how="all")

        for _, row in df.iterrows():
            try:
                dt = datetime.strptime(str(row.iloc[0]).strip(), "%y.%m.%d")
            except ValueError:
                continue
            if dt < start_dt:
                finished = True
                break
            if dt <= end_dt:
                val = float(str(row.iloc[2]).replace(",", ""))  # 외국인 순매수 (억 원)
                records.append((dt, val))

        if finished:
            break
        page += 1
        time.sleep(0.05)

    dates, values = zip(*records)
    return pd.Series(list(values), index=pd.to_datetime(list(dates))).sort_index()
indicators.py — KOSPI 역사적 변동성 계산
python
def volatility_raw(kospi_close: pd.Series) -> pd.Series:
    """
    KOSPI 20일 역사적 연화 변동성(annualized HV) vs 50일 이동평균 이격률.
    CNN VIX vs 50일 MA 방식을 외부 API 없이 자체 구현.
    """
    returns = kospi_close.pct_change()
    vol = returns.rolling(20).std() * (252 ** 0.5) * 100.0  # 연화(%)
    ma  = vol.rolling(50).mean()
    return vol / ma - 1.0  # 양(+)이면 평균 이상 변동성 → 공포
결과와 배운 점
배운 점: 외부 공개 패키지에만 의존하면 타깃 사이트의 크롤링 차단이나 API 스펙 변경에 속수무책이 됩니다. 지수 시세처럼 안정적으로 관리되는 공인 API 캐시(FinanceDataReader)와 가벼운 직접 스크래핑(네이버 금융)을 하이브리드로 구성하는 편이 훨씬 견고하고 지속 가능합니다.
꿀팁: 네이버 금융처럼 비교적 크롤링이 쉬운 사이트도 단순 URL 요청만으로는 빈 테이블이 반환됩니다. 두 가지를 반드시 챙겨야 합니다.
bizdate=YYYYMMDD파라미터 필수: 기준 날짜 없이 요청하면 테이블 바디가 비어 있음User-Agent헤더 필수: 브라우저 요청 흐름을 모방해야 차단 없이 데이터 수신 가능
개발자 도구의 Network 탭으로 실제 브라우저 요청 파라미터를 확인하는 습관이 크롤링 문제 해결의 핵심입니다.
그래프를 보여주는 웹페이지의 스크린샷
중국어로 된 대시보드 스크린샷
시행착오
investorDealTrendDay.nhn 페이지를 처음 요청할 때 sosok 파라미터만 넣었더니 테이블 바디가 텅 빈 상태로 반환되었습니다. 개발자 도구 Network 탭을 분석한 결과, 네이버 금융 서버가 bizdate=YYYYMMDD 형태의 기준일 파라미터를 필수로 요구하도록 바뀌어 있었습니다. 이를 추가하자마자 일별 누적 데이터(7,800바이트 이상)가 정상 수신되었습니다.
또한 pd.read_html() 호출 시 encoding="euc-kr" 옵션 누락으로 한글 컬럼명이 깨지는 문제, 숫자 컬럼의 쉼표(,) 미처리로 float() 변환이 실패하는 문제도 겪었습니다. 두 처리를 추가한 후 안정화되었습니다.
앞으로의 계획
수집된 국내 공포탐욕지수 시계열 데이터를 SQLite DB로 적재하고 있습니다. 이 점수를 기반으로 한 국내 자산 배분·분할 매매 알고리즘을 연동해 실제 백테스트 결과를 활용해 볼 예정입니다. 극단적 공포 구간 매수, 극단적 탐욕 구간 분할 매도 전략의 유효성을 코스피 데이터로 검증하는 것이 다음 목표입니다.
참고: 네이버 금융 투자자별 일별 매매동향 크롤링 구현 방법 (GitHub Gist 및 금융 퀀트 크롤링 커뮤니티 가이드)
