


소개
1주차에는 회사의 AI 비서팀을 어떻게 운영하면 좋을지 고민했습니다.
겉으로는 팀원들이 각자 편하게 쓰는 개인 비서처럼 보이되, 안쪽에는 LLM Wiki와 업무 하네스가 받쳐주는 구조를 상상했습니다.
그런데 2주차에 들어오니 다른 질문이 남았습니다.
“그렇다면 AI 비서들이 참고하는 지식창고 자체는 믿을 수 있는 구조인가?”
처음에는 봇마다 결과물이 다른 문제가 단순한 성능 차이처럼 보였습니다.
예를 들어 같은 “블로그 글 작성” 업무를 맡겨도 결과가 조금씩 달랐는데,
어떤 봇은 제목 후보는 잘 뽑지만 승인 필요 여부를 놓쳤습니다.
어떤 봇은 본문은 길게 쓰지만 브랜드 톤이나 금지 표현을 확인하지 않았습니다.
어떤 봇은 자료를 잘 요약했지만, 그 요약이 회사 기준으로 확정된 내용인지 구분하지 않았습니다.
처음에는 “봇을 더 잘 만들면 되나?”라고 생각했지만
다시 들여다보니 문제는 봇보다 지식창고 안에 있는것 같았습니다.
봇들이 참고할 LLM Wiki 안에서 무엇이 원본이고, 무엇이 AI 해석이고, 무엇이 회사 기준인지 구분되어 있지 않았습니다.
그래서 이번 2주차 작업의 목표는 단순히 자료를 더 많이 넣는 것이 아니었습니다.
LLM Wiki를 실제 운영 가능한 지식창고 구조로 다시 정리하는 것이었습니다.
한국어로 된 웹사이트의 홈페이지
진행 방법
1. 먼저 질문을 바꿨습니다
2주차 과제에는 LLM Wiki, SCHEMA, index, log, 원본과 요약 분리, Ontology, DB, Graph, OpenViking, Harness 같은 여러 요소가 있었습니다.
처음에는 이 도구들을 전부 붙여야 하나 고민했습니다.
하지만 회사 내부 시스템에 그대로 적용하면 범위가 너무 커질 수 있었습니다.
그래서 질문을 이렇게 바꿔보기로 했습니다.
“어떤 도구를 전부 붙일까?”가 아니라,
“우리 회사 AI 비서팀이 같은 기준으로 일하려면 Wiki 안에 어떤 운영 규칙이 필요할까?”
이렇게 질문을 바꾸자 우선순위가 훨씬 선명해졌습니다.
기본 LLM Wiki 구조는 반드시 정리한다.
원본과 AI 요약은 반드시 분리한다.
회사 기준으로 승격되는 흐름을 만든다.
봇 결과물을 검토할 하네스를 만든다.
답변이 어떤 근거에서 나왔는지 확인하는 Query 검증을 추가한다.
Graphiti, OpenViking 같은 확장 도구는 실제 연결보다 개념을 먼저 반영한다.
DuckDB까지 무리해서 붙이기보다 SQLite로 작게 관측한다.
즉, 이번 작업은 “도구를 많이 붙이는 프로젝트”가 아니라
AI 비서들이 같은 기준으로 일할 수 있게 지식창고의 바닥을 정리하는 작업이었습니다.
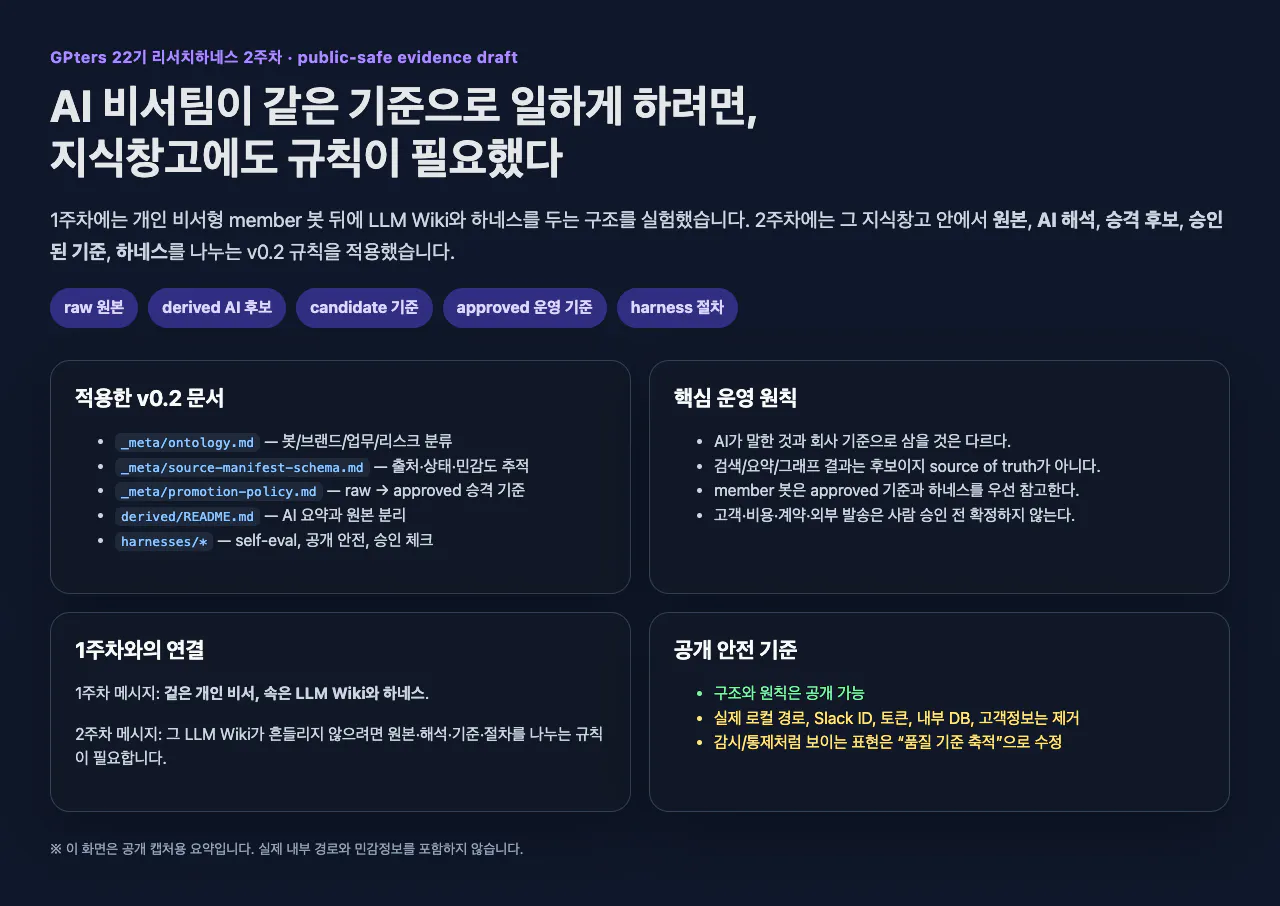
2. LLM Wiki v0.2 구조를 만들었습니다
이번에 기존 SSB LLM Wiki를 v0.2 구조로 확장했습니다.
핵심은 자료를 많이 쌓는 것이 아니라, 자료의 상태를 나누는 것이었습니다.
구조를 단순화하면 다음과 같습니다.
raw/        → 원본 자료

derived/    → AI 요약, self-eval, 관측 결과처럼 아직 기준으로 확정되지 않은 파생 결과

_meta/      → ontology, source manifest, promotion policy

harnesses/  → 봇이 일할 때 따를 절차와 검토 기준

brands/     → 브랜드별 기준

workflows/  → 반복 업무별 작업 방식

risks/      → 공개 발송, 승인 필요 조건 같은 리스크 규칙
이번에 추가하거나 정리한 주요 문서는 다음과 같았습니다.
_meta/ontology.md
_meta/source-manifest-schema.md
_meta/promotion-policy.md
derived/README.md
harnesses/add-source-to-ssb-llmwiki.md
harnesses/bot-output-llmwiki-self-eval.md
harnesses/public-case-post-safety-check.md
harnesses/member-bot-output-approval-check.md
harnesses/llmwiki-query-grounding-check.md
여기서 가장 중요하게 본 것은 raw, derived, candidate, approved, harness의 구분이었습니다.
AI가 정리한 문서는 유용합니다.
하지만 AI가 정리했다고 해서 바로 회사 기준이 되는 것은 아닙니다.
그래서 이번 구조에서는 문서의 상태를 이렇게 나눠 보려고 했습니다.
raw          원본 자료

derived      AI 요약, self-eval, 관측 결과 같은 파생 자료

candidate    아직 검토 중인 후보 기준

approved     실제 업무 기준으로 써도 되는 승인 기준

harness      봇이 따라야 할 절차와 검토 체크리스트
이 구분이 없으면 시간이 지날수록 이런 문제가 생길 수 있습니다.
어디까지가 원본인지 알기 어렵습니다.
임시 요약이 확정 기준처럼 쓰일 수 있습니다.
봇이 오래된 문서를 최신 기준처럼 가져올 수 있습니다.
그래서 이번에는 지식을 더 넣기 전에,
지식이 기준이 되는 과정을 먼저 만들었습니다.
3. promotion policy를 만들었습니다
이번 작업에서 가장 중요했던 문서는 _meta/promotion-policy.md였습니다.
이 문서는 쉽게 말하면 이런 질문에 답하는 규칙입니다.
이 문서는 아직 참고 자료인가?
AI가 정리한 후보인가?
사람이 검토한 기준인가?
실제 업무에서 봇이 따라도 되는 승인 기준인가?
LLM Wiki를 그냥 폴더처럼 쓰면, 처음에는 편합니다.
하지만 시간이 지나면 “이 문서를 기준으로 삼아도 되나?”라는 질문이 계속 생깁니다.
그래서 저는 LLM Wiki를 이렇게 보기로 했습니다.
LLM Wiki는 AI가 뭔가를 저장해두는 곳이 아니라, 원본이 검토를 거쳐 기준으로 승격되는 과정을 관리하는 운영 장치다.
이 관점으로 보니 Wiki 안의 문서가 단순 파일이 아니라, 각각의 상태를 가진 운영 자산처럼 보이기 시작했습니다.
4. 하네스를 만들고 실제 self-eval에 사용했습니다
이번에 만든 하네스 중 하나는 bot-output-llmwiki-self-eval입니다.
이 하네스는 봇의 결과물을 볼 때 다음을 확인합니다.
근거가 있는 주장인가?
Wiki 구조와 맞는가?
사람 승인이 필요한가?
다음 행동으로 이어질 수 있는가?
“하네스를 만들었다”에서 멈추지 않고, 하네스로 결과물을 다시 검토하는 루프를 만들었다는 점입니다.
5. Query 검증을 추가했습니다
문서 구조를 만든 뒤에는 실제 질문도 던져봤습니다.
LLM Wiki가 “자료를 저장하는 곳”을 넘어서, 답변의 근거를 확인하는 장치로 쓸 수 있는지 보고 싶었습니다.
검증한 질문은 세 가지였습니다.
1. member 봇이 외부 발송 문구나 고객 응대 초안을 사람 승인 없이 바로 보내도 되는가?

2. 하나코/orchestrator01과 유우카/member01의 역할은 어떻게 다른가?

3. 어워즈워즈 블로그 글 작성 요청이 들어왔을 때 member 봇은 어떤 Wiki와 하네스를 어떤 순서로 확인해야 하는가?
이때 답변은 그냥 “그럴듯하게” 쓰지 않게 했습니다.
대신 아래 항목을 함께 남기도록 했습니다.
claim
source_ref
evidence_type
promotion_state
confidence
승인 필요 여부
리스크와 다음 액션
이 작업을 해보니 LLM Wiki가 단순 검색 저장소가 아니라,
답변이 어떤 근거에서 나왔는지 확인하는 운영 장치에 가까워졌습니다.
특히 좋았던 점은 “정답처럼 보이는 답변”보다 “근거가 드러나는 답변”을 더 중요하게 보게 됐다는 것입니다.
6. SQLite로 source manifest를 작게 관측했습니다
처음에는 DuckDB까지 설치할지 고민했습니다.
하지만 이번 목적은 데이터 분석 DB를 멋지게 붙이는 것이 아니었습니다.
이번에 보고 싶었던 것은 단순했습니다.
“현재 LLM Wiki 안에 어떤 자료가 있고, 각각 어떤 상태인가?”
그래서 Python 표준 SQLite를 사용해서 source manifest를 작게 관측했습니다.
관측 결과는 다음과 같았습니다.
전체 manifest 항목 수: 59개
query result 항목 수: 4개
public candidate 항목 수: 4개
중복 content hash: 0건
source_type 분포: case evidence, raw source, workflow, brand wiki, harness, meta rule 등으로 분리됨
이 결과를 보면서 LLM Wiki가 단순한 폴더 묶음에서 조금 더 운영 가능한 구조로 바뀌고 있구나...라고 생각이 들었습니다.
다만 여기서도 과장하지 않으려고 했습니다.
SQLite 관측값은 진실을 판단하는 장치가 아닙니다.
어디까지나 자료 상태를 확인하는 작은 계기판입니다.
실제 근거는 여전히 원본 문서와 검토 로그에 있어야 합니다.
7. 실제 member 봇 Before/After 테스트를 해봤습니다
문서 구조만 만들고 끝내면 조금 아쉬웠습니다.
그래서 같은 요청을 member 봇에 두 번 맡겨봤습니다.
요청은 하나였습니다.
어워즈워즈 블로그 글 하나 써줘.
주제는 수상 브랜드가 홍보에 활용하는 방법이야.
Before: 일반 개인 비서처럼 바로 작성
첫 번째 테스트에서는 LLM Wiki나 하네스 문서를 보지 말고, 일반적인 개인 비서형 봇처럼 바로 답변하게 했습니다.
결과는 나쁘지 않았습니다.
오히려 긴 블로그 초안은 바로 나왔습니다.
하지만 운영 관점에서는 빠진 것이 보였습니다.
단일 제목만 있고 제목 후보가 없었습니다.
H2/H3 구조가 먼저 분리되어 있지 않았습니다.
브랜드 기준을 확인했다는 흔적이 없었습니다.
과장 표현이나 수상 보장 표현 검수 블록이 없었습니다.
즉, 글은 나왔지만 담당자가 어떤 기준으로 검토해야 하는지는 잘 보이지 않았습니다.
After: 브랜드 Wiki와 하네스를 먼저 확인
두 번째 테스트에서는 같은 봇에게 먼저 기준 문서를 확인하게 했습니다.
블로그 글 작성 하네스
어워즈워즈 브랜드 기준
외부 발송 리스크 기준
그리고 같은 요청을 다시 처리하게 했습니다.
이번에는 결과 구조가 달라졌습니다.
확인한 기준 요약
제목 후보 5개
추천 제목과 추천 이유
H2/H3 구조
블로그 본문 초안
검수 메모
승인 필요 여부
특히 좋았던 점은 마지막 두 개였습니다.
초안 자체보다 더 중요한 것은 검수 메모와 승인 필요 여부였습니다.
Before는 “글을 써주는 봇”에 가까웠고,
After는 “글을 쓰고, 어떤 기준으로 검토해야 하는지까지 알려주는 봇”에 가까웠습니다.
항목
Before
After
기준 확인
별도 기준 확인 없음
브랜드/업무/리스크 기준 확인
제목 구성
단일 제목
제목 후보 5개 + 추천 제목
글 구조
본문 중심
H2/H3 구조를 먼저 제시
브랜드 톤
일반적인 수상 홍보 톤
신뢰감, 공정성, 수상 가치, 심사 기준 정확성 반영
다음 액션
초안 사용
담당자 검토와 발행 승인 흐름이 명확함
이 테스트 하나만으로 모든 member 봇의 품질이 좋아졌다고 말할 수는 없습니다.
하지만 적어도 반복 업무 하나에서는 하네스가 어디에 도움이 되는지 보였습니다.
하네스는 결과물을 더 길게 쓰게 하는 장치가 아니라, 담당자가 안전하게 검토할 수 있는 구조를 붙이는 장치였습니다.
결과와 배운 점
Before: 지식은 있었지만 상태가 섞여 있었습니다
1주차 이후에는 LLM Wiki와 하네스의 필요성은 보였습니다.
하지만 Wiki 안의 문서 상태가 충분히 나뉘어 있지는 않았습니다.
원본 자료
AI 요약
업무 기준
브랜드별 메모
하네스 후보
이런 자료들이 계속 쌓이면, 나중에는 봇이 어떤 문서를 어떤 수준의 기준으로 봐야 하는지 헷갈릴 수 있습니다.
처음에는 작은 혼란이지만, 운영 규모가 커질수록 결과물의 일관성을 흔드는 원인이 될 수 있다고 생각했습니다.
After: 원본, 파생 결과, 후보 기준, 승인 기준을 나누기 시작했습니다
2주차 적용 후에는 문서 상태를 더 분리해서 볼 수 있게 됐습니다.
raw          원본

derived      AI 요약과 self-eval 같은 파생 결과

candidate    아직 검토 중인 후보 기준

approved     실제 업무 기준으로 써도 되는 문서

harness      봇이 따라야 할 절차와 검토 체크리스트
이 변화가 모든 봇을 갑자기 더 똑똑하게 만드는 것은 아닙니다.
하지만 봇들이 참고할 기준의 바닥을 정리하는 변화입니다.
이번 작업을 하면서 가장 크게 느낀 점은 이것이었습니다.
하네스는 봇을 천재로 만드는 장치가 아니라, 최소한 엉뚱한 기준으로 일하지 않게 만드는 안전레일에 가깝다.
좋았던 점 1. “정리한 자료”와 “기준으로 삼을 자료”가 나뉘었습니다
AI로 자료를 정리하면 속도는 빨라집니다.
하지만 정리 속도가 빨라질수록, 그 결과물을 너무 빨리 기준으로 삼는 위험도 커집니다.
이번 구조에서는 AI 요약과 회사 기준을 분리했습니다.
덕분에 나중에 member 봇들이 자료를 참고할 때도,
“이 문서는 아직 후보인지, 승인된 기준인지”를 더 명확하게 볼 수 있습니다.
좋았던 점 2. 개인 비서형 UX는 유지하면서 품질 기준을 붙일 수 있었습니다
팀원 입장에서는 여전히 평소처럼 담당 봇에게 요청하면 됩니다.
대신 봇 뒤쪽에서는 요청 유형을 분류하고, 관련 브랜드 Wiki와 업무 하네스, 리스크 기준을 확인한 뒤 결과물을 냅니다.
겉으로는 개인 비서입니다.
속으로는 LLM Wiki와 하네스가 붙은 Agent Team 구조입니다.
이번 Before/After 테스트에서 이 차이가 특히 잘 보였습니다.
Before는 빠르게 초안을 써줬습니다.
After는 초안에 더해 기준 확인, 제목 후보, 구조, 검수 메모, 승인 필요 여부까지 붙었습니다.
이 차이는 단순히 글이 더 길어졌다는 뜻이 아니었습니다.
담당자가 결과물을 더 안전하게 검토할 수 있는 구조가 붙었다는 뜻에 가까웠습니다.
좋았던 점 3. 답변의 근거를 더 의식하게 됐습니다
Query 검증을 추가하면서, 이제는 답변 결과만 보는 것이 아니라 답변의 근거도 함께 보게 됐습니다.
특히 다음 항목을 남기게 한 것이 도움이 됐습니다.
claim
source_ref
evidence_type
promotion_state
confidence
승인 필요 여부
리스크와 다음 액션
이렇게 해두면 봇의 답변이 그럴듯해 보여도, 실제로 어떤 문서와 기준에서 나온 것인지 다시 확인할 수 있습니다.
저에게는 이 부분이 LLM Wiki를 단순한 지식 저장소가 아니라 운영 가능한 기준 시스템으로 느끼게 해준 지점이었습니다.
아쉬운 점과 한계
이번 작업은 LLM Wiki 운영 구조를 정리하고, 작은 범위에서 테스트한 단계입니다.
그래서 아직 이렇게 말할 수는 없습니다.
모든 member 봇의 결과 품질이 좋아졌다고 말할 수는 없습니다.
Graphiti나 OpenViking을 실제 운영에 붙였다고 말할 수는 없습니다.
DuckDB를 설치해 본격적인 분석 DB를 만들었다고 말할 수는 없습니다.
팀 전체가 이 구조를 완전히 사용하기 시작했다고 말할 수도 없습니다.
Before/After 테스트 하나만으로 모든 업무에 효과가 있다고 말할 수도 없습니다.
대신 지금 말할 수 있는 것은 이 정도입니다.
회사 AI 비서팀이 같은 기준으로 일하기 위한 LLM Wiki 운영 규칙을 만들었고, self-eval, Query 검증, SQLite 관측, member 봇 Before/After 테스트까지 작게 실행해봤다.
저는 이 표현이 이번 작업을 가장 정확하게 설명한다고 생각합니다.
다음에 해볼 것
다음 단계는 문서를 더 많이 만드는 것이 아닙니다.
실제 member 봇 업무에 하나씩 적용해보는 것입니다.
우선순위는 이렇게 잡고 있습니다.
이번에 테스트한 블로그 글 작성 흐름을 다른 브랜드나 주제로 한 번 더 반복합니다.
적용 전/후 결과물에서 과장 표현, 브랜드 톤, 승인 필요 여부, CTA, 구조 품질을 비교합니다.
효과가 있으면 다른 member 봇과 업무로 확장합니다.
반복해서 유효한 기준만 approved 또는 정식 하네스 후보로 올립니다.
최종 업로드 전에는 이미지 2개 기준으로 public-safe QA를 다시 확인합니다.
그리고 이때도 중요한 기준은 같습니다.
팀원을 평가하기 위한 구조가 아니라, 봇이 더 일관된 결과를 내기 위한 기준을 쌓는 구조여야 한다.
정리
이번 2주차 작업을 하면서 LLM Wiki를 조금 다르게 보게 됐습니다.
처음에는 LLM Wiki를 “AI가 참고할 문서 저장소”라고 생각하기 쉽습니다.
하지만 회사 Agent Team에서 쓰려면 저장소만으로는 부족했습니다.
진짜 필요한 것은 이 질문에 계속 답할 수 있는 구조였습니다.
이 문서는 원본인가?
AI가 정리한 파생 결과인가?
아직 후보 기준인가?
회사 기준으로 승인된 것인가?
봇이 실제 업무에서 따라야 할 하네스인가?
답변은 어떤 근거에서 나왔는가?
사람 승인이 필요한 결과물인가?
이 질문에 답할 수 있어야 member 봇들이 같은 기준으로 일할 수 있습니다.
그래서 이번 2주차의 결론은 이렇게 정리할 수 있을 것 같습니다.
AI 비서팀이 같은 기준으로 일하게 하려면, 지식창고에도 규칙이 필요하다.
LLM Wiki는 자료를 쌓는 곳이 아니라, 원본이 기준으로 승격되는 과정을 관리하는 운영 장치가 되어야 한다.
그리고 실제 테스트를 해보니 한 가지가 더 보였습니다.
겉은 개인 비서처럼 편하게 쓰더라도, 속에는 Wiki와 하네스가 있어야 결과물이 안전해진다.
도움 받은 글 (옵션)
Graphiti 공식 문서: 시간 흐름을 반영하는 지식 그래프와 에이전트 메모리 개념을 참고했습니다.
DuckDB 공식 문서: 로컬 분석 DB를 붙일 수 있는 가능성을 검토할 때 참고했습니다.
SQLite 공식 문서: 이번 단계에서 가볍게 source manifest를 관측하는 방식에 참고했습니다.
OpenViking GitHub: 에이전트용 context database와 파일 시스템형 컨텍스트 관리 개념을 참고했습니다.
