


1. 소개 (시도한 이유) 📌
💡 "자동차 산업의 그 방대한 데이터, 언제 손으로 다 타이핑합니까?"
자동차 업계 데이터는 많이 복잡합니다. OEM 그룹만 140개가 넘고, 차종은 수천 개, 거기에 E-GMP니 MEB니 하는 전동화 플랫폼과 수많은 글로벌 Tier 1 공급사(Valeo, Hanon, Bosch 등)의 관계가 거미줄처럼 복잡하게 얽혀 있죠.
이 귀한 데이터베이스(GPAK)를 맨날 끊어진 엑셀 시트로만 보려니 눈이 빠질 것 같더군요. 그래서 지식 관리 도구 옵시디언(Obsidian)을 활용해 노트를 서로 링크([[위키링크]])로 연결하고, 거미줄 같은 '관계형 지식 지도(Graph View)'를 만들고 싶었습니다.
❌ 하지만 마주한 거대한 장벽... 차종 2,700개, 플랫폼 740개... 이거 언제 손으로 노트 하나하나 만들고 복붙하고 앉아있습니까?
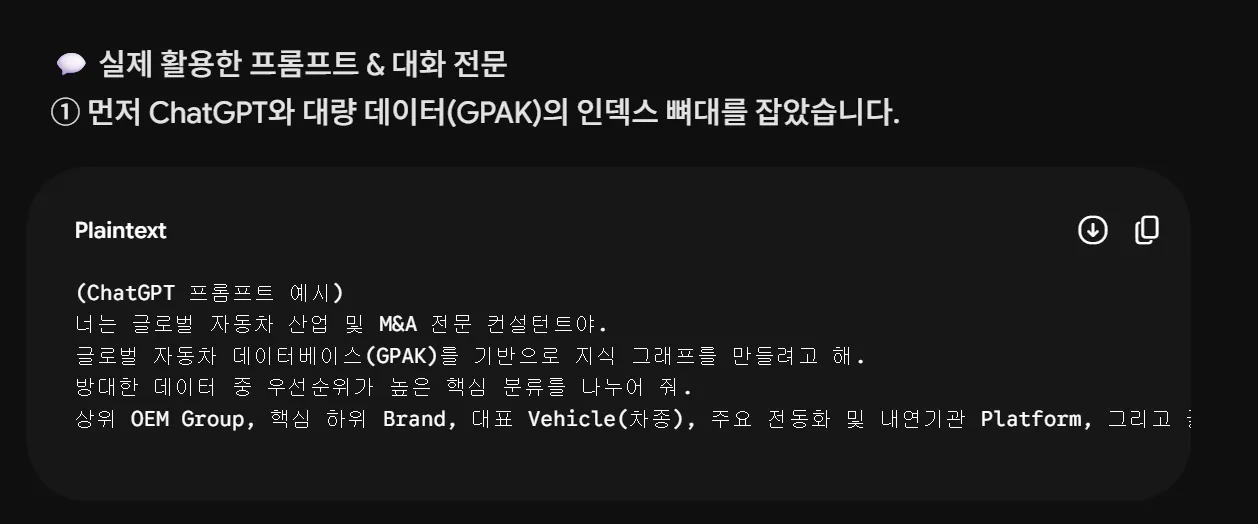
그래서 우선 1단계로, ChatGPT와 제 개인 Hermes 반려봇인 '홍대광봇'을 연계하여 메인 홈 화면과 대분류 인덱스(플랫폼, 공급사, 차종 등)의 '지식 그래프 뼈대(Structure)'를 단 10분 만에 세우는 데 성공했습니다!
2. 진행 방법 및 현재 성과 🛠
⚙️ 내 손과 발이 되어준 환상의 도구 조합
데이터 브레인: ChatGPT (전체적인 자동차 데이터 분류 및 마크다운 구조화 담당)
로컬 파일 제어 봇: Hermes 홍대광봇 (내 PC 폴더 안으로 직접 들어가 마크다운을 만지는 개인 AI 에이전트)
최종 서고: Obsidian (WSL 및 로컬 환경)
🏃♂️ [현재 완료된 1단계] 메신저 대화로 '서고 뼈대' 세우기
ChatGPT를 통해 대량의 자동차 데이터 분류 체계 가이드라인을 잡았습니다.
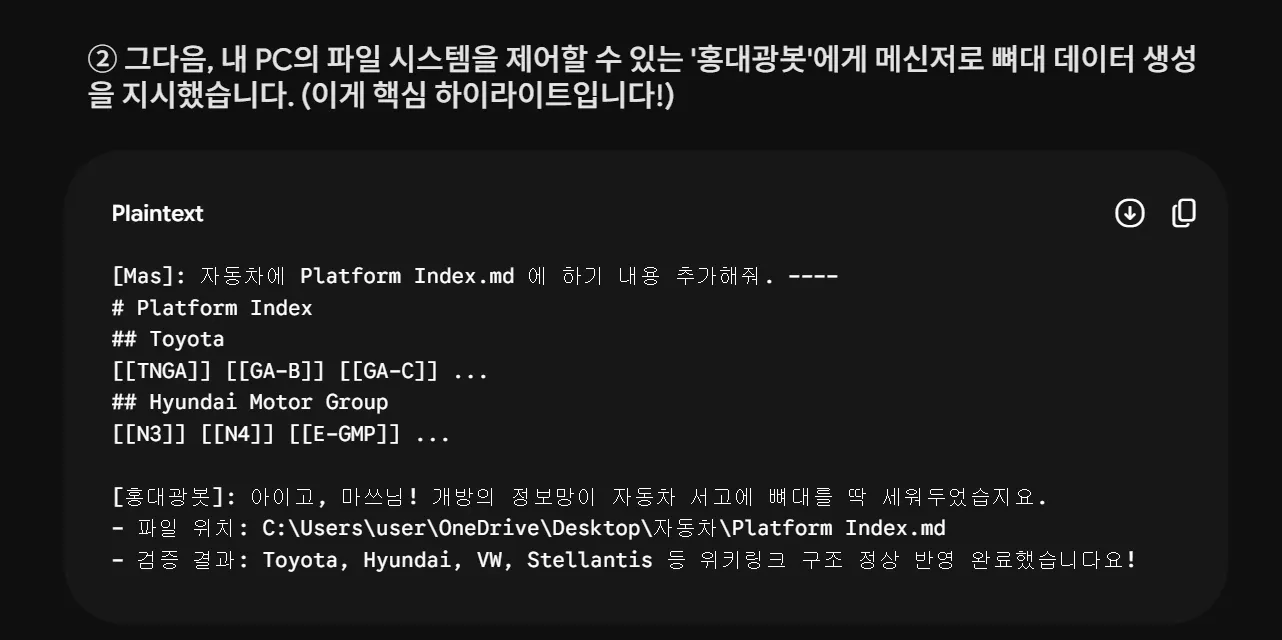
메신저(텔레그램) 환경에서 AI 에이전트(홍대광봇)에게 구조를 던져주며 "내 PC 지정 폴더에 인덱스 파일들을 만들어줘!"라고 지시했습니다.
홍대광봇이 로컬 PC 환경(WSL 경로)에 접근하여
[[위키링크]]형태의 인덱스 노트를 자동으로 뚝딱 생성했습니다.한국어 텍스트가 있는 검은 화면
한국어 텍스트가 있는 검은 화면
📸 실제 내 PC에 뼈대가 세워진 검증 화면
제가 자리에 없을 때, 메신저로 에이전트에게 "잘 지어졌는지 스크린샷 찍어봐"라고 하니, 지가 직접 폴더 파일을 읽어서 옵시디언 렌더링 화면을 캡처해 보내온 모습입니다. 컴퓨터 앞에 앉으면 다시 내용을 확인은 해봐야 겠찌만...
(설명: 보시는 것처럼 메인 홈인 Automotive Wiki 아래에 Platform Index, Supplier Index 등 대분류 인덱스가 완벽한 위키 구조로 들어찼습니다. 링크만 걸어두면 옵시디언이 알아서 지도를 그려주기 때문에 진입장벽을 엄청나게 낮췄습니다.)
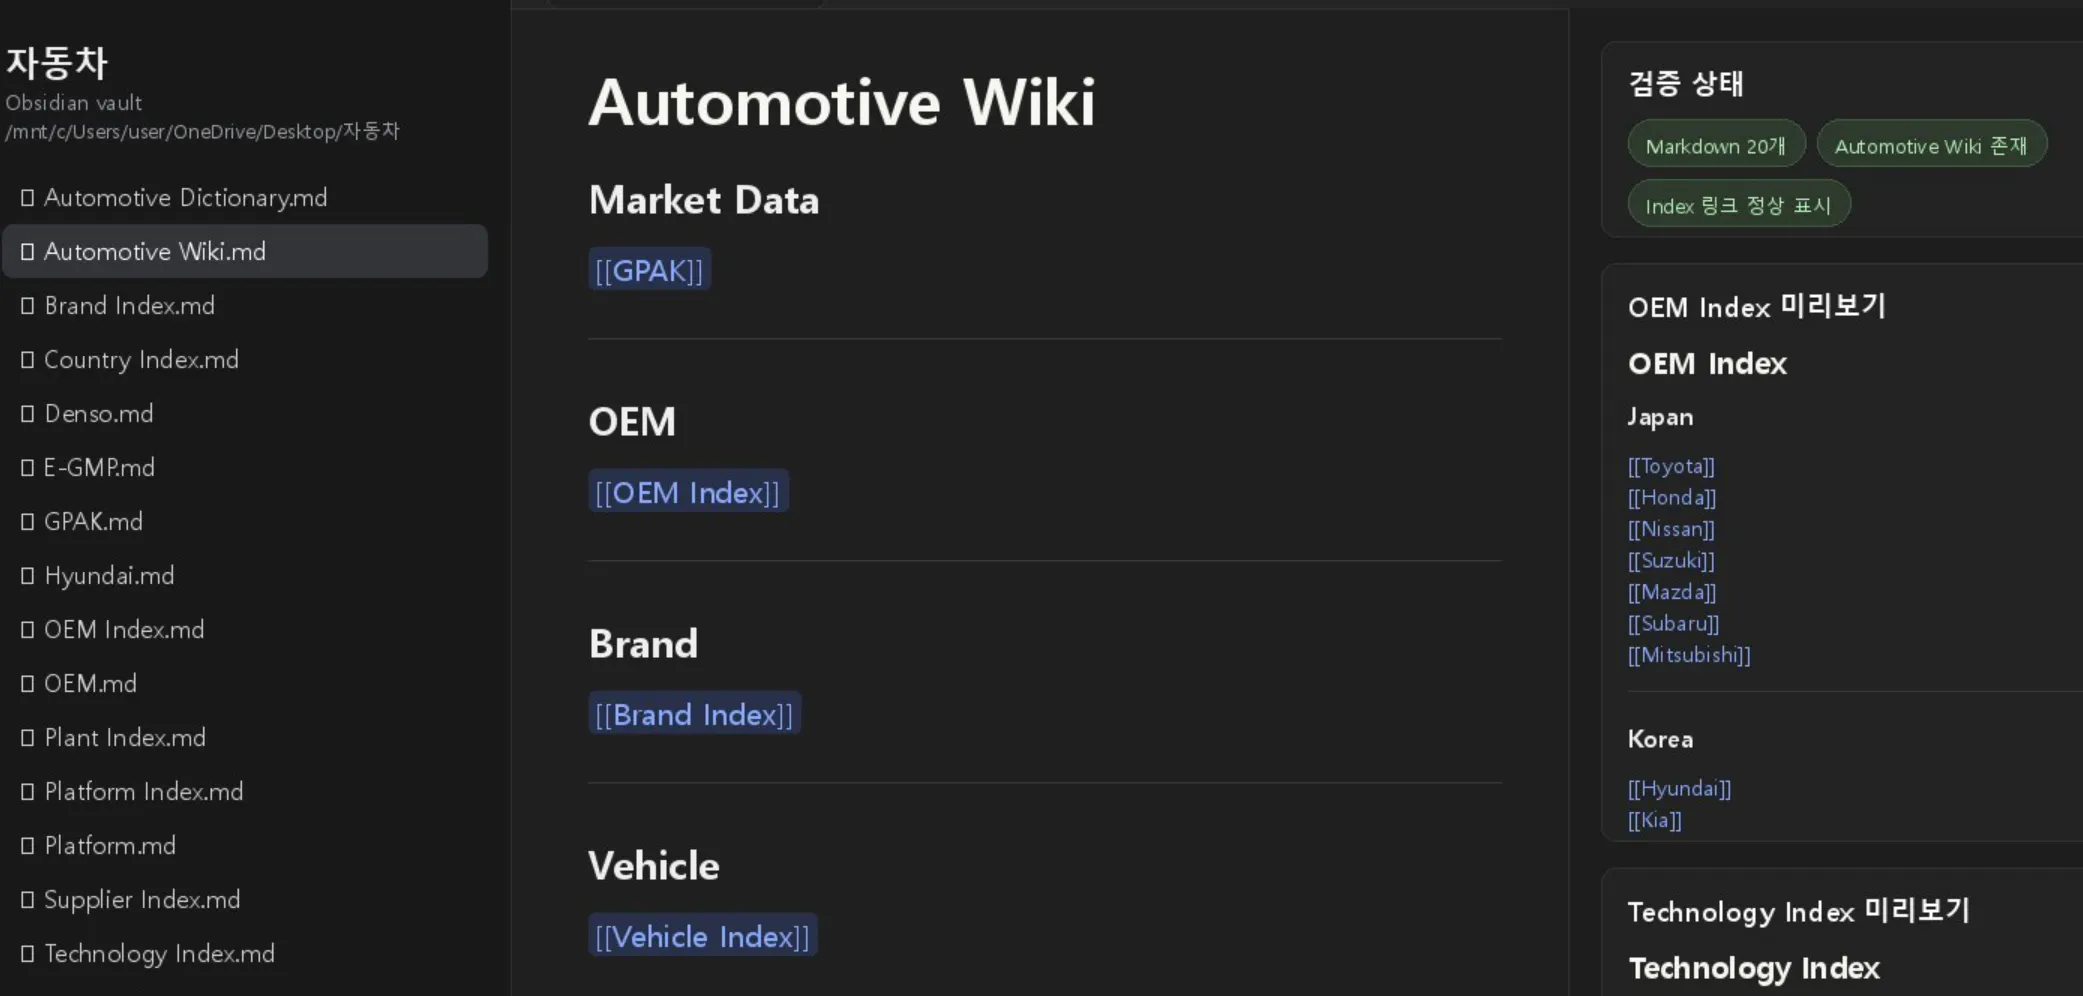
자동차 위키의 스크린샷
3. 시행착오와 새로운 병목 구간 🤦♂️
🚨 "뼈대는 잡았는데... 알맹이는 언제 다 채우지?"
인덱스 뼈대를 만들고 나니 다음 단계인 "각 차종과 플랫폼의 세부 내용(알맹이) 채우기"라는 진짜 지옥이 기다리고 있었습니다.
지금은 그 세부 내용을 ChatGPT에 일일이 물어보고, 나온 답변을 복사해서 다시 텔레그램 봇에 붙여넣기 하는 방식으로 '한 땀 한 땀' 수동 노가다를 하고 있습니다. 10개만 해도 손가락이 아프고 현타가 세게 오더군요. 수천 개의 데이터를 이런 식으로 채우다간 올해가 다 갈 것 같았습니다.
4. 추가로 해야 할 일: "완전 자동화 파이프라인 구축" 🔮
이 수동 노가다의 늪에서 완전히 탈출하기 위해, 제가 앞으로 파보고자 하는 '엔드 투 엔드(End-to-End) 완전 자동화 계획'입니다.
5. 대반전: "생각만 하던 자동화, 오픈소스를 활용한 'Inbox 시스템'으로 시동 걸기!" 🚀
여기서 이번 프로젝트의 가장 흥미진진한 '대반전'이 일어납니다. 수동 복붙의 한계를 느끼고 밖에서 모바일로 반려봇(홍대광봇)에게 아이디어를 던졌습니다.
"대광아, 내가 파일 주면 니가 하루 분량을 정해서 옵시디언 식으로 자동 정리해 줄 수 있어? 나 이거 한 땀 한 땀 올리다가 손가락 부러지겠다."
그랬더니 이 똑똑한 녀석이 제 의도를 정확히 파악하고, 아예 옵시디언 전용 대량 인프라 구축 제안서를 가져오더군요! 텔레그램 업로드 용량 제한(20MB)도 피하고, 매일 알아서 정리해 두는 인박스(Inbox) 폴더 구조를 제안한 것입니다.
📁 AI 에이전트가 제안한 자동화 서고(Vault) 구조
90_Inbox/: 제가 밖에서 구한 엑셀, PDF, 논문 등 대량 파일을 툭 던져두는 폴더00_Index/: 기존에 잡아둔 대분류 뼈대 파일들10_OEM/,20_Platform/,40_Supplier/: AI가 엑셀을 읽고 자동으로 알맹이를 채워 넣을 카테고리 폴더99_Processed/: 처리가 완료된 원본 파일이 이동하는 아카이브 폴더
6. 잘해보라고: AI 에이전트에게 깃허브 오픈소스 학습시키기 🛠️
여기서 쐐기를 박기 위해, 제가 챗GPT가 추천해 준 옵시디언 자동화 오픈소스인 Ar9av/obsidian-wiki 깃허브 링크를 봇에게 툭 던져주었습니다.
"대광아, 이 오픈소스 링크 줄 테니까 분석해서 나에게 보고하고 설치 여부 진행해보자."
"이 오픈소스의 메커니즘을 분석해서 내 비즈니스 환경에 맞는지 보고하라"고 지시했습니다. 봇은 즉시 깃허브 저장소를 복제(Clone)해 코드 구조와 README를 분석하기 시작했습니다. (두 번째 첨부 스크린샷이 바로 그 과정입니다!)
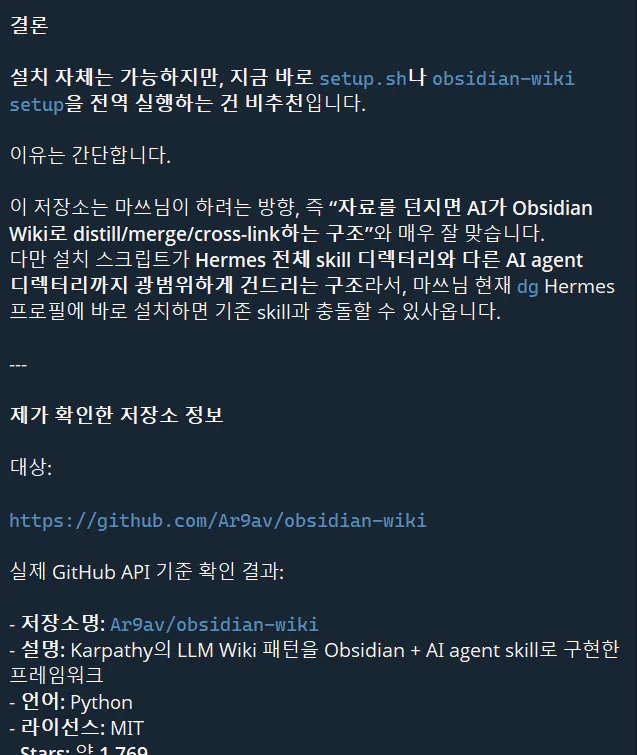
한국어 웹사이트 스크린샷
📊 AI 에이전트의 오픈소스 분석 보고 요약
봇이 코드를 뜯어보고 보고한 내용은 생각보다 훨씬 정교했습니다. 이 도구는 카파시(Karpathy)의 LLM Wiki 패턴을 구현한 프레임워크로, 제가 딱 원하던 기능을 가지고 있었습니다.
문서 추출 및 병합(Extract & Merge): PDF/엑셀에서 개념을 뽑아 기존 노트와 비교 후 자동 병합
중복 방지(.manifest.json): 파일의 해시(Hash) 값을 추적해 중복 처리 원천 차단
검토 모드(Staged Writes): AI가 쓴 내용을 바로 덮어쓰지 않고
_staging/폴더에 임시 저장 후 사용자가 승인하면 반영하는 기능
⚠️ 하지만 에이전트의 칼같은 피드백: "전역 설치는 반대합니다!"
여기서 안심되었던 것은 봇이 무조건 설치한 게 아니라, 제 기존 PC 환경을 고려해 브레이크를 걸었다는 점입니다.
"마쓰님, 이 도구는 아주 훌륭하지만 설치 스크립트가 PC의 전역 환경을 건드려 기존에 쓰시던 봇 스킬들과 충돌할 위험이 있습지요. 외부 툴 구조를 그대로 쓰기보다는, 이 도구의 핵심 규칙(중복 방지, 검토 모드, 신뢰도 마커)만 쏙쏙 뽑아서 우리 자동차 Wiki에 맞게 변형 적용하는 'A안(안전 추천안)'을 제안합니다!"
무지성으로 코드를 돌리는 게 아니라, 개발자나 컨설턴트처럼 "방향은 맞지만 칼날이 넓은 도구이니 손잡이를 감아서 안전하게 쓰자"며 대안을 제시하는 모습에서 감탄이 나왔습니다.
7. 결과와 배운 점 🧠
뼈대(Structure)가 90%: 처음부터 완벽한 노트를 쓰려는 생각을 버려야 합니다. 천리길도 한걸음부터!
챗봇 화면 복붙은 당장 그만: 데이터가 수십 개를 넘어가는 순간, 인간의 노가다는....
AI 에이전트를 조언자로 활용: 오픈소스 링크를 던져주고 "내 환경에 맞는지 장단점을 분석해서 리스크를 보고해 줘"라고 논의를 시작하는게 좋습니다.
🔮 앞으로의 마스터플랜 (Future Roadmap)
이제 분석과 뼈대 세팅이 끝났습니다. 앞으로 집으로 돌아가 봇과 합의한 안전안(A안) 체계에 맞춰 GPAK 원천 데이터를 90_Inbox에 투입하고, 14일간 하루 10~20개씩 안전하게 지식 맵의 알맹이를 채워 나갈 예정입니다.
