


소개
24시간 켜 둘 Mac mini의 컨테이너 기반을 OrbStack으로 구성하고, 표준 Docker Compose 작업이 로그인 뒤 다시 살아나는 것까지 확인했습니다. 핵심은 시작 명령의 종료 코드만 믿지 않고 실제 엔진과 컨테이너 상태를 함께 확인하도록 자동 시작 방식을 바꾼 것이었습니다.
이 작업 전에는 OrbStack을 설치 대상으로 골랐을 뿐, Docker 엔진·데이터 지속성· 서비스 재시작·외부 노출과 로그인 후 복귀는 확인하지 않은 상태였습니다. 이 글에서는 일회성 검증용 컨테이너로 런타임 계약을 확인하고, exit 1인데도 서비스가 이미 살아 있던 모순을 다룬 과정까지만 설명합니다. 전체 재부팅과 정전 후 복귀, 실제 서비스의 장기 부하는 아직 이 결과에 포함하지 않습니다.
한국어로 된 웹사이트를 종료하는 과정을 보여주는 화면
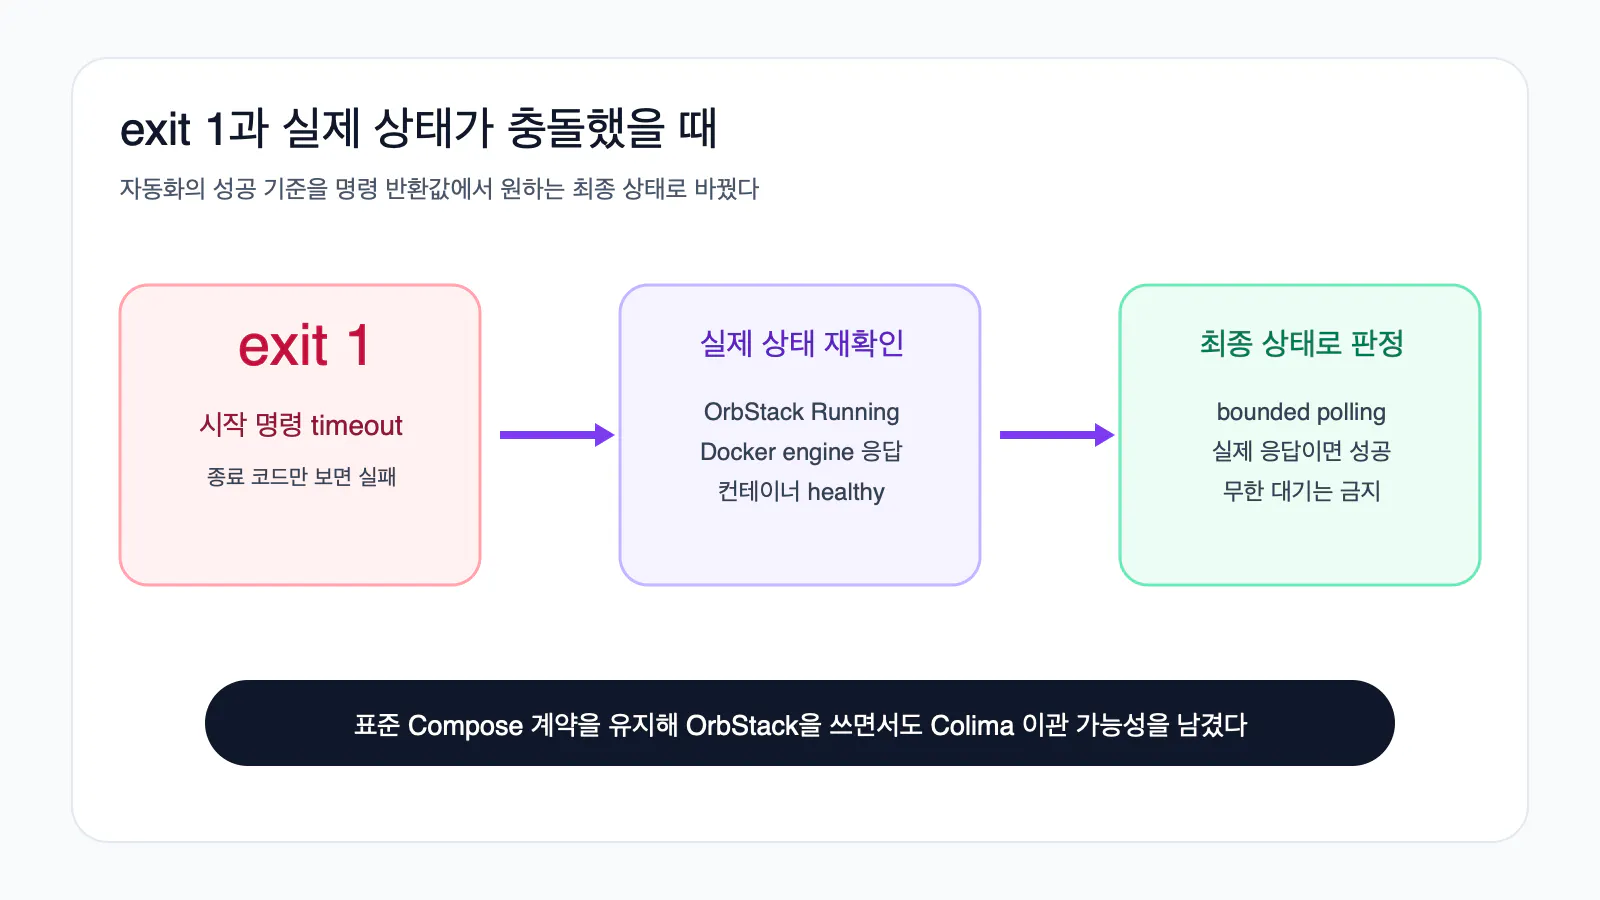
명령의 종료 코드와 실제 서비스 상태가 충돌했을 때 적용한 판정 순서입니다.
한눈에 보는 흐름:
exit 1→ 실제 runtime 상태 재확인 → 최종 상태로 성공 판정
진행 방법
Codex는 저장소의 안전 규칙과 공식 CLI 도움말을 바탕으로 조사·명령·검증 순서를 만들었고, 저는 GUI onboarding과 관리자 helper 설치처럼 사람의 판단이 필요한 단계만 직접 확인하고 승인했습니다.
실제로 사용한 대표 prompt는 다음과 같습니다.
OrbStack 전용 *.orb.local 등에 의존하지 않음으로 얻는 단점이 있나?
그냥 상관없나? 내가 직접 코딩하는 게 아니고 LLM에 설계를 다 맡길 건데
큰 부분은 아닌가? 진행하자.
전용 기능 대신 표준 Compose를 계약으로 삼았다
설치 전에는 OrbStack과 Colima를 먼저 비교했습니다. CLI 중심의 오픈소스 운영과 장기적인 상업 사용 경계만 보면 Colima가 분명한 장점이 있었고, Mac에서의 통합 경험과 지금 바로 개인 학습 서버를 운영하는 목적에는 OrbStack이 더 잘 맞았습니다. 그래서 현재 개인 용도에는 OrbStack을 쓰되, 상업 프로젝트를 시작할 때는 라이선스와 runtime 선택을 다시 검토하기로 했습니다.
처음부터 다른 런타임으로 옮길 가능성을 남기고 싶었습니다. 그래서 OrbStack의 편리한 전용 주소나 Linux machine 기능을 기본 계약으로 쓰지 않았습니다. 대신 Docker image, Compose, named volume, healthcheck, restart policy와 명시적인 port bind만 사용했습니다.
검증용 Compose에는 작은 BusyBox 컨테이너를 올렸습니다. named volume은 컨테이너를 다시 만들어도 보존돼야 하는 데이터 공간이고, healthcheck는 애플리케이션이 실제로 응답하는지를 엔진이 판단하는 검사입니다. HTTP port는 Mac mini 내부에서만 접근 가능한 loopback에 묶고, LAN 공개 기본값도 껐습니다.
Docker client와 server, Compose, ARM64 엔진을 확인한 뒤 image pull과 일회성 컨테이너 실행을 통과했습니다. 별도 컨테이너에서 volume marker를 다시 읽어 데이터 지속성을 확인했고, HTTP 응답과 healthy 상태도 함께 확인했습니다.
틀린 재시작 시험을 완료 근거에서 뺐다
첫 재시작 시험은 컨테이너의 PID 1을 종료했습니다. 그러나 이것만으로 실제 child service가 죽었다가 restart policy로 복구됐다고 말할 수는 없었습니다. 증거 범위가 부족했기 때문에 이 결과는 완료 근거에서 제외했습니다.
그다음 child PID를 노출하도록 Compose를 수정하는 과정에서는 dollar escaping을 잘못 처리했습니다. host 쪽 shell이 container에서 해석해야 할 값을 먼저 확장하면서 warning과 unhealthy restart loop가 생겼습니다. 서비스를 즉시 중단하고 Compose 설정을 고친 뒤, 실제 HTTP child를 종료하는 시험을 다시 진행했습니다.
이번에는 restart count가 0에서 1로 증가했고, 컨테이너가 다시 healthy가 된 뒤 HTTP 응답도 돌아왔습니다. 실패를 숨기지 않고 무엇을 증명하지 못했는지 분리한 덕분에 마지막 결과만 유효한 증거로 남길 수 있었습니다.
종료 코드 대신 실제 상태를 확인했다
자동 시작에서는 더 의외의 문제가 나왔습니다. orb start가 VM 시작 timeout과 exit 1을 반환했지만, 바로 이어서 확인하면 OrbStack은 이미 Running이었고 Docker와 검증용 컨테이너도 정상 응답했습니다.
그래서 raw 종료 코드만으로 실패를 선언하지 않는 login LaunchAgent wrapper를 만들었습니다. 시작 명령이 반환된 뒤 제한된 횟수만큼 실제 runtime status를 확인하고, 엔진이 Running일 때만 성공으로 판정합니다. 무한히 기다리지 않도록 횟수와 간격도 고정했습니다.
런타임을 멈춘 뒤 logout/login을 수행했을 때 raw start는 다시 exit 1을 반환했지만, 첫 상태 확인에서 Running이 관찰됐습니다. 검증용 컨테이너와 HTTP도 복귀했습니다. 시험이 끝난 뒤에는 정확한 컨테이너·network·volume만 제거했고, broad prune은 사용하지 않았습니다.
결과와 배운 점
확인한 결과는 다음과 같습니다.
Docker engine과 Compose가 ARM64 환경에서 실제로 동작했습니다.
named volume persistence, loopback HTTP, healthcheck와 실제 child service restart를 각각 출력으로 확인했습니다.
logout/login 뒤 OrbStack과 검증용 컨테이너가 다시 동작했습니다.
시작 명령의 false-negative를 실제 상태 확인으로 보완했습니다.
OrbStack을 쓰면서도 표준 Compose 계약만 사용해 Colima 이관 여지를 남겼습니다.
시험용 컨테이너·network·volume과 listener는 제거했고 작은 image cache만 남겼습니다.
반면 full reboot와 AC cold boot, 24시간 실제 workload의 resource·log 안정성은 검증하지 않았습니다. login 복귀 성공을 장기 무인 운영 성공으로 확대해서는 안 됩니다.
이번 경험에서 얻은 재사용 가능한 교훈은 세 가지입니다.
자동화의 성공 기준은 명령의 종료 코드가 아니라 원하는 최종 상태여야 합니다.
장애 시험은 “무언가를 죽였다”가 아니라 실제 대상 service와 복구 증거가 연결돼야 합니다.
이식성을 원한다면 특정 런타임의 편의 기능보다 image·Compose·volume·bind 같은 표준 계약을 먼저 고정하는 편이 안전합니다.
다음 검증은 실제 서비스를 올리기 전에 전체 재부팅 뒤 복귀와 장기 resource·log 상태를 별도 증거로 확인하는 것입니다.
