


한줄 요약
여러 AI 세션을 오가며 맥락을 남기려고 SESSION_STATE.md 한 파일에 현재 상태, 할 일, 과거 기록을 계속 보탰습니다. 파일은 144줄까지 커졌고, 시작 기능은 내용을 최대 9,000자까지 자동으로 넣고 있었습니다.
기록을 삭제하는 대신 현재 상태, 할 일, 실행 기록, 재사용 지식, 작업 공간의 장기 상태를 서로 다른 원본으로 나눴습니다. 그 결과 SESSION_STATE.md는 22줄이 됐습니다. 다만 이것은 제가 관리하는 상태 파일과 시작 절차의 변화이지, AI 플랫폼 전체 입력량을 측정한 결과는 아닙니다.
이런 분께
여러 AI 세션과 프로젝트를 빠르게 오가며 맥락을 이어가야 하는 분
다음 AI에게 넘기는 인계 문서가 계속 길어지는 분
파일을 나눴다가 같은 정보가 서로 다르게 낡을까 걱정되는 분
아직 장기 효과를 검증한 완성형 기억 시스템은 아닙니다.
인계 문서가 길어졌습니다
SESSION_STATE.md는 이전 대화가 끝난 뒤, 다음 AI에게 지금 무엇을 하고 있고 무엇을 확인해야 하는지 알려주는 인계 문서입니다. 처음에는 현재 임무, 방금 끝낸 일, 승인 대기, 다음 행동을 이 파일에 계속 추가했습니다.
사실 원래 Handoff를 작성해서 그다음 세션에다가 프롬프트로 넘기고 있기는 했는데, 하는 작업이 많아지다보니까 handoff가 너무 늘어나는게 좀 답답하더라고요. 그래서 일단 다른 방법을 시도해 보고 있었습니다.
처음 구조는 대략 이랬습니다.
SESSION_STATE.md
├─ 다음 세션 인계
├─ 현재 위치
│  ├─ 최근 측정 결과
│  └─ 방금 끝낸 작업
├─ 미해결 게이트
│  ├─ 승인 대기
│  ├─ 검증 대기
│  └─ 다른 프로젝트의 보류 작업
└─ 다음 행동 목록
게이트(gate)는 다음 단계로 넘어가기 전에 승인이나 검증처럼 반드시 확인해야 하는 조건입니다.
당시 파일은 144줄, 17,367바이트였습니다. 세션 시작 때 자동으로 실행되는 훅(hook)은 이 파일의 상당 부분을 시작 입력에 넣었고, 출력 상한은 9,000자였습니다. 재현 측정에서는 115줄, 9,168자가 들어간 뒤 뒷부분이 잘렸을 수 있다는 경고가 붙었습니다.
문제는 파일이 긴 것만이 아니었습니다. 지금 할 일과 직접 관계없는 과거 기록도 시작 입력에 섞였고, 길어지면 뒤쪽 내용이 잘릴 수 있었습니다.
삭제와 단순 분할은 불안했습니다
오래된 내용을 지우면 파일은 짧아지지만, 중간 판단과 보류 사유가 사라져 다시 조사해야 할 수 있습니다. 반대로 큰 파일을 여러 개로 자르고 같은 내용을 복사하면 한쪽만 갱신되어 서로 다른 상태가 될 수 있습니다. 이런 상태를 stale, 즉 오래되어 현재 사실과 달라진 상태라고 부릅니다.
그래서 “어느 파일로 쪼갤까?” 대신 다음을 물었습니다.
이 정보는 어떤 질문에 답하며, 어느 파일 하나가 그 답의 원본을 맡아야 할까?
정본은 같은 사실을 책임지는 유일한 원본입니다. 다른 파일에는 상세 내용을 복사하지 않고 필요할 때 원본 위치만 가리킵니다.
실제로 어떻게 바꿨나
기존 상태 문서의 업무 항목과 의미 블록을 목록화했습니다.
각 항목을 현재 상태, 앞으로 할 일, 과거 기록, 재사용 지식, 장기 상태로 분류했습니다.
상세 내용을 책임질 원본 파일을 항목마다 하나씩 정했습니다.
원본과 분리된 공간에서 새 파일을 만들었습니다.
항목 수와 내용 요약값을 대조해 누락과 중복을 검사했습니다.
검토와 사람 승인을 거친 뒤 관련 파일을 적용했습니다.
독자가 알고 싶은 것
원본
지금 맡은 임무와 다음 관문
SESSION_STATE.md
앞으로 처리할 일과 시작 조건
BACKLOG.md
한 차례 실행에서 실제로 한 일
akm/60-actions/runs
다음 작업에도 재사용할 교훈
akm/00-inbox
작업 공간의 장기 상태
STATUS.md
akm은 23기 AI지식관리 스터디장님 deck님의 지식관리체계 레포로, 최근 사용하려 시도하고 있는 AI 전용 지식 관리 공간의 이름입니다.
runs는 실행 기록, akm/inbox는 재사용할 교훈이 akm으로 들어가는 입구입니다.
STATUS.md는 작업 공간이 진행 중인지, 멈췄는지, 끝났는지를 나타냅니다.
반면 SESSION_STATE.md는 다음 세션이 바로 이어받을 현재 임무와 다음 관문만 담습니다.
항목 하나를 옮긴 예
이전 — SESSION_STATE.md 한 곳
- 문서 변환 작업은 검증 대기.
실행 결과와 오류, 승인 뒤 할 일까지 함께 기록.이후
SESSION_STATE.md
- 현재 임무: 문서 변환 결과 검증
- 다음 관문: 오너 확인
BACKLOG.md
- 할 일: 검증 후 최종 문서 생성
- 시작 조건: 검증 자료 준비
runs
- 이미 실행한 변환 결과와 오류
inbox
- 다른 작업에도 재사용할 수 있는 변환 교훈모든 항목이 네 곳에 생기는 것은 아닙니다. 현재 임무가 아니면 SESSION_STATE.md에 넣지 않고, 재사용할 교훈이 없으면 inbox에도 넣지 않습니다.
새 세션은 무엇을 읽나
새 세션 시작
→ 공통 훅이 역할 지침을 확인하라는 한 줄만 전달
→ 마스터라면 master-awaken.py 실행
→ SESSION_STATE.md에서 현재 임무와 다음 관문 확인
→ BACKLOG.md에서 당장 시작할 항목의 ID 확인
→ 필요할 때만 runs, inbox, STATUS.md 원본 확인master-awaken.py는 마스터가 시작할 때 실행하는 읽기 전용 명령입니다. 마스터는 cys/terminal에서의 마스터에서 아이디어를 얻어 차용하였고, 멀티 오케스트레이션 작업에서 작업을 지휘하는 역할을 맡습니다. 다양한 에이전트가 이 시스템이 적용된 워크스페이스에서 '너는 마스터다'라고 말하면 마스터로 각성합니다.
STATUS.md, SESSION_STATE.md, BACKLOG.md, 개선 원장, 현재 폴더와 Git 상태를 읽어 위치, 장기 상태, 현재 임무, 다음 관문, 시작 가능한 백로그 ID를 15줄로 요약합니다. 위치가 불명확하거나 필수 파일 형식이 틀리면 추측해서 시작하지 않고 멈춥니다.
프로그램은 원본을 검사하지만 AI에게는 전체 파일을 그대로 넣지 않고 필요한 요약만 보여줍니다. 세부 내용은 실제로 필요할 때 원본을 엽니다.
무엇이 달라졌나
측정 기준은 다음과 같습니다.
측정 시점: 2026년 8월 13일(KST)
실행 환경: macOS 26.5.2, 시스템 Python 3.9.6
파일 크기: Git에 저장된 UTF-8 원본 바이트
줄 수: 빈 줄 포함. 파일 끝 줄바꿈은 별도 행으로 세지 않음
제외 범위: 플랫폼 시스템 지침, 스킬, 대화 기록 등 제가 관리하지 않는 컨텍스트
항목
변경 전
변경 후
SESSION_STATE.md
144줄 · 17,367바이트
22줄 · 1,368바이트
공통 훅 session-state-inject.py
290줄 · 13,368바이트
53줄 · 2,248바이트
공통 훅 자동 전달 내용
115줄 · 9,168자
1줄 · 73자
BACKLOG.md
상태 파일 안에 섞임
별도 332줄 · 24,220바이트
master-awaken.py
없음
673줄 · 29,020바이트
마스터 복원 요약
공통 훅에 섞임
15줄 · 1,242자
저장된 문서와 코드의 총량은 오히려 늘었습니다. 줄어든 것은 모든 역할에 자동으로 보내던 내용이며, 마스터는 필요한 원본을 요약해서 읽게 됐습니다. 이것은 플랫폼 전체 입력량이 줄었다는 측정 결과가 아닙니다.
누락 여부는 어디까지 확인했나
모든 대화와 과거 정보를 보존했다고 주장할 수는 없습니다. 이번에 확인한 범위는 이관 전에 분모를 선언한 상태 문서의 업무 항목과 보조 블록입니다.
업무 항목 22건을 고정했습니다.
앞으로 할 일 19건은
BACKLOG.md후보에 각각 한 번씩 있는지 확인했습니다.지속 규칙 2건은 규칙 원본으로 보냈습니다.
폐기하기로 한 1건은 활성 백로그에서 제외하고 감사 기록에 남겼습니다.
보조 블록 5건을 별도로 분류했습니다.
총 27개 블록의 SHA-256을 비교했고 모두 일치했습니다.
SHA-256은 내용이 바뀌면 달라지는 내용 요약값입니다. 일부러 원문을 훼손한 사본에서 검사 실패도 확인했습니다.
따라서 정확한 결론은 다음과 같습니다.
미리 선언한 22개 업무 항목과 5개 보조 블록은 삭제·중복 여부를 추적하며 분류했다. 작업 공간의 모든 기억을 영구히 보존했다고 증명한 것은 아니다.
구조 안정화 점검은 최상위 82개가 통과했고, 그중 기존 검사 묶음의 세부 검사는 551개였습니다. 이 숫자는 장기 운영에서 정보가 stale되지 않는다는 증거는 아닙니다.
코드 없이 적용한다면
현재 상태 문서를 복사해 백업합니다.
각 항목을 현재 상태·백로그·실행 이력·재사용 지식·장기 상태 중 하나로 분류합니다.
역할이 드러나는 원본 파일을 만들고, 상세 내용은 한 곳에만 둡니다.
새 세션에서는 현재 상태 파일만 먼저 읽고, 필요할 때 백로그와 이력을 추가합니다.
옮기기 전후 항목 수와 미분류 항목을 확인합니다.
주요 승인과 임무 변경은 SESSION_STATE.md, 할 일의 상세 변경은 BACKLOG.md, 장기 상태 변경은 STATUS.md 한 곳에서만 관리합니다.
제가 배운 것
이번 실험에서 줄인 것은 AI의 전체 기억이 아닙니다. 여러 역할을 맡고 있던 인계 파일을 나누자 현재 상태 파일과 자동 주입 범위를 작게 만들 수 있었습니다.
지금 읽을 상태와 나중에 찾아볼 기록을 같은 파일에 둘 필요는 없었습니다.
Before / After
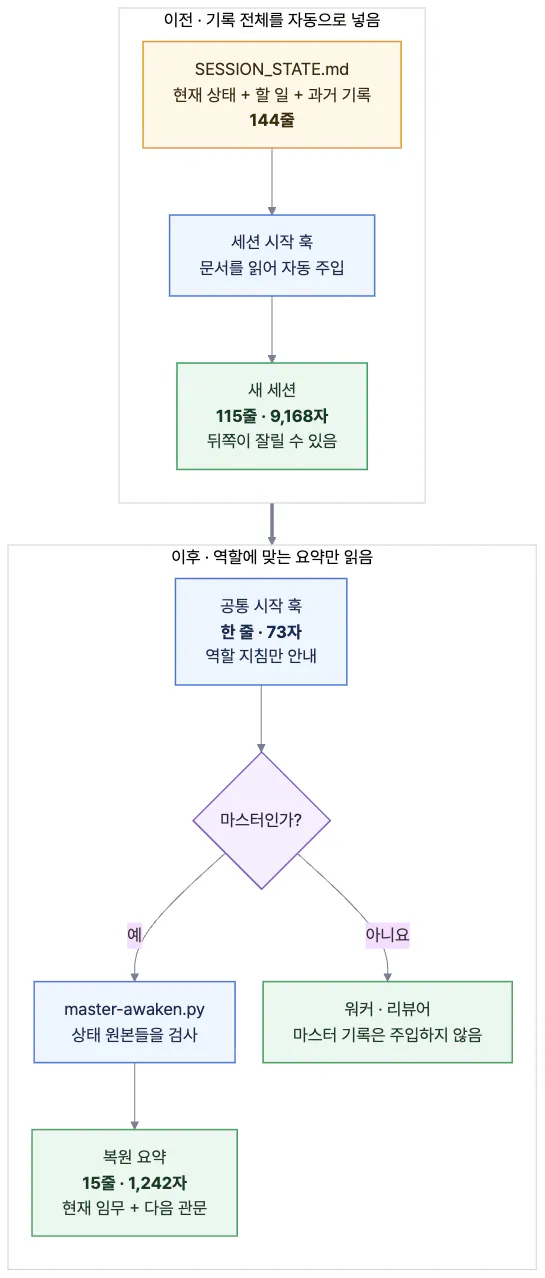
프로세스의 다양한 단계를 보여주는 순서도
내 상태 문서 점검해보기
아래 프롬프트는 전체 자동화가 아니라 1차 분류와 수동 이관 계획을 위한 것입니다.
<상태 문서 경로>를 읽고 모든 의미 있는 항목을 먼저 번호로 세어줘.
각 항목을 다음 다섯 질문 중 하나로 분류해줘.

1. 지금 어디까지 왔나 — 현재 상태
2. 앞으로 무엇을 할까 — 시작 조건이 붙은 백로그
3. 과거에 무엇을 했나 — 실행 이력
4. 다음에도 쓸 교훈은 무엇인가 — 재사용 지식
5. 작업 공간이 장기적으로 어떤 상태인가 — active, paused, done

같은 상세 내용을 여러 파일에 중복되지 않게 복사하지 않는 것을 우선해줘.
각 항목의 원본 파일과 이동 이유를 표로 제안하고,
분류 전 항목 수, 분류 후 부분합, 미분류 수를 마지막에 밝혀줘.
아직 파일은 수정하지 말고 제안에서 멈춰줘.