


소개
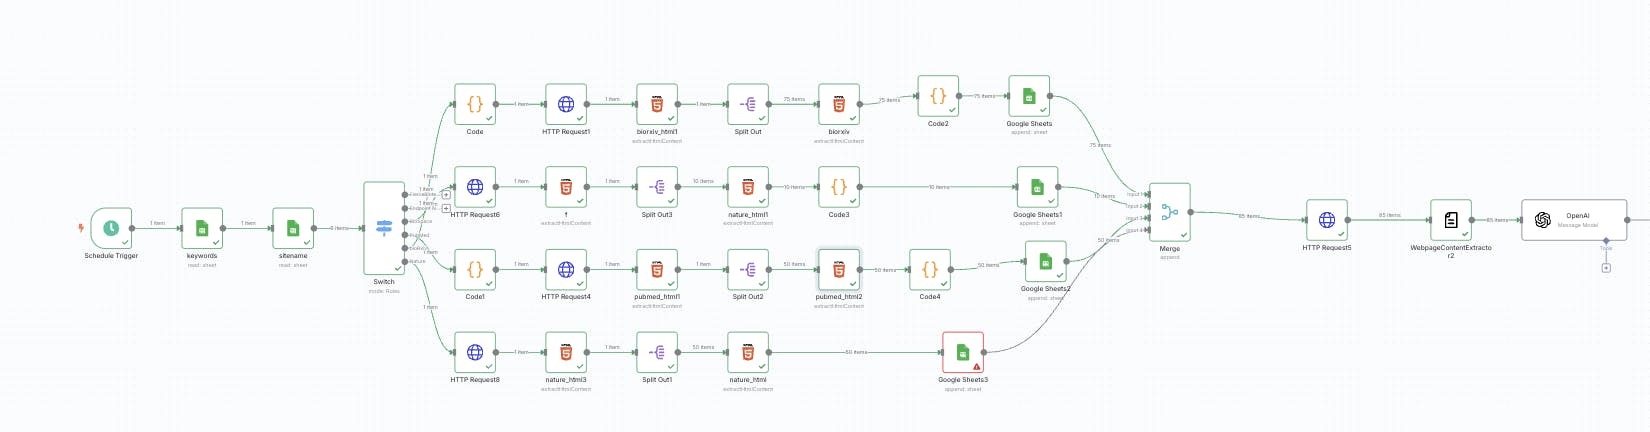
6가지 사이트에서 키워드 검색 결과를 뉴스레터로 받아볼수있도록 하기위해 시작하엿습니다. 각 사이트 중에서 rss가 있기도 하고, 없기도하고 다양하여, 결국엔 사이트마다 모두 플로우를 다르게 구성했습니다.
make와 비교하여 n8n 기본 기능으로 HTML파싱이 너무 잘되어있어 사례글을 작성합니다.
진행 방법
원하는 사이트 pubmed
https://pubmed.ncbi.nlm.nih.gov/
사이트의 검색창에 검색어를 입력하면, 어떤 파라미터로 검색하는지 파악
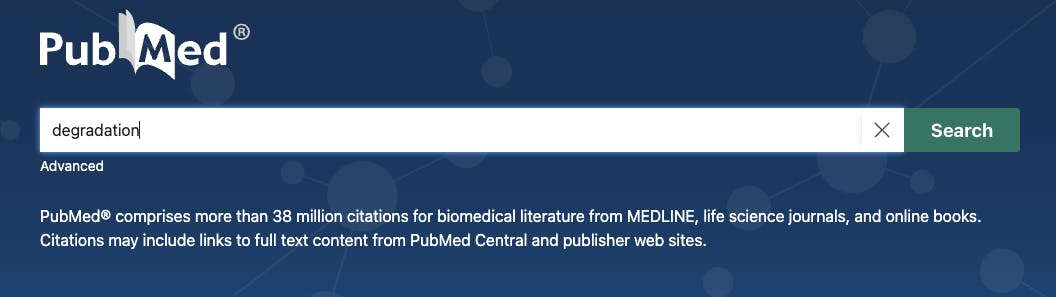
PubMed 검색 페이지의 스크린 샷
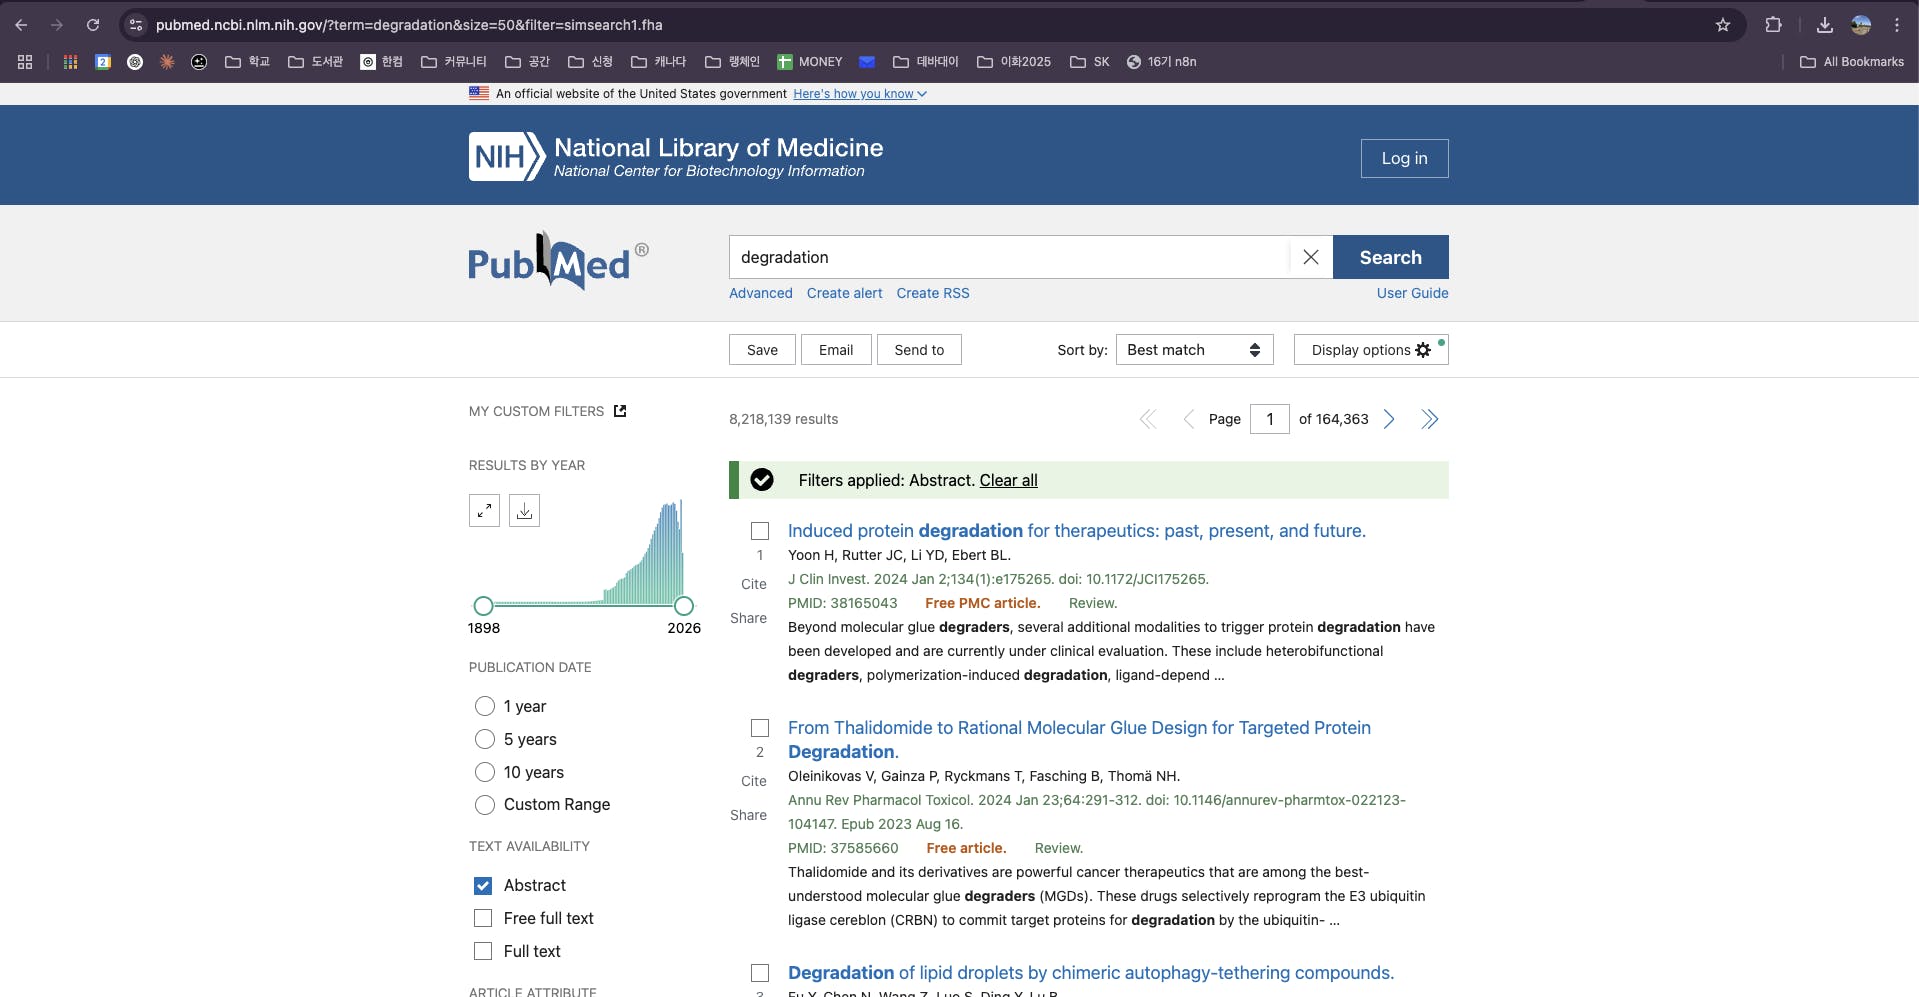
웹 사이트에서 검색 페이지의 스크린 샷
https://pubmed.ncbi.nlm.nih.gov/?term=degradation&size=50&filter=simsearch1.fha
검색어: term
size: 한페이지에 나오는 검색결과 수
여러 조건들을 더 걸어 상세한 파라미터까지 파악
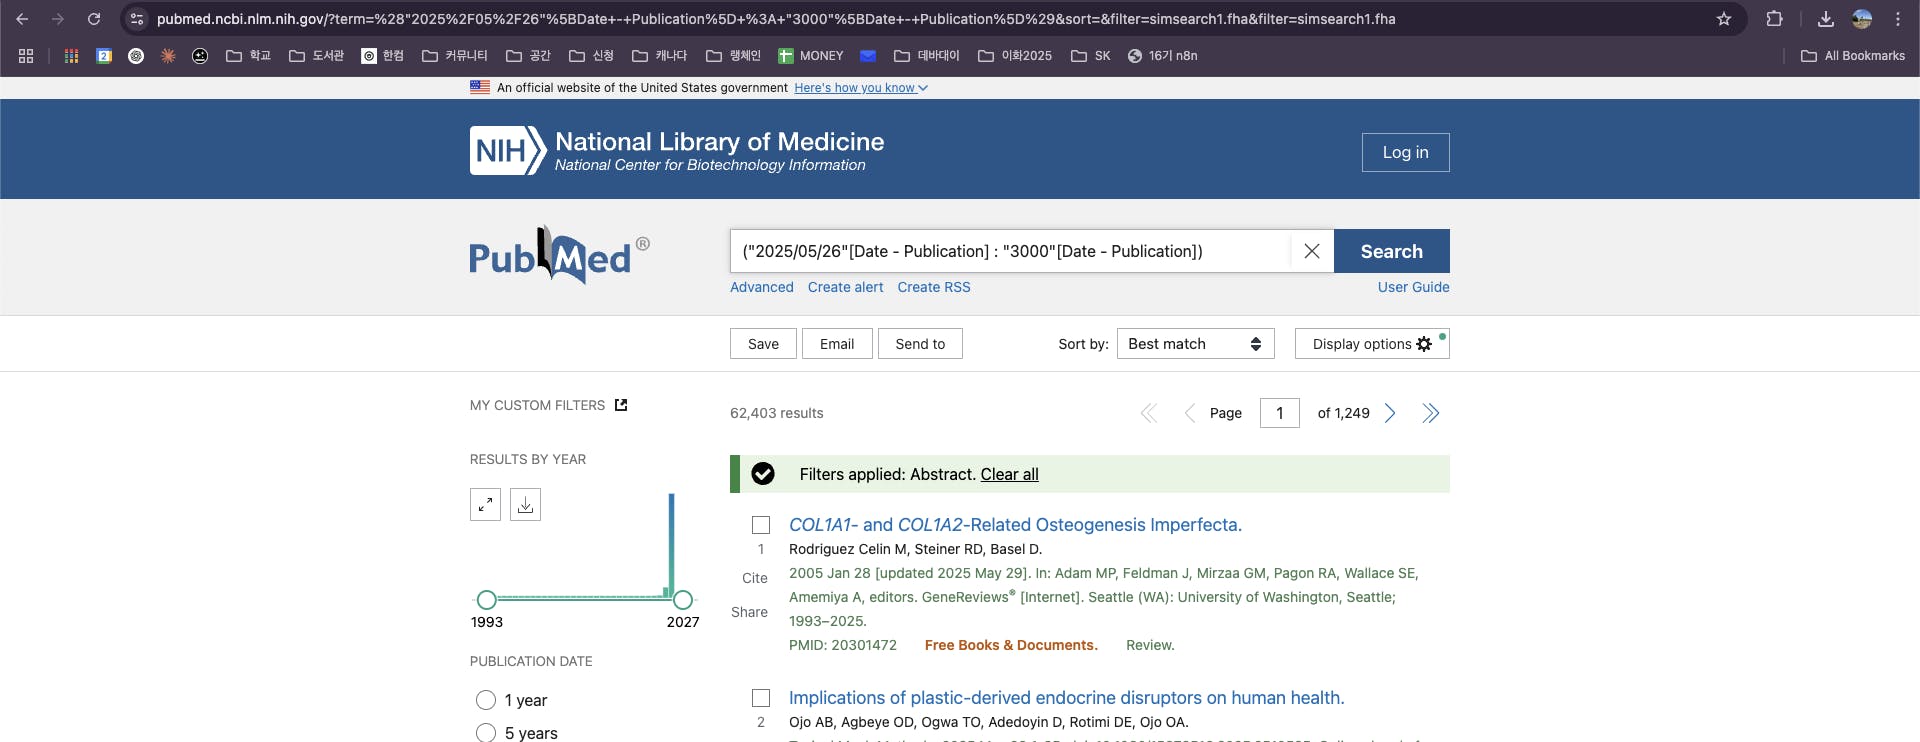
==> 최근 7일간 검색어 결과 URL 생성 코드
// 오늘 날짜와 7일 전 날짜 계산
const today = new Date();
const endDate = today.toISOString().slice(0, 10).replace(/-/g, '/'); // YYYY/MM/DD
const startDateObj = new Date(today);
startDateObj.setDate(today.getDate() - 6); // 오늘 포함 7일간
const startDate = startDateObj.toISOString().slice(0, 10).replace(/-/g, '/');

// 입력에서 키워드 추출
const keyword = $input.first().json['검색키워드'] || 'degradation';

// PubMed 쿼리 조립
// 쿼리 형태: (키워드) AND (("시작날짜"[Date - Publication] : "끝날짜"[Date - Publication]))
const query = `(${keyword}) AND (("${startDate}"[Date - Publication] : "${endDate}"[Date - Publication]))`;
// 공백, 따옴표 등 특수문자 인코딩
const encodedQuery = encodeURIComponent(query);

// 최종 URL
const baseUrl = 'https://pubmed.ncbi.nlm.nih.gov/?term=';
const filter = '&filter=simsearch1.fha&size=50';
const finalUrl = `${baseUrl}${encodedQuery}${filter}`;

// 결과 반환
return [
  {
    json: {
      url: finalUrl,
      startDate,
      endDate,
      keyword
    }
  }
];
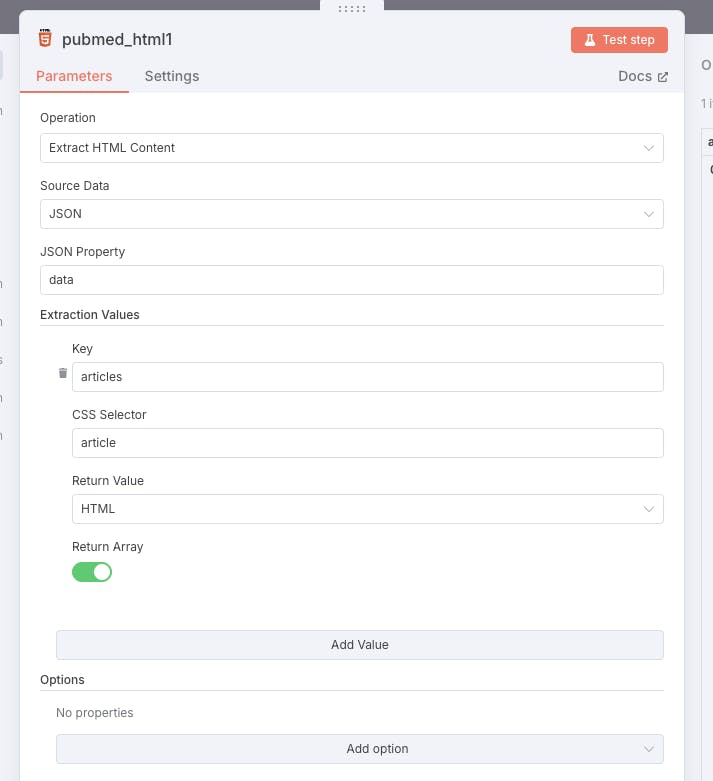
결과 리스트를 하나씩 가져오기위해, n8n에서 HTML 모듈 사용
CSS selector: article
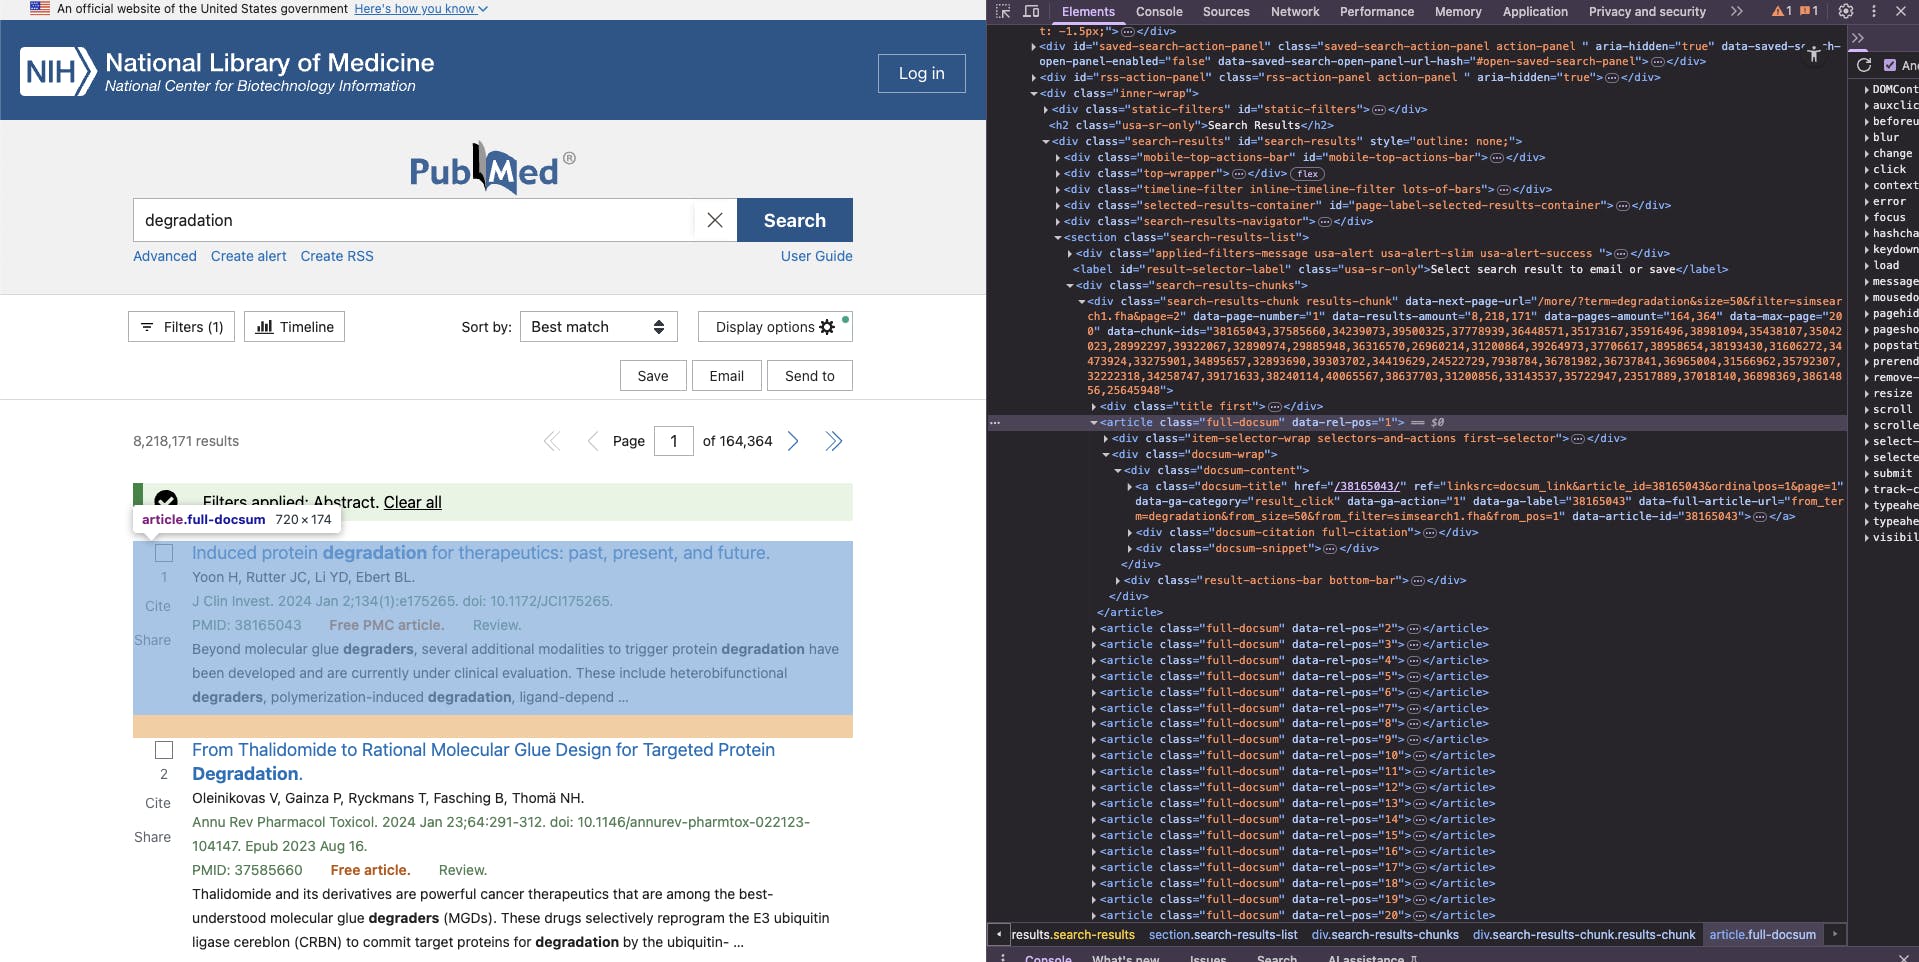
웹 페이지의 스크린 샷 및 웹 페이지의 스크린 샷
가져온 리스트에서, 필요한 정보 추출하기.
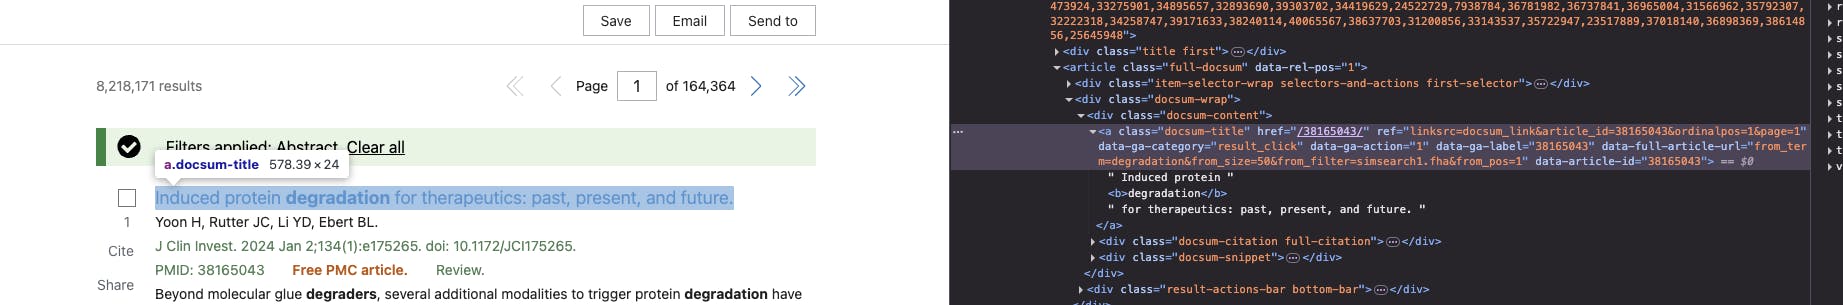
HTML 편집기의 스크린 샷
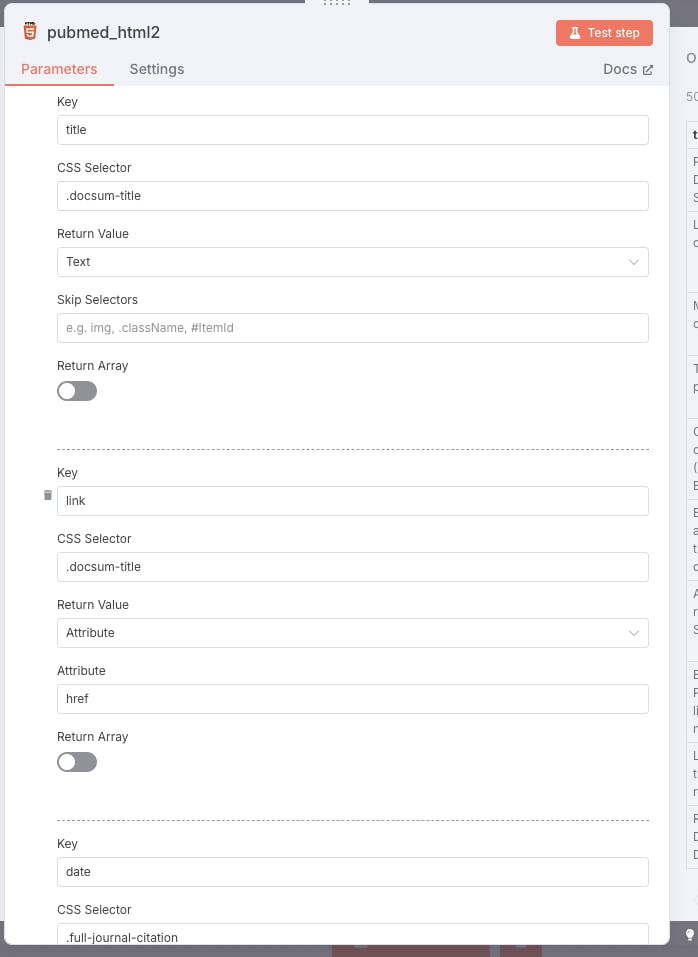
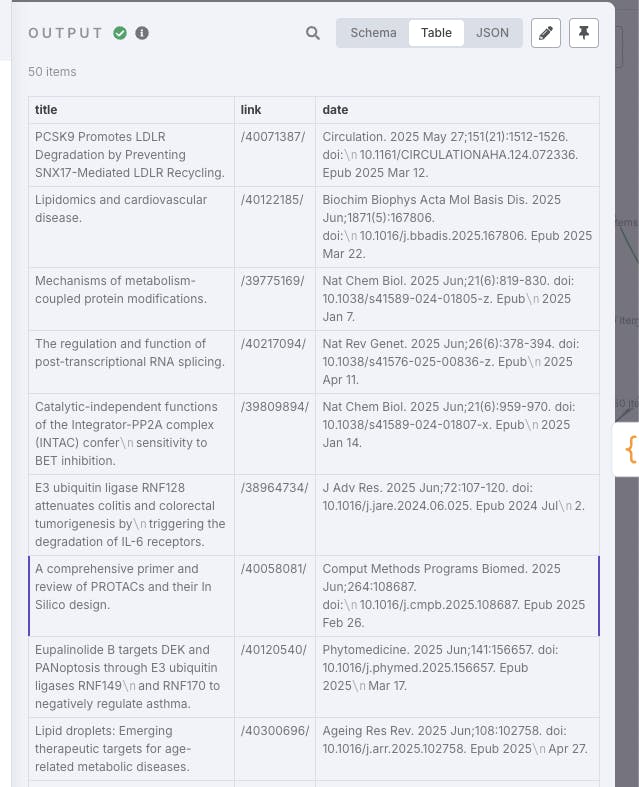
그렇게 정리한 결과
이 과정을 각 언론사별로 진행
느낀점
HTML파싱은 make보다 훨씬훨씬 좋다.
RSS는 자동화 설계할때 데이터 받아오는게 너무 귀찮아서, 오히려 검색해서 가져오는 방식이 속시원
다만 구글이나 큰 기업에서는 무작위 랜덤하게 클래스명을 짓기때문에 적용하기 힘듬
결과적으로 크롤링 서비스도 안쓰고 그냥 잘 자르고 잘 추출해오기 성공
