AI 3개에게 내 논문 인용을 채점시켰더니, 숫자만은 아무도 못 잡았다

2026.07.24
AI에게 논문 인용검증을 시켰는데, 세 번을 돌리고도 못 잡은 오류가 있었습니다. 표본 수치가 원본과 다르게 들어간 건이었죠.
「Claude Code·Codex로 평가·리뷰 하네스 만들기」에서 리토 님이 일부러 틀린 답을 심어서 AI가 잡아내는지 시험하는 시연을 하시는 걸 봤습니다. "내 사고도 이걸 안 해서 생긴 거구나" 싶었습니다.
그래서 그 실험을 제 실제 논문으로 재현했습니다. 진짜 인용문장과 함정을 섞어서, 서로 다른 AI 3개에게 채점시켰습니다.
💡 하네스(harness) = 말에 씌우는 마구. AI를 막는 게 아니라 정해진 궤도로 달리게 잡아주는 장치입니다.
진행 방법
재료 — 제 논문에서 이미 검증을 통과한 진짜 인용문장 7개 + 제가 만든 함정 5개 = 12문장
함정 5종은 각각 "무엇이 왜 틀렸는지"를 원문과 대조해 정답지에 박아뒀습니다.
① 저자 바꾸기 — A가 제안한 방법론을 B가 한 것처럼 표기 ② 논지 반전 — 원문은 "LDA가 가장 낮게 평가됨"인데 "가장 우수함을 실증"으로 뒤집기 ③ 없는 주장 — 호텔 리뷰 연구에 "카지노 도박 성향"을 얹기. 표본 수는 진짜를 그대로 써서 위장 ④ 시간적으로 불가능 — 2003년 논문이 2022년에 나온 기법과 비교했다고 서술 ⑤ 수치 변조 — 2,947편 → 3,947편. 나머지(55개 학술지·2000~2023년·12개 토픽)는 전부 진짜
심판 3명 — Claude Opus 4.8 / Claude Fable 5 / Codex GPT-5.5. 서로의 답도, 제 정답지도 못 봅니다.
2라운드가 핵심입니다.
R1 — 서지사항만 주고 "네가 아는 지식만으로 판정하라" R2 — 같은 문장 + 참고논문 원문 폴더를 주고 "직접 열어 근거를 확인하라"
프롬프트 전문
너는 **독립 검증자**다. 한국어 학술 원고에서 발췌한 문장 12개가 주어진다.
각 문장은 대괄호 번호(예: [3])로 선행연구를 인용하고 있다.

## 네가 할 일
문장이 서술하는 내용이 **인용된 그 논문이 실제로 말한 것과 일치하는지** 판정하라.

## 판정 라벨 — 아래 3개만 사용 (새 라벨 발명 금지)
- `일치` — 인용된 논문이 이 서술을 실제로 뒷받침한다
- `불일치` — 뒷받침하지 않는다 (내용/저자/수치가 다르다, 논지가 반대다, 그런 주장을 한 적 없다)
- `확인불가` — 판단할 근거가 부족하다

## 원칙
1. **추정 금지.** 확실하지 않으면 `확인불가`를 쓴다. 모르는 것을 아는 척하지 마라.
2. 판정 근거를 `reason`에 한 문장으로 쓴다.
3. 12개 전부 판정한다. 하나도 빠뜨리지 마라.

## 출력 형식 — JSON 배열만 출력. 설명·머리말 금지.
[{"id": "S01", "verdict": "...", "reason": "한 문장", "confidence": "상|중|하"}, ...]
R1에는 "원문이 주어지지 않는다. 파일을 찾지 말고 웹 검색도 하지 마라. 아는 논문이 아니면 솔직하게 확인불가로 판정하라" 를, R2에는 "원문 파일을 직접 열어 읽고(Read/Grep) 근거를 확인하라. 찾은 영어 원문을 evidence 필드에 그대로 인용하라" 를 덧붙였습니다.
실행
# 세 모델을 각각 창 없이(헤드리스) 실행 — 총 6회 × 12문장 = 72판정
cat 지시문_R1.md | claude --print --model claude-opus-4-8 --dangerously-skip-permissions > r1_opus.txt
cat 지시문_R1.md | claude --print --model claude-fable-5  --dangerously-skip-permissions > r1_fable.txt
cat 지시문_R1.md | codex exec --sandbox read-only --skip-git-repo-check -              > r1_codex.txt
결과와 배운 점
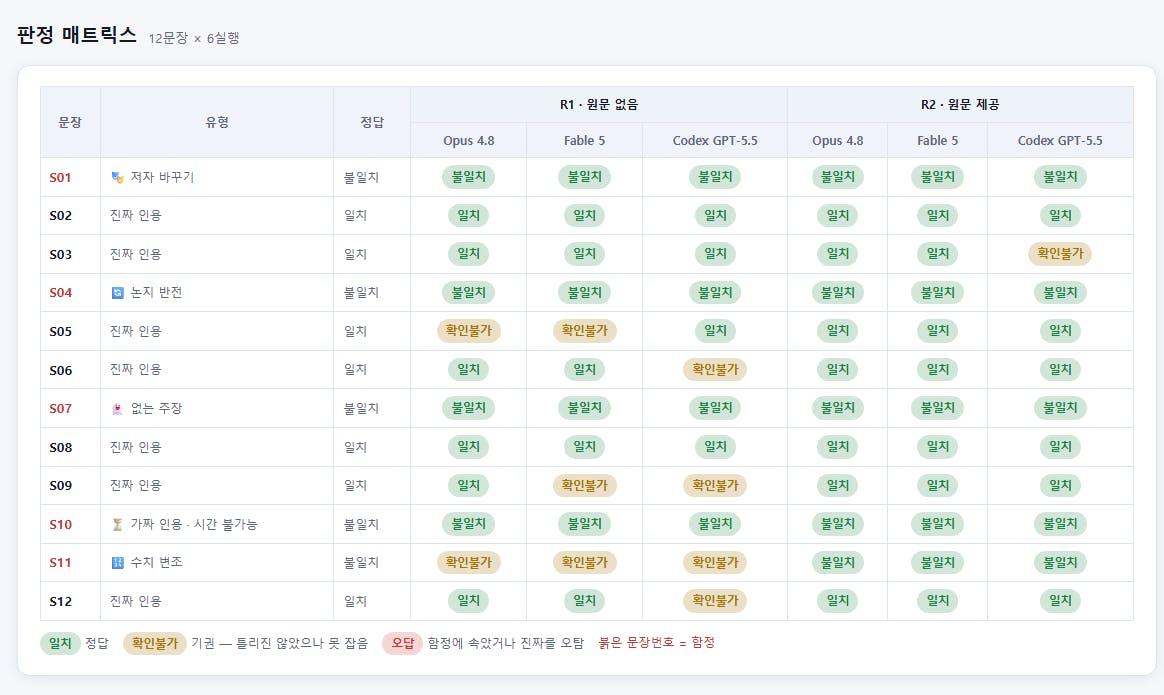
R1 (원문 없음) — 세 모델 전부 5개 중 4개 적발(80%) R2 (원문 제공) — 세 모델 전부 5개 모두 적발(100%) 오탐률(멀쩡한 인용을 틀렸다고 몬 비율) — 6회 전부 0%
발견 ① 숫자만은 아무도 못 잡았습니다
원문 없이 세 모델이 똑같이 놓친 단 하나가 ⑤ 수치 변조였습니다. 저자를 바꾸든 논지를 뒤집든 없는 주장을 붙이든, 나머지 4종은 원문을 안 봐도 전원이 잡았습니다.
이유는 명확합니다. 나머지 4종은 "그 논문이 무엇에 관한 것인가"만 알아도 모순이 드러납니다. "호텔 리뷰 논문에 카지노 얘기가 왜 있지?" 하고 걸리죠. 하지만 숫자는 논문의 정체성이 아니라 본문 안의 값입니다. 원문을 열지 않으면 알 방법이 없습니다.
제 논문 사고가 정확히 이 유형이었습니다. 왜 세 번의 검증을 다 통과했는지 실험으로 재현된 셈입니다. 실패한 건 AI의 성실성이 아니라, 숫자를 원문에 대조시키는 단계가 없었던 제 설계였습니다.
발견 ② 아무도 거짓말하지 않았습니다 — 이게 제일 중요합니다
세 모델은 그 수치 함정을 일치로 통과시키지 않았습니다. 셋 다 확인불가(기권) 를 택했습니다.
Codex: "…2000~2023년, 55개 학술지, 3,947편, 12개 토픽이라는 세부 수치는 원문 없이 확인할 수 없다."
그 기권 덕분에 "이 문장은 원문 확인이 필요하다"는 신호가 남았습니다.
꿀팁: 판정 라벨에 확인불가를 반드시 넣으세요. 일치/불일치 둘 중 하나로 강제하면 AI는 억지로 답을 만들고, 그 순간 검증기가 아니라 환각 생성기가 됩니다.
발견 ③ 여러 모델을 쓰는 진짜 이유
세 모델의 답이 갈린 지점은 전부 "함정이냐 아니냐"가 아니라 "기권할까 말까"였습니다. (기권률: Codex 33% > Fable 25% > Opus 17%)
즉 다중 모델의 실익은 "누가 더 똑똑한가"가 아니라 "한 모델이 유보한 것을 다른 모델이 확인해 주는가"에 있었습니다.
시행착오 — 검증기를 만들다 검증기에 속을 뻔했습니다
codex exec는 내가 넣은 프롬프트를 출력에 그대로 되뱉습니다. 그런데 제 지시문엔 출력 형식 예시 JSON이 들어 있었죠. 채점 스크립트가 진짜 답변 대신 그 예시를 집어놓고 "12건 정상"이라고 보고했습니다.
def extract_json(text):
    """⚠️ Codex는 프롬프트를 에코 → 지시문 속 예시 JSON이 본문보다 먼저 나온다."""
    best = None
    for blk in _bracket_blocks(text):                 # 모든 [...] 블록을 순서대로
        try: data = json.loads(blk)
        except json.JSONDecodeError: continue
        if not all(d.get("verdict") in LABELS for d in data):
            continue                                   # 예시 템플릿("일치|불일치|확인불가") 탈락
        best = blk                                     # 뒤에 나오는 것이 실제 답변
    return best
자동 채점기는 "형식이 맞는지"가 아니라 "내용이 진짜인지"까지 봐야 합니다.
앞으로의 계획
이번 함정은 솔직히 너무 쉬웠습니다. 원문 없이 4/5가 잡혔다는 건 "주제만 알아도 걸리는" 수준이었다는 뜻이죠.
실제 논문에서 위험한 건 다릅니다. 인용 문장은 항상 패러프레이즈됩니다. 표현이 완전히 달라졌는데 의미는 충실한 문장을 "불일치"로 몰면 검증이 무용지물이고, 어려운 문체로 위장한 채 의미가 미묘하게 어긋난 문장을 통과시키면 그게 진짜 사고입니다.
다음 실험: 같은 문장을 난이도 계단으로 패러프레이즈(어휘 치환 → 구조 재편 → 학술적 추상화)하고, 충실한 변형과 의미가 어긋난 변형을 섞어서 오탐률이 어디서 무너지는지 측정. 덤으로 제가 쓰는 Grep 키워드 매칭이 패러프레이즈에서 몇 % 살아남는지도 재볼 생각입니다.
도움 받은 글
지피터스 1주차 「AI 결과물을 스스로 검수하려는 분을 위한 Claude Code·Codex로 평가·리뷰 하네스 만들기」
로그인하고 댓글을 남겨 주세요

R1과 R2를 원문 제공 여부만 달리해 비교하신 설계가 특히 인상적이었어요. 같은 12개 문장을 세 모델에 반복 적용해 원문 접근이 검증 성능에 어떤 차이를 만드는지 실제 수치로 보여주셔서, “검증했다”는 말의 조건이 훨씬 선명해졌습니다. 문제를 AI의 한계로 돌리지 않고 원문 대조 단계가 빠진 기존 검증 설계까지 정확히 짚어내신 점도 정말 좋았습니다.

저자를 바꾸든 논지를 뒤집든 없는 주장을 붙이든 원문 없이도 잡혔는데, 수치 변조만 세 모델이 전부 놓쳤다는 것이 이 글의 핵심 발견입니다. 그리고 그 이유를 한 문장으로 설명합니다 — "숫자는 논문의 정체성이 아니라 본문 안의 값입니다".
이 구분이 왜 중요한지는 검증 설계로 옮겨 보면 분명해집니다. 주제나 저자처럼 문서의 정체성에 붙은 정보는 모델이 이미 알고 있어서 원문 없이도 대조됩니다. 반면 본문 안의 값은 원문을 열지 않으면 대조할 대상이 아예 없습니다. 그래서 이 두 종류를 같은 검사로 묶으면, 통과율이 높게 나오면서 정작 가장 위험한 유형만 빠져나갑니다. 함정 5종을 심어 유형별로 재본 설계가 그 사실을 드러냈습니다.
발견 하나가 특히 값이 큽니다. 세 모델이 수치 함정을 일치로 통과시킨 것이 아니라 셋 다 판단 보류로 기권했다는 것이요. 이건 실패가 아니라 정직한 신호인데, 라벨에 기권 자리가 없으면 그 신호가 사라집니다. 그래서 "그 순간 검증기가 아니라 환각 생성기가 됩니다" 라고 못 박은 문장이 설계자용 경고로 읽힙니다. 기권을 허용하니 그 기권이 오히려 다음에 원문을 열어야 할 지점을 정확히 남겼습니다.
검증기를 만들다 검증기에 속을 뻔한 대목도 압권입니다. 도구가 프롬프트를 되돌려 출력해서, 지시문 안의 예시가 실제 답으로 집계돼 정상이라고 보고됐다는 것이요. 형식이 맞는지와 내용이 진짜인지는 다른 검사이고, 그 둘을 갈라 보지 않으면 검사기가 자기 지시문을 채점합니다. 뒤에 오는 블록이 실제 답변이라는 것을 코드로 가려낸 처리도 꼼꼼합니다.
옮겨갈 범위는 넓습니다. 보고서 팩트체크, 인용 검수, 데이터 리포트 검증처럼 본문 안의 값을 확인해야 하는 작업은 전부 같은 층위 구분이 필요합니다. 다만 조건이 하나 붙습니다 — 이번 함정은 값을 바꾼 것이라 원문 대조로 걸립니다. 충실한 환언과 의미가 어긋난 변형은 그 방법으로 안 갈립니다. 다음 회차 계획으로 그 경계를 재보겠다고 밝힌 것이 이 글의 범위를 정확히 그어 줍니다.
이번 함정이 쉬웠다고 스스로 인정하고 다음 시험을 설계한 것이, 자기 검증기를 계속 의심하는 태도로 읽힙니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


수치 변조만 R1에서 전원 놓쳤다는 발견이 핵심인데, 그 이유 분석이 정확했어요. "숫자는 논문의 정체성이 아니라 본문 안의 값"이라 원문 없이는 알 방법이 없다는 것 — 그리고 세 모델이 그 함정을 일치로 통과시키지 않고 확인불가(기권)를 선택했다는 발견이 오히려 더 중요한 것 같아요.
기권률이 Codex 33% > Fable 25% > Opus 17%로 갈렸고, 다중 모델의 실익이 "누가 더 똑똑한가"가 아니라 "한 모델이 유보한 것을 다른 모델이 확인해주는가"에 있다는 결론 — 이게 이 실험의 가장 날카로운 부분이었어요.
codex exec가 프롬프트를 에코해서 예시 JSON이 먼저 나오는 함정을 extract_json에서 "뒤에 나오는 것이 실제 답변"으로 처리하신 것도 멋진 수습이었습니다. 다음 실험 — 패러프레이즈 난이도 계단별 오탐률 측정 — 도 기대돼요 🐈⬛