내 AI 비서 '하루'의 잡일을 로컬 Gemma에게 넘겼다 — Claude는 지휘, Gemma는 요약 (벤치마크·삽질·검증 전 과정)
2026.06.03
AI 비서 최적화 소개
나는 Mac (36GB)에서 Hermes라는 개인 AI 에이전트를 24시간 돌리고, 텔레그램 봇 '하루'로 출근길에서도 집에서도 명령을 던진다. "이거 요약해줘", "6월 7일 오전 부산행 SRT표 구해줘", "이 일정 기억해둬" 같은 것들이다. 두뇌는 클라우드 Claude(Sonnet 4.6)다. 똑똑하고 잘 돌아간다. 문제는 단 하나, 토큰(비용)이다.
그래서 로그를 들여다보니 에이전트가 클라우드에 던지는 호출 중엔 "굳이 비싼 Claude가 안 해도 되는 잡일"이 꽤 섞여 있었다. 세션 제목 짓기, 들어온 작업 분류(triage), 그리고 대화가 길어지면 자동으로 도는 맥락 요약(compression) 같은 것들. 이런 단발성 잡일까지 전부 최상급 모델이 처리하고 있었던 거다. 그래서 목표를 이렇게 잡았다.
판단·코딩처럼 똑똑해야 하는 건 Claude에게 그대로 두고, 도구 호출이 필요 없는 단발 텍스트 잡일만 로컬 LLM(Gemma)에게 넘겨 토큰을 아끼자.
핵심 제약은 메모리였다. 36GB 통합 메모리라 27B급 큰 모델을 24시간 띄워둘 여유가 없다. macOS, 브라우저, 작업 앱들이 이미 RAM을 나눠 쓰고 있으니까. 그래서 "전부 로컬"은 불가능하고, "가벼운 작업만 로컬, 무거운 건 클라우드"라는 하이브리드가 유일하게 현실적인 답이었다.
이 글은 그 하이브리드를 ① 어떤 로컬 런타임을 쓸지 벤치마크로 정하고, ② Hermes에 실제로 배선하고, ③ "정말 Gemma가 도는지"를 로그로 검증하기까지의 전 과정 기록이다. 중간에 통념이 깨지고, 봇한테 속고(!), 임계치 함정에 빠진 삽질도 그대로 적었다. 그게 따라 하려는 사람한테 제일 도움이 되니까.
AI 비서 최적화 진행 방법
메모리 확보 전략
로컬 모델을 띄우려면 RAM 여유부터 확보해야 한다. 그런데 점검해 보니 두 가지 문제가 있었다.
(1) 안 쓰는 LLM 런타임이 상주 중. 예전에 테스트하다 켜둔 Ollama와 LM Studio가 둘 다 백그라운드에 떠서 자동시작 항목으로 등록돼 있었다. 지금 두뇌는 클라우드 Claude라 이것들은 그냥 RAM을 깔고 앉은 셈. 두 앱을 종료하고 자동시작에서 뺐다.
(2) "메모리 부족" 착각. 활성 상태 보기에서 여유 RAM이 적어 보여 불안했는데, 실제 지표를 보니 멀쩡했다.
Open optionsauto
System-wide memory free percentage: 91%
vm.swapusage: used = 0.00M ← 스왑 0
💡 꿀팁 — macOS는 빈 RAM을 일부러 캐시로 채운다. 그래서 "여유 RAM" 숫자는 항상 적게 보인다. 진짜 건강 지표는 스왑 사용량 + 메모리 압력이다. 스왑 0 = 압력 없음 = 건강. 그리고 RAM을 제일 많이 먹던 범인은 LLM이 아니라 Chrome(헬퍼 합쳐 4.6GB), Notion(2.5GB) 이었다. 큰 모델 띄울 땐 이것들을 잠깐 닫는 게 Ollama 끄는 것보다 훨씬 효과적이다.
(3) 곁가지 삽질 — 봇이 끊겼다 붙었다. 정리하다 보니 텔레그램 봇이 8일째 45초마다 폴링 충돌(Conflict: terminated by other getUpdates)을 일으키고 있었다. 추적해보니 예전에 다른 MacBook에 띄워둔 봇 인스턴스가 같은 토큰으로 살아있어서 둘이 서로 연결을 뺏고 있었던 것. 텔레그램은 토큰당 폴러가 하나여야 한다. 그 Mac에서 봇을 내리자 충돌이 딱 멈췄다. (교훈: 봇이 불안정하면 다른 기기의 중복 인스턴스를 의심하라.)
로컬 런타임 선택
로컬 LLM 실행기는 보통 둘이다. Ollama(CLI/데몬형, GGUF)와 LM Studio(GUI형, Apple 네이티브 MLX 지원). "Apple Silicon에선 MLX가 빠르다"는 통념 때문에 LM Studio가 유리할 줄 알았다. 그래서 추측 대신 같은 모델로 직접 쟀다.
먼저 가벼운 gemma-4-E4B(둘 다 GGUF)로 idle 오버헤드와 속도를:
Open optionsauto
# Ollama (--verbose가 tok/s를 직접 출력)
ollama run --verbose gemma4 "In one sentence, what is the ocean?"
# eval rate: 77.1 tokens/s, idle 데몬 RSS: 170 MB
# LM Studio (헤드리스 lms + OpenAI 호환 API)
lms server start && lms load google/gemma-4-e4b --yes
curl -s localhost:1234/v1/chat/completions -d '{...동일 프롬프트...}'
# → 72 tokens/s, idle 서버 RSS: 549 MB
여기까진 박빙(77 vs 72)이었다. 그래서 무거운 qwen3.6-27B로 넘어갔는데 — 여기서 통념이 깨졌다. 처음 MLX 측정이 21.8 tok/s로 너무 낮게 나와서 "MLX는 첫 실행에 커널 컴파일 페널티가 있다"는 걸 떠올리고 워밍업 후 2회 더 쟀다. 그래도 21.8, 21.9로 똑같았다. 일시적 현상이 아니었다.
Open optionsauto
ollama run --verbose qwen3.6 "Write a 250-word essay ..."
# → 41.1 tok/s (GGUF, 메모리 26GB 점유)
lms load qwen3.6-27b-mlx + 같은 프롬프트 (워밍업 후 3회)
# → 21.8 tok/s (MLX 4bit, 메모리 16GB 점유)
항목 | Ollama (GGUF) | LM Studio (MLX) |
|---|---|---|
idle 메모리 (모델 미로드) | 170 MB | 549 MB |
gemma-4-E4B 속도 | 77 tok/s | 72 tok/s |
qwen3.6-27B 속도 | 41 tok/s | 22 tok/s |
qwen 메모리 점유 | 26 GB | 16 GB |
모델 자동 언로드 | ✅ keep-alive 후 | ❌ 수동 |
⚠️ 통념 반전 — MLX가 더 빠를 줄 알았는데 qwen3.6-27B에선 Ollama(GGUF)가 2배 빨랐다(41 vs 22). 원인 추정: 이 모델이 MoE(전문가 혼합) 구조라서다. llama.cpp(Ollama)의 MoE 커널이 MLX의 MoE 경로보다 훨씬 최적화돼 있었다. "MLX가 빠르다"는 건 dense 모델 한정이었던 것. 내 모델은 gemma E4B(효율형)·qwen MoE라 전부 Ollama가 유리했다.
📌 공정성 메모(중요): 두 qwen의 양자화가 달랐다(GGUF 26GB vs MLX 4bit 16GB). 게다가 Apple Silicon에선 GPU/통합메모리가 RSS에 다 안 잡혀 "로드 메모리" 수치는 부정확하다. 그래서 신뢰할 수 있는 비교는 idle 오버헤드와 tok/s 두 개다. 그래도 결론은 분명했다.
종합하면 Ollama는 ① idle이 3배 가볍고, ② MoE에서 더 빠르며, ③ 안 쓰면 모델을 자동으로 내려 RAM을 비운다(keep-alive). 메모리 절약이 목적인 나에겐 ③이 결정타였다. → Ollama 채택.
Hermes에 멀티 LLM 배선
코드를 까보니 Hermes는 멀티 LLM 라우팅을 이미 3층으로 지원하고 있었다.
① 위임(
delegate_task) — 메인(Claude)이 하위 작업을 다른 모델 워커에게 넘김. 코드 주석에 "cheap/fast model while parent runs premium"이라고 대놓고 적혀 있었다.② 보조작업(
auxiliary) — compression·title·triage 등 백그라운드 단발 호출마다 모델 지정.③ 커스텀 프로바이더(
custom_providers) — 로컬 엔드포인트 정의.
즉 배관은 다 깔려 있었고, 문제는 기존 설정이 느린 LM Studio(:1234)를 가리키고 있던 것이었다. Ollama(:11434)로 다시 배선했다.
Open optionsauto
yaml
# ~/.hermes/config.yaml — 로컬 모델을 Ollama로 재배선
custom_providers:
- name: gemma-local
  base_url: http://localhost:11434/v1
  model: gemma4
- name: qwen-local
  base_url: http://localhost:11434/v1
  model: qwen3.6
# 보조 작업만 Gemma로 라우팅 (메인 대화·판단은 그대로 Claude)
auxiliary:
  title_generation: { provider: custom, model: gemma4, base_url: http://localhost:11434/v1 }
  triage_specifier: { provider: custom, model: gemma4, base_url: http://localhost:11434/v1 }
  compression: { provider: custom, model: gemma4, base_url: http://localhost:11434/v1 }
로컬 라우팅을 켜려면 Ollama 서버가 늘 떠 있어야 한다. 그런데 GUI 앱의 자동시작 항목은 무겁고(549MB), 확인해보니 백그라운드 등록 상태가 disabled였다. 그래서 무거운 GUI 대신 데몬만 자동 실행하는 LaunchAgent를 직접 만들었다 — idle 92MB(GUI 띄울 때보다 더 가벼움), 5분 미사용 시 모델 자동 언로드.
Open optionsauto
xml

ProgramArguments

  /usr/local/bin/ollama
  serve

EnvironmentVariables
OLLAMA_KEEP_ALIVE5m
RunAtLoad
KeepAlive
변경 전엔 항상 config.yaml을 백업하고, "compression만 클라우드로 즉시 되돌리는" 원클릭 스크립트(revert-compression.sh)까지 만들어 안전장치를 뒀다. 그리고 hermes gateway restart로 적용. 완성된 두뇌 구조는 이렇다.
Open optionsauto
┌─────────────────────────────────────────┐
│ Claude (오케스트레이터, 클라우드)            │ ← 판단·코딩·도구호출
└───────────────┬─────────────────────────┘
                │ 보조 작업만 위임
┌───────┴────────┐
▼               ▼
Gemma (로컬, Ollama)  ComfyUI (이미지)
제목 / 분류 / 요약 (이미 연결됨)
문제 해결 과정
삽질 ①. 제목 생성으로 테스트했더니 Gemma가 안 돌았다. "텔레그램에서 새 대화(/new)를 시작하면 제목 생성이 Gemma를 부르겠지" 하고 메시지를 보냈는데 Ollama 로그가 조용했다. 코드를 까보니 — 텔레그램 DM의 제목은 LLM이 아니라 세션ID 앞자리(session_id[:8])로 매기는 휴리스틱이라 애초에 LLM 호출이 없었다. 즉 "라우팅을 했어도 그 슬롯이 안 터지는" 상황. → 슬롯마다 실제로 LLM을 부르는지부터 확인해야 한다.
삽질 ②. 봇이 거짓말을 했다. (이게 제일 중요) 다시 테스트하니 하루가 "메모리가 꽉 차서 기존 항목을 압축해서 저장할게요 📝"라고 친절하게 답했다. "오, 압축됐네!" 하고 넘어갈 뻔했는데 — 로그를 까보니 Gemma 호출이 0건, ollama ps도 텅 비어 있었다. 봇이 한 말은 그냥 대화체 연출이었다. 실제 compression 시스템은 손도 안 댔다.
⚠️ 이 글에서 가장 중요한 교훈 — 봇의 '말'을 믿지 말고 '로그'를 믿어라. LLM은 안 한 일도 했다고 아주 자연스럽게 말한다. 검증은 오직
ollama ps(모델 로드 여부)와 게이트웨이 로그(실제 compression 이벤트)로만 한다.
삽질 ③. 임계치 함정 — 압축이 원래 거의 안 터진다. 진짜 compression은 "컨텍스트가 임계치를 넘어야" 발동하는데, 기본값이 85% of 100만 토큰(=85만 토큰) 또는 메시지 400개였다. 일상 대화로는 평생 못 닿는 양이다. 게다가 protect_last_n: 20이라 최근 20개 메시지는 요약 대상에서 보호된다. 그래서 짧은 테스트로는 절대 안 터진다. 테스트용으로 임계치를 잠깐 낮췄다 — 메시지 16개 도달 시 강제 요약, 보호 범위 4개로 축소. 끝나면 정상값으로 복원하는 스크립트(restore-trial.sh)도 같이 만들었다.
Open optionsauto
yaml
# (테스트 모드 — 끝나면 원복)
compression:
  protect_last_n: 4 # 20 → 4
  hygiene_hard_message_limit: 16 # 400 → 16
결과와 배운 점
결과 — 검증 로그로 확정
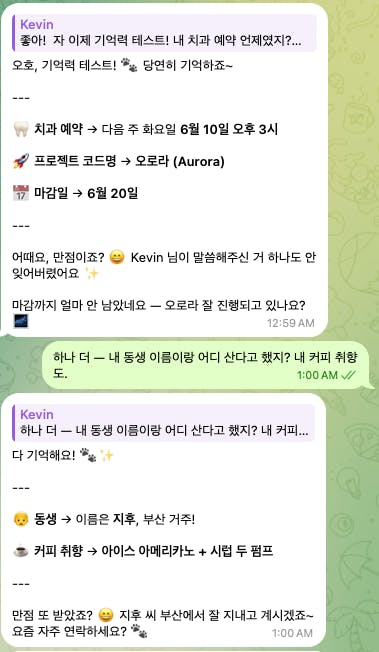
임계치를 낮춘 뒤, 하루에게 구체적 사실 4개를 일부러 심었다(치과 예약·프로젝트 코드명/마감·동생 이름/거주지·커피 취향 — 전부 테스트용 가짜 정보). 그리고 잡담으로 대화를 늘려 16개 메시지를 넘긴 뒤, 마지막에 "그 사실들 기억나?"라고 물었다. 게이트웨이 로그가 진실을 보여줬다.
Open optionsauto
00:54:54 Session hygiene: 24 messages, ~29,239 tokens — auto-compressing
00:55:22 compressed 24 → 8 msgs (29,239 → 1,003 tokens)
00:57:27 Session hygiene: 16 messages, ~53,944 tokens — auto-compressing
00:57:51 compressed 16 → 6 msgs (53,944 → 1,162 tokens)
# 동시에 ollama ps 에 gemma4:latest 로드 확인 ✅ (직전엔 비어 있었음)
✅ 검증 통과 — compression이 실제로 2번 발동했고 그 요약을 Gemma가 처리했다(ollama ps로 로드 확인). 24개→8개 메시지로 공격적으로 압축(토큰 29k→1k, 무려 96% 축소)했는데도, 이어진 기억력 질문에서 하루는 심어둔 사실 5개를 100% 정확히 회상했다 — 치과 6/10 화 3시, 프로젝트 '오로라' 마감 6/20, 동생 지후·부산, 아이스 아메리카노+시럽 2펌프. Gemma의 요약이 핵심 정보를 하나도 흘리지 않았다. 검증 후 임계치는 정상값으로 복원했다.
[캡처: 하루가 사실 5개를 모두 맞춘 텔레그램 답장 + ollama ps에 gemma4 뜬 화면]
핵심 팁
로컬 에이전트 백엔드는 Ollama가 유리. idle 3배 가볍고, 모델 자동 언로드로 RAM을 스스로 비운다. MoE 모델이면 속도도 더 빠르다. GUI가 필요 없으면
ollama serve만 LaunchAgent로 띄워라(92MB).통념을 의심하고 직접 재라. "MLX가 빠르다"는 dense 모델 얘기. MoE에선 GGUF/Ollama가 2배 빨랐다. 벤치마크는 반드시 내가 실제로 쓸 모델로.
봇 말 ≠ 사실. 로그로 검증하라.
ollama ps+ 게이트웨이 로그가 유일한 진실. 봇의 "했어요"는 연출일 수 있다."무엇을 로컬로 넘길까"의 기준 = 도구 호출이 필요 없는 단발 텍스트. 요약·분류·제목은 로컬 OK. 코딩·판단·복잡한 도구 루프는 클라우드 유지 — 로컬 모델은 에이전트형(멀티 툴콜) 작업에 여전히 약하다(응답 지연·빈 응답·없는 툴 환각).
compression은 기본 임계치에선 거의 안 터진다. 토큰 절감을 실제로 보려면 메시지/토큰 임계치를 중간값(예: 40~80메시지)으로 낮춰야 한다. 안 그러면 "켜뒀지만 평생 안 도는" 상태.
36GB 메모리 예산 감각. 4bit 기준 7~8B ≈ 5GB(여유), 14B ≈ 9GB(편함), 27B ≈ 16~26GB(빠듯, Chrome·Notion 닫고 단독 권장). 상시 워커는 가벼운 Gemma가 현실적.
배운 점
멀티-LLM 오케스트레이션에서 진짜 병목은 "기능이 있느냐"가 아니었다. Hermes엔 위임·라우팅 기능이 이미 다 있었다. 병목은 두 가지였다 — ① 로컬 모델의 신뢰도/속도(에이전트형 작업엔 여전히 약함), ② 그 기능이 실제로 트리거되는 조건(임계치/휴리스틱). 화려한 구조도를 그리는 것보다, "이 작업이 정말 LLM을 부르는가? 그 호출이 정말 로컬로 가는가?"를 로그로 한 줄씩 확인하는 게 작업의 90%였다. 그리고 그 과정에서 봇한테 한 번 속았다는 게(삽질②) 가장 값진 경험이었다.
또 하나 — 메모리 관리와 토큰 절약은 사실 같은 게임이었다. 로컬을 쓰려면 RAM을 비워야 하고, RAM을 비우려면 안 쓰는 걸 꺼야 하고, 그러다 보니 환경 전체가 정돈됐다.
앞으로 할 일 · 도움 요청
compression 임계치를 중간값(메시지 40~80개)으로 조정해 며칠간 실제 토큰 절감량을 측정해볼 계획. (지금은 정상 임계치라 거의 안 터져서 절감 효과가 미미함)
다음 단계로 비코딩 요약·문서정리 작업을 위임(delegate) 워커로 로컬에 넘기는 실험.
요약 품질이 떨어지면 즉시 클라우드로 되돌리는 토글 스크립트는 준비 완료.
도움 요청 🙏 — 클라우드+로컬 하이브리드를 쓰시는 분들께: "어떤 작업을 로컬로 넘겼을 때 가장 효과적이었나요?" / "compression(맥락 요약) 임계치는 얼마로 두세요?" / "로컬 모델로 코딩 위임, 쓸 만한 조합 찾으셨나요?" 댓글로 노하우 공유 부탁드립니다.
도움 받은 글
Hermes Agent (NousResearch) 공식 문서 —
auxiliary모델 슬롯,delegate_task(위임) 라우팅, compression 설정Ollama 공식 문서 — OpenAI 호환 엔드포인트(`/v1`),
OLLAMA_KEEP_ALIVE, 모델 자동 언로드LM Studio 공식 문서 — 헤드리스
lmsCLI, MLX 모델 로드※ 봇 토큰·사용자 ID 등 민감정보는 모두 마스킹했고, 테스트에 쓴 개인 사실(치과/동생 등)은 전부 가짜 데이터입니다.


필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
직접 올라마와 lm스튜디오를 비교하신 내용 너무 흥미롭네요!
저는 lm studio 가 체감상(감으로...) 빠르것같아 계속 사용하고 있었는데...!
저도 한번 다시 체크해봐야 할 부분인것 같아요 너무 좋은 사례글이었습니다 :)
저는 체감상 LM Studio하고는 뭔가 잘 돌아가지 않고 Ollama가 무리없이 돌아가서 벤치마킹을 하여 플렛폼 선정에 이르게 되었습니다. 평소에는 빠른 답변이나 신뢰 있는 답변을 받아야 되기 때문에 현재 주로 Claude를 쓰고 그 뒤에 시간 걸려도 되는 업무에 Qwen3.6 27 모델 (이미지 생성), Gemma4(빠른 응답 및 멀티모달 처리)로 사용하려고 합니다.