


소개
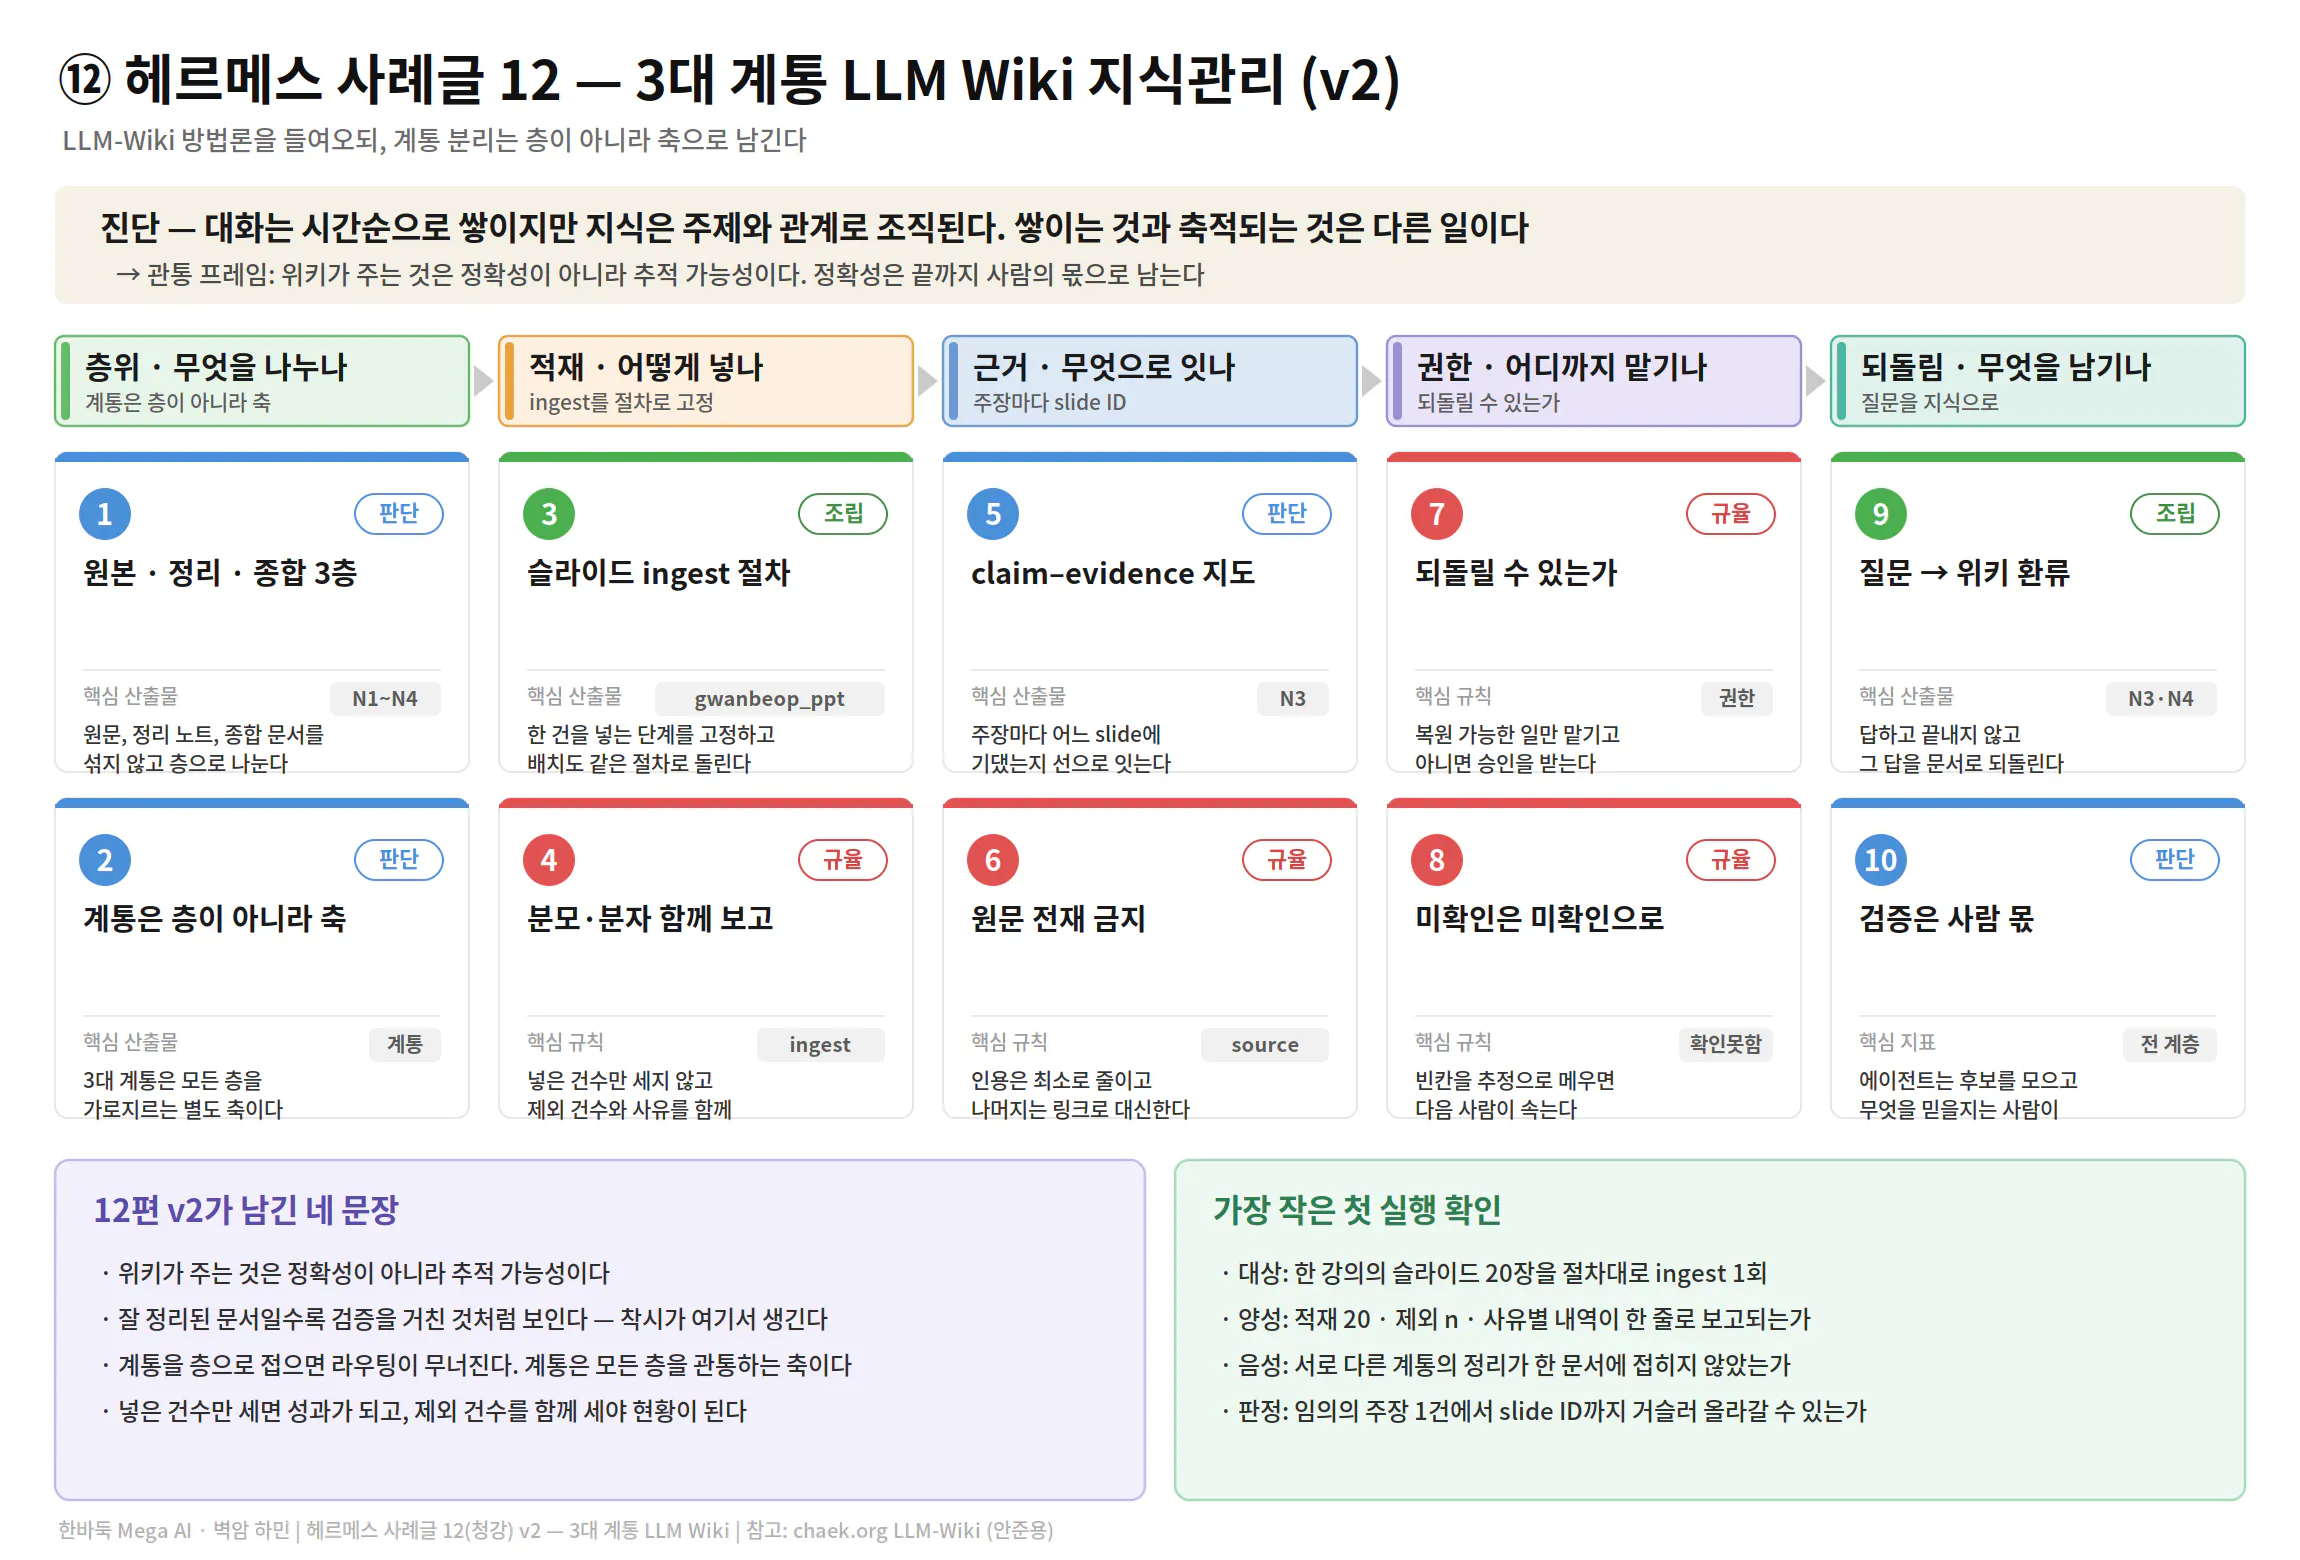
2-1. 시도한 것
헤르메스는 사주 통변(通辯)을 근거 슬라이드와 함께 생성하는 LangGraph 파이프라인입니다. 11편까지 오면서 규율(N4 가드레일 · N6 fail-closed)과 검증(N7 리뷰 하네스)은 어느 정도 모양이 잡혔습니다.
그런데 정작 판단이 딛고 설 지식 자체는 손대지 않은 상태였습니다. 3대 계통 자료는 gwanbeop_ppt 테이블에 슬라이드 단위로 적재만 돼 있고, 항목 사이의 관계·상호 참조·용어 정의는 어디에도 없었습니다.
이번 편은 청강2(DECK님 LLM Wiki 지식관리 AI 에이전트)를 헤르메스에 흡수해, RAG 지식을 계통별 위키 항목(용어 · 정의 · 근거 슬라이드 · 연관 링크 · 검증 상태)으로 구조화한 기록입니다.
2-2. 그 이유 — 건수는 늘었는데 유사도가 안 움직였습니다
계기는 단순했습니다. 자료는 계속 늘어나는데 검색 품질이 제자리였습니다.
항목
값
검증 상태
gwanbeop_ppt 누적 레코드
9,733건+
⚠️ 문서 기준 / 서버 실측 대조 필요
Dify RAG 문서
135문서
⚠️ 문서 기준
Layer 3 시맨틱 유사도 (19개 일주 교차검증)
0.5395
✅ 측정값
목표 유사도
0.80
목표치(미달성)
60갑자 일주 커버리지
19 / 60
✅ 측정값
AKM 27칸 매핑 중 실제 작동
7 / 27
✅ 점검값
⚠️ 누적 건수는 서버
SELECT COUNT(*)확인 전까지 확정값이 아닙니다. 프로젝트 내부 원칙상 "문서 ≠ 사실"로 다루며, 실측 대조 전 수치는 NOT_VERIFIED로 표기합니다. (문서마다 2,387건 / 2,700건 / 9,733건으로 값이 엇갈리는 상태를 실제로 겪었습니다.)
9,000건을 넘겼는데 유사도가 0.5395에서 멈춰 있다면, 문제는 자료의 양이 아닙니다. 슬라이드를 더 넣는 것으로는 해결되지 않는 무언가가 있다는 뜻입니다.
2-3. 3대 계통 — 섞이면 안 되는 세 개의 지식 체계
한바둑 MegaAI의 자료는 성격이 다른 3대 계통으로 나뉩니다. 이 구분이 위키 설계의 출발점입니다.
계통
내용
성격
탈XX 4관법 (gwanbeop)
음양 · 간지자의 · 육신 · 신살의 4관법 체계 (PPT 정리본)
이론 골격
박청화 강의 (parkcheonghwa)
춘하추동 · 운의해석 · 제트엔진 · 정진반 · 신살론 등
실전 통변
상리철학 (sangni)
象理哲學 (조명언 저 · 김동화 강의 정리)
원리 · 철학
같은 용어가 계통마다 다른 뜻으로 쓰입니다. 그래서 한 문장 안에서 두 계통을 섞으면, 문법적으로는 매끄럽지만 명리학적으로는 틀린 통변이 나옵니다. 헤르메스의 존재 이유 절반이 이 혼용을 막는 데 있습니다.
2-4. 최신 등재 현황 (2026-08 기준, 문서 기준값)
위키를 얹을 바닥이 어떤 상태인지부터 정리했습니다.
계통
시리즈
섹션/건수
slide 대역
비고
4관법
탈XX 4관법 PPT 정리본
1,593
—
이론 골격
박청화
운의해석 4편
460
6001~6725
春119·夏81·秋125·冬135
박청화
춘하추동 2010년판
340
2901~5199
春128·夏113·冬99 (秋 미등재)
박청화
춘하추동 2004년판
449
2200~2890
春94·夏127·秋137·冬91
박청화
제트엔진 上·中·下
635
7001~7630
10천간 전편 완료
박청화
정진반 上·下 (49강)
196
7001~7098 / 9636~9733
직업론 단일 축
박청화
로드투프로
135
7701~7835
박청화
무엇이든물어보세요 108강
108
9950~10057
content 전부 빈 값(스텁)
상리철학
상리철학 上 28강
82
—
⚠️ 위 표는 각 로드맵 문서에 기록된 값입니다. 서버 실측 COUNT와 대조 전까지 NOT_VERIFIED. 특히 제트엔진 上(7001~7233)과 정진반 上(7001~7098)의 slide 대역이 문서상 겹쳐 보이는데, 이 확인이 아래 3-3의 설계 결정으로 이어졌습니다.
진행 방법
사용 도구: PostgreSQL 17 (hanbadook_production, DigitalOcean 152.42.240.248) · Dify RAG(hybrid_search) · LangGraph N3 검색 노드 · Claude Opus 4.5(claude-opus-4-5-20251101)
3-1. 초안 스키마 — 제약 이름이 스스로에게 거짓말을 하고 있었습니다
먼저 만든 초안입니다.
sql
-- ❌ 초안 (문제 있음)
CREATE TABLE hermes_wiki (
  id            SERIAL PRIMARY KEY,
  lineage       TEXT NOT NULL,
  term          TEXT NOT NULL,
  definition    TEXT NOT NULL,
  source_slides TEXT[],
  related_terms TEXT[],
  CONSTRAINT no_cross_lineage
    CHECK (lineage IN ('sangni','gwanbeop','parkcheonghwa'))
);
제약 이름을 no_cross_lineage(계통 혼용 금지)라고 붙여놓고 "계통 분리는 스키마에 박았다"고 안심했습니다.
그런데 이 CHECK가 실제로 하는 일은 lineage 컬럼 값이 셋 중 하나인지 보는 것뿐입니다.
실제 계통 혼용은 이렇게 일어납니다.
lineage = 'parkcheonghwa' 인 항목의
source_slides = ['박청화_춘하추동_春#2950', '탈XX_4관법#1120']  ← 4관법 근거가 섞임
이 INSERT는 CHECK를 그냥 통과합니다. 이름은 계통 혼용을 막는다고 말하는데, 코드는 아무것도 막지 않고 있었습니다.
🔴 이름이 하는 일과 코드가 하는 일이 다를 때가 가장 위험합니다. 아무도 의심하지 않기 때문입니다.
3-2. 수정 스키마 — CHECK로 안 되는 것은 트리거로
sql
CREATE TABLE hermes_wiki (
  lineage       text NOT NULL
                CHECK (lineage IN ('gwanbeop','parkcheonghwa','sangni')),
  term          text NOT NULL,
  aliases       text[]  NOT NULL DEFAULT '{}',   -- 표기·음차 변형
  definition    text    NOT NULL,
  source_slides text[]  NOT NULL,                -- 'source#slide' 복합 형식
  related_terms text[]  NOT NULL DEFAULT '{}',
  edition       text,                            -- 판본 구분 (2004 / 2010 등)
  status        text    NOT NULL DEFAULT 'not_checked'
                CHECK (status IN ('verified','doc_only','not_checked')),
  verified_by   text,
  verified_at   timestamptz,
  wiki_ver      text    NOT NULL DEFAULT 'v1',

  PRIMARY KEY (lineage, term, COALESCE(edition,'')),  -- 계통·판본별 별개 항목
  CHECK (cardinality(source_slides) > 0),             -- 근거 없는 항목 금지
  CHECK (status <> 'verified' OR verified_by IS NOT NULL)
);

-- 계통 혼용을 '실제로' 막는 트리거 (CHECK로는 배열 원소 검증 불가)
CREATE OR REPLACE FUNCTION hermes_wiki_lineage_guard() RETURNS trigger AS $$
DECLARE bad text;
BEGIN
  SELECT s INTO bad
  FROM unnest(NEW.source_slides) AS s
  WHERE lineage_of(split_part(s, '#', 1)) <> NEW.lineage
  LIMIT 1;

  IF bad IS NOT NULL THEN
    RAISE EXCEPTION '계통 혼용 차단: [%] 항목에 타 계통 근거 [%] 포함', NEW.term, bad;
  END IF;
  RETURN NEW;
END $$ LANGUAGE plpgsql;

CREATE TRIGGER trg_wiki_lineage
  BEFORE INSERT OR UPDATE ON hermes_wiki
  FOR EACH ROW EXECUTE FUNCTION hermes_wiki_lineage_guard();
초안 대비 변경점
항목
초안
수정본
이유
PK
id SERIAL
(lineage, term, edition)
같은 용어가 계통·판본마다 다른 정의를 가짐
계통 분리
CHECK(도메인만)
트리거(근거 대조)
CHECK로는 배열 원소를 검증할 수 없음
aliases
없음
추가
STT 음차오류 대응 (3-4)
edition
없음
추가
춘하추동 2004판/2010판 병존 (3-5)
status
없음
추가
미검증 항목의 검색 차단 (3-6)
근거 0건
허용
cardinality > 0
근거 없는 위키 항목은 환각의 씨앗
PRIMARY KEY에 lineage를 넣은 것이 계통 분리 원칙의 스키마 표현입니다. "희기동소"가 박청화 계통과 상리철학 계통에서 다르게 쓰인다면 그건 하나의 항목이 아니라 두 개의 항목입니다. 억지로 합치는 순간 문장 내 혼용이 시작됩니다.
3-3. 왜 source_slides를 'source#slide' 복합 형식으로 두었나
처음에는 슬라이드 번호만 저장하려 했습니다. [6119, 4073] 이런 식으로요.
그런데 등재 현황을 대조하다 보니, 문서상 제트엔진 上편(7001~7233)과 정진반 上편(7001~7098)의 slide 대역이 겹쳐 보이는 구간이 나왔습니다. (실제 서버 상태는 실측 확인 대상입니다.)
겹침이 사실이든 문서 오기든, 여기서 배운 원칙은 하나입니다.
slide 번호는 전역 유일 키가 아닙니다. 반드시
source#slide복합 형식으로 참조해야 합니다.
번호만 저장했다면, 위키 항목이 어느 시리즈의 7050번을 가리키는지 영원히 알 수 없었을 겁니다. 근거 추적이 존재 이유인 시스템에서 근거가 모호해지는 최악의 경우였습니다. 이 형식 덕분에 3-2의 트리거도 split_part(s, '#', 1)로 계통 판정을 할 수 있게 됐습니다.
3-4. 위키 항목 예시 — 희기동소
json
{
  "lineage": "parkcheonghwa",
  "term": "희기동소(喜忌同所)",
  "aliases": ["희기동소", "희귀동소", "喜忌同所"],
  "definition": "희신과 기신이 한 자리에 공존하는 상황. 처방형 단정이 아니라 비교·재정립 맥락에서 해석한다.",
  "source_slides": ["박청화_신사주학#§3.4", "박청화_춘하추동_夏#4071"],
  "related_terms": ["격청격탁", "용신 재정립"],
  "edition": null,
  "status": "verified"
}
이 항목이 중요한 이유는, 4관법 금기어 규정의 예외 통로이기 때문입니다.
헤르메스는 격국 · 용신 · 기신 · 희신 네 단어를 처방형 단정으로 쓰는 것을 차단합니다("용신은 OO이다" 형태). 그런데 희기동소 · 격청격탁 · 재정립 맥락의 비교 서술은 허용해야 합니다. 무조건 차단하던 초기 가드레일이 정당하게 인용된 원문까지 검열하는 사고가 실제로 있었습니다.
N4 가드레일이 이 구분을 하려면 어딘가에 기준이 명문화돼 있어야 합니다. 지금까지는 프롬프트 안에 문장으로 들어 있었습니다. 이제 위키 항목으로 옮겼습니다.
💡 프롬프트에 있던 규율을 데이터로 옮긴 것입니다. 프롬프트는 이번 한 번의 부탁이고, 테이블은 계속 지켜지는 약속입니다.
3-5. aliases가 필요했던 이유 — 音借 오류와 판본 병존
첫째, STT 음차오류. 전사본에는 희기(喜忌)가 희귀로 잘못 적힌 곳이 여럿 있습니다. 에러사례집에도 별도 항목으로 정리해둔 사안입니다. ILIKE '%희기%'로 검색하면 이 슬라이드들이 통째로 누락됩니다.
그렇다고 원문을 함부로 고칠 수도 없습니다. 희귀동소는 오타지만 희귀(稀貴)가 제대로 쓰인 자리도 있어서, 일괄 치환은 원문 훼손입니다.
💡 원문은 그대로 두고, 위키 항목에 표기 변형을 등록했습니다. 검색은 aliases까지 훑고, 원본 슬라이드는 손대지 않습니다.
둘째, 판본 병존. 춘하추동은 2004년판(95강·449섹션)과 2010년판(340섹션)이 나란히 등재돼 있습니다. 같은 강사, 같은 시리즈명, 다른 연도 강의입니다. 같은 용어를 설명하는 방식이 6년 사이에 달라진 경우가 있어, 두 판본을 하나의 위키 항목으로 합치면 어느 시점의 설명인지 사라집니다.
그래서 PK에 edition을 넣었습니다. 계통 분리와 같은 논리의 연장입니다 — 출처가 다르면 항목도 다릅니다.
3-6. status — 무물 108강이 가르쳐준 것
"무엇이든물어보세요" 108강은 제목·메타만 채운 빈 스텁(content 전부 빈 값) 으로 등재돼 있습니다. 레코드 수는 +108이지만 지식은 0입니다.
이런 항목이 위키에 그대로 올라오면, 위키는 "항목은 있는데 내용이 없는" 상태를 정상으로 보고하게 됩니다. 그래서 AKM 판정 어휘를 그대로 빌려 세 단계 상태를 뒀습니다.
status
의미
검색 노출
verified
근거 슬라이드를 사람이 직접 대조 확인
✅ 노출
doc_only
문서상 존재하나 원문 대조 미완
❌ 차단
not_checked
미검증 (기본값)
❌ 차단
기본값을 not_checked로 둔 것이 핵심입니다. 새로 넣은 항목은 아무것도 하지 않으면 검색에 나오지 않습니다. fail-closed를 위키에도 적용한 것입니다.
3-7. N3 검색 연동
sql
-- 질의어의 위키 항목 + 연관 항목까지 근거로 회수 (계통 고정)
WITH hit AS (
  SELECT term, definition, source_slides, related_terms
  FROM hermes_wiki
  WHERE lineage = :lineage                    -- 계통 혼용 금지 유지
    AND status  = 'verified'                  -- 미검증 항목 제외 (fail-closed)
    AND (term = :q OR :q = ANY(aliases))      -- 정확 일치 + 표기 변형
),
linked AS (
  SELECT w.term, w.definition, w.source_slides, w.related_terms
  FROM hermes_wiki w
  JOIN hit h ON w.term = ANY(h.related_terms)
  WHERE w.lineage = :lineage                  -- 연관 항목도 계통 경계 안에서만
    AND w.status  = 'verified'
)
SELECT *, true  AS is_primary FROM hit
UNION ALL
SELECT *, false AS is_primary FROM linked;
초안의 term ILIKE '%'||:q||'%'를 정확 일치 + aliases로 바꿨습니다. 부분 일치는 인덱스를 타지 못하는 데다, "관"으로 검색하면 관성·관법·관제·편관이 전부 걸려 나옵니다.
💡 넓게 긁는 검색은 회수율은 올라가지만 근거의 정확성은 떨어집니다. 근거를 붙여 파는 시스템에서는 후자가 더 중요합니다.
linked 절에 w.lineage = :lineage를 다시 건 것도 의도적입니다. 연관 항목을 따라가다 계통 경계를 넘는 것이, 오염이 가장 자연스럽게 일어나는 경로입니다.
3-8. N7 리뷰(11편)와의 연결 — 판단이 하던 일을 규율로 내리기
위키가 생기면서 11편의 "계통순수" 채점이 실제로 가능해졌습니다.
기존에는 리뷰어 LLM이 "이 문장이 두 계통을 섞었는가"를 문맥으로 판정했습니다. 이제는 통변에 인용된 슬라이드의 계통을 위키에서 조회해 대조할 수 있습니다.
draft의 인용 → source 추출 → lineage_of() → 문장 단위 계통 집합 확인
  집합 크기 ≥ 2  →  계통순수 0점 (하드게이트 → 즉시 보류)
💡 판단(LLM 채점)이 하던 일 중 기계가 확정할 수 있는 부분을 규율(스키마 조회)로 내렸습니다. LLM에게 맡길 필요가 없던 일을 맡기고 있었던 셈입니다.
3-9. 구축 우선순위
전체 9,700건을 한 번에 위키화하는 것은 불가능합니다. 계통별로 핵심 용어부터 잡았습니다.
순서
범위
근거
1
4관법 4대 축 용어 (음양·간지자의·육신·신살)
이론 골격이자 다른 계통의 참조 기준
2
금기어 예외 통로 (희기동소·격청격탁·재정립)
N4 가드레일 오작동이 실제로 발생한 지점
3
박청화 시리즈 반복 등장 용어
나선형 구조상 여러 시리즈에 흩어져 있음
4
상리철학 원리 용어 (평기·태과·불급·구족성 등)
계통 혼동 위험이 가장 큰 영역
5
무물 108강
content UPDATE 이후 편입
(이미지 자리 ① — 위키 항목 상세 화면: 정의 · 근거 slides · 연관 링크)
(이미지 자리 ② — 연관 항목 그래프, 계통별 색 구분)
(이미지 자리 ③ — 계통 혼용 트리거 발동 로그: INSERT 거부 메시지)
결과와 배운 점
⚠️ 먼저 구분합니다. 아래는 스키마 설계와 소수 항목(계통별 5~10개) 시범 구축에서 얻은 것입니다. 전체 용어 위키화는 착수 단계이고, 검색 유사도 개선 수치는 아직 없습니다. 0.5395가 얼마나 움직였는지는 항목이 쌓인 뒤에 측정합니다. 지금 개선을 주장하면 그건 측정이 아니라 기대입니다.
꿀팁
① "적재"와 "지식관리"는 다른 일입니다. 슬라이드를 쌓으면 자료가 늘고, 용어를 정의하고 링크로 이으면 검색이 좋아집니다. 9,700건을 쌓는 동안 유사도가 0.5395에서 안 올랐던 이유가 여기 있었습니다. 건수는 지식관리의 지표가 아니었습니다.
② 제약 조건의 이름을 믿지 말고 동작을 확인하십시오. no_cross_lineage라는 이름을 붙여놓고 계통 분리가 끝났다고 생각했는데, 실제로는 아무것도 막지 않고 있었습니다. 이름이 하는 일과 코드가 하는 일이 다를 때가 가장 위험합니다.
③ 참조 키는 반드시 전역 유일하게 잡으십시오. slide 번호만으로 근거를 가리키려다, 시리즈 간 번호 대역이 겹칠 수 있다는 걸 뒤늦게 알았습니다. source#slide 복합 형식으로 바꾸고 나서야 트리거 검증도 가능해졌습니다.
④ 원문을 고치지 말고 항목에 변형을 등록하십시오. STT 음차오류(희기→희귀)를 일괄 치환하면 정상 표기까지 망가집니다. aliases 배열 하나로 원문 보존과 검색 회수를 동시에 얻었습니다.
⑤ 위키 항목에도 "미검증" 상태를 두십시오. 위키가 1차 지식원이 되면 위키의 오류가 전 통변으로 퍼집니다. 검증 전 항목은 검색에서 빼는 편이, 항목 수가 적어 보이더라도 안전합니다. 기본값을 not_checked로 두는 것만으로 fail-closed가 됩니다.
⑥ source_slides를 배열로 두면 근거가 통째로 딸려옵니다. 항목 하나를 맞히면 근거 3~5건이 함께 회수됩니다. 반쪽 근거로 통변을 쓰다 N6에서 보류되던 패턴이 줄어들 것으로 기대하고 있습니다(측정 전).
시행착오
① 계통 없이 위키부터 만들려 했습니다. "희기동소" 하나에 박청화 근거와 4관법 근거를 함께 담으려다, 이게 바로 프로젝트가 가장 경계하는 계통 혼용이라는 걸 뒤늦게 알아챘습니다. → PK와 트리거로 규율을 스키마에 박았습니다.
② 검색을 넓게 잡았다가 좁혔습니다. ILIKE '%q%'로 시작했는데 "관" 한 글자에 관성·관법·편관이 전부 걸렸습니다. 회수율을 위해 정확성을 버리는 거래였고, 근거 시스템에서는 잘못된 거래였습니다.
③ 문서의 수치를 그대로 믿을 뻔했습니다. 누적 건수가 문서마다 2,387 / 2,700 / 9,733으로 달랐습니다. 어느 하나를 골라 위키 설계 근거로 삼았다면, 그 위에 세운 판단 전체가 흔들렸을 겁니다. → 서버 SELECT COUNT(*)만 사실로 취급하고 나머지는 NOT_VERIFIED 표기.
④ 예시 항목의 출처부터 흔들렸습니다. 희기동소의 전거를 초안에 박청화_춘하추동:§3.4로 적었는데, 확인해보니 『신사주학』 §3.4 쪽이 맞는 것으로 보입니다. 위키의 존재 이유가 출처 정확성인데 첫 예시부터 출처가 흔들리면 곤란합니다. 서버 대조 후 확정할 항목으로 남겨뒀습니다.
도움이 필요한 부분
슬라이드 → 용어 정의 자동 추출 파이프라인. 9,700건을 사람이 다 읽을 수는 없는데, LLM에게 정의를 맡기면 그 정의의 근거는 누가 검증하는가의 문제가 그대로 돌아옵니다.
질의어와 문서 어휘의 어휘 격차. 사용자는 "결혼해도 될까요"라고 묻고, 문서에는 "재성공망·임묘"라고 적혀 있습니다. 위키의
aliases로 일부는 잡히지만, 이건 표기 변형이 아니라 추상화 층위의 차이라 다른 해법이 필요해 보입니다.기존 9,700건에 대한 소급 태깅. 전량 재적재 없이 메타데이터를 덧붙이는 현실적인 방법.
무물 108강처럼 "레코드는 있고 지식은 없는" 항목의 관리 관행. 지우자니 대역이 아깝고, 두자니 통계를 오염시킵니다.
5. 앞으로의 계획
시점
계획
단기
계통별 핵심 용어 위키 우선 구축(3-9 순서) · 희기동소 전거 서버 확정 · slide 대역 중복 실측 확인
중기
위키를 N2 라우팅 · N3 검색의 1차 지식원으로 승격 · 항목 100건 축적 후 유사도 재측정(0.5395 대비)
중기
N7 계통순수 축을 LLM 채점 → 위키 조회 하드게이트로 전환
장기
위키를 UNESCO 등재 서류의 용어집(glossary) 으로 재활용 — 등재 심사에 필요한 것이 정확히 "정의 + 출처 + 관계"이므로 형식이 그대로 맞습니다
장기
LangGraph Phase 10 스트리밍 파이프라인(Rails SSE)에 위키 조회 노드 통합
도움 받은 글 (옵션)
23기 청강2 — DECK님, LLM Wiki 지식관리 AI 에이전트 (Row / Wiki / Schema 3요소 구조)
카파시(Karpathy)의 LLM 지식 3층 구조 — 본 프로젝트에서는 Row=
gwanbeop_ppt, Wiki=Dify RAG 섹션, Schema=GuardrailAgent로 대응시켰습니다내부 문서:
RAG 분리운영 가이드 v1.0·Claude 반성문 총괄표 v3.7(문서≠사실 원칙) ·박청화 옴니버스 완성도 소감 v3.0(청크 전략)
