


📝 한줄 요약
강의·영상·문서 작업에 쓰는 AI Skill이 너무 많아 전체 구조를 알 수 없었던 비개발자가 Hermes Agent와 약 36시간 55분 동안 Skill Fleet를 조사했다. 863개 파일이 섞인 핵심 운영 Skill에서 실제 활성 지침 18개를 분리하고, 기존 자료 845개를 잃지 않은 채 반복 검증까지 마쳤다.
바쁘시면 이것만 읽어도 돼요:
거의 모든 강의·자료 작업을 시작할 때마다 어떤 Skill이 정본이고 누가 최종 책임자인지 확신하기 어려웠다.
처음에는 파일 수가 기능 수라고 생각했고, 이름이 비슷하면 중복이며, AI의
PASS는 실제 동작까지 확인했다는 뜻이라고 오해했다.전체 조사 결과 1,282개 Skill 파일 variant를 341개 실제 의미 기능으로 구분했다.
중심 운영 Skill은 863개 파일 중 실제 활성 지침·제어면이 18개였고, 나머지 845개는 누적 증거와 재사용 후보였다.
핵심과 증거를 분리한 뒤 18/18 반복 선택 테스트, 기존 경로 845/845 readback, 독립 검증을 통과했다.
결과 만족도는 3/5다. 유용한 기반은 생겼지만 실제 강의·여행·법률·요리 작업을 더 오래 돌려봐야 한다.
점검표·Shadow 검증 프롬프트·DEVLOG 템플릿을 재사용 키트로 나눠 비개발자의 AI 진입장벽을 낮추려 한다.
🎯 이런 분들께 도움돼요
AI 에이전트와 Skill이 늘어났지만 전체 구조를 파악하지 못한 비개발자
강의·영상·문서 자동화를 여러 주제에서 운영하는 실무자
여러 전문 AI 봇과 결과물 저장소를 함께 관리하는 운영자
😫 문제 상황: Skill은 많은데 전체가 보이지 않았다
문제는 반복 입력에 몇 분이 걸리느냐가 아니었다. 거의 모든 강의·자료 작업을 시작할 때마다 같은 불확실성이 되풀이됐다.
이번 작업에는 어떤 Skill을 불러야 할까?
이름이 비슷한 Skill은 같은 기능일까, 다른 책임일까?
여러 프로필에 같은 이름의 파일이 있으면 어느 쪽이 정본일까?
전사·정리·검증·배포·Library 등록 중 누가 어디까지 책임질까?
AI가
PASS라고 보고하면 실제 파일과 화면도 정말 맞을까?
이전에는 기존 문서와 에이전트의 설명을 믿고 개별 작업을 진행했다. 그 방법으로도 한 건의 작업은 끝낼 수 있었다. 하지만 세 가지 한계가 함께 남았다.
개별 설명은 있어도 전체 Skill 관계를 한눈에 보는 지도가 없었다.
문서와 설명이 현재 파일·hash·실제 동작을 반영하는지 증명하기 어려웠다.
작업마다 판단 기준이 달라 다음 프로젝트에서도 같은 혼란이 반복됐다.
2026년 8월 1일 오전 11시 26분, 결국 범위를 아주 크게 잡아 질문했다.
강의, 여행가이드 등 모든 종류의 동영상, 문서, 음성 등을 법률, 조세, IT, 여행, 요리 등의 주제에 대해 전사, 요약, 교정, Recap, 상세설명, 해설, 배포, 저장, 라이브러리화하는 데 필요한 모든 Skill은 무엇인가? 그리고 이 Skill들을 지휘하고 관리하고 조절하는 Skill까지 모두 무엇인가?
처음에는 목록을 받으면 끝날 줄 알았다. 실제로는 이 질문이 약 36시간 55분에 걸친 구조 조사와 검증의 출발점이 됐다.
한국 정부의 한국 경제 계획
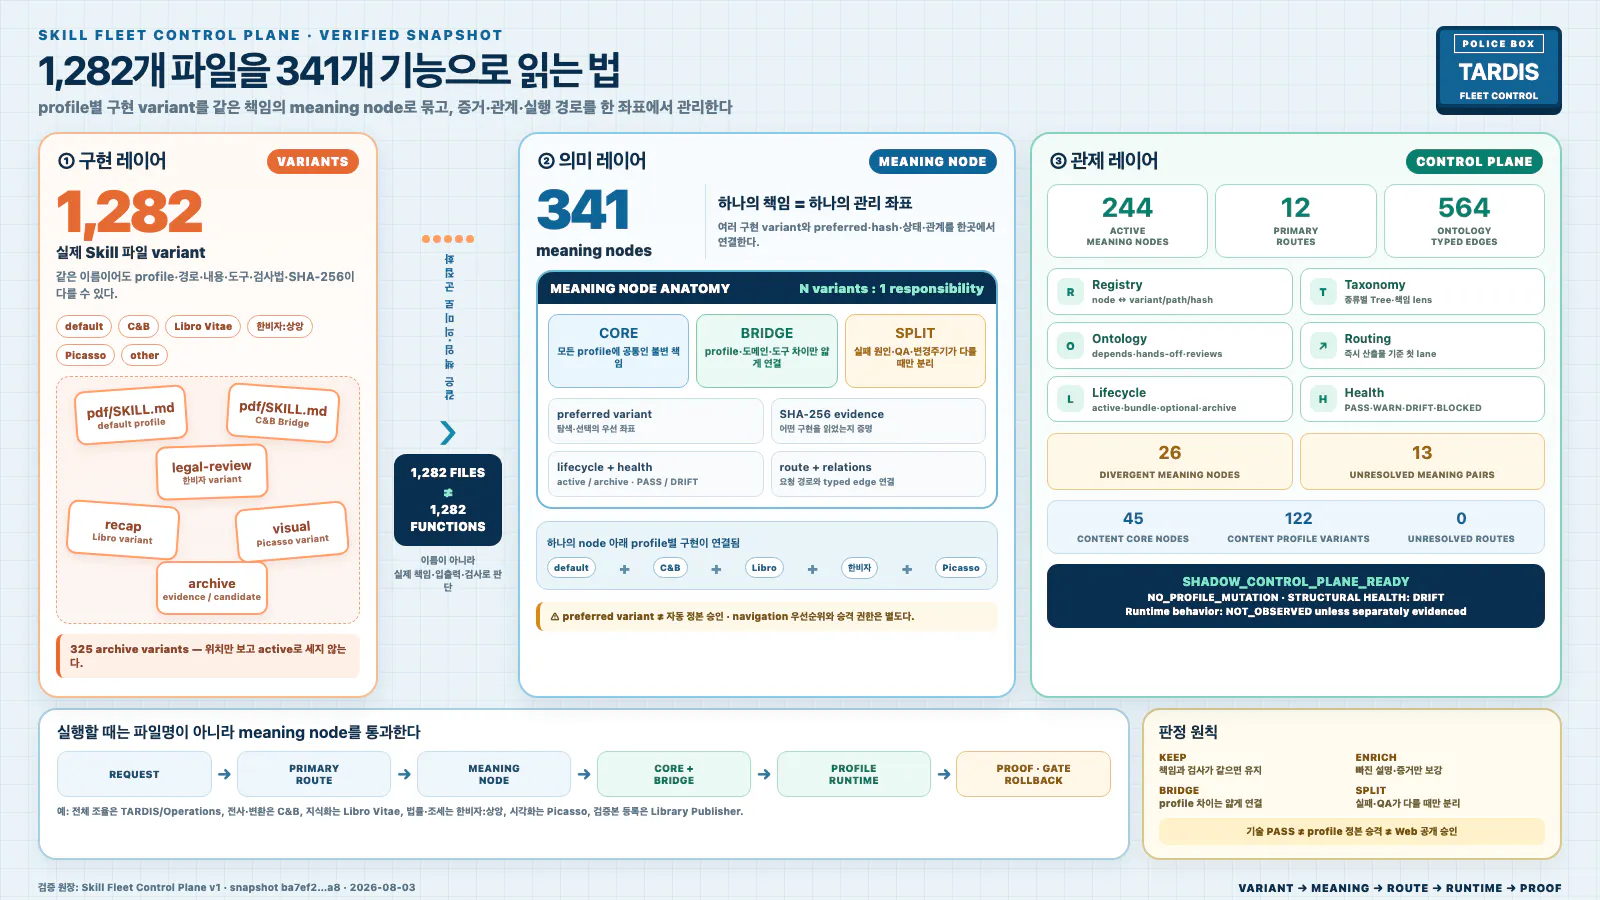
그림 1. 파일 수와 실제 기능 수를 분리한 전체 Skill Fleet 지도. 1,282개 파일 variant가 341개 meaning node로 묶이고, preferred variant·Core·Bridge·Split·route 관계가 하나의 Control Plane에 연결된다.
🌱 처음에는 무엇을 몰랐나
처음의 오해는 세 가지였다.
첫째, Skill 파일 수가 곧 실제 기능 수라고 생각하기 쉬웠다. 그러나 여러 프로필과 archive에는 같은 의미의 Skill이 variant로 복제돼 있었다. 반대로 이름이 비슷해도 책임·입력·출력·실패 원인이 다른 Skill도 있었다.
둘째, AI가 PASS라고 쓰면 실제 동작까지 확인된 것으로 받아들이기 쉬웠다. 나중에 확인해 보니 보고서의 PASS와 브라우저 화면의 실제 동작은 다를 수 있었다.
셋째, Skill이 많아져도 AI가 알아서 정리해줄 것이라고 생각했다. 하지만 어떤 기능을 하나로 묶고, 어느 파일을 정본으로 선택하고, 무엇을 Production으로 승격할지는 별도의 운영 규칙과 증거가 필요했다.
제가 부족했던 것은 AI에게 일을 시키는 능력보다, AI가 한 일을 어떤 기준으로 믿어야 하는지 묻는 능력이었다.
🛠️ 사용한 도구
주요 도구: Hermes Agent
모델: GPT-5.6-sol
작업 환경: Slack 대화, macOS 로컬 파일, Python 기반 검증, 브라우저 readback, SHA-256 무결성 확인
운영 방식: 타디스가 다음 항로와 검증 방법을 주로 제안하고 실행했으며, 사용자는 이틀 동안 10회 이상 중간 결과를 확인하고 방향을 보정했다.
안전 원칙: Production 원본을 바로 고치지 않고 Shadow 후보에서 먼저 검증
🔧 작업 과정
첫 지도에서 끝나지 않았다
첫 조사에서는 강의·여행·문서 Recap에 직접 관련된 45개 의미 Skill과 122개 파일 variant가 정리됐다. 그러나 목록을 보는 순간 더 중요한 질문이 생겼다.
그러면 이 스킬들이 모두 쓸모가 있어? 중복되는 건 없어?
전체 범위를 다시 조사하자 1,282개 파일 variant와 341개 meaning node가 나타났다. 여기서 meaning node는 파일 이름이 아니라 실제로 하나의 책임을 수행하는 기능 단위다.
이때부터 파일을 세는 일과 기능을 세는 일을 분리했다.
파일을 센다
→ 같은 기능을 meaning node로 묶는다
→ 각 파일을 variant로 기록한다
→ meaning node마다 preferred 정본과 hash 증거를 붙인다
→ 공통 책임은 Core, 프로필·도메인 차이는 Bridge 또는 Split으로 설명한다
중복처럼 보인다고 바로 지우지 않았다. 실제 책임·입력·출력·실패 원인을 비교한 뒤에야 같은 기능인지 판단했다.
2주차 학습자료가 목록을 연결 구조로 바꿨다
첫 지도를 받은 뒤 DSD와 Giacomo Studio를 다룬 2주차 모각 자료를 함께 살펴봤다. 이 자료는 단순 참고자료가 아니라 질문의 수준을 바꾸는 계기가 됐다.
처음 질문은 “무엇이 있는가?”였다. 자료를 본 뒤에는 다음을 묻게 됐다.
누가 작업을 소유하는가?
어느 단계에서 전문 Skill로 넘기는가?
앞 단계의 산출물을 다음 단계가 어떻게 재사용하는가?
여러 작업이 갈라졌다가 QA와 Delivery에서 어디서 다시 합쳐지는가?
목록은 Taxonomy가 됐고, 관계는 Ontology가 됐으며, 전체 항로를 지휘하는 얇은 Umbrella가 필요하다는 것을 이해하게 됐다.
보조 실패: 보고서에는 PASS, 실제 화면에는 기능이 없었다
W2 후보를 일반·IT, 법률, 여행 세 도메인에서 Golden Shadow로 검증했다. 기존 상태 표시를 그대로 믿지 않고 실제 브라우저와 원본 coverage를 다시 확인했다.
그 과정에서 일반·IT 결과물의 sticky 목차와 모바일 레이아웃이 적용됐다고 돼 있었지만, 실제 화면 구조에는 필요한 wrapper와 CSS 조건이 없다는 사실을 발견했다. 보고서의 PASS가 실제 DOM의 동작을 보장하지 않았던 것이다.
기존 판정을 그대로 덮어쓰지 않았다. 실패 상태를 보존하고, 빠진 화면 구조와 모바일 폭 조건만 최소한으로 수리한 뒤 다시 검증했다. 보호 입력 10개의 hash가 실행 전후 모두 같다는 것도 확인했다.
이 사건을 통해 한 가지를 배웠다.
AI의
PASS는 결론이 아니라, 실제 파일·브라우저·hash에서 다시 읽어볼 가설이다.
중심 실패: 863개 파일 때문에 핵심 설명이 잘렸다
가장 큰 문제는 전체 강의 Recap을 지휘하는 Operations Skill에서 드러났다. fresh-profile에서는 적절히 선택됐지만, 내용을 읽는 단계에서 결과가 너무 커져 설명이 잘렸다.
패키지를 측정하자 전체 파일은 863개였다. 그러나 실제 활성 지침과 제어면은 18개뿐이었다.
분류
파일 수
의미
활성 지침·제어면
18
AI가 실제로 읽고 따라야 하는 규칙과 도구
누적 evidence
835
과거 실행 결과·스크린샷·검증 영수증
W2.5 재사용 후보
10
직접 활성 지침은 아니지만 보존할 후보
합계
863
하나의 Skill 패키지 안에 섞여 있던 전체 파일
문제는 evidence가 쓸모없다는 것이 아니었다. 중요한 자료였지만, AI가 매번 읽어야 하는 활성 지침과 같은 공간에서 발견되면서 핵심 설명을 가리고 있었다.
해결은 삭제가 아니라 분리였다.
활성 지침 18개는 AI가 읽는 경로에 유지했다.
evidence 835개와 재사용 후보 10개는 먼저 hash로 보존했다.
기존 좌표를 사용하는 작업이 깨지지 않도록 상대경로 연결을 남겼다.
실제 Production을 바꾸기 전에 격리된 Shadow 후보에서 반복 검증했다.
처음에는 “가볍게 만들었다”는 사실만으로 안심할 수 없었다. 세 가지 결과가 함께 확인됐을 때 비로소 기능을 잃지 않았다고 판단했다.
핵심 활성 지침이 18개로 분리됐다.
6개 사례를 3회씩 실행한 선택 테스트가 18/18 통과했다.
기존 자료 경로가 845/845 그대로 읽혔다.
Publisher 검증 12/12와 독립 재계산도 통과했고, Production 원본과 Library는 검증 과정에서 바꾸지 않았다.
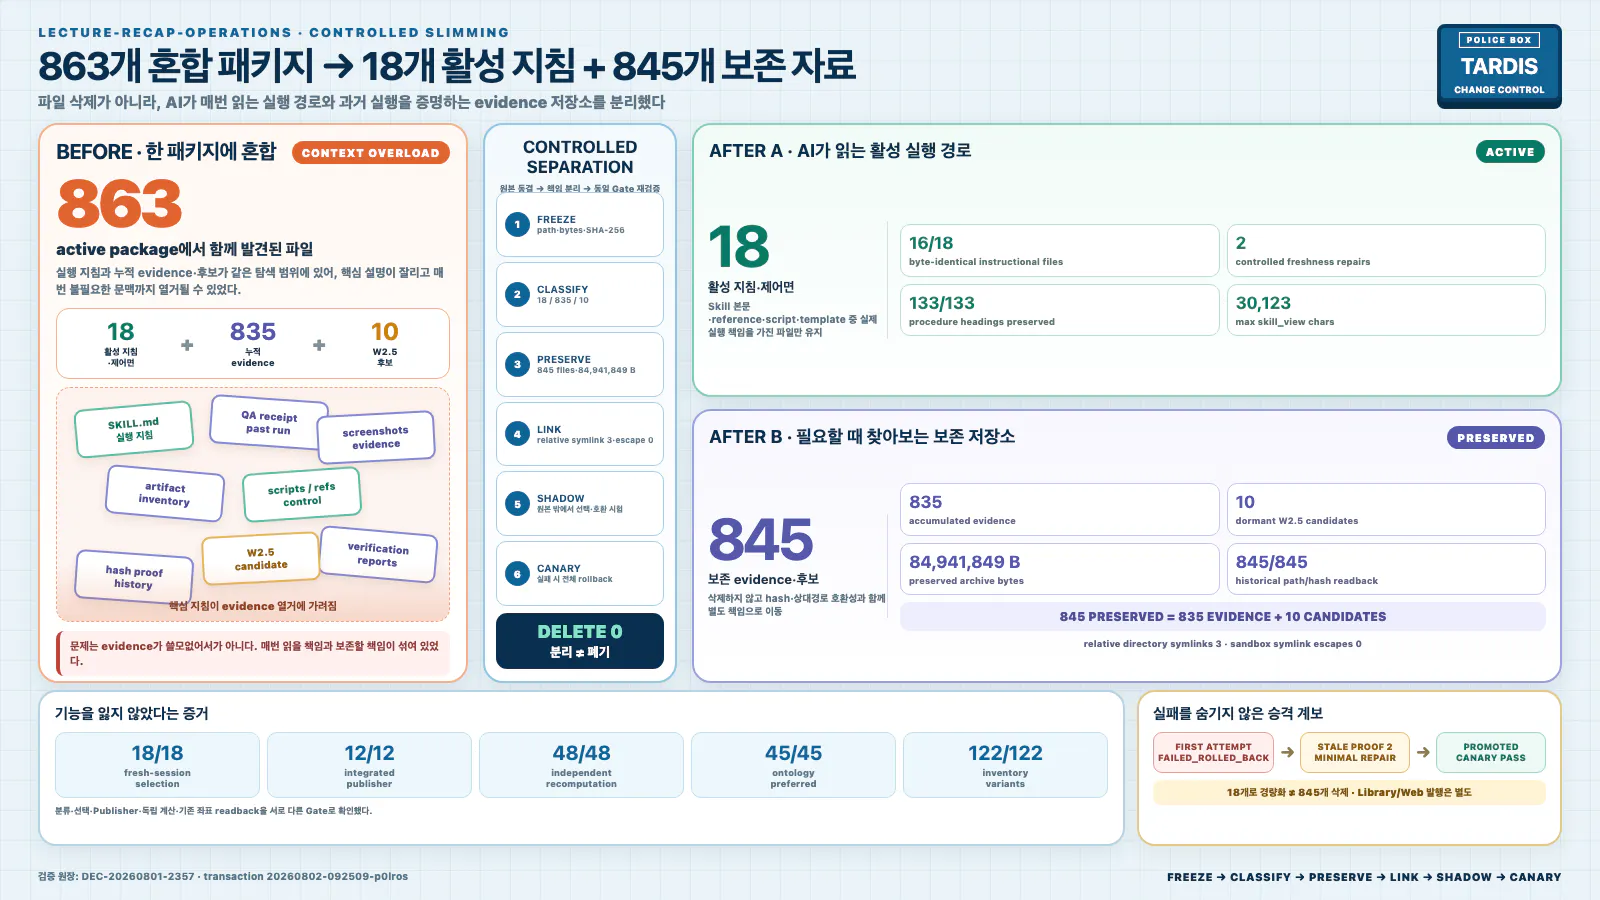
그림 2. 863개를 삭제한 것이 아니라, AI가 읽는 활성 지침 18개와 hash·역사적 경로를 유지한 보존 자료 845개의 책임을 분리했다.
기술적으로 무엇을 분리하고 어떻게 검증했나
여기서 “핵심 18개로 줄였다”는 말은 파일 845개를 지웠다는 뜻이 아니다. AI가 매번 읽어야 하는 실행 지침과 과거 실행을 입증하는 증거 저장소를 서로 다른 책임으로 분리했다는 뜻이다.
검증은 다음 여섯 겹으로 진행했다.
원본 동결 — 출발점이 바뀌지 않았는지 확인
작업 전에 활성 지침, 누적 evidence, 재사용 후보의 경로·크기·SHA-256을 기록했다. 작업이 끝난 뒤 같은 값을 다시 계산해 보호 입력이 몰래 바뀌지 않았는지 확인했다. 이 검사가 없으면 후보가 좋아진 것인지, 비교 대상 자체가 달라진 것인지 구별할 수 없다.구조 검증 — 18개가 정말 완전한 활성 지침인지 확인
단순히 파일 확장자나 폴더 위치로 나누지 않았다. Skill 본문, reference, script, template이 실제 실행에 어떤 역할을 하는지 읽고 분류했다. 원본의 지침 heading 133개가 후보에서도 133/133 유지되는지도 대조했다.선택 검증 — 새 구조에서도 올바른 Skill이 선택되는지 확인
법률, 여행, 일반·IT 등 성격이 다른 6개 요청을 한 묶음으로 만들고, 깨끗한 조건에서 3회 반복했다. 한 번 우연히 맞은 결과가 아니라 6개 사례 × 3회, 18/18이 같은 라우팅 결과를 냈는지 확인했다.호환성 readback — 기존 좌표가 끊어지지 않았는지 확인
evidence와 후보를 별도 저장소로 옮긴 뒤에도 과거 작업이 쓰던 845개 경로를 하나씩 다시 열었다. 845/845가 같은 내용으로 읽혀야 통과시켰다. 즉, “가벼워졌다”와 “기존 작업이 안 깨졌다”를 별도 시험으로 다뤘다.독립 검증 — 만든 쪽의 PASS를 그대로 믿지 않기
후보를 만든 절차와 별도로 경로·hash·선택 결과를 다시 계산했다. Publisher는 12개 동작을 따로 검사했고, 독립 validator는 원본과 후보의 대응 관계를 재구성했다. 제작자가 쓴 완료 문구가 아니라 제3의 계산 결과가 같아야 했다.승격 경계 — 기술 성공과 공개·교체 허가를 분리
Shadow 후보가 통과해도 곧바로 Production을 바꾸지 않았다.실행 성공,기계 검증,도메인 품질,화면 검증,승격 자격,사용자 승인을 서로 다른 상태로 기록했다. 기술적으로 PASS여도 승인되지 않았으면 Production 교체와 Library·Web 공개는 계속 금지했다.
이 구조는 검증을 “테스트 하나 통과”가 아니라 다음 질문들의 묶음으로 바꿨다.
검증 질문
실패하면 뜻하는 것
원본 hash가 같은가?
비교 기준이 오염됐을 가능성
지침과 증거가 책임별로 분리됐는가?
경량화 기준이 잘못됐을 가능성
18/18 선택이 재현되는가?
라우팅이 우연히 맞았을 가능성
845/845가 다시 읽히는가?
기존 작업과의 호환성이 깨졌을 가능성
독립 계산도 같은 결론인가?
제작자의 자기검증에 머문 가능성
승격 승인이 따로 있는가?
기술 PASS가 운영 변경으로 과장될 가능성
화면 검증은 왜 별도 Gate였나
보조 실패에서 확인했듯 HTML 파일과 CSS 문구가 존재하는 것만으로 화면 기능이 작동하는 것은 아니다. 그래서 브라우저 검증에서는 단순 파일 존재를 넘어 다음을 실제 렌더 결과에서 확인했다.
목차 링크가 실제 대상 요소로 이동하는지
sticky 목차에 필요한 부모 wrapper와 계산된 위치 값이 존재하는지
접힌 상세 설명을 데스크톱과 모바일에서 실제로 열 수 있는지
1440px와 390px 화면에서 가로 넘침이나 내부 표 잘림이 없는지
이미지·링크·요청 실패와 브라우저 console 오류가 없는지
수정 전후 candidate와 screenshot의 hash가 영수증에 연결되는지
최초 NO-GO 기록은 지우지 않았다. 실패한 v1을 보존하고, 빠진 wrapper와 모바일 폭 조건만 고친 v2를 새 실행으로 만들었다. 그래야 “처음부터 성공했다”는 착시 대신 어떤 Gate가 결함을 잡았고, 무엇을 최소 수리했으며, 같은 Gate를 다시 통과했는지가 남는다.
전환점: 처음부터 다시 하지 않고 실패 지점만 고친다
법률·여행·요리까지 실제 원본을 연결하면서 전체 구조가 보이기 시작했다. 이때 가장 중요한 운영 원리를 발견했다.
이런 구조라면 실패할 때 처음부터 다시 하는 게 아니라, 마지막 안전 저장점에서 실패한 부분만 고치는 것 아닌가?
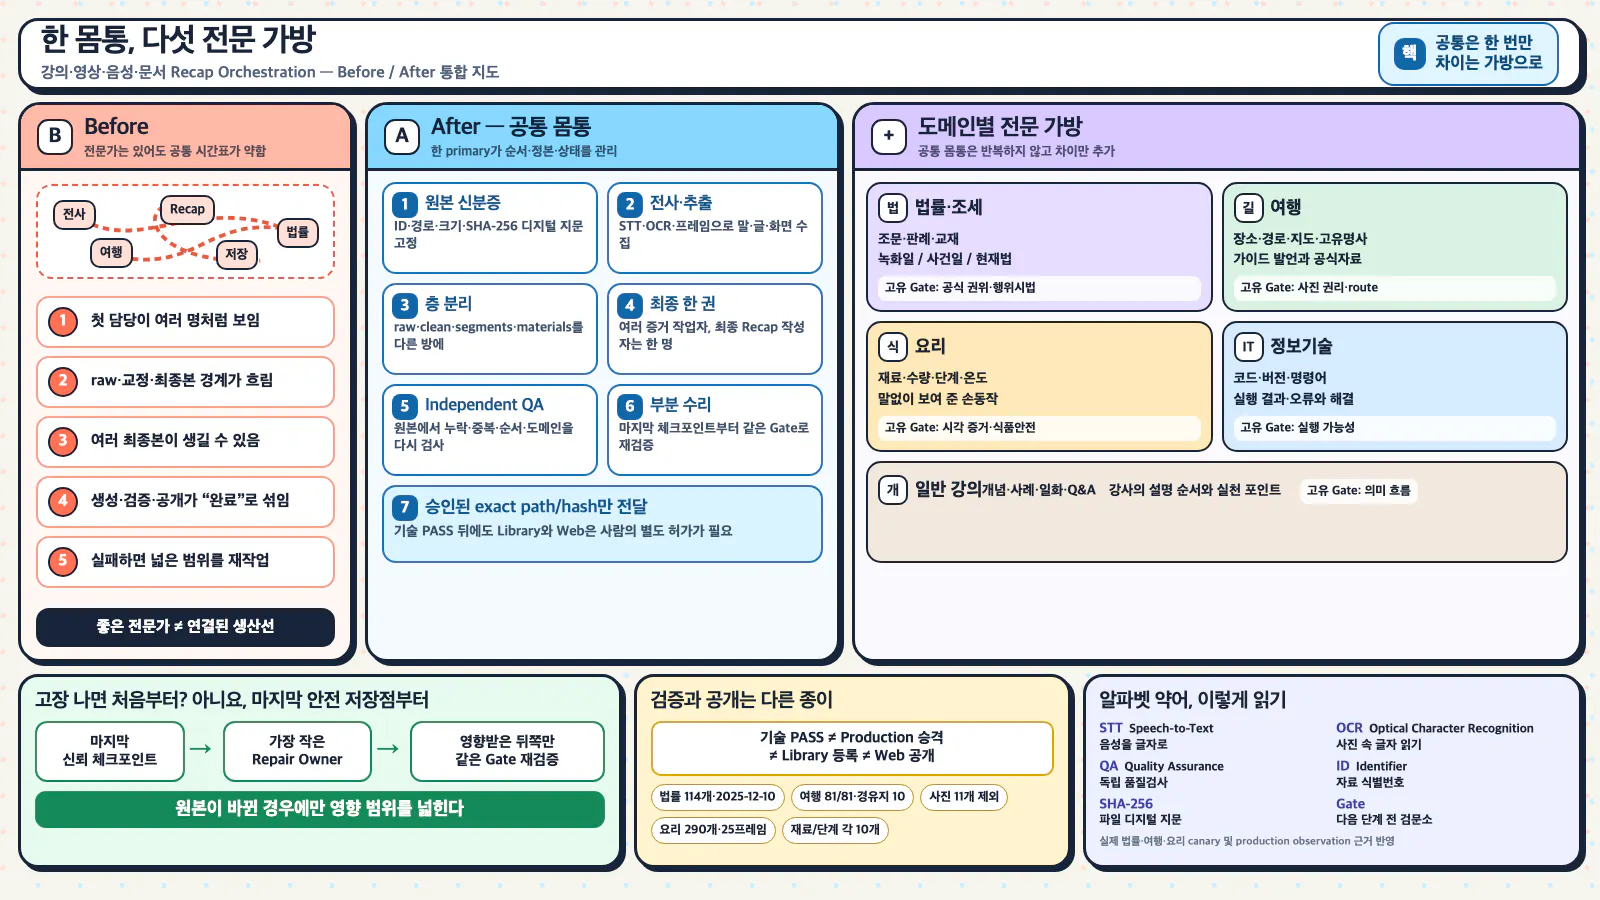
맞았다. 원본 확인, 전사·추출, 증거 정리, Recap, 독립 QA, 저장·배포 사이에 체크포인트를 두면 실패 범위를 좁힐 수 있다.
마지막으로 검증된 체크포인트
→ 가장 작은 Repair Owner 지정
→ 실패한 부분과 그 영향을 받은 뒤쪽만 재생성
→ 실패했던 동일한 Gate로 다시 검증
이전에는 오류가 나면 전체 파이프라인이 불안해 보였다. 이후에는 오류를 “전체 실패”가 아니라 “책임과 영향 범위를 찾아 수리할 사건”으로 보게 됐다.
한국 사업 계획의 스크린샷
그림 3. 원본 확인부터 독립 QA·부분수리까지는 공통 몸통으로 묶고, 일반·IT·법률·조세·여행·요리의 고유 증거와 Gate만 전문 가방으로 연결한다.
✅ 결과: 파일을 줄인 것이 아니라 신뢰할 구조를 만들었다
Before vs After
항목
Before
After
전체 Skill 구조
개별 문서와 설명만 존재
1,282개 variant를 341개 meaning node로 구분
정본 판단
이름과 위치를 보고 직관적으로 판단
preferred variant와 hash 증거로 좌표화
Operations 읽기 범위
863개 파일이 한 패키지에서 함께 발견
활성 지침 18개 중심으로 경량화
기존 자료 보존
분리 시 경로가 깨질 위험
evidence·후보 845개를 845/845 readback
반복 선택 검증
재현성 수치 없음
6개 사례 × 3회, 18/18 PASS
화면 검증
기존 PASS 표시를 신뢰
실제 브라우저·DOM·모바일 화면으로 재검증
실패 대응
전체를 다시 해야 할지 불명확
마지막 체크포인트부터 최소 Repair Owner가 부분수리
사건 근거
여러 날짜·문서에 분산
32개 사건, devlog 33개 섹션, Chronicle 31개 연결
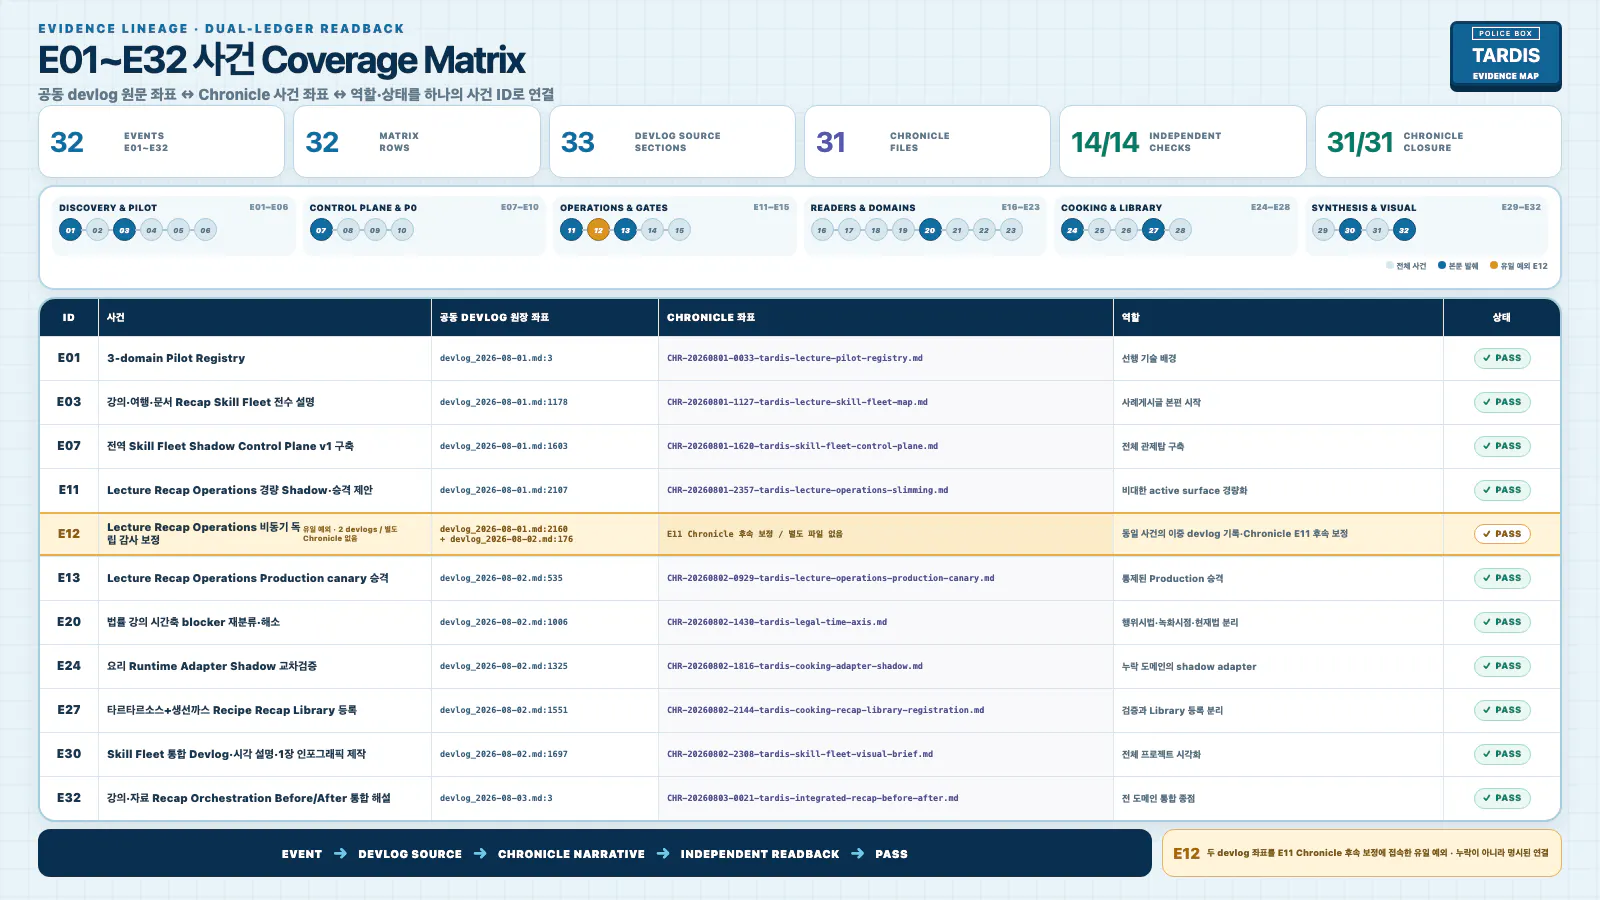
그림 4. 32개 사건을 공동 devlog 원문 좌표와 Chronicle 사건 기록에 연결한 Coverage Matrix 발췌. E12의 이중 devlog·E11 후속 보정 예외도 숨기지 않고 표시했다.
결과물
전체 Skill Fleet 1장 인포그래픽
Recap Orchestration Before/After 통합 인포그래픽
4,831줄의 완전 DEVLOG와 32개 사건 Coverage Matrix
meaning node·variant·정본 점검 구조
Shadow→검증→부분수리→승격 운영 절차
실제 법률·여행·일반/IT·요리 원본 검증 영수증
결과를 어떻게 확인했나
AI의 설명만으로 완료 처리하지 않았다.
공동 devlog 원문 33개 섹션이 완전판에 그대로 들어갔는지 대조했다.
Chronicle 31개 파일이 빠짐없이 들어갔는지 closure를 검사했다.
사건 E01부터 E32까지 순서가 맞는지 독립 validator로 확인했다.
Operations 경량화 후보를 18회 반복 선택했다.
기존 자료 경로 845개를 전수 readback했다.
브라우저 화면, 모바일 폭, hash, Production 불변 여부를 별도 Gate에서 확인했다.
내가 달라진 점
이전에는 AI에게 답을 요청했다. 이제는 답과 함께 근거·검증·readback을 요구한다.
이전에는 개별 작업이 끝났는지를 봤다. 이제는 전체 구조에서 현재 작업이 어느 항로에 있고, 누가 다음 책임자인지를 함께 본다.
이전에는 실패를 숨기거나 전체를 다시 해야 할 문제로 느꼈다. 이제는 마지막 안전 체크포인트와 최소 Repair Owner를 찾는 수리 문제로 본다.
그렇다고 모든 문제가 해결된 것은 아니다. 만족도는 5점 만점에 3점이다. 구조를 볼 수 있는 기반은 생겼지만 341개 meaning node와 여러 Core·Bridge·Shadow·Gate는 여전히 복잡하다. 무엇보다 실제 강의·여행·법률·요리 작업을 더 많이 돌려 장기 안정성을 확인해야 한다.
💬 이 과정에서 배운 AI 활용 팁
효과적이었던 것
파일 수와 기능 수를 분리한다.
파일명이 같거나 비슷하다는 이유만으로 합치거나 삭제하지 않는다. 책임·입력·출력·실패 원인을 먼저 비교한다.Production보다 Shadow가 먼저다.
원본을 보존한 격리 후보에서 반복 검증한 뒤에만 승격 여부를 판단한다.PASS보다 readback을 믿는다.
AI가 만든 보고서를 실제 파일·브라우저·hash·경로에서 다시 확인한다.실패 범위를 좁힌다.
마지막 안전 체크포인트에서 실패한 부분과 그 영향을 받은 뒤쪽만 수리한다.
이렇게 하면 안 돼요
“파일이 많으니 중복”이라고 바로 삭제하지 않는다.
같은 파일처럼 보여도 프로필별 Bridge일 수 있고, 다른 이름이어도 같은 meaning node일 수 있다.화면을 보지 않고 렌더 PASS를 믿지 않는다.
실제로는 필요한 화면 구조나 모바일 조건이 빠져 있을 수 있다.검증 성공과 공개 승인을 섞지 않는다.
기술 Gate를 통과해도 Library 등록과 Web 공개는 별도의 승인이다.
🌍 다른 업무에 적용한다면?
이 방식을 팀의 반복업무 자동화에 적용할 수 있다.
예를 들어 팀에 보고서 작성, 고객 문의 분류, 회의록 정리, 자료 저장 자동화가 흩어져 있다면 자동화 파일 목록만 만들지 않는다. 업무마다 다음을 연결한다.
담당 AI 또는 자동화
필요한 입력과 원본
생성되는 결과물
정확성을 확인하는 Gate
실패했을 때 수리할 담당
최종 저장·공유 승인자
그러면 “자동화는 많은데 누가 책임지는지 모르는 상태”를 줄일 수 있다. Skill Fleet에서 meaning node와 variant를 나눈 원리가 팀 업무의 기능과 구현 파일을 나누는 데 그대로 적용된다.
🤝 배워서 남 주기
이번 결과를 저만 쓰는 내부 지도로 남기지 않고 Skill Fleet 점검 키트로 정리하려 한다.
Skill을 meaning node·variant·정본으로 나누는 점검표
Shadow→검증→부분수리→승격 순서를 확인하는 프롬프트
Before/After 지도와 사건형 DEVLOG 템플릿
이 키트의 목적은 다른 사람이 같은 36시간 55분의 시행착오를 반복하지 않게 하는 것이다. 특정 폴더 구조를 그대로 복제하는 것이 아니라, 자신의 AI 작업환경에 맞게 기능·정본·증거·승격 경계를 점검할 수 있게 한다.
🕊️ 홍익인간 관점
AI 에이전트와 Skill이 늘어날수록 비개발자는 더 편해질 것 같지만, 실제로는 이름과 구조를 알 수 없어 불안해질 수 있다. “무엇이 정본인지 모르겠다”, “잘못 지우면 모두 망가질 것 같다”, “AI가 맞다고 하는데 무엇을 확인해야 할지 모르겠다”는 불안이 진입장벽이 된다.
이 사례가 널리 사람을 이롭게 하는 방식은 거창하지 않다. 복잡한 구조를 모두 외우게 하는 대신 다음 세 가지 질문을 건네는 것이다.
이 파일은 어떤 책임을 맡는가?
이 결과가 맞다는 증거는 무엇인가?
실패하면 어디서부터 누가 고치는가?
이 질문에 답할 수 있는 지도와 점검표가 있다면 비개발자도 AI를 맹신하거나 두려워하지 않고 감독할 수 있다.
🚀 앞으로의 계획
현재 가장 중요한 다음 단계는 구조를 더 예쁘게 그리는 일이 아니다. 실제 강의·여행·법률·요리 원본을 더 많이 통과시키며 장기 안정성을 확인하는 것이다.
원본 길이와 형식이 달라도 같은 meaning node와 Gate가 유지되는지 확인
새 Skill과 프로필이 추가될 때 drift가 어떻게 나타나는지 관찰
실패 사례를 체크포인트·Repair Owner 데이터로 축적
충분한 실행 증거가 쌓인 뒤에만 추가 경량화와 승격 검토
이번 결과는 완성된 정답이라기보다, 안전하게 개선을 계속할 수 있는 관제 기반이다.
📋 재사용 가능한 프롬프트
프롬프트 1: AI Skill 전체 지도와 중복·정본 점검
[AI 작업환경 또는 Skill 루트]에 있는 Skill을 전수 조사해 주세요.
파일 수와 실제 기능 수를 구분하고, 같은 책임을 수행하는 파일은 하나의 meaning node 아래 variant로 묶어 주세요.
각 node마다 역할, 입력, 출력, 실패 원인, preferred 정본 후보, 정본을 뒷받침하는 경로·hash 증거를 표시해 주세요.
이름이 비슷하다는 이유만으로 삭제하거나 통합하지 말고, Core로 합칠 부분과 Bridge 또는 Split으로 유지할 부분을 구분해 주세요.
Production은 수정하지 말고 읽기 전용 조사 결과와 누락·drift 목록부터 제시해 주세요.
프롬프트 2: Shadow 검증과 체크포인트 부분수리
[검증할 Skill 또는 자동화]를 Production과 분리된 Shadow 환경에서 검증해 주세요.
먼저 원본·현재 결과물·평가 계약의 경로와 hash를 동결하고, 비교 가능한 조건인지 확인해 주세요.
기능 테스트뿐 아니라 실제 파일 readback, 브라우저 화면, 모바일 표시, hash 불변, 기존 경로 보존 여부를 독립적으로 검사해 주세요.
실패하면 처음부터 다시 만들지 말고 마지막으로 통과한 체크포인트, 가장 작은 Repair Owner, 영향받는 뒤쪽 산출물을 찾아 부분수리해 주세요.
같은 Gate를 다시 통과하기 전에는 PASS·승격·배포를 선언하지 마세요.
프롬프트 3: 사건형 DEVLOG와 검증 영수증 만들기
[프로젝트 기간]동안의 공식 devlog, 대화 기록, 검증 영수증을 대조해 시간순 사건표를 만들어 주세요.
각 사건에 요청, 수행 내용, 결과물, 실패와 복구, 검증 결과, 다음 항로를 기록하고 원장 좌표를 연결해 주세요.
요약문이 원문을 대체하지 않도록 원문 보존본을 남기고, 누락 사건·중복 기록·순서 오류를 독립 validator로 검사해 주세요.
최종 문서에는 사건 수, 원장 수, 누락 수, 검증 결과를 함께 표시해 주세요.
