


소개
시도한 것
명리학 AI 에이전트 헤르메스(Hermes)의 통합 로드맵 v1.0을 완성했다. 흩어져 있던 10개 문서를 흡수한 누적통합본이었고, 6노드 아키텍처·스킬 3계층·12편 사례글 매핑·지표 체계까지 13개 절로 정리됐다. 표도 깔끔했고 코드 블록도 들어갔다.
그래서 Claude에게 시켰다.
"첨부자료에서 스스로 검증하여 더 심화 및 보완해야 할 부분을 알려 줘."
칭찬을 기대한 건 아니었지만, 이 정도 나올 줄은 몰랐다.
왜 이걸 했나
헤르메스는 "스스로 근거(slide 번호)를 대지 못하면 답하지 않는" 명리학 에이전트다. 탈XX 4관법과 박청화 강의 RAG 위에 얹는 LangGraph 사이드카 계층이고, 남은 여생을 걸고 하는 프로젝트다.
핵심 규율이 하나 있다. 금기어 차단이다. 4관법 계통에서는 격국·용신·기신·희신 4개 용어를 절대 쓰지 않는다. 그래서 GuardrailAgent를 만들었고, 로드맵에 코드까지 박아놨다.
문제는 로드맵이 문서로 예뻤다는 것이다. 표가 정연하면 검증했다고 착각한다. 나는 이 착각을 34건의 "Claude 반성문"으로 이미 알고 있었다. 그중 원칙 1번이 이것이다.
모르면 아는 척 금지. 3회 실패 시 멈추기.
이 원칙을 내가 AI에게 요구하면서, 정작 내 문서에는 적용한 적이 없었다.
어도비 어도비 어도비 어도비 a의 한국어 버전
진행 방법
3-1. 사용 도구
도구
역할
Claude Opus 4.5
문서 자체 검증 + 코드 결함 진단
PostgreSQL 18.1
실측 진단 쿼리 (DigitalOcean 서버)
LangGraph
6노드 사이드카 파이프라인
Dify RAG
hybrid_search, 활성 문서 ~84건
3-2. 프롬프트 전문 (단 두 줄이다)
1차 — 검증 요청
첨부자료에서 스스로 검증하여 더 심화 및 보완해야 할 부분을 알려 줘.2차 — 실행 요청
우선순위 제안
P0-a: 가드레일 코드 결함 3건 수정 + 골든셋 구축
→ P0-b: slide 대역 실측 확정
→ P0-c: N6 임계값·audit DDL 확정
을 차례대로 실행해 줘.
프롬프트는 이게 전부다. 길게 안 썼다.
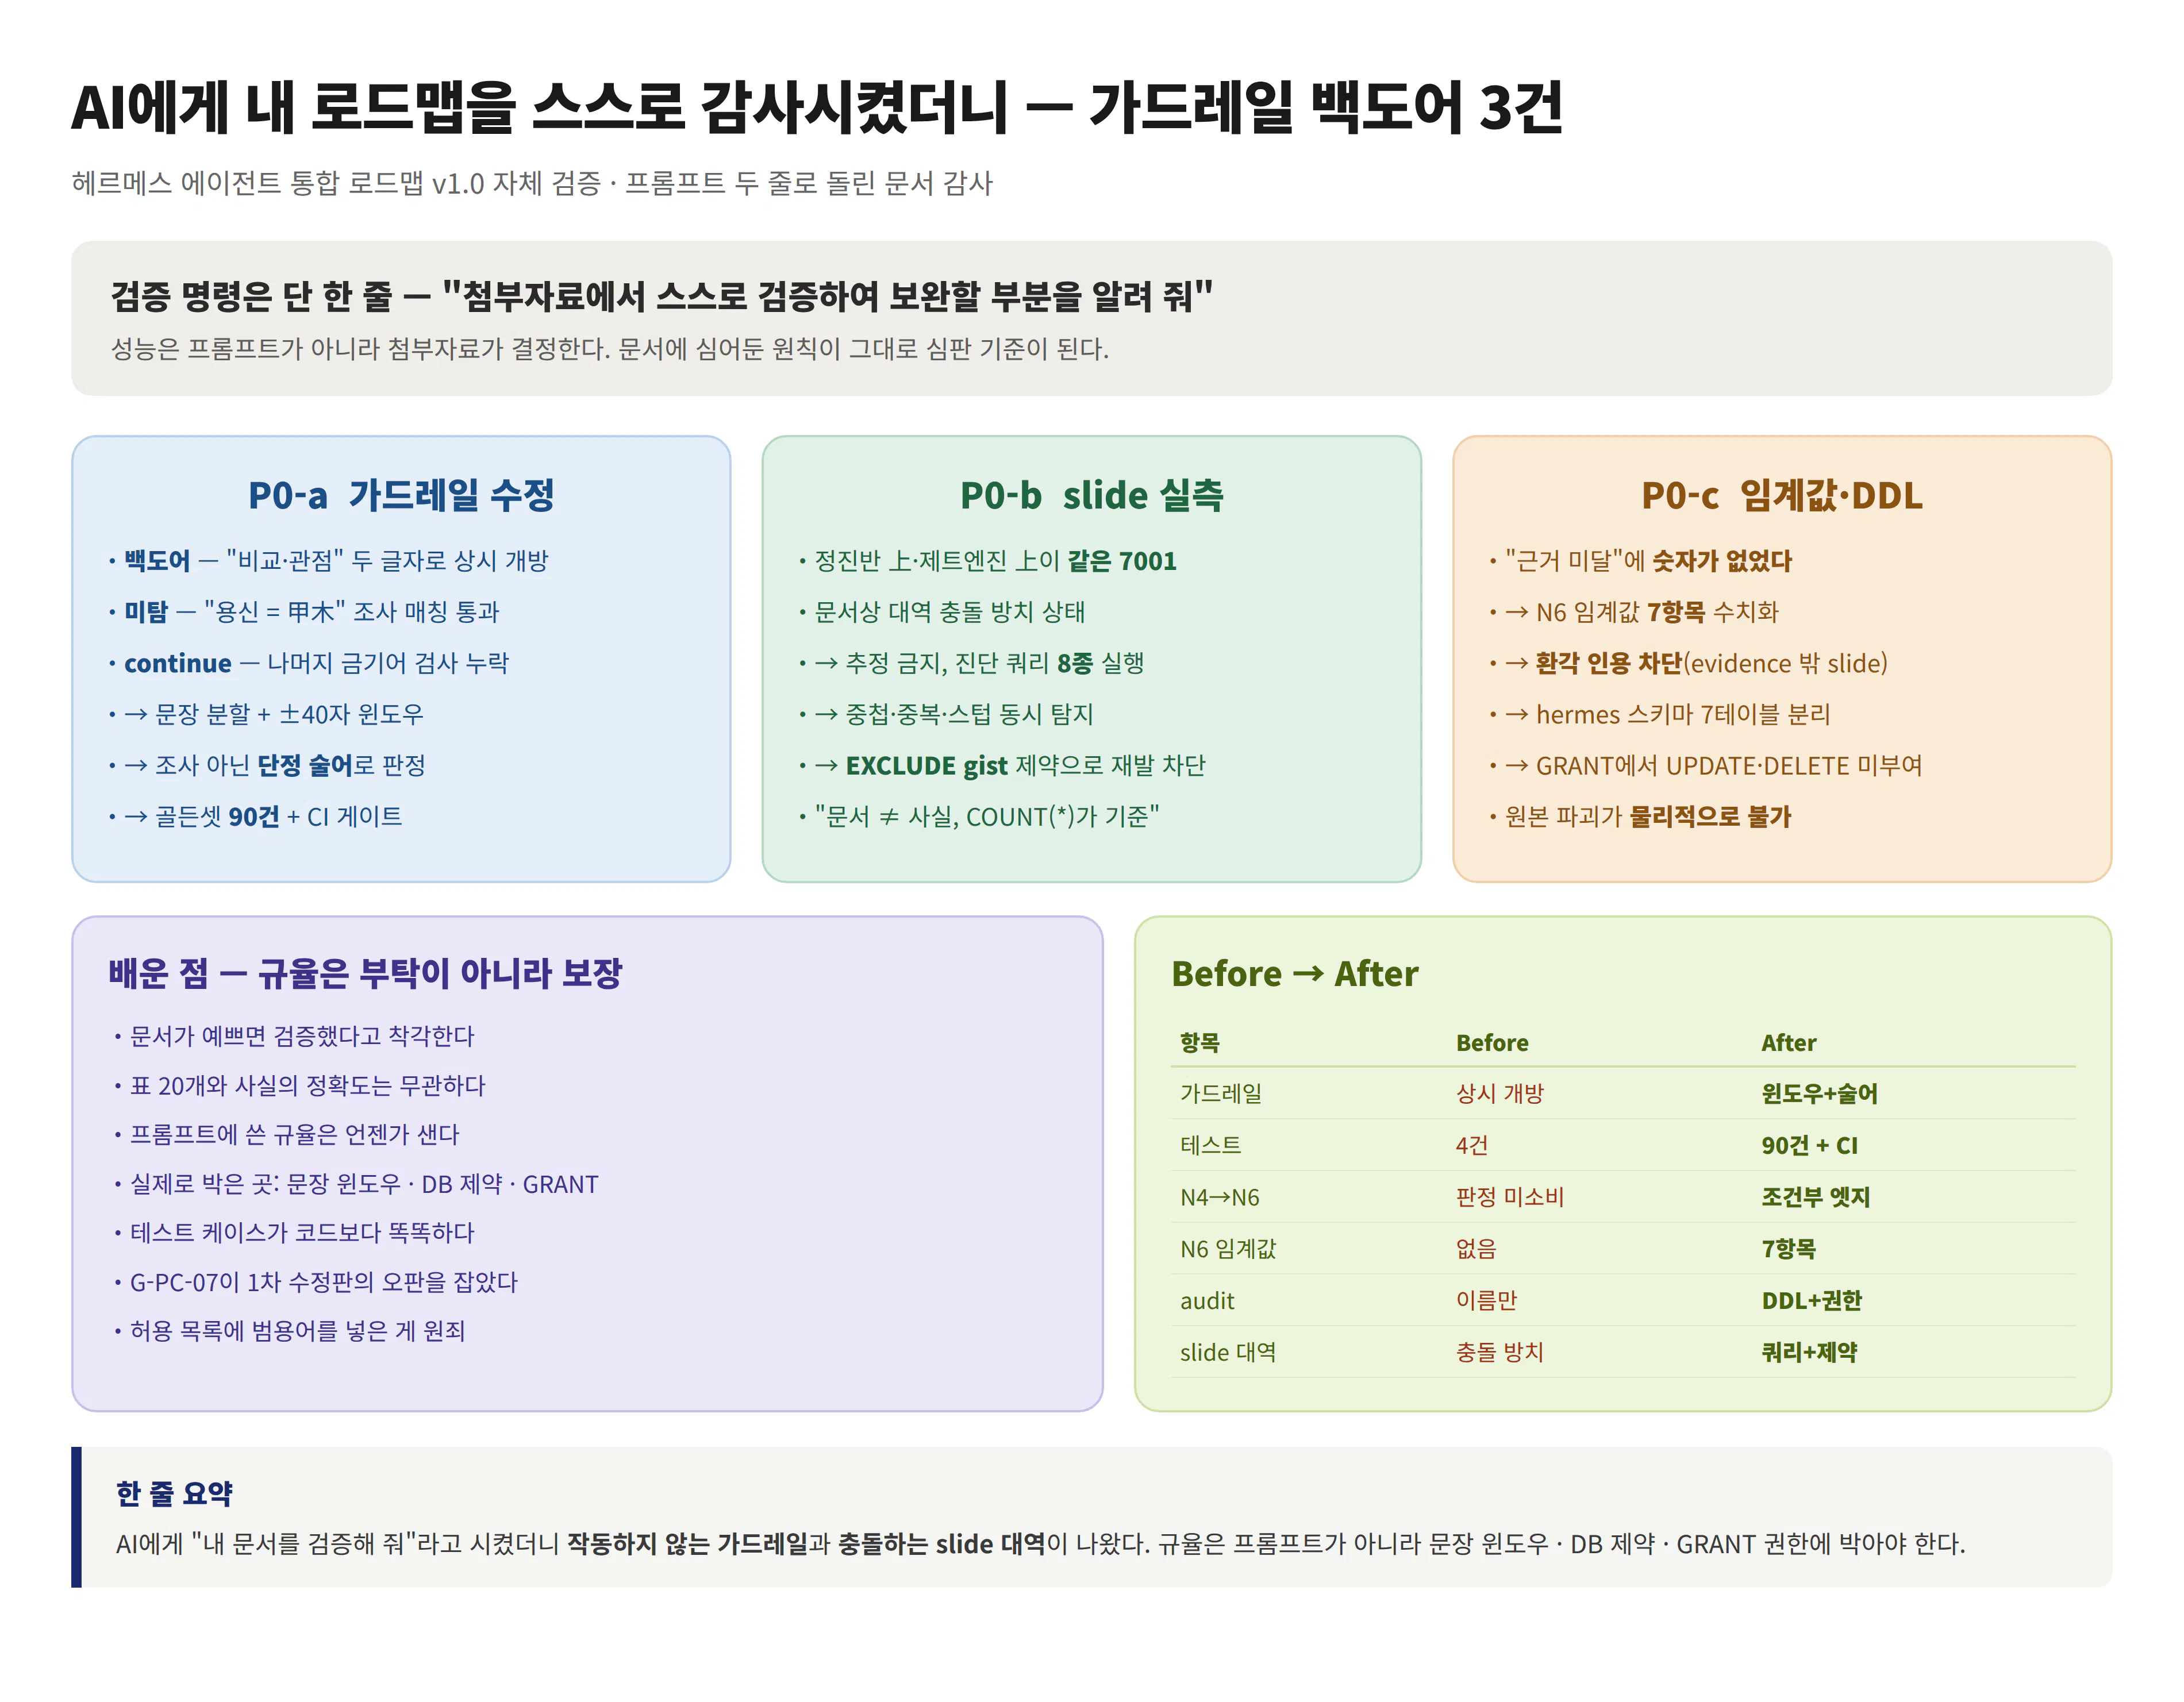
꿀팁은 프롬프트가 아니라 첨부자료에 있다. 로드맵 v1.0 안에 이미 "불변 원칙 5개", "반성문 원칙 매핑표", "문서 ≠ 사실" 선언이 박혀 있었다. AI가 이 기준선을 읽고 그 기준으로 문서 자신을 때렸다. 판단 기준을 프롬프트에 쓰지 말고 문서에 심어두면, 짧은 명령 한 줄로 감사가 돌아간다.
3-3. 진단된 결함 — 가장 아팠던 것
로드맵 §9-3에 자랑스럽게 넣어둔 가드레일 코드다.
python
# 로드맵 v1.0 원본 — 이게 문제였다
BLOCK_TERMS = ["격국", "용신", "기신", "희신"]
ALLOW_CONTEXT = ["희기동소", "격청격탁", "재정립", "비교", "관점"]

def guardrail_eval(text: str) -> tuple[str, str]:
    for term in BLOCK_TERMS:
        if f"{term}은 " in text or f"{term}이 " in text or f"{term}는 " in text:
            if any(ctx in text for ctx in ALLOW_CONTEXT):
                continue
            return "보류", f"처방형 단정 감지: '{term}'"
    return "통과", "문맥상 허용"
Claude가 짚은 세 가지.
① ALLOW 백도어 any(ctx in text ...) — 문서 전체 어디든 "비교" 또는 "관점" 두 글자만 있으면 통과한다. 명리학 문서에 "비교"가 없을 리가 없다. 즉 이 가드레일은 사실상 항상 열려 있었다.
② 조사 3종 매칭의 미탐 은/이/는만 본다. 그래서 아래가 전부 뚫린다.
"용신을 甲木으로 본다"   → 미탐
"용신 = 甲木"            → 미탐
"당신 용신, 甲木입니다"   → 미탐
가장 처방형에 가까운 표현들이 그대로 통과한다.
③ continue의 루프 오작동 term 루프를 빠져나가면서 나머지 금기어 검사를 건너뛴다.
세 개를 합치면 결론은 하나다. 이 가드레일은 작동하지 않았다. 그런데 로드맵에는 "구현 코드"라는 제목으로 당당히 실려 있었다.
3-4. 수정판 — 문장 단위 + 단정 술어
python
# hermes/guardrail.py
import re
from typing import Literal, NamedTuple

BLOCK_TERMS = ["격국", "용신", "기신", "희신"]

# 범용어(비교·관점) 제거 → 도메인 고유어만 잔류
ALLOW_TERMS = ["희기동소", "喜忌同所", "격청격탁", "格淸格濁", "재정립"]

# 조사가 아니라 "단정 술어"로 판정
PRESCRIPTIVE = re.compile(
    r"(?:은|는|이|가|을|를)?\s*"
    r"(?:[甲乙丙丁戊己庚辛壬癸子丑寅卯辰巳午未申酉戌亥]|"
    r"[가-힣]{1,4}[木火土金水]|[木火土金水])"
    r"\s*(?:입니다|이다|다\b|로\s*본다|으로\s*본다|에\s*해당|=)"
)
PRESCRIPTIVE_ALT = re.compile(
    r"(?:당신|귀하|이\s*명식|사주)의?\s*[^.。\n]{0,12}"
    r"(?:격국|용신|기신|희신)"
)

CONTEXT_WINDOW = 40   # 금기어 기준 좌우 40자만 본다

class GuardResult(NamedTuple):
    verdict: Literal["통과", "보류"]
    reason: str
    hits: list

def _split_sentences(text: str) -> list[str]:
    """허용 판정을 문장 안에 가둔다 — 백도어 차단의 핵심"""
    parts = re.split(r"(?<=[.。!?])\s+|\n+", text)
    return [p.strip() for p in parts if p.strip()]

def guardrail_eval(text: str) -> GuardResult:
    hits = []
    for sent in _split_sentences(text):
        for term in BLOCK_TERMS:
            for m in re.finditer(re.escape(term), sent):
                s, e = m.span()
                tail = sent[e: e + 30]
                window = sent[max(0, s - CONTEXT_WINDOW): e + CONTEXT_WINDOW]

                prescriptive = PRESCRIPTIVE.search(tail) or PRESCRIPTIVE_ALT.search(sent)

                # 허용어가 있어도 처방형 단정이면 우선 차단
                if prescriptive:
                    hits.append({"term": term, "sentence": sent})
                elif any(a in window for a in ALLOW_TERMS):
                    continue
    if hits:
        terms = ", ".join(sorted({h["term"] for h in hits}))
        return GuardResult("보류", f"처방형 단정 감지: {terms}", hits)
    return GuardResult("통과", "문맥상 허용", [])
가장 중요한 한 줄은 _split_sentences다. 허용 판정을 문장 안으로 가두는 순간 백도어가 닫힌다.
3-5. 골든셋 — 계통별 30건씩 90건
수정만 하면 다음 개선 때 또 깨진다. 그래서 회귀 방지 고정 셋을 만들었다.
가장 값진 케이스는 이것이다.
ID
문장
기대
G-PC-07
희기동소이므로 용신은 丁火다
보류
허용어("희기동소")가 윈도우 안에 버젓이 있다. 그런데 뒤에 처방형 단정이 붙는다. 1차 수정판은 이걸 통과로 오판했다. Claude가 골든셋을 짜다가 스스로 발견하고 순서를 뒤집었다 — 처방형 판정을 허용 판정보다 먼저. 검증이 코드를 고친 게 아니라, 테스트 케이스가 코드를 고쳤다.
yaml
schema:
  id:        G-{계통}-{일련}
  lineage:   gwanbeop | parkcheonghwa | sangni
  text:      검사 대상 문장
  expect:    통과 | 보류
  regression: true
① 탈XX 4관법 (절대 차단 계통)
ID
text
expect
G-GB-01
당신의 용신은 甲木입니다
보류
G-GB-03
기신 = 丙火
보류
G-GB-04
희신을 壬水로 본다
보류
G-GB-06
4관법은 격국·용신 개념을 사용하지 않는다
통과
G-GB-09
탈XX 계통에서 용신론은 배제된다
통과
② 박청화 (재정립 맥락 허용)
ID
text
expect
G-PC-01
희기동소 관점에서 용신과 기신이 한 자리에 있다
통과
G-PC-03
冬 85강에서 격국용신을 재정립한다
통과
G-PC-05
그래서 당신의 용신은 庚金이다
보류
G-PC-07
희기동소이므로 용신은 丁火다
보류
③ 상리철학 (오탐 방지용)
ID
text
expect
G-SN-01
황경 기준 절기 계산은 겉보기태양을 쓴다
통과
G-SN-04
상리철학에는 용신 개념이 없다
통과
G-SN-06
그러므로 이 명식의 용신은 癸水입니다
보류
CI 게이트 — 1건이라도 실패하면 배포 차단
python
# hermes/eval/run_golden.py
import yaml, sys
from hermes.guardrail import guardrail_eval

cases = yaml.safe_load(open("hermes/eval/golden_set.yaml"))["cases"]
fails = [(c["id"], c["expect"], guardrail_eval(c["text"]).verdict, c["text"])
         for c in cases
         if guardrail_eval(c["text"]).verdict != c["expect"]]

print(f"{len(cases)-len(fails)}/{len(cases)} pass")
for f in fails:
    print("FAIL", *f, sep=" | ")
sys.exit(1 if fails else 0)
완료 기준(DoD): 90건 전건 통과 + 오탐률 0%. 오탐 0%가 미탐 0%보다 우선한다. 과거 무조건 차단 시절, 희기동소 설명이 통째로 막히는 과잉 차단 사고를 겪었기 때문이다.
3-6. 실측 — "문서 ≠ 사실"
로드맵 §2-2에 이렇게 적혀 있었다.
정진반 上   : slide 7001~7098
제트엔진 上 : slide 7001~7233
같은 시작번호다. 둘 중 하나가 오기이거나, 애초에 대역 관리 체계가 없다는 뜻이다. 그런데 추정하지 않는다. 이것도 반성문 원칙이다.
원본 데이터 우선, 추정 금지.
sql
-- ============================================
-- P0-b : slide 대역 실측 진단 (hanbadook_production)
-- ============================================

\echo '=== [1] 전체 누적 건수 (문서 9,733건+ 대조) ==='
SELECT COUNT(*) AS total_rows,
       COUNT(DISTINCT slide) AS distinct_slides,
       MIN(slide) AS min_slide, MAX(slide) AS max_slide
FROM gwanbeop_ppt;

\echo '=== [2] source별 slide 대역 (§2-2 대조표) ==='
SELECT source, COUNT(*) AS rows,
       MIN(slide) AS slide_min, MAX(slide) AS slide_max,
       (MAX(slide) - MIN(slide) + 1) - COUNT(DISTINCT slide) AS gap_count
FROM gwanbeop_ppt GROUP BY source ORDER BY slide_min;

\echo '=== [3] 대역 중첩 탐지 (정진반 上 vs 제트엔진 上) ==='
WITH r AS (SELECT source, MIN(slide) lo, MAX(slide) hi
           FROM gwanbeop_ppt GROUP BY source)
SELECT a.source AS source_a, a.lo, a.hi,
       b.source AS source_b, b.lo, b.hi,
       GREATEST(a.lo,b.lo) AS overlap_from, LEAST(a.hi,b.hi) AS overlap_to
FROM r a JOIN r b ON a.source < b.source
  AND a.lo <= b.hi AND b.lo <= a.hi
ORDER BY overlap_from;

\echo '=== [4] 동일 slide를 2개 이상 source가 점유 (실제 충돌) ==='
SELECT slide, COUNT(DISTINCT source) AS n_source,
       string_agg(DISTINCT source, ' | ') AS sources
FROM gwanbeop_ppt GROUP BY slide
HAVING COUNT(DISTINCT source) > 1 ORDER BY slide LIMIT 50;

\echo '=== [8] content 스텁 탐지 — RAG 검색 오염원 ==='
SELECT source, COUNT(*) AS stub_rows
FROM gwanbeop_ppt
WHERE content IS NULL OR length(btrim(content)) < 30
GROUP BY source ORDER BY stub_rows DESC;
그리고 재발 방지. 실측 결과와 무관하게, slide 번호를 source마다 수동 부여하는 방식은 언젠가 또 충돌한다. DB가 막게 했다.
sql
CREATE TABLE slide_range_registry (
  id          serial PRIMARY KEY,
  lineage     text NOT NULL CHECK (lineage IN ('gwanbeop','parkcheonghwa','sangni')),
  source      text NOT NULL UNIQUE,
  slide_lo    integer NOT NULL,
  slide_hi    integer NOT NULL,
  CHECK (slide_hi >= slide_lo),
  EXCLUDE USING gist (int4range(slide_lo, slide_hi, '[]') WITH &&)
);
EXCLUDE ... WITH && 한 줄이 대역 중첩을 DB 레벨에서 원천 차단한다. 코드가 실수해도 INSERT가 튕긴다.
3-7. N6 임계값 — "근거 미달"에 숫자를 넣다
로드맵에는 "근거 미달 → 차단"이라고만 써 있었다. 숫자가 없으면 규칙이 아니다.
python
VERIFY_THRESHOLDS = {
    "min_evidence":       2,      # slide 근거 최소 2건 (단일 출처 단정 방지)
    "min_distinct_slide": 2,      # 서로 다른 slide 2개 이상
    "sim_top1_min":       0.55,   # 현 기준선 0.5395 기반 보수 설정
    "sim_mean_min":       0.45,
    "citation_valid":     True,   # ★ 인용 slide가 evidence에 실재해야 함
    "single_lineage":     True,   # 계통 혼용 시 즉시 실패
    "min_content_len":    30,     # 스텁 배제
}
핵심은 citation_valid다.
python
cited = extract_citations(state["draft"])
if not cited:
    fails.append("인용 누락")
elif not set(cited) <= {e["slide"] for e in ev}:
    fails.append("환각 인용: evidence 밖 slide 참조")
draft가 evidence에 없는 slide 번호를 지어내는 것 — 이게 fail-closed를 무력화하는 가장 흔한 경로다. "slide 6,203 참조"라고 그럴듯하게 써놓으면 사람은 못 잡는다. 이 한 줄이 잡는다.
3-8. 사이드카를 DB 권한으로 강제
헤르메스 불변 원칙 1번은 사이드카 — 원본은 절대 건드리지 않는다. 이걸 "조심하자"가 아니라 권한으로 못박았다.
sql
CREATE SCHEMA IF NOT EXISTS hermes;

CREATE TABLE hermes.saju_rag_evidence (
  id           bigserial PRIMARY KEY,
  run_id       uuid NOT NULL REFERENCES hermes.run(run_id) ON DELETE CASCADE,
  rank         smallint NOT NULL,
  source       text NOT NULL,
  slide        integer NOT NULL,
  lineage      text NOT NULL,
  score        numeric(6,5) NOT NULL,
  content_hash text NOT NULL,        -- 원문 SHA256 → 원본 변조 감지
  cited        boolean NOT NULL DEFAULT false,
  UNIQUE (run_id, rank)
);

-- 권한 분리 ★
CREATE ROLE hermes_agent LOGIN;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO hermes_agent;   -- 읽기만
GRANT SELECT, INSERT ON ALL TABLES IN SCHEMA hermes TO hermes_agent;
-- UPDATE/DELETE 미부여 → audit 불변성 + 원본 파괴 물리적 불가
코드에 버그가 있어도 원본이 안 죽는다. 원칙을 프롬프트에 쓰면 새고, 권한에 쓰면 안 샌다.
결과와 배운 점
4-1. 결과 요약
구분
Before (로드맵 v1.0)
After
가드레일
범용어 백도어로 상시 개방
문장 윈도우 + 단정 술어 판정
미탐 패턴
= / 로 본다 / 쉼표 전부 통과
정규식 커버
테스트
Eval 케이스 4건
골든셋 90건 + CI 게이트
N4→N6
보류 판정이 소비되지 않음
조건부 엣지 신설
retry_count
라우터에서 변이(LangGraph 위반)
노드에서 증가
N6 임계값
없음
7개 항목 수치화
audit 스키마
이름만 존재
DDL 7테이블 + 권한 분리
slide 대역
문서상 충돌 방치
실측 쿼리 8종 + DB 제약
4-2. 배운 점 — 세 가지
① 문서가 예쁘면 검증했다고 착각한다
로드맵 v1.0은 13개 절, 표 20개, 코드 블록 5개짜리 누적통합본이었다. 형식이 정연할수록 내용을 안 본다. 표의 개수와 사실의 정확도는 무관하다.
② 규율은 프롬프트가 아니라 구조에 박아야 한다
이건 원래 내 로드맵 §4-2에 적혀 있던 원칙이다.
LLM에게 "지켜줘"라고 부탁하면 언젠가 샌다.
그 원칙을 적어놓고, 정작 가드레일 코드는 새고 있었다. 원칙을 아는 것과 구현하는 것은 전혀 다르다. 이번에 실제로 박은 것: 문장 단위 윈도우, DB EXCLUDE 제약, GRANT 권한 분리. 셋 다 부탁이 아니라 보장이다.
③ 테스트 케이스가 코드보다 똑똑하다
G-PC-07("희기동소이므로 용신은 丁火다")은 골든셋을 짜는 도중에 1차 수정판의 오판을 잡아냈다. 코드를 더 노려봐도 안 나왔을 결함이다. 경계 케이스를 문장으로 써보는 행위 자체가 설계 검증이다.
4-3. 시행착오
착오 1 — 첫 수정판도 틀렸다. 허용 판정을 먼저 하고 처방형 판정을 나중에 했다. 순서가 뒤집혀 있었다. 골든셋이 없었으면 그대로 배포했을 것이다.
착오 2 — 범용어를 허용 목록에 넣은 게 원죄였다. "비교", "관점"을 ALLOW에 넣을 때는 "재정립 맥락을 살리자"는 선의였다. 선의가 백도어가 됐다. 허용 목록은 도메인 고유어만. 범용어는 절대 넣으면 안 된다.
착오 3 — 로드맵에 고아 수치가 있었다. "2004판 449섹션"이라는 수치가 §6-1에 있는데, 다른 어떤 누적치로도 이어지지 않는다. 어디서 왔는지 나도 모른다. 출처 없는 숫자는 문서의 신뢰를 통째로 깎는다.
4-4. 나만의 꿀팁
"자체 검증해 줘"의 성능은 프롬프트가 아니라 첨부자료가 결정한다.
내 로드맵에는 이미 이런 것들이 박혀 있었다.
불변 원칙 5개 (사이드카 / 원본 불변 / 계통 혼용 금지 / fail-closed / 2단 승인)
반성문 원칙 → 코드 매핑표
"문서 ≠ 사실 — 서버
SELECT COUNT(*)가 유일한 최종 기준"
AI는 이 기준선을 읽고 그 기준으로 문서 자신을 심판했다. 판단 기준을 매번 프롬프트에 타이핑하지 말고 문서에 심어두면, "검증해 줘" 한 줄로 감사가 돌아간다.
부수 효과가 하나 더 있다. 기준을 문서에 써두면 AI가 나를 봐주지 못한다. 내가 쓴 원칙으로 내 문서를 때리기 때문이다.
4-5. 도움이 필요한 부분
① 문자열 매칭의 한계 — 문맥 분류기 설계 정규식은 임시방편이다. "재정립 맥락"과 "처방형 단정"을 진짜로 가르려면 소형 LLM 분류기가 필요한데, 학습 데이터를 어느 규모로 잡아야 할지 감이 안 온다. 도메인 특화 분류기 파인튜닝 경험 있으신 분 조언 구합니다.
② 골든셋 90건이 충분한가 계통별 30건으로 잡았는데 근거가 약하다. 회귀 테스트 셋 규모 산정 기준을 어떻게 잡으시는지 궁금합니다.
③ RAG 유사도 0.5395 → 0.80 현 기준선이 0.5395다. 청크 전략을 구조 유형별(격자형/나선형/요약형)로 차별화하는 방향은 잡았는데, 강의 녹취 기반 나선형 구조(같은 주제가 여러 강에 흩어져 반복) 청킹에서 막혀 있다.
< 앞으로의 계획 >
즉시 (P0 — 진행 중)
\d gwanbeop_ppt→ 실측 쿼리 8종 실행 → §2-2 표 확정골든셋 90건 완성 + CI 게이트 연결 (DoD: 전건 통과 · 오탐 0%)
hermes 스키마 DDL 적용 +
hermes_agent권한 분리N4 조건부 엣지 · retry_count 이동 반영
단기 (P1)
유사도 히트맵 일일 Cron
맥락 분기 태거 (동일 키워드의 강의 시점 구분)
무엇이든물어보세요 108강 스텁 content UPDATE + 재색인
문맥 분류기(소형 LLM) 설계 착수
중기 (P2)
교차 참조 인덱스 — "기억의 연결 고리" 재현
LangGraph Phase 10 스트리밍(Rails SSE)에 6노드 통합
hermes_wiki테이블 구축 (3대 계통 위키화)60갑자 커버리지 19/60 → 60/60
최종 (2027)
UNESCO 디지털 문화유산 등재. 헤르메스 출력이 등재 서류 규격으로 바로 흐르도록 표준화하고, hermes_wiki를 등재 서류 용어집(glossary)으로 재활용한다.
목표 유사도 0.80은 기술 수치가 아니다. 인간 학습자가 148강을 듣고 잊어버리는 맥락을, AI가 대신 기억하는 충실도의 정량 표현이다.
도움 받은 글 (옵션)
Andrej Karpathy — LLM as Wiki (Row / Wiki / Schema 3요소) : 이 틀로 자산을 점검하니 결론이 명확해졌다. Row(원천 데이터)는 이미 충분하다. 병목은 Wiki(정제)와 Schema(규칙)다. 헤르메스가 할 일은 새 데이터 추가가 아니라 기존 Wiki 품질을 올리는 것.
Anthropic — Agent Harness 개념 (Trigger / Context / Skill / Eval / Approval / Repair) : 6노드를 이 6단계에 매핑하니 "어디서 멈춰야 하는지"가 구조로 드러났다.
내 자신의 「Claude 반성문 총괄표 v3.7」 (34건 누적) : 가장 크게 도움받은 자료. AI의 실수를 기록해둔 문서가 내 문서의 실수를 잡는 기준이 됐다. 원칙 1(모르면 아는 척 금지), 원칙 2(추정 금지), 원칙 3(기존 기능 유지)이 이번 P0-a/b/c 전부의 뼈대다.
