Hermes Agent + Unsloth 로컬 엔드포인트 + Chroma 로컬 RAG 기초까지 붙여보기
2026.06.09
배경
Giacomo 님께서 좋은 소스를 공유해 주었습니다. Hermes Agent를 이용해 sLLM을 구성할 수 있는 다양한 빌트인들~! (하단 참조)
Hermes Agent를 만든 Nous Research가 원래 AI 모델을 개발하는 회사여서 sLLM 하기 좋은 Agent라는 이야기를 전해주셔서 오늘의 파이프라인에 도전하게 되었습니다~!
헤르메스 옵셔널 빌트인
mlops
- huggingface-accelerate: PyTorch 스크립트에 분산학습을 쉽게 붙이는 HF Accelerate 가이드
- chroma: 로컬/오픈소스 RAG용 임베딩 DB와 벡터/텍스트 검색
- clip: 이미지-텍스트 매칭, zero-shot 이미지 분류, 크로스모달 검색
- faiss: 대규모 벡터 k-NN/유사도 검색용 고성능 라이브러리
- optimizing-attention-flash: Flash Attention/SDPA로 attention 속도와 메모리 최적화
- guidance: regex/grammar로 LLM 출력을 구조적으로 제어
- huggingface-tokenizers: Rust 기반 고속 tokenizer 훈련·처리
- outlines: JSON/regex/Pydantic 기반 구조화 LLM 생성
- instructor: Pydantic validation과 retry로 LLM 구조화 추출
- lambda-labs-gpu-cloud: Lambda Labs GPU 인스턴스 사용/운영 가이드
- llava: LLaVA 기반 이미지 대화·시각 질의응답 작업
- modal-serverless-gpu: Modal serverless GPU로 ML API/배치 작업 실행
- nemo-curator: LLM 학습데이터 품질필터·중복제거·PII 제거 등 GPU 큐레이션
- peft-fine-tuning: LoRA/QLoRA 등 PEFT 방식의 LLM 파인튜닝
- pinecone: 관리형 벡터 DB로 프로덕션 RAG/추천/검색 구축
- pytorch-fsdp: PyTorch FSDP/FSDP2 분산학습 전문 가이드
- pytorch-lightning: Lightning Trainer로 깔끔한 학습 루프와 분산학습 구성
- qdrant-vector-search: Rust 기반 Qdrant 벡터 검색/RAG 시스템 구축
- sparse-autoencoder-training: SAELens로 Sparse Autoencoder 학습·해석
- simpo-training: DPO보다 단순한 reference-free preference optimization
- slime-rl-training: Megatron+SGLang 기반 slime RL post-training
- stable-diffusion-image-generation: Diffusers 기반 Stable Diffusion 이미지 생성/인페인팅
- tensorrt-llm: NVIDIA TensorRT-LLM으로 LLM 추론 최적화
- distributed-llm-pretraining-torchtitan: TorchTitan으로 대규모 LLM pretraining 구성
- axolotl: YAML 기반 LoRA/DPO/GRPO 파인튜닝
- fine-tuning-with-trl: TRL 기반 SFT/DPO/PPO/GRPO/reward modeling
- unsloth: VRAM 절약형 고속 LoRA/QLoRA 파인튜닝
- whisper: OpenAI Whisper 기반 다국어 음성인식/번역
위 내용을 참조하여 우선은 DGX Spark 장비 기준으로 Hermes Agent를 안정적으로 붙여보는 것부터 시작했습니다.
최종적으로는 로컬 오픈모델 운영, 그리고 이후에는 Unsloth 등을 활용한 개인 sLLM 구축 테스트까지 염두에 두고 있습니다.
다만 처음부터 분산 구성이나 대규모 튜닝으로 들어가면 확인 포인트가 너무 많아져서, 이번에는 범위를 줄여서 아래 세 가지만 빠르게 검증해봤습니다.
Hermes Agent를 로컬 모델 백엔드에 붙일 수 있는가
Chroma로 로컬 문서 검색 기반 RAG를 최소 형태로 만들 수 있는가
이 구성이 나중에 튜닝/분산 확장으로 이어질 수 있는가
목표
이번 테스트의 목표는 성능 최적화가 아니라,
“아 이렇게 붙이면 되는구나”를 빠르게 체감하는 것이었습니다.
구체적으로는 다음 정도를 확인하는 게 목표였습니다.
DGX Spark에서 Hermes Agent 실행
Unsloth 로컬 API endpoint를 Hermes의 모델 백엔드로 연결
Chroma에 샘플 문서를 넣고 간단한 질의 검색 수행
추후 개인 sLLM / RAG / 2대 확장으로 이어질 수 있는 기본 구조 확보
즉, 프로덕션급 완성보다 로컬 AI 스택의 연결 감각을 잡는 테스트에 가까웠습니다.
진행 과정
1) Hermes Agent 설치 및 실행 확인
가장 먼저 Hermes Agent부터 올렸습니다.
Git 상태 확인 후 설치를 진행했고, 실행까지는 비교적 매끄럽게 됐습니다.
초기 확인 포인트는 단순했습니다.
git --version정상 출력hermes실행 시 TUI 진입기본 모델/도구/스킬 목록 표시 확인
이 단계에서 느낀 점은, Hermes 자체 설치 난이도는 생각보다 높지 않다는 것이었습니다.
TUI로 바로 들어가서 동작 상태를 확인할 수 있는 점도 좋았습니다.
2) optional built-ins 방향 정리
이번 미니 파이프라인에서는 optional built-ins를 전부 건드리지는 않았고,
목적에 맞는 최소 조합만 보려고 했습니다.
우선순위는 이렇게 잡았습니다.
Unsloth: 로컬 모델 서빙 및 이후 경량 튜닝 축
Chroma: 로컬 문서 저장/검색 기반 RAG 축
필요 시 이후 검토:
acceleratepefttrltensorrt-llm
결론적으로 이번 테스트에서는
“Hermes + Unsloth + Chroma” 이 3개 축만 잡아도 구조를 이해하는 데 충분했습니다.
3) Unsloth를 로컬 OpenAI-compatible endpoint로 쓰는 구조 확인
이번 구성의 핵심은 여기였습니다.
보통 Hermes를 쓰면 기본 제공자 쪽으로 먼저 연결해보게 되는데,
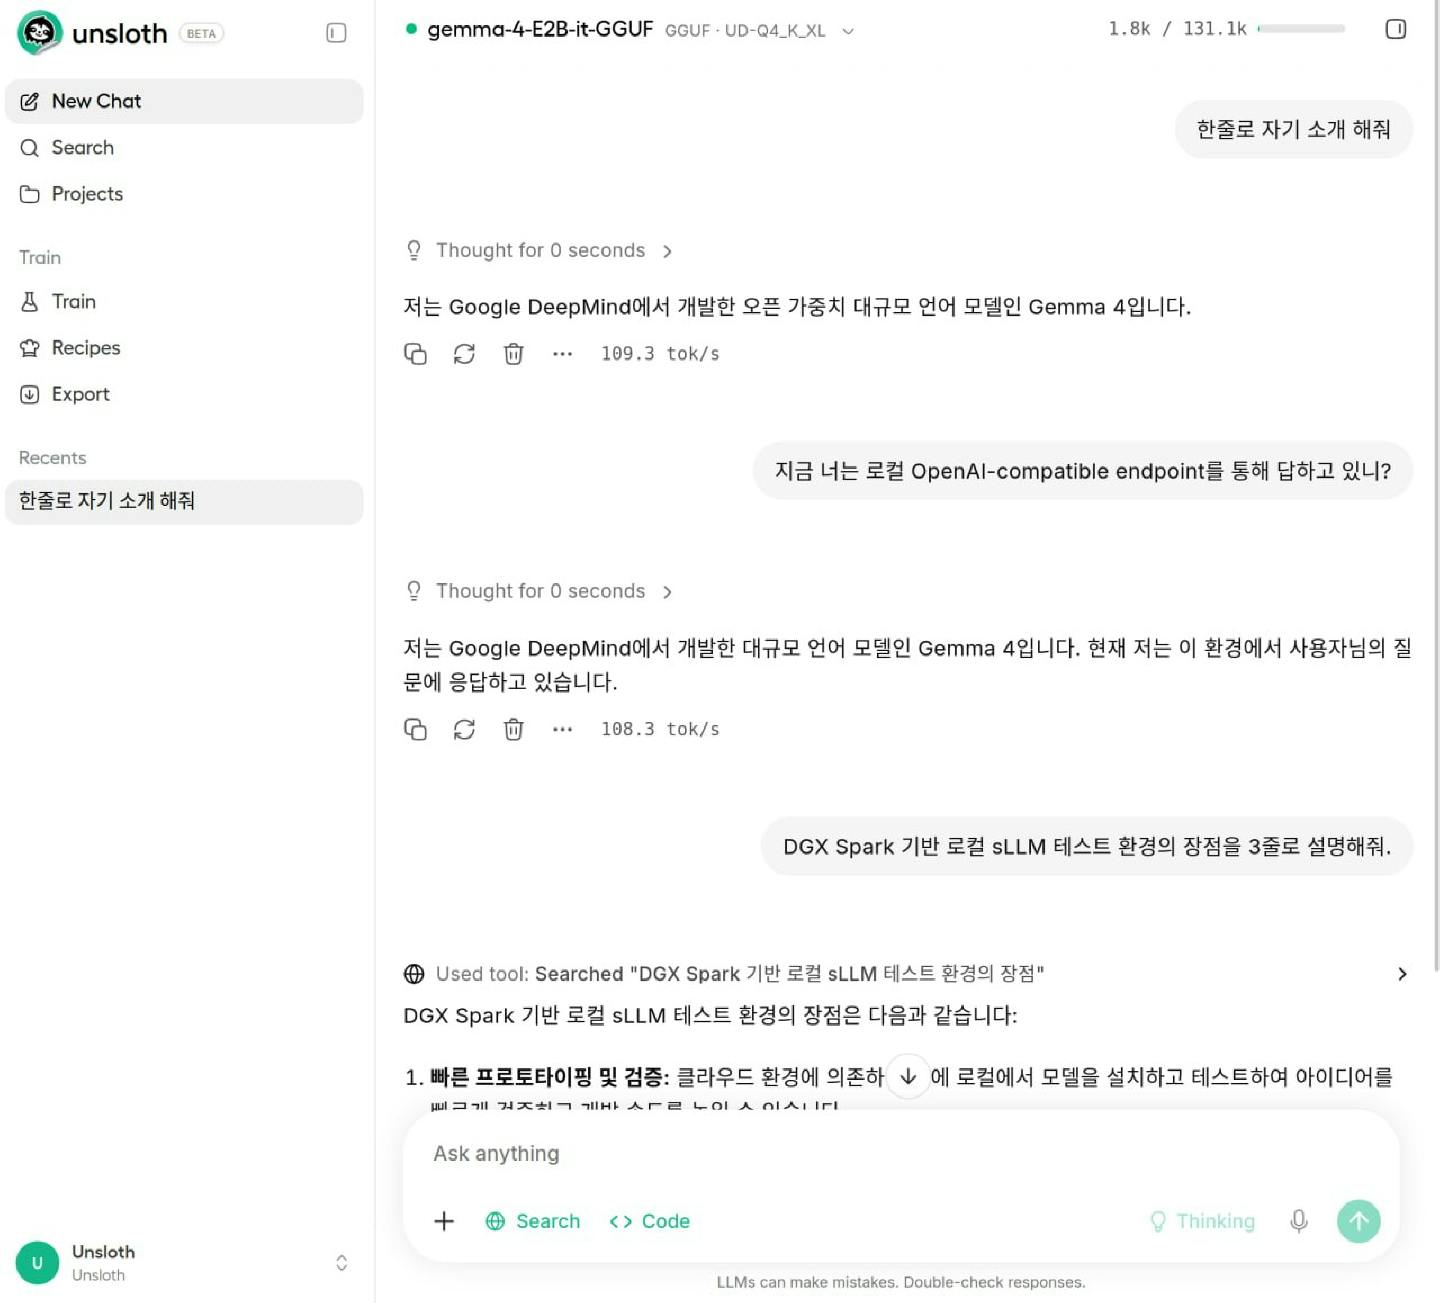
제가 보고 싶었던 건 “Hermes를 로컬 모델 백엔드로 돌릴 수 있느냐” 였습니다.
여기서 Unsloth가 꽤 직관적이었습니다.
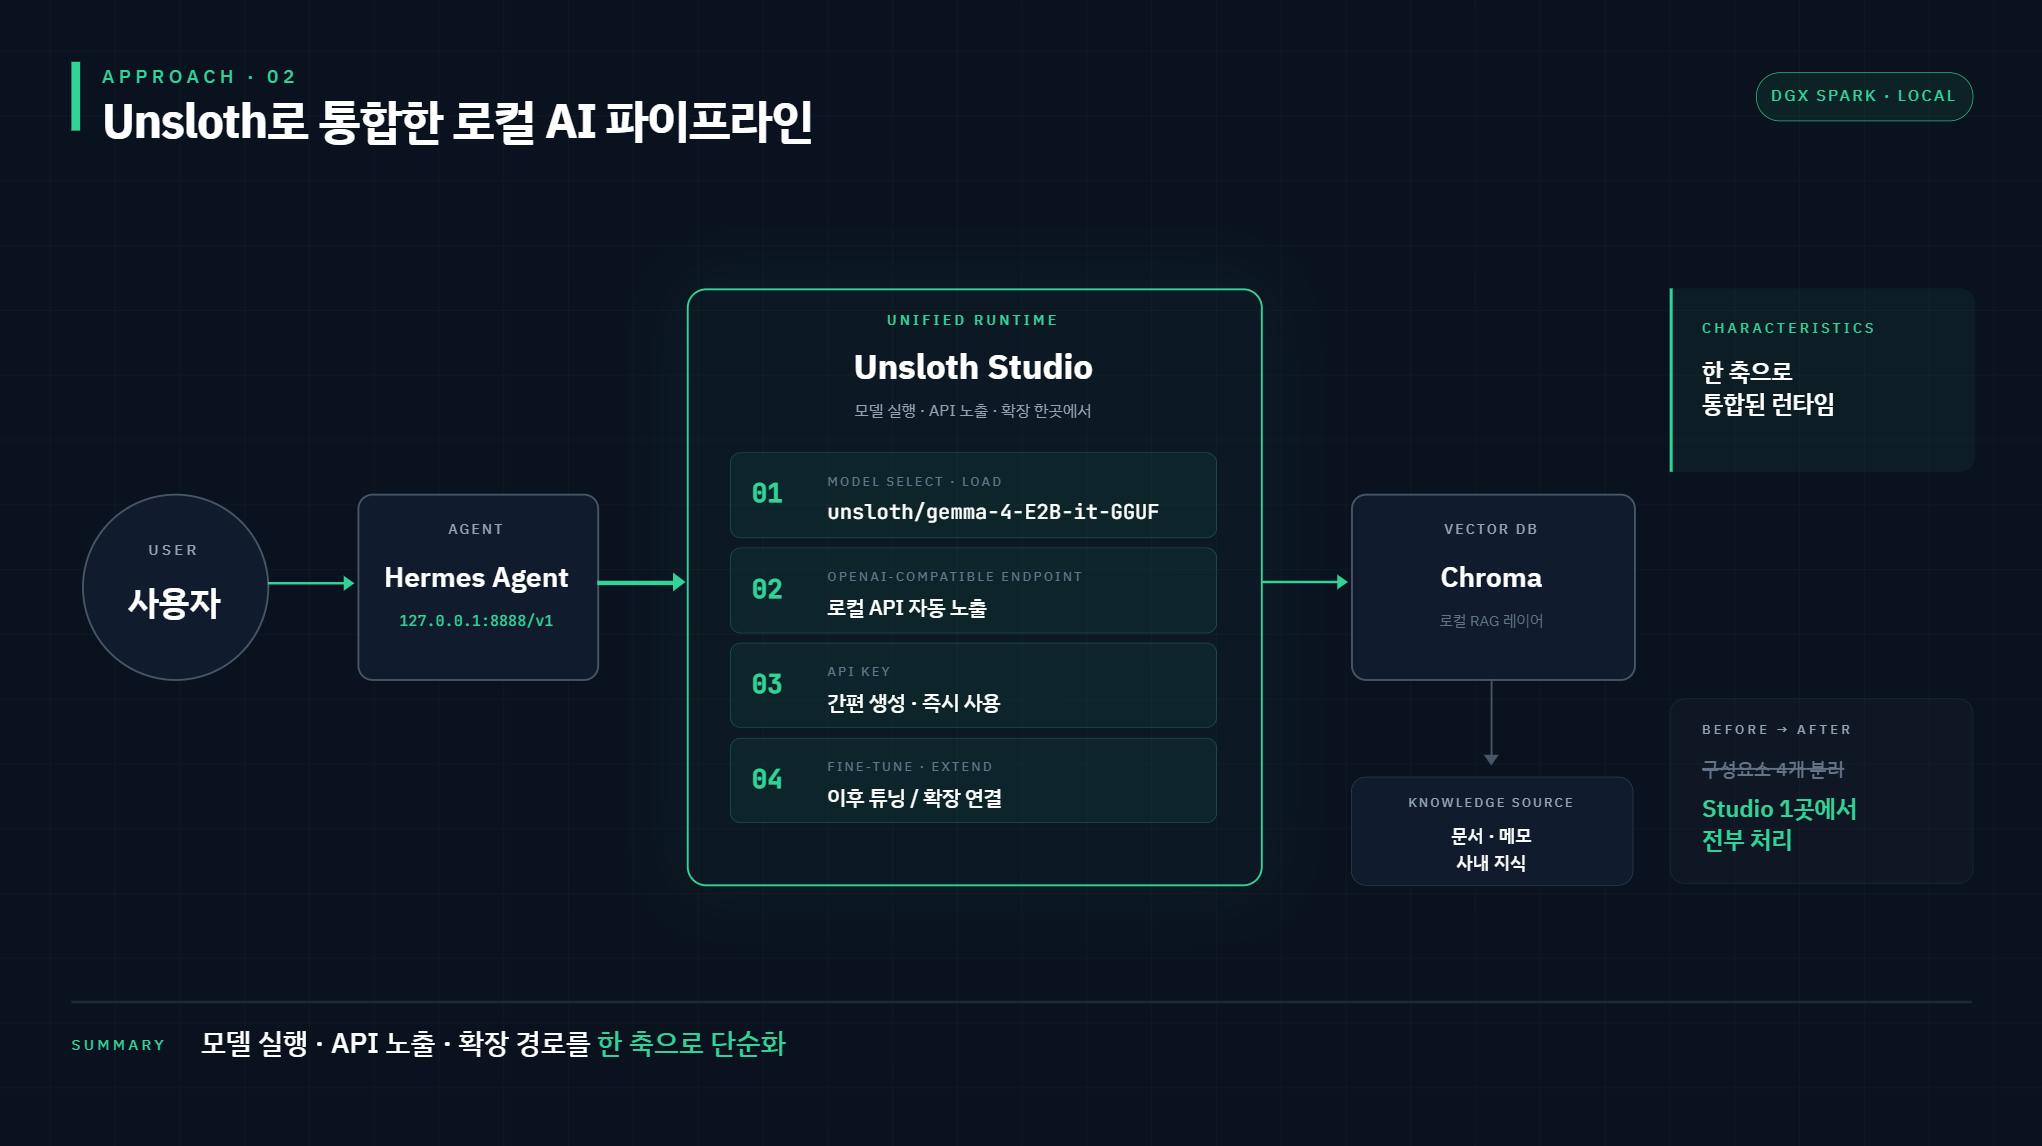
구조는 단순하게 보면:
Unsloth = 로컬 모델을 띄우는 서버
Hermes Agent = 그 서버를 호출하는 에이전트 클라이언트
형태입니다.
즉 Hermes 입장에서는
Unsloth가 띄운 로컬 모델 endpoint를 OpenAI-compatible API처럼 바라보고 붙는 구조입니다.
이 흐름이 잡히니까,
“나중에 내가 튜닝한 모델로 교체해도 Hermes 쪽 구조는 크게 안 바뀌겠구나”라는 감이 바로 왔습니다.
4) Hermes 쪽 모델 연결 관점
중간에 확인한 중요한 포인트 하나는,
Hermes가 실행된다고 해서 바로 로컬 모델에 붙은 것은 아니라는 점이었습니다.
실제로 처음 화면에서는 기존 제공자 기반 모델이 잡혀 있었고,
여기서 알 수 있었던 건:
Hermes 실행 성공
하지만 현재 백엔드는 아직 Unsloth 로컬 엔드포인트가 아닐 수 있음
따라서 실제 테스트에서는 provider 설정을 명확히 바꿔야 함
이라는 점이었습니다.
이 부분은 초보자 입장에서는 꽤 중요합니다.
TUI가 뜬다고 끝이 아니라, “지금 어떤 모델 엔드포인트를 보고 있는가”를 꼭 확인해야 합니다.
5) Chroma로 로컬 RAG 최소형 구성
RAG 쪽은 처음부터 Qdrant나 Pinecone 같은 방향보다는,
가볍게 확인하기 좋은 Chroma를 선택했습니다.
이번 테스트에서는 거창한 데이터 대신
짧은 내부 메모 느낌의 샘플 문서를 몇 개 준비해서 넣는 수준으로 시작했습니다.
예를 들면 이런 내용입니다.
DGX Spark A는 Hermes Agent 실험용 메인 장비
DGX Spark B는 추후 분산/백업 테스트용
로컬 모델은 Unsloth를 통해 endpoint로 노출
민감 데이터는 외부 API보다 로컬 처리 우선
개인 sLLM 테스트는 소형 샘플부터 시작
이런 식의 짧은 문서들을 Chroma에 넣고,
“두 번째 DGX Spark의 역할은?” 같은 질문으로 유사 문서를 검색해보는 흐름입니다.
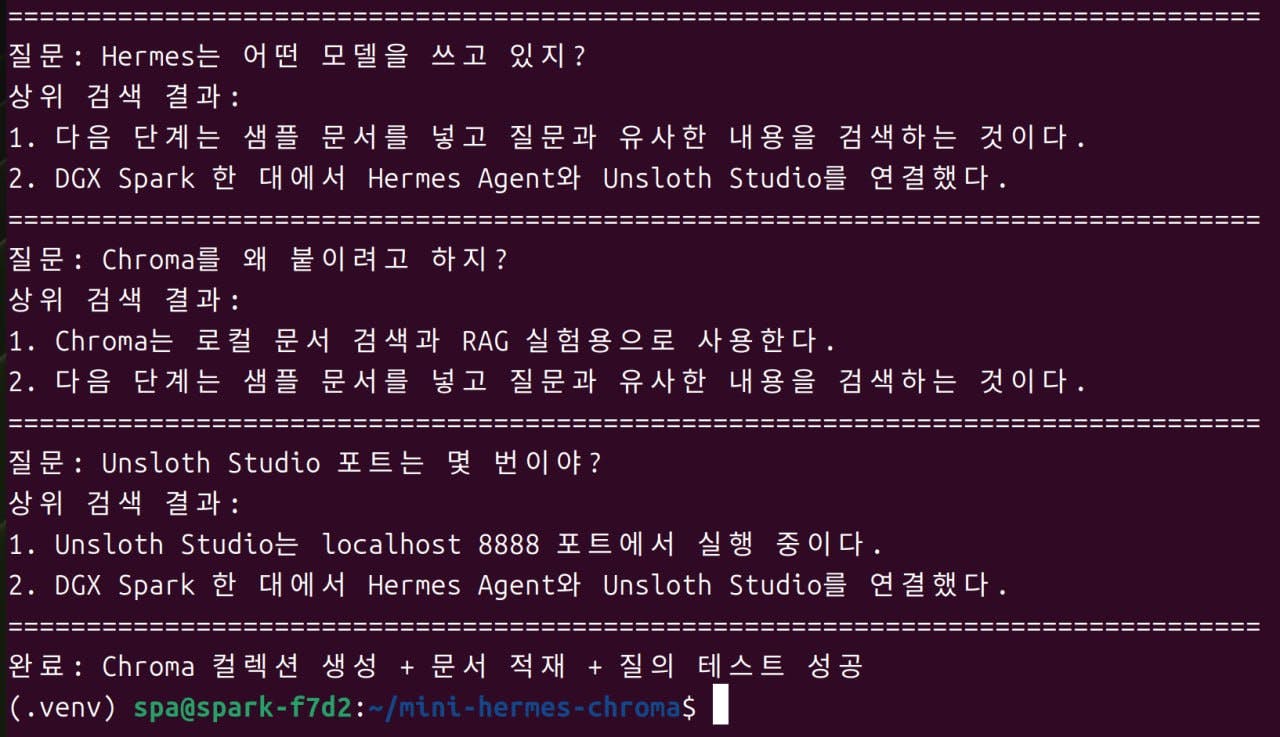
(찬찬히 답변을 읽어보니.. 많은 지도편달(사랑의 매)이 느껴지는 답변이긴 합니다. ㅋ)
이걸 해보면 RAG가 갑자기 복잡한 게 아니라, 결국은:
문서를 넣고
관련 문서를 찾고
그걸 모델 답변에 붙이는 구조
라는 게 훨씬 선명하게 보입니다.
막혔던 점
1) Hermes가 켜졌다고 바로 로컬 모델에 붙은 줄 알기 쉬움
이게 첫 번째 함정이었습니다.
Hermes TUI가 잘 뜨고 반응도 하니까 처음엔
“이제 로컬 모델까지 된 건가?”라고 생각하기 쉬운데, 실제로는 기존 provider 설정을 보고 있을 수 있습니다.
즉:
Hermes 설치 성공
Hermes 실행 성공
로컬 모델 연결 성공
이건 서로 다른 단계입니다.
2) 역할 구분이 안 되면 구조가 금방 헷갈림
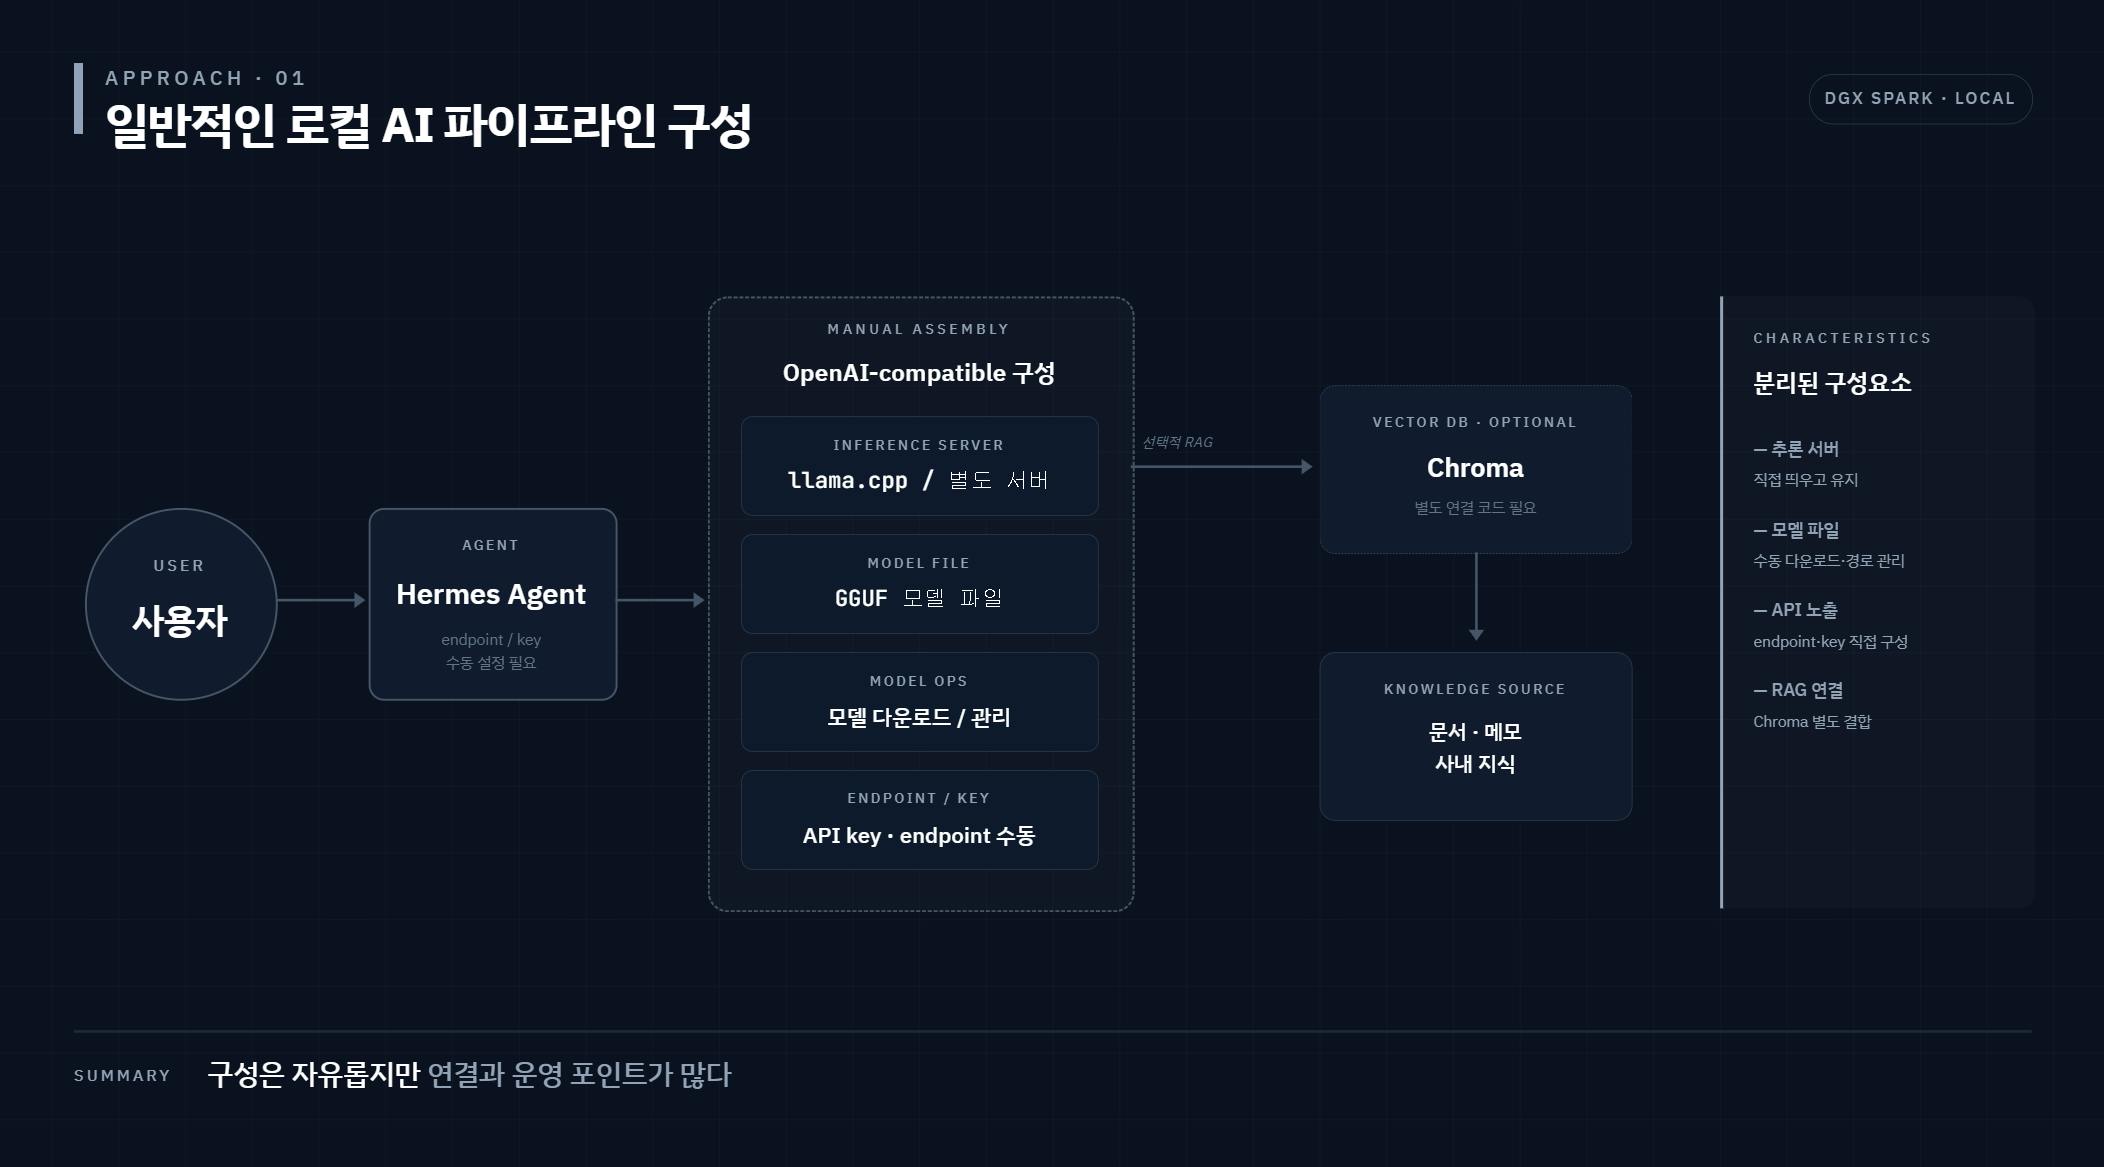
처음에는 Hermes, Unsloth, Chroma가 각각 뭘 하는지 섞여 보였습니다.
그런데 아래처럼 나누고 나서 훨씬 명확해졌습니다.
Hermes: 에이전트 인터페이스 / 실행 레이어
Unsloth: 로컬 모델 서빙 레이어
Chroma: 문서 검색 레이어
이렇게 분리해서 보니까
나중에 어떤 부분을 교체하고 확장해야 할지도 자연스럽게 보였습니다.
해결 포인트
1) 먼저 단일 장비 baseline부터 만든다
이번에 가장 잘한 선택은
무조건 DGX Spark 1대 기준으로 자르는 것이었습니다.
덕분에 확인 포인트가 단순해졌습니다.
Hermes 되나?
Unsloth endpoint 되나?
Chroma 검색 되나?
이 세 가지만 보면 됐습니다.
2) 로컬 AI 스택을 계층별로 본다
이 구성을 한 줄로 보면 꽤 복잡해 보이는데,
계층별로 보면 훨씬 단순합니다.
모델 계층: Unsloth
에이전트 계층: Hermes
검색 계층: Chroma
이렇게 나누면,
나중에 모델만 바꾸거나, 벡터DB만 바꾸거나, 에이전트 설정만 바꾸는 식의 사고가 가능해집니다.
3) 샘플 데이터는 아주 작게 시작한다
이번 테스트는 성능 검증이 아니라 구조 검증이라서,
문서도 짧게, 질문도 짧게, 목표도 작게 잡았습니다.
이게 꽤 중요했습니다.
괜히 문서 수십~수백 개, 모델 여러 개, 복잡한 파이프라인까지 한 번에 넣었으면
오히려 아무것도 명확히 안 보였을 것 같습니다.
현재 상태
현재 기준으로는 다음 정도까지 방향이 정리됐습니다.
Hermes Agent 설치 및 실행 확인
단일 DGX Spark에서 Hermes 중심 미니 파이프라인 방향성 확보
Unsloth를 로컬 OpenAI-compatible endpoint로 붙이는 구조 이해
Chroma 기반 로컬 RAG 최소형 테스트 흐름 정리
이후 개인 sLLM / LoRA / QLoRA / 2대 확장으로 갈 수 있는 출발점 확보
즉, 이번 테스트는
“완성”보다는 구성 원리와 연결 포인트를 파악한 단계라고 보는 게 맞습니다.
짧은 회고
짧게 정리하면, 이번 테스트에서 가장 크게 얻은 건
**“로컬 에이전트 스택은 생각보다 계층이 분명하다”**는 감각이었습니다.
처음엔 Hermes가 메인처럼 보이지만, 실제로는:
어떤 로컬 모델을 붙이느냐
문서를 어떻게 검색하게 하느냐
나중에 어떤 방식으로 튜닝하느냐
에 따라 전체 체감이 달라집니다.
개인적으로는 이번 미니 테스트만으로도
Hermes + Unsloth + Chroma 조합이 로컬 AI 실험의 출발점으로 꽤 괜찮다는 확신은 얻었습니다.
아직 2대 직결 구성이나 본격적인 개인 sLLM 튜닝까지 간 것은 아니지만,
적어도 “단일 DGX Spark에서 무엇부터 쌓아 올려야 하는지”는 훨씬 명확해졌습니다.
처음 로컬 AI 에이전트 환경을 잡아보려는 분들께는,
저처럼 단일 장비 + 작은 문서 + 작은 목표로 시작하는 방식을 추천드립니다.
로그인하고 댓글을 남겨 주세요

단일 장비 + 작은 문서 + 작은 목표로 테스트 파이프라인을 먼저 구축하고 작게 시작해서 점차 확장해나가는 방식이 컴퓨터 공학 전공자의 방식과 유사하네요! evaluation 기준도 (evaluation 골든 셋) 평가 데이터를 모으고, 실험 결과를 카운팅할 수 있게 수치화 하여 실험 사이클을 여러번 돌린다면, 최적화도 하실 수 있을 것 같아요ㅎㅎ 로컬 모델도 잘 돌아가는 것으로 선정하고 여러 셋팅도 테스트해보실 수 있으며, 이 과정도 cluade나 gpt, gemini 등 LLM에게 시켜볼 수도 있습니다ㅎㅎ
unsloth, local LLM 관련하여 의미 있는 도전해 주시고 사례글 공유해 주셔서 감사드립니다!
감사합니다~ 엔지니어H 스터디장님~! 비전문가 이지만 하나하나 한걸음씩 스터디 하면서 조금씩 배워가고 있습니다~ 항상 좋은 코멘트와 꿀팁 공유해주셔서 감사합니다~!


필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


Spark님, 예전부터 해보려던 sLLM 쪽 첫발을 드디어 떼신 느낌이라 먼저 축하드리고 싶어요. DGX Spark에서 Hermes Agent를 올리고, Unsloth 로컬 엔드포인트와 Chroma RAG까지 최소 형태로 붙여본 건 “이제 진짜 로컬 AI 스택을 내 손으로 만져보기 시작했다”는 의미가 있어서 되게 좋았습니다. Spark님 최고예요.
이번 글에서 특히 좋았던 건 로컬 AI 스택을 한 번에 크게 만들지 않고, 단일 DGX Spark에서 연결 감각부터 확인했다는 점이었어요. Hermes, Unsloth, Chroma를 한꺼번에 보면 꽤 복잡해 보이는데, 이번 글은 그걸 에이전트 실행 레이어, 로컬 모델 서빙 레이어, 문서 검색 레이어로 나눠서 보여줘서 따라가는 입장에서도 구조가 훨씬 선명했습니다.
특히 Hermes TUI가 뜬 것과 실제 로컬 모델 백엔드에 붙은 것을 분리해서 본 대목이 중요해 보여요. 처음에는 “실행됐다”와 “원하는 모델 endpoint를 보고 있다”가 쉽게 섞이는데, 이걸 서로 다른 확인 단계로 잡아둔 게 좋았습니다. 이 구분이 있어야 나중에 Unsloth 모델을 바꾸거나, 개인 튜닝 모델로 교체하거나, Chroma 쪽 검색 품질을 따로 손볼 수 있을 것 같아요.
RAG도 샘플 문서를 작게 잡은 선택이 좋았습니다. 처음부터 문서 수백 개나 복잡한 파이프라인으로 들어가지 않고, DGX Spark A/B 역할이나 로컬 처리 우선 같은 짧은 문서로 “문서를 넣고, 관련 문서를 찾고, 답변에 붙인다”는 흐름을 확인한 게 실험 설계상 안전해 보여요. 성능을 증명하려는 글이라기보다, 나중에 튜닝과 확장으로 가기 위한 baseline을 만든 기록처럼 읽혔습니다.
앞선 Spark님 글들이 에이전트 사무실, 멀티에이전트 팀, 지식베이스처럼 “AI가 일하는 구조”를 만드는 쪽이었다면, 이번 글은 그 구조의 바닥에 로컬 모델과 로컬 검색을 붙여보는 단계라 더 의미 있어 보입니다. 다음에 한 단계만 더 보강한다면, 대표 질문 3개 정도를 고정해서 “기대 문서, 실제 검색 문서, 최종 답변 근거”를 나란히 남겨보면 좋을 것 같아요. 그러면 Hermes + Unsloth + Chroma 조합이 단순 연결 테스트를 넘어서, 로컬 에이전트 스택의 재현 가능한 검증 기록으로 이어질 것 같습니다.
매번 느끼는거지만, 지아코모님 코멘트에는 진심이 느껴져서 참 따뜻합니다~ 이번 기수에 많은 가이드 주시고, 팁 공유 해주셔서 정말 감사합니다~!!