


소개 시도 배경
최종 목표는 서비스 정책을 Slack으로 질문하면 답변해주는 에이전트를 만드는 것입니다.
구체적으로는 세 가지 기능을 목표로 합니다.
단순 질문에 대해 정책서 기반으로 답변
새로운 기획 시 온고잉 서비스와의 충돌·영향범위를 사전에 체크
정책서가 완벽하지 않을 수 있으니, 적절한 답을 못한 질문은 모아서 인간 PM이 개입
유용한 결과가 나온다면 운영 비용 부담을 주고 싶지 않아, Hermes + 로컬 LLM 조합으로 구성하기로 했습니다. 4주에 걸쳐 만들어볼 계획이고, 이번 주는 환경 설치입니다.
진행 방법과 사용 도구
HERMES 설치
공식 가이드대로 설치 자체는 무난하게 완료했습니다.
로컬 LLM 설치 전에 먼저 Hermes와 대화를 해보기 위해 클라우드 Provider로 시도했습니다.
BUT, Provider 선택에서 약 90분을 소비했습니다.
Claude API 시도 → 유료 구독자도 서드파티 앱은 별도 크레딧이 필요하다는 에러 발생
OpenRouter 전환 시도 → 여러 모델·환경변수 변경·reset을 반복했으나 대부분 out-of-date된 정보였고 chat 시점에 404 에러만 발생
결론 → 모델 선택 리스트에서
free표시된 것을 하나 골랐더니 바로 성공
Local LLM 설치
로컬 Provider로 LM Studio(lmstudio.ai)를 설치했습니다.
Hermes에서 로컬 LLM을 연결하는 방법은 간단합니다.
Provider:
Custom endpoint→ URL:127.0.0.1:1234Model: 다운로드한 모델 중 선택
여기서 모델 삽질이 다시 시작됩니다.
모델
문제
google/gemma-4-e4b다운로드 85%에서 멈춤. 아직도 그 상태
google/gemma-4-e2bcontext window 4,096 → Hermes 최소 64K 미달 에러
brunopio Qwen3.5-14B-A3B Q4_K_M답변을 중국어로 함. SOUL.md에 한국어 강제 지시를 추가하면 된다고 하는데 아직 미해결
Qwen3-14B← 현재동일한 64K 미달 에러. LM Studio 기본값이 4,096이라 아래 명령으로 재로드 필요
:
lms load qwen/qwen3-14b --context-length 65536 --gpu max로 재로드
SOUL.md 작성
정책서는 미리 md 파일로 구성해두었고, 정책서 위치와 에이전트 의도를 담아 SOUL.md 파일을 작성했습니다.
Hermes 실행
SOUL.md를 올바른 위치에 복사한 뒤 Hermes를 실행합니다.
# SOUL.md를 올바른 위치에 복사
cp {경로}/SOUL.md ~/.hermes/SOUL.md

# 확인
cat ~/.hermes/SOUL.md

# Hermes 실행 (그냥 이렇게만)
hermes
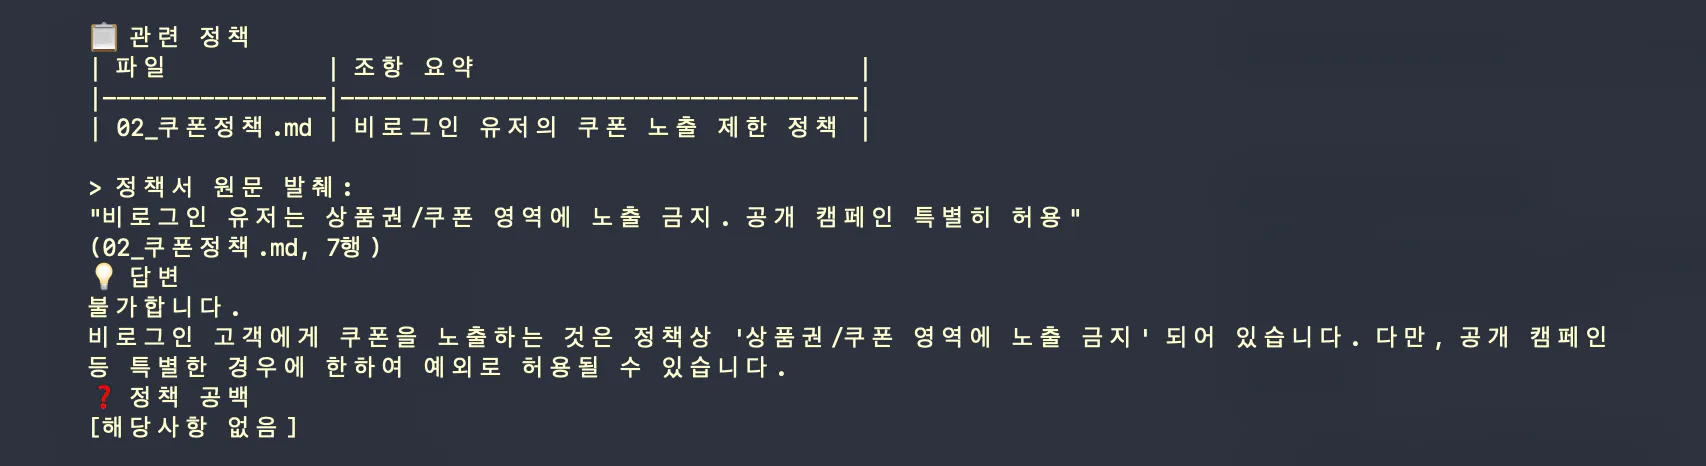
질문을 던져보면, 답변은 오는데, 아직 원하는 품질은 아닙니다.
어두운 배경에 한국어 텍스트
결과와 배운 점
느낀점
모델 설정에서 꽤 답답한 시간을 보냈지만, 덕분에 Hermes 설정을 바꾸는 것에 대한 두려움은 없어졌습니다. 설정을 아무렇게나 해도, 원복이 복잡하진 않습니다.
앞으로의 계획
답변속도 개선 - 단순질문도 3분 이상 소요.
LLM 모델 다시 찾아볼 것
일단 단순 질의응답부터 개선 -> 이후 추론형 답변(모델 + 스킬 정의) + 피드백 프로세스
Slack 연동
