


소개
한국 달력 스크린샷
지금까지 헤르메스가 갖춘 것
헤르메스는 사주 통변을 근거와 함께 생성하는 LangGraph 파이프라인입니다. 10편까지 오면서 검증 계층을 두 겹 쌓았습니다.
노드
역할
판정 방식
성격
N4 GuardrailAgent
처방형 단정 차단 (격국·용신·기신·희신)
문자열·패턴 대조
규율
N6 검증
근거 slide 없는 문장 차단 (fail-closed)
인용 존재 여부
규율
두 노드의 공통점은 기계가 대조할 수 있는 것만 본다는 점입니다. 금기어가 있는가, 인용이 붙었는가. 예/아니오로 떨어집니다.
그런데 비어 있던 것
문제는 이 두 겹을 다 통과한 통변이 좋은 통변이라는 보장은 전혀 없다는 것이었습니다.
[N4 통과] 금기어 없음        ✅
[N6 통과] 모든 문장에 인용   ✅
   ↓
그래서 이 통변이 쓸 만한가?  ← 사람이 눈으로 봄
금기어를 피하면서 하나 마나 한 말만 늘어놓을 수 있습니다. 모든 문장에 [source:slide]를 붙이면서도 계통을 뒤섞을 수 있습니다. 인용은 붙었는데 정작 그 인용이 문장 내용과 무관할 수도 있습니다. 규율 검사는 "위반하지 않았다"만 말해줄 뿐, "잘했다"는 말해주지 않습니다.
지금까지는 이 부분을 제가 감으로 봤습니다. 그런데 감으로 본 판단은 기록이 남지 않고, 기록이 없으면 개선 우선순위도 세울 수 없습니다.
청강1에서 빌려온 것
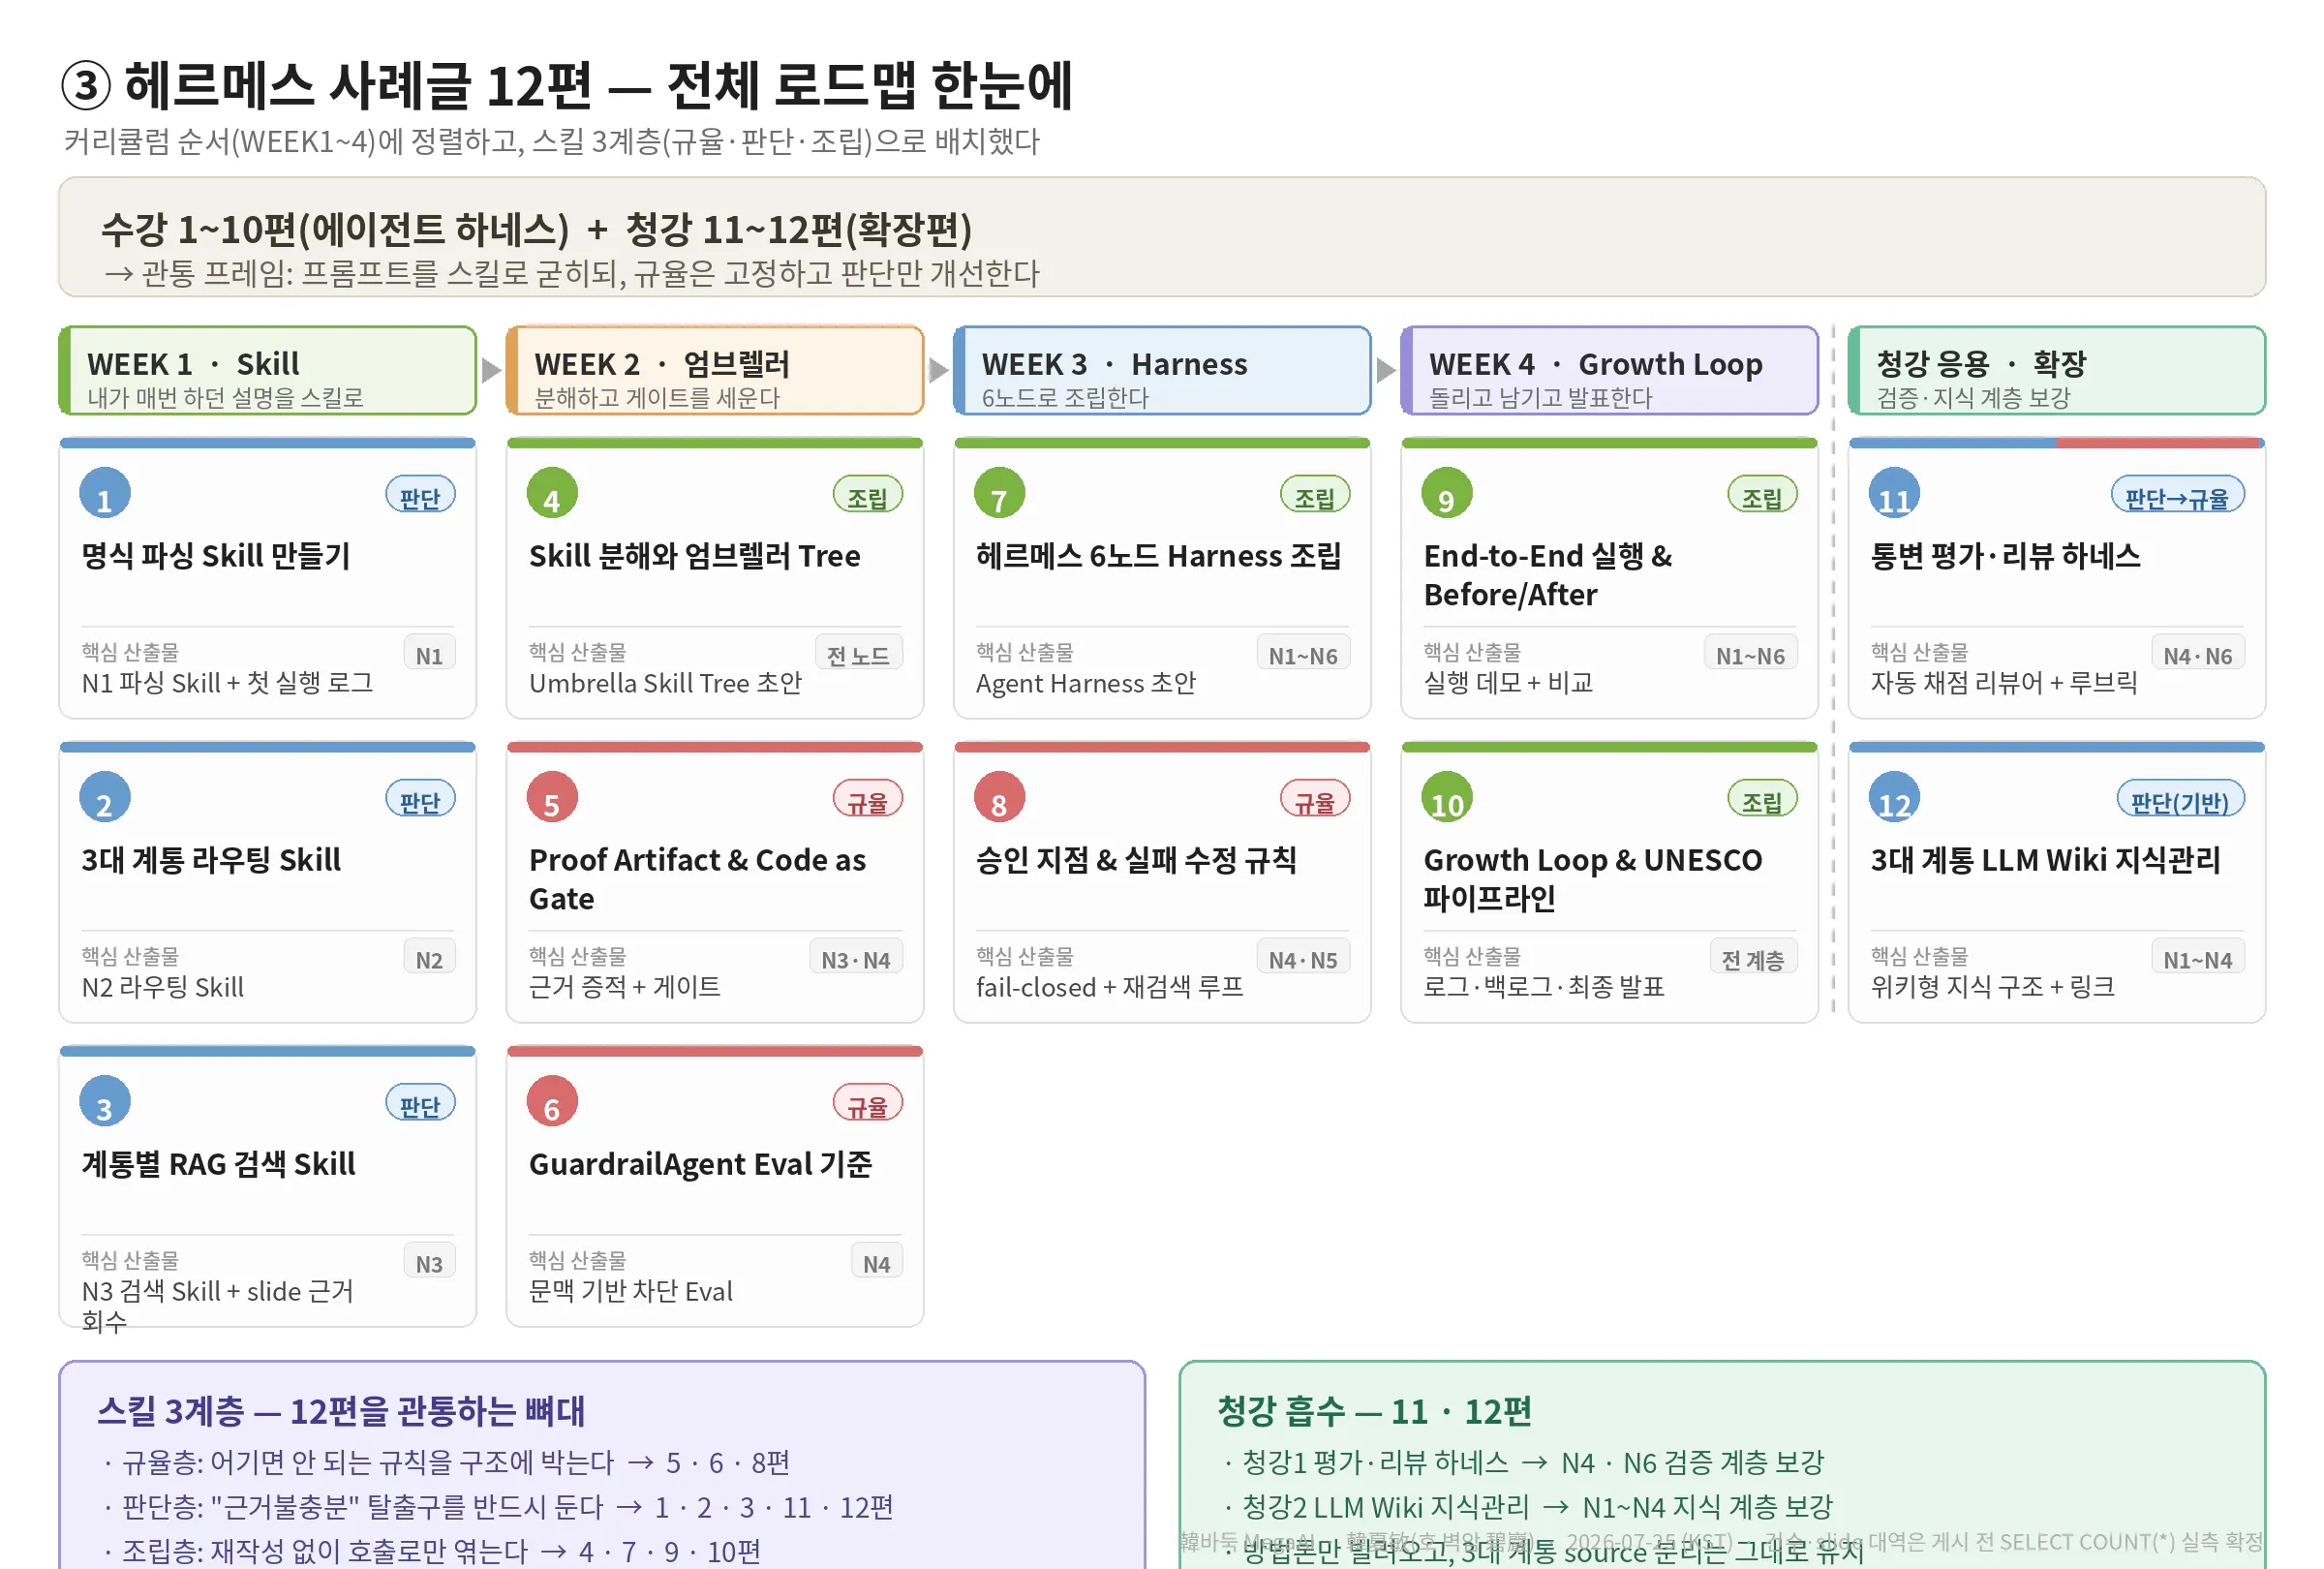
23기 청강1(AI 결과물을 스스로 검수하는 평가·리뷰 하네스)의 핵심은 단순했습니다. 결과물을 만든 놈에게 채점을 시키지 말 것. 루브릭을 고정하고, 별도의 리뷰어가 점수를 매기고, 그 점수로 다음 행동을 정한다.
이걸 헤르메스에 흡수해서 N7 리뷰 노드를 만들었습니다.
이번 편의 설계 원칙 3가지
생성기와 리뷰어를 분리한다 — 같은 프롬프트 안에서 자기 결과물을 채점하면 반드시 후해집니다.
리뷰어는 채점만 한다 — 고쳐 쓰기를 허용하는 순간 리뷰어가 두 번째 생성기가 됩니다.
점수 총합만으로 통과시키지 않는다 — 특정 축은 0점이 나오면 총점과 무관하게 보류입니다(하드게이트).
진행 방법
사용 도구: LangGraph(N7 리뷰 노드) · Claude Opus 4.5 API(리뷰어, 생성기와 별도 호출) · PostgreSQL(채점 이력 저장)
3-1. N4·N6·N7의 역할 분리
세 노드가 겹치지 않도록 관할을 먼저 갈랐습니다. 겹치면 "누가 잡을 것"이라 서로 미루다 아무도 안 잡습니다.
N4 가드레일
N6 검증
N7 리뷰(신규)
묻는 것
금지된 말을 했는가
근거가 붙었는가
내용이 쓸 만한가
판정
이진(차단/통과)
이진(차단/통과)
0~2점 × 5축
실패 시
BLOCKED
HELD
보류 / 수정
성격
규율
규율
판단 + 규율 결합
주체
규칙 엔진
규칙 엔진
별도 LLM
N7만 LLM입니다. "이 문장이 겸손한가"는 정규식으로 판정할 수 없기 때문입니다. 대신 LLM이 들어온 만큼 N7 자신도 검증 대상이 됩니다(3-7에서 다룹니다).
3-2. 실행 순서에서 N7의 자리
앞 편에서 얻은 교훈을 그대로 적용했습니다. 번호는 설명하기 위한 것이고, 실행 순서는 따로 정의한다.
정의 순서(문서상)   N1 → N2 → N3 → N4 → N5 → N6 → N7

실행 순서(런타임)   N1 명식파싱
                    ↓
                    N2 계통라우팅
                    ↓
                    N3 RAG 검색
                    ↓
                    N5 합성 ────────── 여기서 draft가 생김
                    ↓
                    N4 가드레일 ────── 금기어 차단
                    ↓
                    N6 검증 ────────── 근거 fail-closed
                    ↓
                    N7 리뷰 ────────── 통과한 것 중 품질 채점
                    ↓
                    [통과 / 수정 / 보류]
N7이 맨 뒤인 이유: N4·N6에서 이미 걸린 것을 채점해봐야 의미가 없습니다. BLOCKED·HELD는 애초에 사용자에게 나가지 않는 결과물입니다. N7은 "나갈 수 있는 것들 중에서" 품질을 가르는 노드입니다.
3-3. 루브릭 5축과 그 출처
5개 축은 임의로 정하지 않았습니다. 전부 이미 프로젝트에서 지키기로 한 원칙을 채점 가능한 형태로 바꾼 것입니다.
축
묻는 것
어디서 왔나
근거성
모든 문장에 [source:slide]가 붙었는가
N6 fail-closed 원칙
계통순수
단일 계통만 사용했는가
3대 계통 분리 원칙(문장 내 혼용 금지)
가드준수
처방형 단정이 없는가
4관법 금기어 규정
표기규칙
시주|일주|월주|연주 순서를 지켰는가
명식 표기 표준(오른쪽→왼쪽)
겸손성
근거 없는 부분을 "근거 부족"으로 밝혔는가
반성문 원칙1 — 모르면 아는 척 금지
새 규칙을 만들지 않은 것이 의도입니다. 리뷰어가 새 기준을 들고 오면 기존 파이프라인과 충돌합니다. N7은 이미 있는 규칙을 채점 가능한 언어로 번역하는 역할만 합니다.
3-4. 0/1/2점의 정의 — 이게 제일 오래 걸렸습니다
처음엔 축 이름만 주고 "0~2점으로 채점하라"고 했습니다. 결과는 엉망이었습니다. 같은 통변을 두 번 채점시키면 점수가 달랐습니다. 채점 기준이 없으면 LLM은 매번 기준을 새로 만듭니다.
각 점수의 정의를 못 박고 나서야 재현성이 생겼습니다.
축
0점
1점
2점
근거성
인용 없는 문장이 2개 이상
인용 없는 문장이 1개
전 문장 인용
계통순수
한 문장 안에 두 계통 혼재
단계 내 두 계통 병기(결론 일치)
단일 계통
가드준수
처방형 단정 있음
단정은 없으나 어조가 처방형
비교·서술형만
표기규칙
순서 어긋남
순서는 맞으나 구분자 불일치
표준 준수
겸손성
근거 없는 내용을 단정
보류 표시가 일부만
전부 "근거 부족" 명시
가드준수 1점 구간이 핵심입니다. "용신은 甲木이다"는 명백한 0점입니다. 그런데 "甲木을 쓰시면 좋겠습니다"는 금기어가 하나도 없으면서 실질적으로 같은 말입니다. N4의 문자열 대조로는 절대 못 잡습니다. 이 구간을 잡으라고 N7을 붙인 겁니다.
3-5. 판정 로직 — 총점 + 하드게이트 2종
python
# skill_n7_review_harness.py   (layer: 판단 → 규율)

RUBRIC = {
    "근거성":   "모든 문장에 [source:slide]가 붙었는가",
    "계통순수": "단일 계통만 사용했는가 (문장 내 혼용 0)",
    "가드준수": "처방형 단정이 없는가 (희기동소·비교 서술은 허용)",
    "표기규칙": "시주|일주|월주|연주 순서를 지켰는가",
    "겸손성":   "근거 없는 부분을 '근거 부족'으로 밝혔는가",
}

# 총점과 무관하게 0점이면 즉시 보류인 축
HARD_GATE = ("근거성", "계통순수")

PASS_TOTAL   = 9   # 10점 만점
REVISE_TOTAL = 6


def n7_review(state) -> dict:
    """생성기와 분리된 리뷰어가 루브릭으로 채점한다. 고쳐 쓰지 않는다."""

    scores, notes = grade_with_llm(state["draft"], RUBRIC)   # 각 축 0~2점 + 근거 한 줄
    total = sum(scores.values())

    # ① 하드게이트 — 총점을 보기 전에 먼저 본다
    breached = [ax for ax in HARD_GATE if scores[ax] == 0]
    if breached:
        return _verdict(scores, notes, total, "보류",
                        f"하드게이트 위반: {', '.join(breached)}")

    # ② 근거성은 만점이 아니면 통과시키지 않는다 (N6와 이중 안전망)
    if scores["근거성"] < 2:
        return _verdict(scores, notes, total, "수정", "근거성 미달")

    # ③ 총점 판정
    if total >= PASS_TOTAL:
        verdict, reason = "통과", ""
    elif total >= REVISE_TOTAL:
        verdict, reason = "수정", "백로그 회부"
    else:
        verdict, reason = "보류", "재생성 요청"

    return _verdict(scores, notes, total, verdict, reason)


def _verdict(scores, notes, total, verdict, reason) -> dict:
    return {
        "review_scores": scores,
        "review_notes":  notes,
        "review_total":  total,
        "verdict":       verdict,
        "verdict_reason": reason,
    }
하드게이트를 왜 따로 뒀는가. 초안에서는 총점 9점 이상이면 통과였습니다. 그런데 계산해보니 계통순수가 0점이어도 나머지 네 축이 만점이면 8점이 나옵니다. 8점은 "수정"이고, 수정은 백로그로 갈 뿐 결과물은 살아남습니다. 계통 혼용은 이 프로젝트에서 가장 치명적인 오염인데 총점 산술에 묻혀버린 겁니다.
평균으로 뭉개면 안 되는 축이 있습니다. 그래서 근거성·계통순수 두 축은 총점을 보기 전에 먼저 검사합니다.
3-6. 리뷰어 프롬프트 전문
생성기와 별도 API 호출입니다. 같은 세션에 두지 않습니다.
text
당신은 헤르메스 통변의 독립 리뷰어다.
통변을 생성하거나 수정하지 마라. 오직 채점만 하라.
개선안을 제시하지 마라. 점수와 근거 한 줄만 남겨라.

아래 5개 축을 각 0~2점으로 채점한다. 각 점수의 정의는 다음과 같다.

1. 근거성
   2점 = 모든 문장에 [source:slide] 인용이 있다
   1점 = 인용 없는 문장이 정확히 1개
   0점 = 인용 없는 문장이 2개 이상

2. 계통순수
   2점 = 단일 계통만 사용
   1점 = 같은 단계 내 두 계통 병기이되 결론이 일치
   0점 = 한 문장 안에 두 계통의 논리가 혼재

3. 가드준수
   2점 = 비교·서술형만 사용
   1점 = 금기어는 없으나 어조가 처방형("~을 쓰시면 좋겠습니다")
   0점 = 처방형 단정 있음("용신은 OO이다")
   ※ 희기동소(喜忌同所)·재정립 맥락의 서술은 감점하지 않는다

4. 표기규칙
   2점 = 시주|일주|월주|연주 순서(오른쪽→왼쪽) 준수
   1점 = 순서는 맞으나 구분자·표기 불일치
   0점 = 순서 어긋남

5. 겸손성
   2점 = 근거 없는 부분을 전부 "근거 부족"으로 명시
   1점 = 일부만 명시
   0점 = 근거 없는 내용을 단정

각 축마다 그 점수를 준 근거를 통변 원문에서 인용해 한 줄로 남겨라.
근거를 찾지 못하면 그 축은 채점하지 말고 "판정불가"로 표기하라.

출력은 아래 JSON만. 다른 문장을 덧붙이지 마라.
{
  "근거성":   {"score": n, "note": "..."},
  "계통순수": {"score": n, "note": "..."},
  "가드준수": {"score": n, "note": "..."},
  "표기규칙": {"score": n, "note": "..."},
  "겸손성":   {"score": n, "note": "..."},
  "총평": "..."
}

채점 대상 통변:
{draft}
"근거를 찾지 못하면 판정불가로 표기하라" 한 줄이 의외로 컸습니다. 이게 없으면 리뷰어가 근거를 찾지 못해도 그럴듯한 점수를 지어냅니다. 리뷰어에게도 겸손성을 요구한 셈입니다.
3-7. 채점 이력 저장
채점이 1회성이면 아무 의미가 없습니다. 축적돼야 "어느 축이 계속 낮은가"를 볼 수 있습니다.
sql
CREATE TABLE hermes.tongbyun_review (
  id            bigserial PRIMARY KEY,
  report_id     text NOT NULL,
  reviewer_ver  text NOT NULL,           -- 프롬프트 버전 (바뀌면 비교 불가)
  rubric_ver    text NOT NULL,           -- 루브릭 버전
  s_geunkeo     smallint NOT NULL CHECK (s_geunkeo   BETWEEN 0 AND 2),
  s_gyetong     smallint NOT NULL CHECK (s_gyetong   BETWEEN 0 AND 2),
  s_guard       smallint NOT NULL CHECK (s_guard     BETWEEN 0 AND 2),
  s_pyogi       smallint NOT NULL CHECK (s_pyogi     BETWEEN 0 AND 2),
  s_gyeomson    smallint NOT NULL CHECK (s_gyeomson  BETWEEN 0 AND 2),
  total         smallint GENERATED ALWAYS AS
                (s_geunkeo + s_gyetong + s_guard + s_pyogi + s_gyeomson) STORED,
  verdict       text NOT NULL CHECK (verdict IN ('통과','수정','보류')),
  verdict_reason text,
  notes         jsonb NOT NULL,
  reviewed_at   timestamptz DEFAULT now()
);

-- 어느 축이 병목인가
SELECT AVG(s_geunkeo)  AS 근거성,  AVG(s_gyetong) AS 계통순수,
       AVG(s_guard)    AS 가드준수, AVG(s_pyogi)   AS 표기규칙,
       AVG(s_gyeomson) AS 겸손성
FROM hermes.tongbyun_review
WHERE rubric_ver = 'v1';reviewer_ver·rubric_ver를 반드시 남깁니다. 프롬프트를 고치면 그 전후 점수는 비교 대상이 아닙니다. 이걸 안 남기면 나중에 "점수가 올랐다"가 개선인지 채점이 후해진 건지 구분할 수 없습니다.
3-8. 리뷰어 자체를 검증하기 — 불량 샘플 골든셋
여기가 이번 편에서 제일 중요한 부분입니다.
N7을 붙이고 처음 며칠간 채점 결과가 전부 8~10점이었습니다. 기분은 좋았는데 이상했습니다. 통과만 하는 검사기는 안전망이 아니라 장식입니다.
그래서 일부러 불량인 통변 5건을 만들어 넣었습니다. 각각 한 축씩만 망가뜨린 샘플입니다.
샘플
고의 결함
기대 판정
BAD-01
인용을 3개 문장에서 제거
근거성 0 → 보류
BAD-02
한 문장에 탈XX 4관법 + 상리철학 논리 혼재
계통순수 0 → 보류
BAD-03
"용신은 甲木입니다" 삽입
가드준수 0
BAD-04
연주|월주|일주|시주 역순 표기
표기규칙 0
BAD-05
근거 없는 대운 예측을 단정으로 서술
겸손성 0
첫 실행에서 BAD-03과 BAD-05가 통과했습니다. BAD-03은 금기어가 문장 중간에 묻혀 있어 리뷰어가 흘려봤고, BAD-05는 "겸손성" 정의가 모호해 리뷰어가 1점을 줬습니다. 정의를 3-4처럼 못 박고 재실행하니 5건 모두 잡혔습니다.
이 5건이 없었으면 저는 N7이 잘 돌고 있다고 믿었을 겁니다.
(이미지 자리 ① — 리뷰어 채점 결과 JSON 원본)
(이미지 자리 ② — 통과/수정/보류 판정 로그)
(이미지 자리 ③ — 불량 샘플 5건 회귀 실행 결과, 1차 3/5 → 2차 5/5)
결과와 배운 점
먼저 구분해둡니다. 아래 내용 중 수치가 붙은 것은 불량 샘플 5건에 대한 실행 결과이고, 나머지는 소수 통변에 대한 정성 관찰입니다. 실제 운영 통변에 대한 통계는 아직 없습니다. 표본이 쌓이기 전에 "개선됐다"고 말하지 않기로 했습니다.
확인된 것
항목
결과
불량 샘플 탐지 (1차)
3/5 — 가드준수·겸손성 누락
불량 샘플 탐지 (2차, 점수 정의 명문화 후)
5/5
리뷰어 재현성
같은 통변 3회 채점 시 점수 정의 前 편차 있음 → 後 동일
꿀팁
① 생성기와 리뷰어를 분리하면 채점이 냉정해집니다. 같은 프롬프트 안에서 "네가 쓴 걸 채점해봐"라고 하면 자기 편향이 생깁니다. 별도 호출로 뺀 뒤 눈에 띄게 박해졌습니다.
② 총점 판정만 두지 말고 하드게이트를 함께 두십시오. 평균에 묻히면 안 되는 축이 반드시 있습니다. 계통순수 0점이 8점으로 통과 직전까지 갔던 게 이번 편의 가장 큰 발견입니다.
③ 0/1/2점의 정의를 반드시 문장으로 못 박으십시오. 축 이름만 주면 LLM이 매번 기준을 새로 만듭니다. 재현성이 무너지면 시계열 비교가 불가능해집니다.
④ 채점 이력에 프롬프트 버전을 남기십시오. 없으면 점수 상승이 품질 개선인지 채점 완화인지 영원히 알 수 없습니다.
⑤ 리뷰어에게도 "판정불가"를 허용하십시오. 근거를 못 찾았을 때 억지로 점수를 지어내는 것을 막아줍니다. 규율을 만드는 쪽에도 같은 규율을 적용하는 셈입니다.
시행착오
① 리뷰어가 통변을 고쳐 쓰려 했습니다. "이 부분은 이렇게 바꾸면 좋겠다"를 계속 덧붙였습니다. → 프롬프트 첫 줄에 "생성·수정 금지, 채점만"을 명시하고, 출력 스키마를 JSON으로 고정해 해결했습니다.
② 처음 며칠 점수가 전부 높게 나왔습니다. 좋은 신호로 읽었는데 아니었습니다. → 불량 샘플 5건을 넣어보고서야 리뷰어가 두 축을 사실상 안 보고 있다는 걸 알았습니다.
③ 총점 임계값을 먼저 정하고 축을 나중에 채웠습니다. 순서가 거꾸로였습니다. 축과 점수 정의가 먼저이고, 임계값은 실측 분포를 보고 정해야 합니다. 지금의 9점·6점도 잠정값입니다.
도움이 필요한 부분
5개 축의 가중치 — 현재는 전부 동등한 2점 만점입니다. 표기규칙과 계통순수가 같은 무게인 게 맞는지 확신이 없습니다. 하드게이트로 일부 보완했지만 근본 해법은 아닌 것 같습니다.
보류 케이스의 자동 재생성 루프 — 지금은 보류가 뜨면 제가 손으로 다시 돌립니다. 무한 루프를 막으면서 재시도를 자동화하는 방법(재시도 상한, 같은 실패 반복 시 중단 조건)에 대한 조언을 구합니다.
리뷰어 골든셋의 적정 규모 — 현재 5건인데, 축당 1건이라 우연히 통과할 여지가 있어 보입니다.
< 앞으로의 계획 >
N7 결과를 Growth Loop 백로그(사례글 10)에 자동 회부 — "수정" 판정이 난 케이스가 개선 우선순위 상단에 자동으로 쌓이도록 연결합니다. 사람이 옮겨 적는 단계를 없애는 것이 목표입니다.
축별 평균 점수 시계열 관측 — 어느 축이 만성적으로 낮은지가 곧 다음 개선 대상입니다. 낮은 축이 계통순수라면 라우팅 문제이고, 근거성이라면 RAG 회수 문제입니다. 점수가 진단 지도 역할을 하게 만드는 것이 진짜 목적입니다.
불량 샘플 골든셋 확장 — 축당 1건에서 축당 3건으로. 특히 "금기어 없이 처방하는" 교묘한 케이스를 늘릴 계획입니다.
임계값 재산정 — 실측 분포가 30건 이상 쌓인 뒤 9점·6점을 다시 정합니다.
도움 받은 글 (옵션)
23기 청강1 — AI 결과물을 스스로 검수하는 평가·리뷰 하네스
Claude 반성문 총괄표 v3.7 (원칙1 "모르면 아는 척 금지", 원칙4 "임시방편 금지")
韓바둑 통변 고급화 전략 v2.0 — rtype 판정, 계통 결합 원칙
