AutoResearch 패턴 적용해서 AI가 알아서 콘텐츠 소스 품질을 개선하게 만드는 방법
2026.03.19
한줄 요약
Karpathy의 AutoResearch 패턴을 콘텐츠 큐레이션에 적용해서, AI가 소스 품질을 채점하고 나쁜 소스는 끄고, 좋은 소스는 복제하고(Exploit), 완전히 새로운 소스도 탐험하는(Explore) 자동 루프를 만들었어요.
콘텐츠 큐레이팅의 문제: "좋은 소스"를 찾는 게 가장 어렵다
AI 뉴스, 도구 활용법, 인사이트를 수집해서 웹 피드와 Slack으로 전달하는 큐레이션 봇을 운영하고 있어요. RSS, Reddit, Hacker News, YouTube 등 106개가 넘는 소스에서 콘텐츠를 긁어오는 구조예요.
콘텐츠 큐레이션에서 가장 중요한 건 소스 품질이에요.
아무리 AI 요약을 잘해도, 원본 소스가 별로면 결과물도 별로거든요.
그래서 좋은 소스를 계속 발굴하고 밀어넣는 게 핵심 업무였어요.
문제는 이걸 개선하는 작업이 꽤 수동이었다는 거예요.
새 소스를 찾으려면 직접 블로그, RSS를 검색하고 하나씩 확인
등록한 소스가 시간이 지나면서 품질이 떨어져도 알 길이 없음
소스가 40개를 넘으니 "어떤 소스가 좋고 어떤 게 별로인지" 감으로만 판단
좋은 소스를 찾는 데 시간이 가장 많이 들었어요. 그런데 이걸 계속 사람이 해야 하나? 하는 의문이 있었어요.
갓파시의 AutoResearch를 보고 얻은 아이디어
그러다 Karpathy가 공개한 AutoResearch를 발견했습니다! 630줄짜리 스크립트인데,
핵심 아이디어가 매우 좋았어요.
실험 → 측정 → 유지/폐기 → 반복
AI 에이전트가 ML 코드를 수정하고, 5분간 학습시키고, 결과가 좋으면 유지하고 나쁘면 롤백해요. 이걸 하루에 100번 반복하면서 스스로 개선되는 구조였는데요.
"이 패턴이 ML에만 적용되라는 법은 없잖아?"
측정할 수 있는 품질 지표가 있고, 그 지표에 따라 자동으로 의사결정하는 구조
— 이건 소스 관리에도 그대로 적용할 수 있었어요.
AutoResearch            →     내 큐레이션 봇
─────────────────────────────────────────────
코드 수정               →     소스 추가/제거
학습 결과 측정           →     콘텐츠 품질 채점
좋으면 유지, 나쁘면 롤백  →     우수 소스 유지, 저품질 비활성화
소스 자동 개선 루프 설계 과정
아이디어는 명확했지만, 실제로 만들려면 구체적인 설계가 필요했어요.
Claude Code와 대화하면서 설계를 발전시켰는데, 핵심적인 결정이 세 가지 있었어요.
결정 1: 품질을 어떻게 측정할까?
가장 고민이 많았던 부분이에요. 사용자 피드백을 기다리자니 데이터가 너무 느리게 쌓여요. 하루에 수백 개 콘텐츠가 수집되는데, 사람이 일일이 "좋아요/별로"를 누르는 건 현실적이지 않았습니다.
해결: LLM이 직접 채점 (LLM-as-judge)
콘텐츠를 수집하고 정리하는 시점에, Gemini가 3가지 축으로 1~10점을 매기게 했어요:
축 | 기준 | 높은 점수 예시 | 낮은 점수 예시 |
|---|---|---|---|
Relevance | AI 실무자에게 관련 있는가 | 프롬프트 엔지니어링 팁 | 정치 뉴스 |
Freshness | 새로운 정보인가 | GPT-5 출시 소식 | 1년 된 가이드 재탕 |
Depth | 실질적 깊이가 있는가 | 코드 예시가 포함된 튜토리얼 | 제목만 있는 짧은 글 |
종합 점수 공식: relevance × 0.5 + freshness × 0.25 + depth × 0.25
관련성에 50% 가중치를 준 이유가 있어요. 아무리 깊이 있고 새로운 글이어도 우리 독자와 관련 없으면 의미가 없으니까요. 정치 분석 글이 아무리 잘 쓰여도 AI 큐레이션 피드에는 필요 없는 것처럼요.
결정 2: 언제 소스를 끌까? 언제 새 소스를 찾을까?
단일 콘텐츠 하나가 낮은 점수를 받았다고 소스를 꺼버리면 안 돼요.
좋은 소스도 가끔 별로인 글을 올리니까요.
해결: 소스 레벨 평균, 최소 20개 샘플
┌─────────────────────────────────────────────────────┐
│              소스 품질 판단 기준                       │
├─────────────────────────────────────────────────────┤
│                                                     │
│  소스별 평균 = 최근 채점된 콘텐츠 20개 이상의 평균       │
│                                                     │
│  평균 < 4점  →  🔴 자동 비활성화                       │
│               "이 소스는 전반적으로 별로"               │
│                                                     │
│  평균 4~7점  →  🟡 유지                              │
│               "보통 수준, 계속 관찰"                   │
│                                                     │
│  평균 ≥ 7점  →  🟢 유사 소스 발굴 트리거               │
│               "이 소스처럼 좋은 걸 더 찾자"             │
│                                                     │
└─────────────────────────────────────────────────────┘
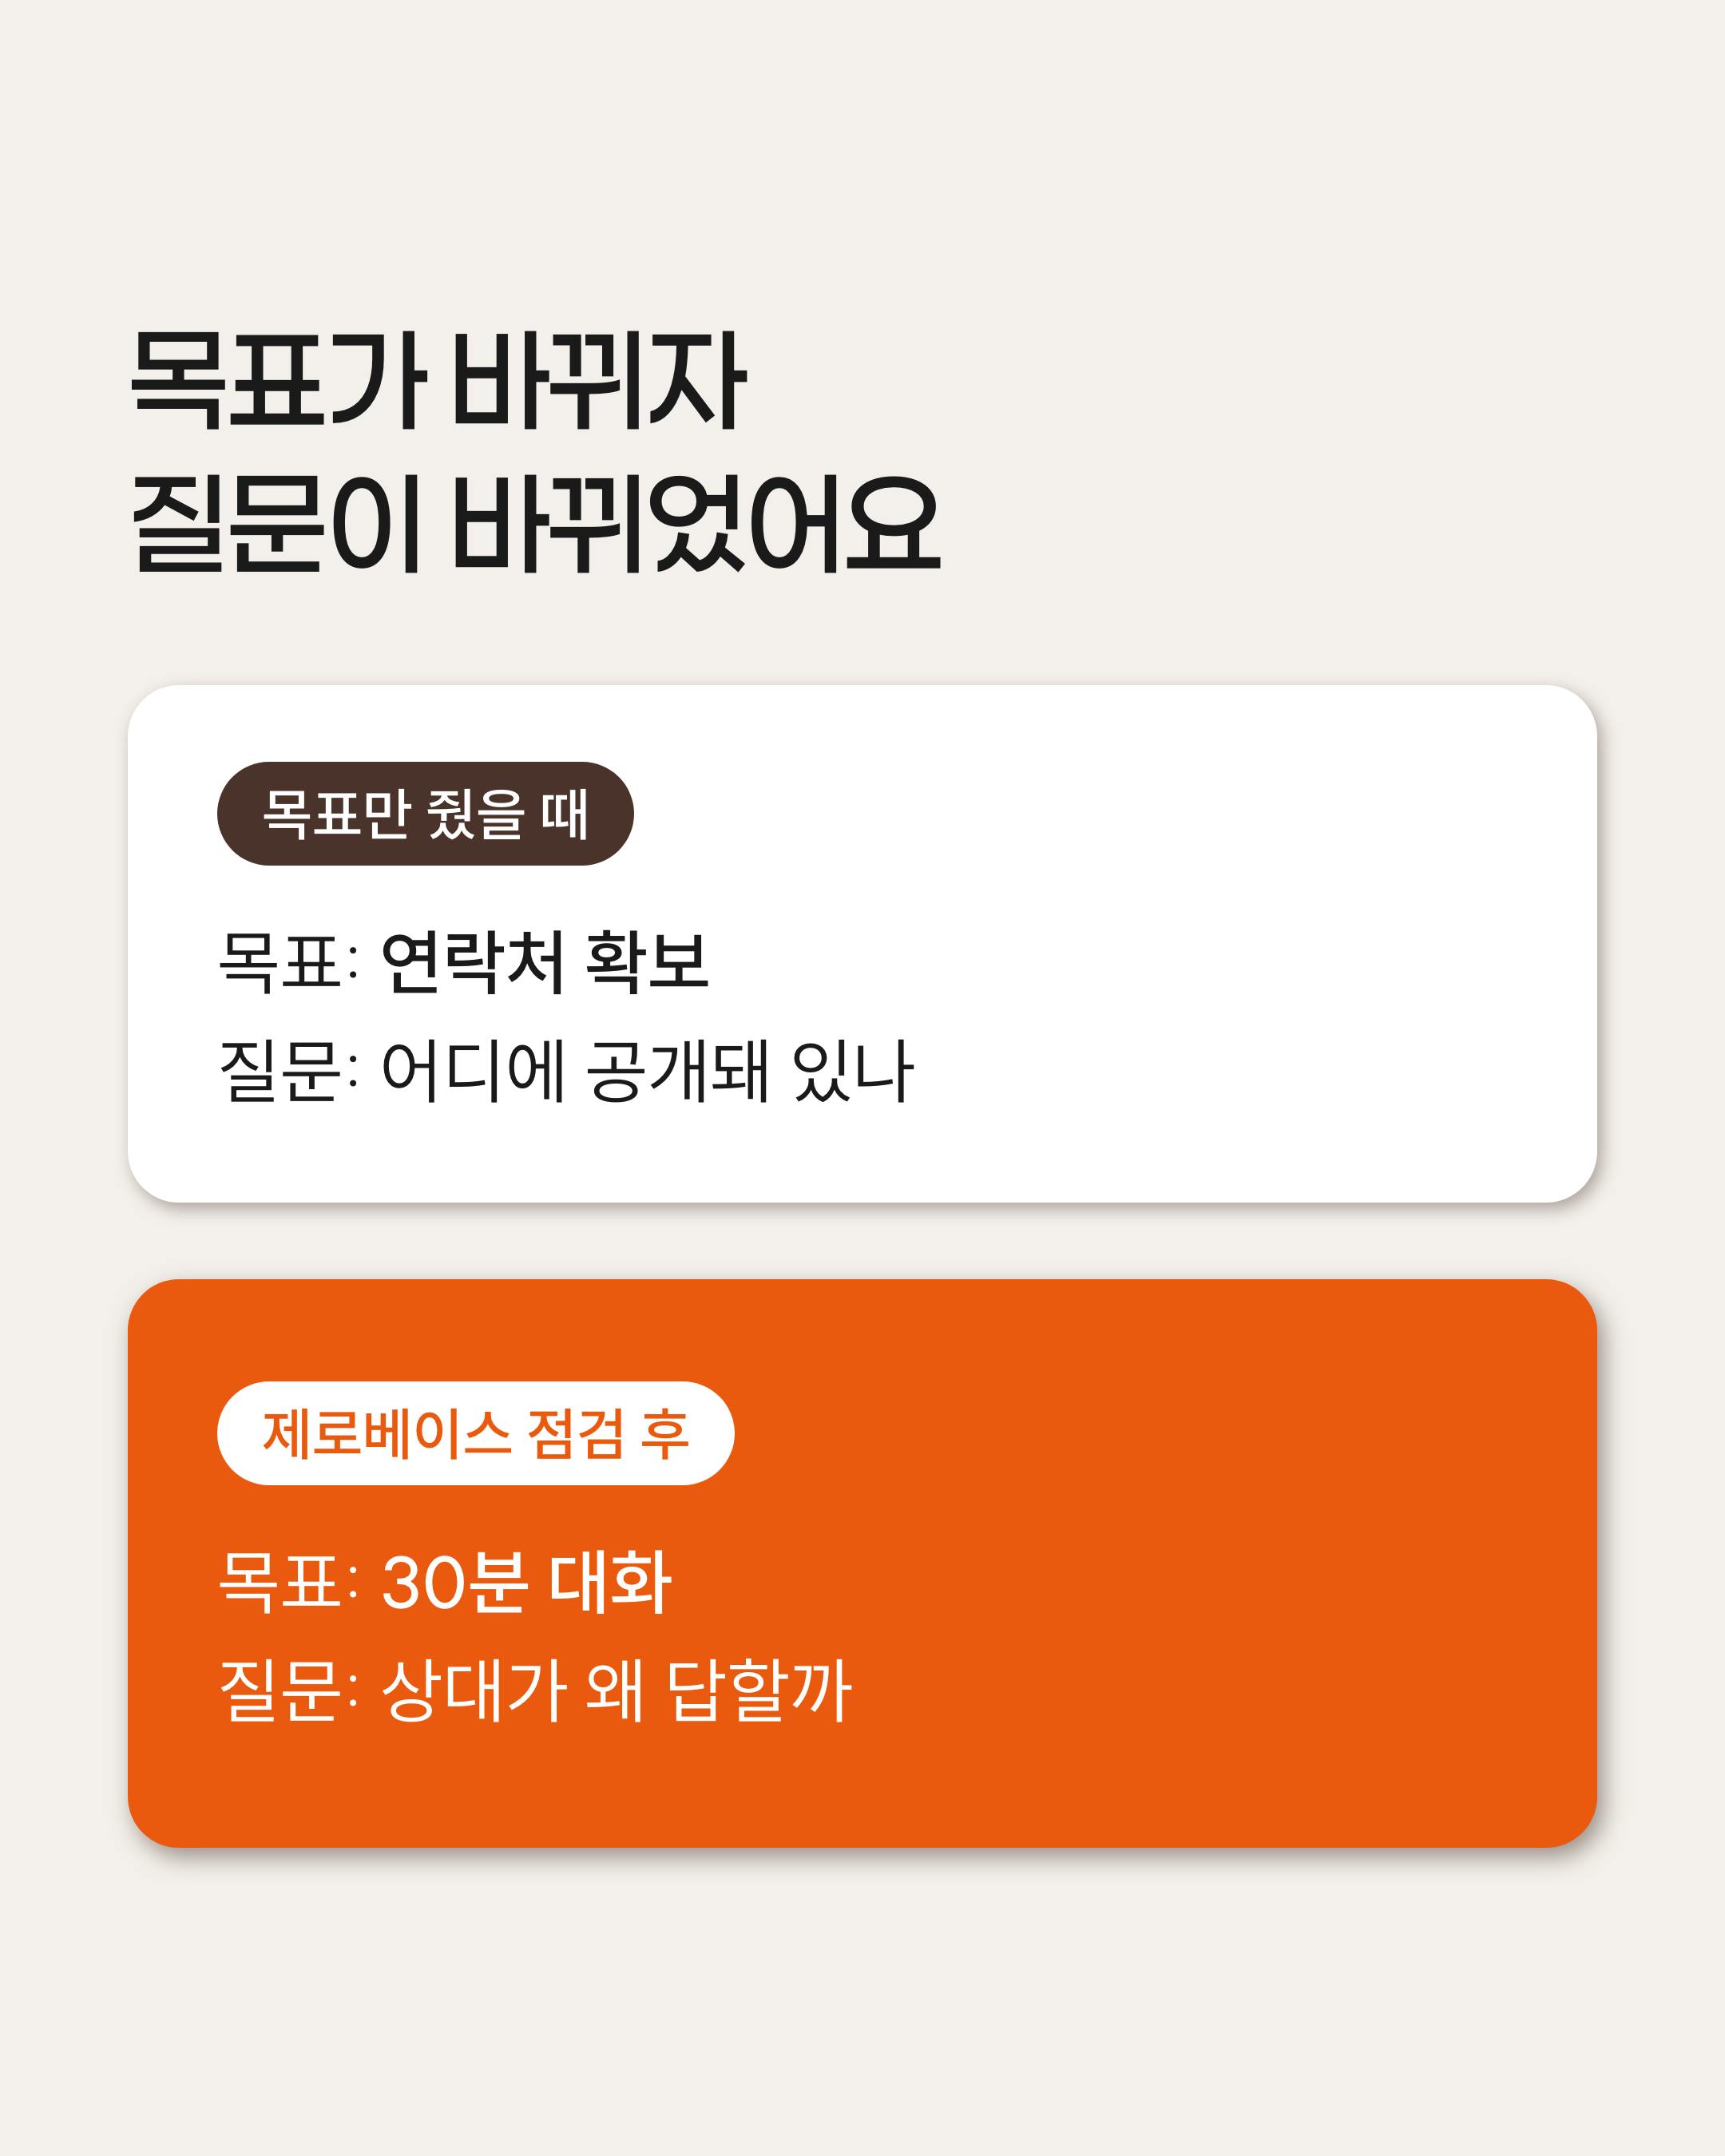
여기서 발굴 트리거가 AutoResearch 패턴의 핵심을 가져온 부분이에요. 단순히 나쁜 걸 끄는 게 아니라, 잘 되는 소스의 DNA를 복제하는 거예요. 평균 7점 이상인 RSS가 있으면 Gemini에게 "이 블로그랑 비슷한 AI/기술 블로그 3개 추천해줘"라고 물어보고, 추천받은 URL을 검증해서 자동으로 등록해요.
결정 3: 만약 채점이 잘못되면?
AutoResearch에서 가장 인상 깊었던 부분이 "잘못된 실험은 롤백한다"는 안전장치였어요.
우리 시스템에서도 같은 걱정이 있었어요. 만약 Gemini의 채점 기준에 버그가 있어서, 모든 소스가 4점 미만으로 나온다면? 소스가 전부 꺼져요. 콘텐츠 수집이 멈춰요. 재앙이에요.
해결: 3중 안전장치
사이클당 최대 3개만 비활성화 — 한 번에 다 꺼지는 일 방지
활성 소스 최소 5개 유지 — 아무리 점수가 낮아도 5개는 보호
20개 미만 샘플이면 판단 보류 — 데이터가 충분하지 않으면 건드리지 않음
구조적으로 전부 꺼지는 일이 불가능하게 만들었어요.
AutoResearch의 "롤백" 정신을 "파괴 방지"로 번역한 거예요.
결정 4: Exploit만으로 충분할까? — Explore의 필요성
여기까지 만들고 나서 한 가지 빈 곳이 보였어요.
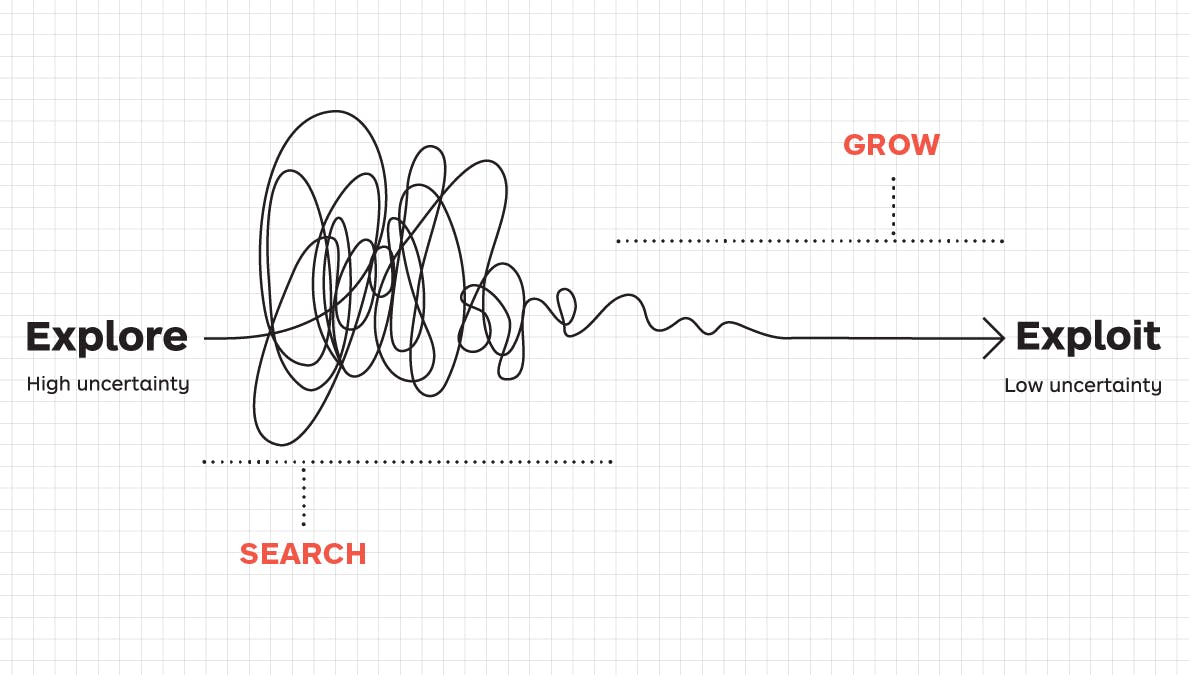
유사 소스 발굴(Exploit)은 이미 좋은 소스와 비슷한 걸 더 찾는 거예요.
7점 이상인 AI 블로그가 있으면 비슷한 AI 블로그를 추천받는 거죠.
그런데 이건 같은 동네에서만 계속 찾는 거예요. AI 코딩 블로그가 좋으면 AI 코딩 블로그만 더 추가되고, 소프트웨어 아키텍처나 제품 관리 같은 다른 시각의 소스는 영원히 발견할 수 없어요.
ML에서 많이 쓰이는 Explore vs Exploit 개념에서 아이디어를 얻었습니다!
Exploit (착취)                    Explore (탐험)
─────────────────────────────────────────────────
잘 되는 걸 더 파고듦              완전히 새로운 곳을 찾아감
리스크 낮음, 개선폭 작음          리스크 높음, 발견 가치 큼
"좋은 AI 블로그 옆에 더 좋은      "소프트웨어 아키텍처 블로그에서
 AI 블로그가 있을 거야"            의외의 AI 인사이트가 나올 수도"
AutoResearch 패턴에도 이 개념이 있어요. 기존 방향을 개선하는 것(Exploit)만으로는 국소 최적해에 갇힐 수 있어요. 가끔은 전혀 다른 방향을 시도해봐야(Explore) 진짜 좋은 소스를 발견할 수 있어요.
해결: 주 1회 월요일에만 탐험
Explore는 Exploit보다 리스크가 높아요. 추천받은 소스가 전혀 쓸모없을 수도 있으니까요. 그래서 매주 월요일에만, 최대 2개까지 실험적으로 추가하게 했어요.
Explore 규칙:
├─ 실행 빈도: 주 1회 (월요일만)
├─ 추가 상한: 사이클당 최대 2개
├─ 진입 등급: 최하위 tier 'C'로 시작
└─ 평가 방식: 콘텐츠 20개 쌓이면 기존 채점 루프로 자동 평가
Gemini에게 "현재 구독 중인 소스 목록을 줄 테니, 이 목록에 없는 완전히 새로운 분야의 AI/기술 RSS를 추천해줘"라고 물어봐요. 핵심은 기존과 겹치지 않는 새로운 영역을 찾는 거예요. 추천받은 URL을 검증해서 RSS가 실제로 작동하면 tier 'C'로 등록해요. 이후에는 기존 채점 루프가 알아서 평가하고, 점수가 좋으면 살아남고 나쁘면 자연스럽게 비활성화돼요.
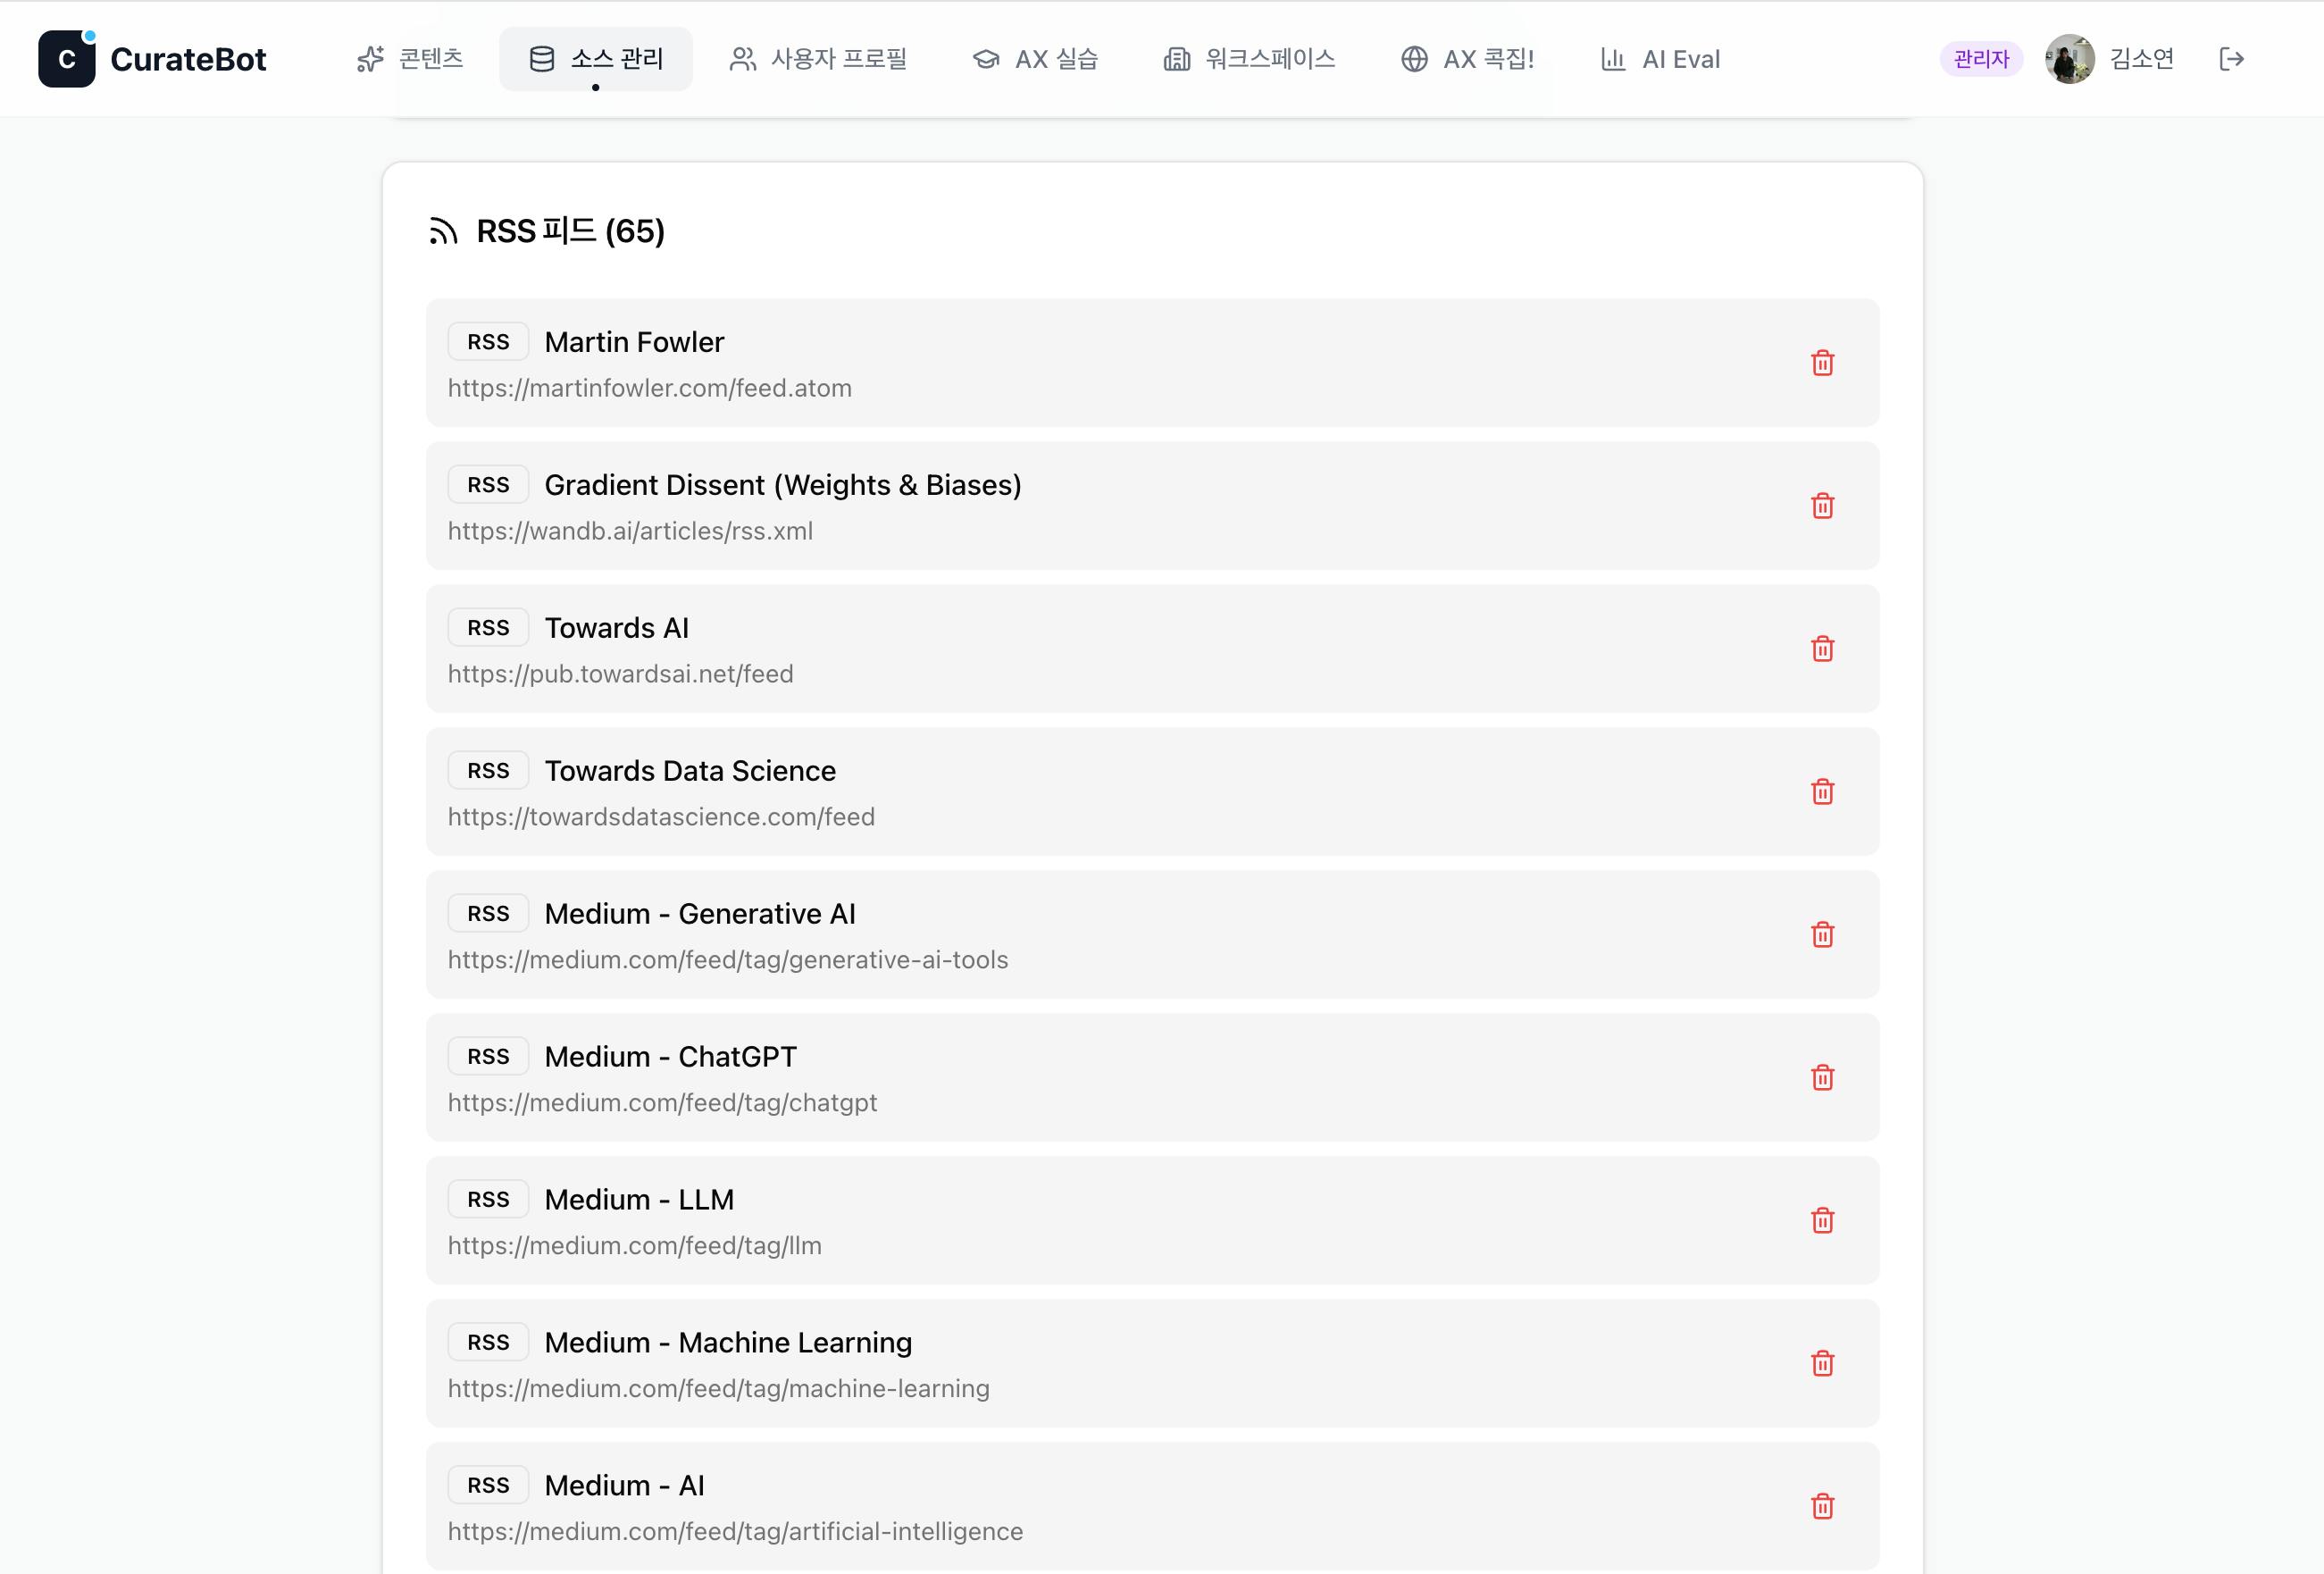
첫 Explore 테스트 결과: Gradient Dissent(Weights & Biases의 ML 블로그)와 Martin Fowler(소프트웨어 아키텍처 블로그)가 추가됐어요. 기존에 순수 AI 블로그 위주였는데, ML Ops 관점과 아키텍처 관점이 들어온 거예요. 이런 소스에서 나오는 콘텐츠가 오히려 더 깊이 있는 인사이트를 줄 수도 있어요.
결과: 매일 새벽 3시, 봇이 알아서 돌아간다
이 루프는 매일 새벽 3시에 자동 실행돼요. 왜 3시냐면, 콘텐츠 수집 cron이 6시간마다 돌고 있거든요.
하루 동안 쌓인 콘텐츠가 모두 채점된 상태에서, 다음 날 수집이 시작되기 전에 소스 정리를 끝내는 거예요.
아침에 출근하면 이미 정리된 상태에서 새 콘텐츠가 들어오는 구조예요.
전체 흐름은 이래요:
수집 → Gemini 품질 채점 → 소스별 평균 집계 (매일 03:00)
                                 │
                  ┌──────────────┼──────────────┐
                  ▼              ▼              ▼
           avg < 4:         avg ≥ 7:        매주 월요일:
           비활성화          유사 소스 발굴    새 영역 탐험
           (Exploit-끄기)   (Exploit-복제)   (Explore)
                  │              │              │
                  └──────┬───────┴──────────────┘
                         ▼
                  Slack 리포트 발송
                  (비활성화 + 발굴 + 탐험 결과)
Slack 리포트에는 이런 내용이 담겨요:
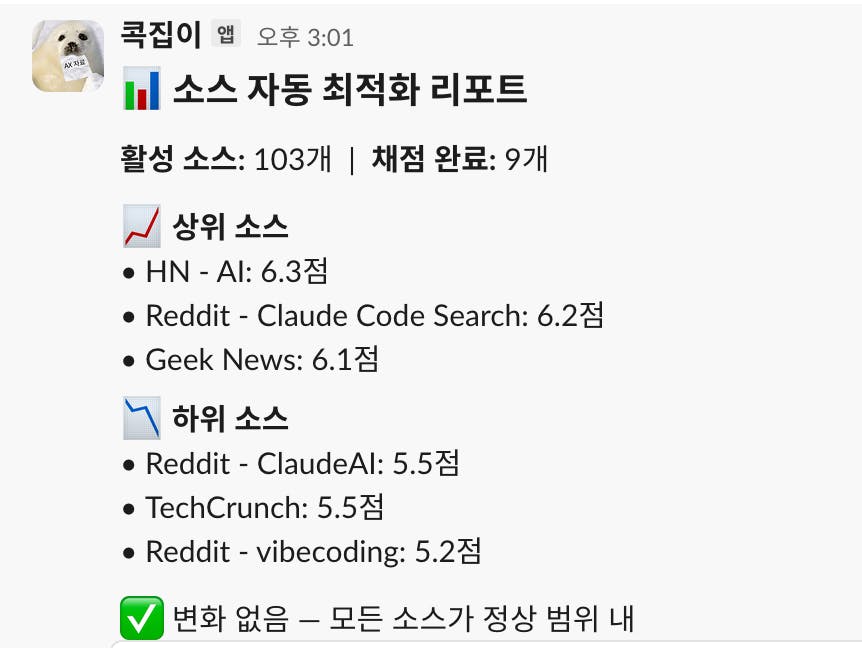
첫 실행
소스 | 평균 | R(관련성) | F(신선도) | D(깊이) |
|---|---|---|---|---|
HN - AI | 6.3 | 6.9 | 5.8 | 5.4 |
Reddit - Claude Code | 6.2 | 6.9 | 5.9 | 5.1 |
Geek News | 6.1 | 6.6 | 5.9 | 5.4 |
TechCrunch | 5.5 | 6.2 | 5.4 | 4.7 |
Reddit - vibecoding | 5.2 | 5.8 | 4.8 | 4.2 |
아직 비활성화 대상(4점 미만)도, 발굴 후보(7점 이상)도 없었어요. 모든 소스가 5~6점대 "보통" 수준이었어요.
하지만 이게 이 시스템이 만족스러운 이유예요. 데이터가 쌓이면 쌓일수록 소스 간 차이가 벌어지면서, 자연스럽게 저품질은 꺼지고 우수 소스 근처에서 새 소스가 발굴돼요. 사람이 개입하지않아도 시간이 지날수록 알아서 좋아지는 구조. 지금은 관찰 단계지만, 2주 후면 소스별로 충분한 데이터가 쌓여서 실제 비활성화와 발굴이 시작될 거예요.
이 경험에서 얻은 가장 큰 인사이트는 이거예요:
AutoResearch 패턴은 "측정 가능한 품질 지표 + 자동 의사결정 규칙"이 있는 모든 곳에 적용할 수 있어요.
마케터고 ML의 원리도 잘 이해하고있는게 아니라 Autoresearch 개념이 어렵게 느껴졌는데 그럴 때 클코를 키고 레포를 함께 들여다보며 차근차근 이해하며 적용해본 점이 좋았습니다!
핵심은 세 가지인듯합니다!
숫자로 잴 수 있는 품질 지표가 있는가
자동으로 실행할 수 있는 액션(끄기, 추가, 수정)이 있는가
잘못되었을 때 복구할 수 있는 안전장치가 있는가
이 세 가지가 있으면, 여러분의 영역에서도 AutoResearch 패턴을 적용할 수 있어 업무 개선에 크게 도움이 될 것 같아요!
로그인하고 댓글을 남겨 주세요
넘 흥미롭게 잘 읽었습니다! 궁금하게 'Explore' 이건 어떻게 동작하는 걸까요? exploit는 좋은 소스에서 계속 콘텐츠를 발굴하는 것이니 직관적인데, explore는 특정 키워드 기반으로 검색해서 소스를 찾고 - 기존에 등록된 소스와 중복되는지 등을 비교하고 이런 로직이 있을텐데
구체적으로 어떻게 알잘딸깍센 하는지 궁금했어요.

Gemini 추천 → 중복제거 → 실존확인 → 시범등록 → 성적순 자동퇴출 순으로 도는데요!
예를 들어 기존 소스에없더라도 웹 서치 중 발견한 링크나 기존 소스에서는 AI 활용 측면을 다뤘다면 아키텍쳐나 모델 자체에 대한 연구와 같은 소스도 가져오는 방식입니다. 좀 더 넓게 소스를 가져오는 !!

Explore에서 발견한 소스가 Exploit 트리거(7점+)까지 올라간 케이스가 생기면 그 전환 비율도 추적하고, 그게 쌓이면 "탐험 주기를 늘릴지 줄일지" 자체도 자동화할 수 있을 것 같아요.
오 아이디어 감사합니다! 바로 적용해볼게요 ㅎㅎ

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
우리 회사에도 이런 자동화를 도입하고 싶다면
회사 업무에 맞춘 AI 교육을 함께 설계해요.
와우 AutoReseach 개념을 정말 효과적으로 적용하셨네요!!
콕집이로 알게된 개념 적용해본거라 뿌듯했습니다 ^-^