


이런 분께
AI에게 검사·검증을 시켰더니 “이상 없습니다”가 나왔는데, 이걸 어디까지 믿어야 하나 싶었던 분
보고서나 공적 문서에 유튜브 인용을 실어야 하는 분
검증 자동화를 만들 때 뭘 같이 만들어야 하는지 궁금한 분
완성된 검증 도구 소개가 아닙니다. 하루 동안 AI와 검증기를 만들어 굴리면서, 결과보다 결과를 믿을 근거를 만드는 데 더 많은 시간을 쓴 기록입니다.
왜 했나
저는 주기적으로 의료에 대한 과한 공포를 조장하거나 오정보가 섞인 유튜브 영상을 모니터링하고 있습니다. 이번에는 그 결과를 실제로 제출할 보고서로 만들어야 했습니다.
문서의 핵심은 “이 영상 몇 분 몇 초에 이런 발언이 나온다”는 인용 목록입니다. 영상 10편, 인용 문장 18개.
이런 문서에서 인용이 하나라도 틀리면 — 그 시각에 그 말이 없거나, 숫자가 다르거나 — 문서 전체의 신뢰가 무너집니다.
그런데 인용의 출처인 유튜브 자동자막에는 전과가 있습니다. 예전 작업에서 발화자가 말한 “800배”가 자막에는 “800가”로 찍혀 있었습니다. 단위가 증발한 겁니다. 자막만 보고 인용을 확정하면, 원문을 문자 그대로 옮겨도 발언과 다른 것을 옮기게 될 수 있습니다.
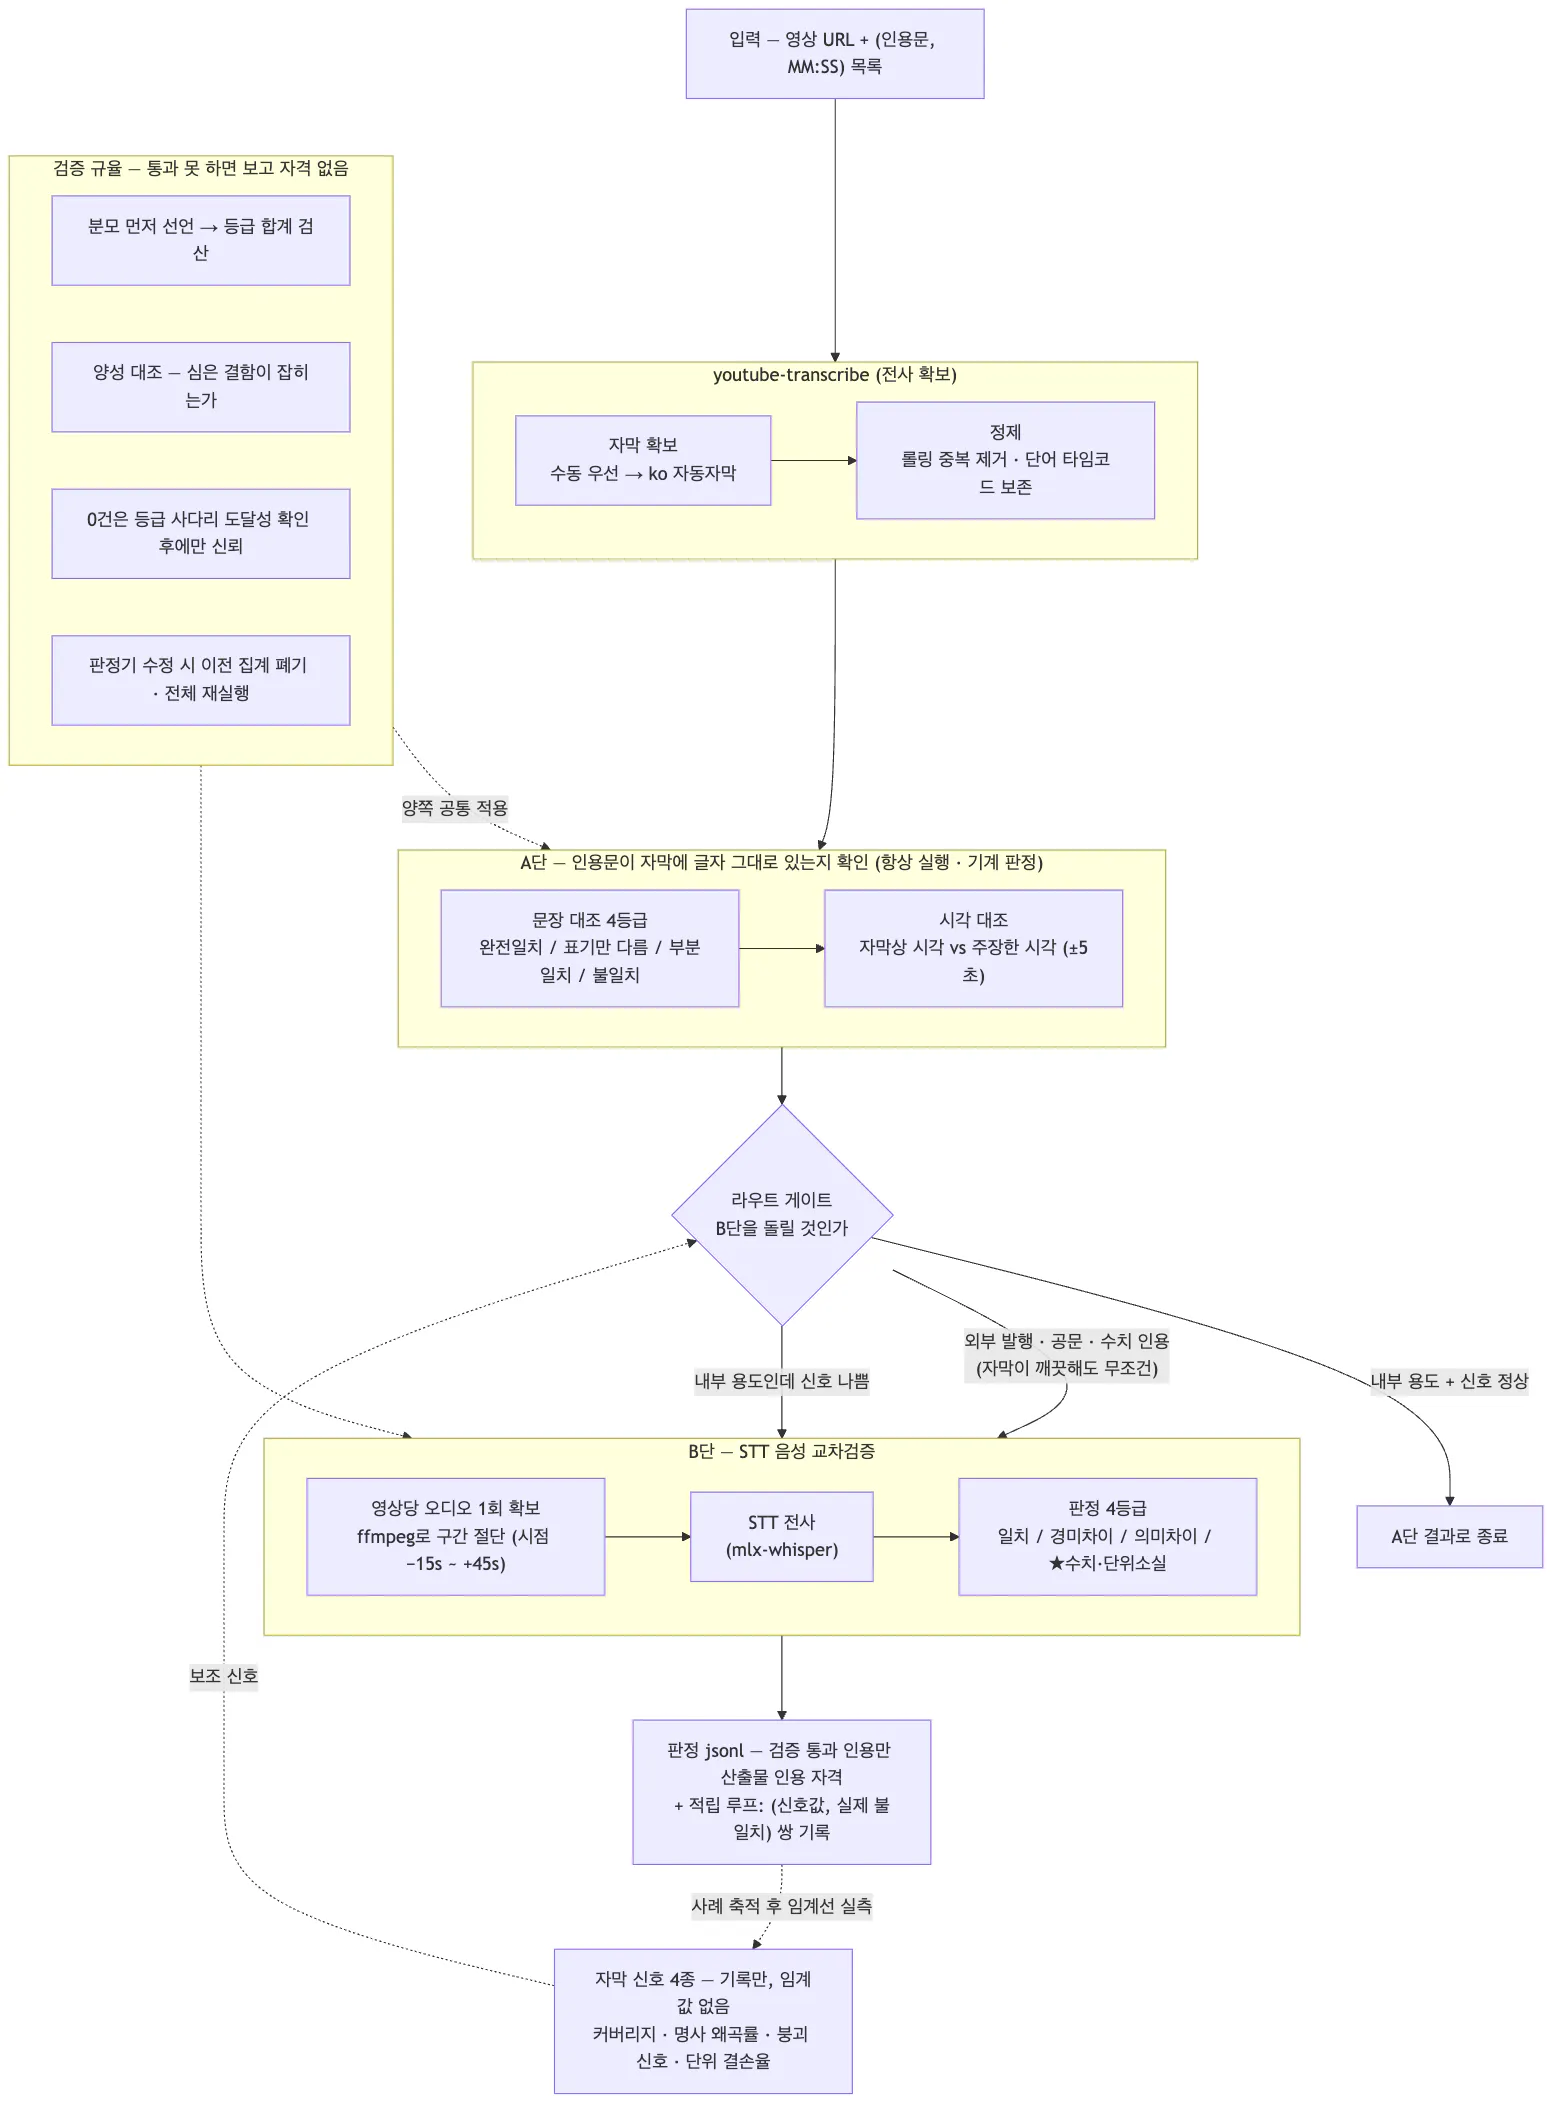
그래서 검증을 두 겹으로 설계했습니다.
1차 — 자막 대조: 인용 문장이 자막에 문자 그대로 존재하는가, 주장한 시각과 자막상 시각이 맞는가
2차 — 음성 대조: 그 구간의 오디오를 음성인식으로 따로 받아써서, 자막이 실제 발화를 정확히 옮겼는가. 특히 숫자와 단위가 보존됐는가
돌렸더니 결과가 나왔습니다. 1차: 18건 전부 자막에 존재, 시각 오차 최대 0.9초. 2차: 18건 전부 음성과 일치, 숫자·단위 소실 0건.
전부 통과. 문제 0건.
0건이 제일 무섭습니다
여기서 이 글의 주제가 시작됩니다. “문제 0건”은 두 가지 경우에 나옵니다. 정말 문제가 없거나, 검출기가 고장 나서 아무것도 못 잡거나. 결과 화면만 봐서는 이 둘을 구분할 수 없습니다. 고장 난 금속탐지기도 조용합니다.
그래서 0건을 보고하기 전에 장치 세 개를 통과시켰습니다.
첫째, 결함을 일부러 심었습니다. 멀쩡한 인용 하나를 골라 원문을 “어느 자막에도 없는 문장”으로 바꿔치기한 가짜 행을 검증기에 몰래 넣었습니다. 검증기가 이걸 “불일치”로 잡아내는지 봅니다. 잡았습니다. 심은 행은 집계에서 빼되 기록에는 “심은 것”이라고 표시해 남깁니다 — 나중에 누가 봐도 검증기가 그날 작동했다는 증거가 되도록.
둘째, 판정 등급이 전부 살아 있는지 확인했습니다. 검증기의 판정은 “완전일치 / 표기만 다름 / 부분일치 / 불일치” 네 단계인데, 결과에는 완전일치만 나왔습니다. 나머지 세 등급이 0건인 게 “그 등급으로 가는 길이 코드에서 막혀 있어서”일 수도 있습니다. 그래서 실재하는 문장 하나를 단계별로 변형해 — 문장부호만 바꾸고, 뒷부분을 갈아 끼우고, 통째로 다른 문장으로 — 네 등급이 전부 나올 수 있음을 확인했습니다.
셋째, 숫자를 셌습니다. 넣은 게 23건이면 판정 결과의 합계도 23이어야 합니다. 당연해 보이지만, 목록을 처리하는 도구는 항목을 조용히 떨어뜨리고도 성공한 얼굴을 할 수 있습니다. 합계가 맞아야 “빠진 것 없이 다 봤다”가 성립합니다.
판정기를 두 번 버렸습니다
사실 위의 장치들보다 먼저 있었던 일이 있습니다. 2차 검증(음성 대조)의 첫 실행 결과는 0건이 아니라 “숫자·단위 소실 11건”이었습니다. 열여덟 개 중 열한 개가 문제라는 겁니다.
그대로 썼으면 문서 작업이 뒤집혔을 텐데, 검증을 맡은 AI가 보고 전에 열한 개를 먼저 들여다봤는데 — 열 개가 검증기 자신의 결함이었습니다. 검증기는 숫자 뒤의 단위를 넉 자까지 읽게 짜여 있어서, 띄어쓰기를 지운 음성인식 쪽 텍스트에서는 다음 단어까지 삼켜버린 겁니다. “250장”과 “250장이나 찍”을 다른 단위로 판정하는 식입니다. 소수점 처리도 양쪽이 달라서 “2.8배”와 “28배”를 다르다고 우겼습니다.
고쳐서 다시 돌렸더니 이번엔 “소실 6건”. 이것도 전부 오탐이었습니다. 이번에는 반대 방향 검사 — 음성에는 있는데 자막에 없는 숫자를 찾는 부분 — 가 구간을 너무 넓게 잡아서, 옆 문장의 숫자가 딸려 들어온 거였습니다.
여기서 지킨 규칙이 하나 있습니다. 판정기를 고치면 이전 집계는 버리고 처음부터 다시 돌립니다. 틀린 자로 잰 값을 부분적으로 살려 쓰기 시작하면, 최종 결과가 어느 자로 잰 것인지 아무도 말할 수 없게 됩니다. 세 번째 실행에서야 “소실 0건”이 나왔고, 이 0건은 위의 장치들 — 심은 결함, 등급 생존, 합계 — 을 통과한 뒤에야 보고서에 올릴수 있었습니다.
기계가 못 보는 것은 사람이 봤습니다
축자 검증(逐字 — 뜻이 아니라 글자 그대로 일치하는지 보는 검증)이 끝났다고 판단이 끝난 게 아닙니다. 이번 작업에서 기계가 원리적으로 못 보는 것이 두 종류 있었습니다.
하나는 화면입니다. 자막과 음성은 기계가 봤지만, 한 영상에서 발화자가 입은 가운의 이름 글씨가 이상하게 뒤틀려 있는 것 — 생성형 AI로 만든 영상 특유의 문자 붕괴 — 은 영상을 직접 열어본 사람의 눈이 잡았습니다. 이 관찰은 “화자가 실존 의료인인가”라는 판단의 근거가 됐습니다.
다른 하나는 해석입니다. 어떤 영상에 “전화해서 예약하세요”라는 발화가 두 번 나옵니다. 이게 특정 의료 기관으로 유인하는 것인지, 일반적인 검진 권유인지는 자막만으로 갈리지 않습니다. 화면과 설명란에 기관명이 나오는지 제가 확인했고(없었습니다), 문서에는 “단정할 근거 부족”으로 적었습니다.
역할이 명확해집니다. 기계는 “이 말이 그 시각에 실제로 나왔다”를 보증하고, 사람은 그 말이 실제로 무엇을 의미하는지 판정합니다. 이 경계를 반대로 넘기면 — 기계에게 판정을 시키거나 사람에게 축자 대조를 시키면 — 양쪽 다 못하는 일을 하게 됩니다.
요약 — 0건 보고를 받으면 물어볼 것
심은 결함을 잡는가? — 일부러 틀린 것 하나를 넣었을 때 검출기가 우는지. 운 적이 없는 검출기의 0건은 정보가 아닙니다.
모든 판정 등급이 도달 가능한가? — “문제”로 가는 길이 막혀 있으면 영원히 0건입니다.
합계가 분모와 맞는가? — 넣은 개수와 판정된 개수가 다르면, 그 차이만큼이 조용히 사라진 겁니다.
이 세 가지에 답할 수 없는 “이상 없음”은, 아직 검증이 안 끝난 상태의 다른 이름입니다.
아직 못 한 것
이 절차를 정리한 도구는 이번 한 번 실전을 돌았을 뿐입니다. 다음 사람이 절차 문서만 보고 같은 검증을 재현할 수 있는지는 확인 전입니다.
“자막 품질이 나쁘면 음성 대조로 넘어간다”의 판단 기준을 숫자로 정하지 않았습니다. 근거가 될 불일치 사례가 아직 0건이라, 선을 긋는 대신 사례가 쌓일 때까지 기록만 하기로 했습니다. 임계값이 필요해 보일 때 그 숫자의 출처를 못 대면, 그건 기준이 아니라 짐작입니다.
아래는 현재 유튜브 스킬의 구조를 머메이드로 도식화한 것입니다.
비즈니스 프로세스의 흐름도
