위키에 '검수 라인'을 깔다 — 1인 운영으로 바꾸며 AI 하네스 검증 끌어올리기 (2편)
2026.08.11
시도하고자 했던 것과 그 이유
1편에서 팀 위키에 검색 레이어(gbrain)를 얹는 도입 제안까지 정리했습니다. 이번 주에는 두 가지가 겹쳤습니다.
하나는 1편에서 예고한 숙제 — "남의 벤치마크는 인용하되, 내 데이터로 재는 계획을 반드시 붙인다"고 했으니 실제로 재야 했습니다.
다른 하나는 더 큰 변화입니다. 개발 속도를 올리기 위해 기획 문서를 1인 작성·관리 체제로 전환했습니다. 그동안 위키에는 팀 합의 절차가 배어 있었습니다 — 모든 결정에 "1차 결정 · 팀 확정 대기" 라벨을 붙이고, 회의 합의 후에만 '확정'으로 승격하고, 문서마다 상태 표(확정/대기/미정)를 유지하는 식이죠. 결정을 밖에서 혼자 진행하게 되면 이 절차는 관리 비용만 남습니다. 그래서 걷어냈습니다.
그런데 절차를 걷어내는 순간 질문이 하나 생깁니다. 사람 리뷰어(팀 회의)가 사라졌는데, 누가 내 문서의 오류를 잡아주나?
답은 AI 하네스뿐입니다. 하네스(harness)는 "규칙 + 게이트로 결과물의 편차를 통제하는 장치"라는 뜻으로, 에이전트 운영 자료에서 빌려온 어휘입니다. 이번 글은 절차를 줄이면서 검증은 오히려 끌어올린 하루의 기록입니다. 그리고 하루를 마치고 보니 더 큰 교훈이 하나 남았습니다 — 같은 하네스 도구라도 어떤 도메인에 얹느냐에 따라 체감 효과가 완전히 갈린다는 것. 이 얘기는 결과 부분에서 따로 정리합니다.
진행 방법
사용 도구: Claude Code(측정·개정·검증), gbrain 0.44(MCP 연결, 도입 완료 상태), pre-commit 훅(Python 검사 스크립트), PowerPoint(제안서 갱신)
1) 1편 추정치를 실측으로 교체 — "1/10"은 실제로 7~10배였다
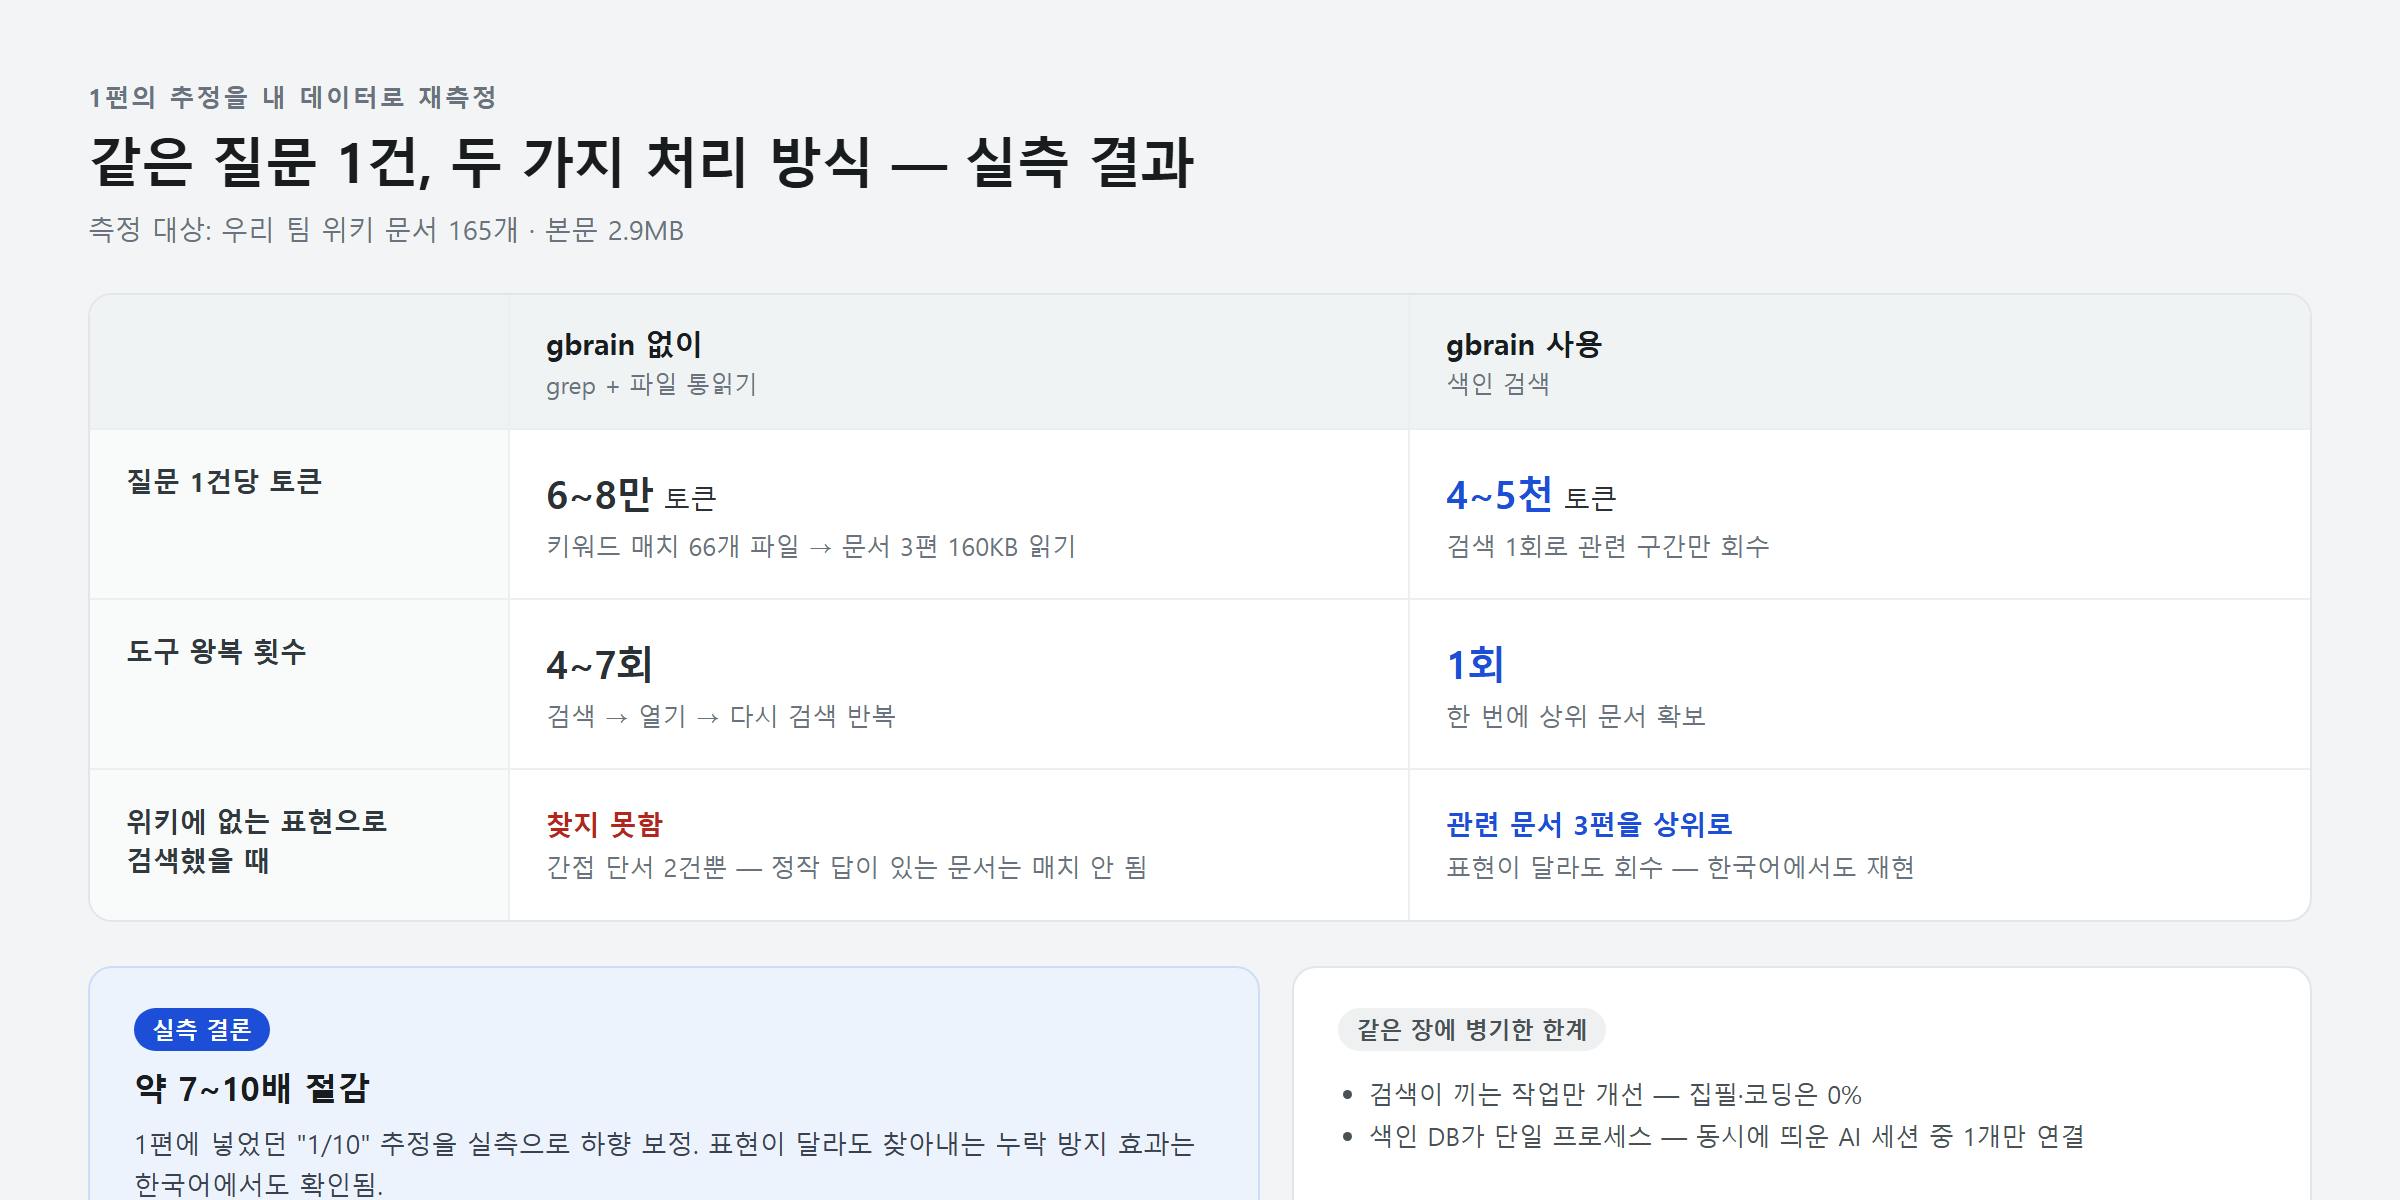
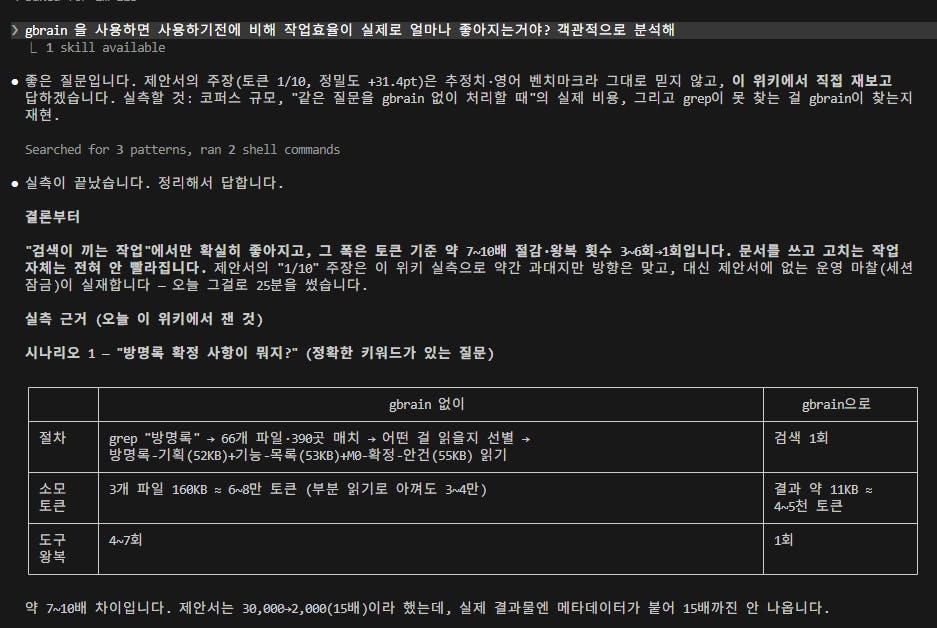
1편 제안서에 넣었던 "질문 1건당 토큰 약 1/10" 추정을 우리 위키(문서 165개, 본문 2.9MB)에서 직접 쟀습니다.
측정 | gbrain 없이 (grep + 파일 읽기) | gbrain (색인 검색) |
|---|---|---|
같은 질문의 처리 비용 | 키워드 매치 66개 파일 → 문서 3편 160KB(6~8만 토큰) 읽기 | 검색 1회 ≈ 4~5천 토큰 |
도구 왕복 | 4~7회 | 1회 |
위키에 없는 표현으로 검색 | 실패 — 간접 단서 2건뿐, 정작 답이 있는 문서는 매치 안 됨 | 관련 문서 3편을 한 번에 상위로 |
결론: 약 7~10배 절감 (1/10 추정보다 약간 낮게 보정), 그리고 표현이 달라도 찾는 "누락 방지"는 한국어에서도 재현됐습니다. 이 실측을 제안서에 "검증 결과 ②" 슬라이드로 추가하면서, 한계도 같은 장에 병기했습니다 — 집필·코딩 작업은 0% 개선(검색이 끼는 작업만 좋아짐), 그리고 색인 DB가 단일 프로세스라 동시에 띄운 AI 세션 중 1개만 연결됩니다.
2) 검증 실패 사례 하나가 규칙이 됐다 — 반증 측정
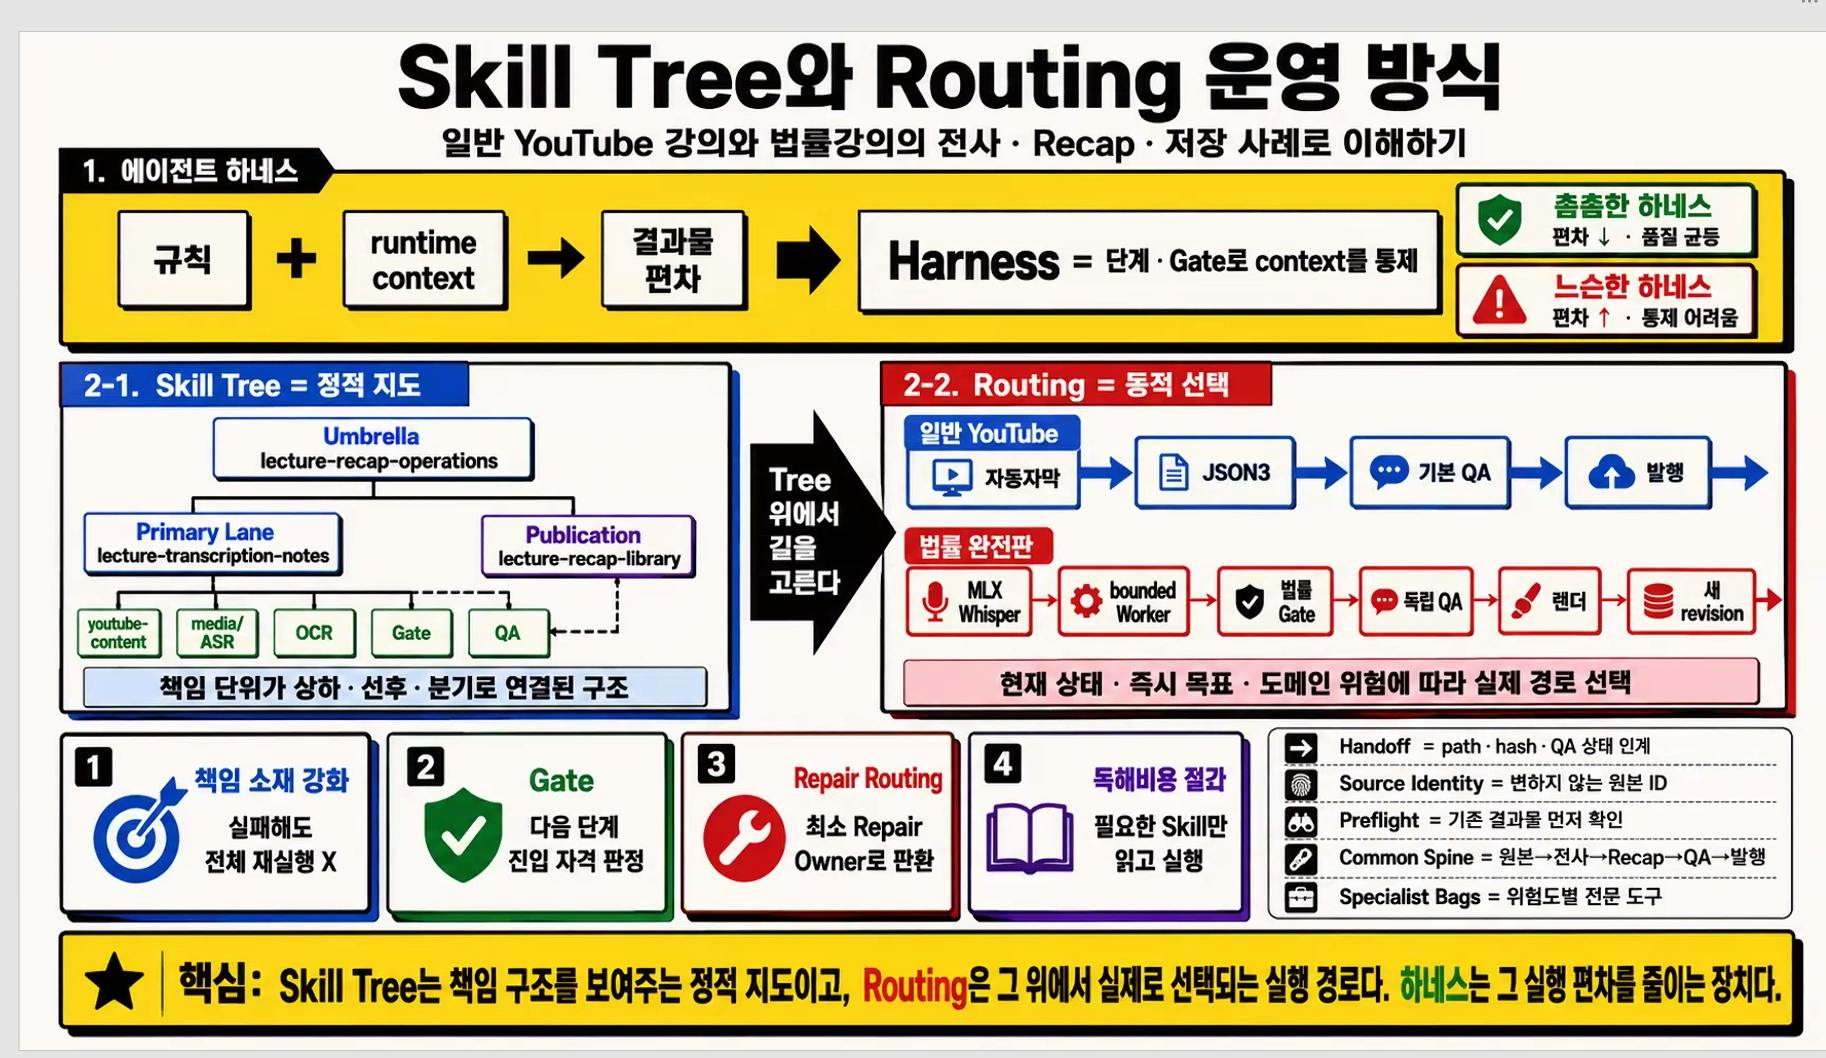
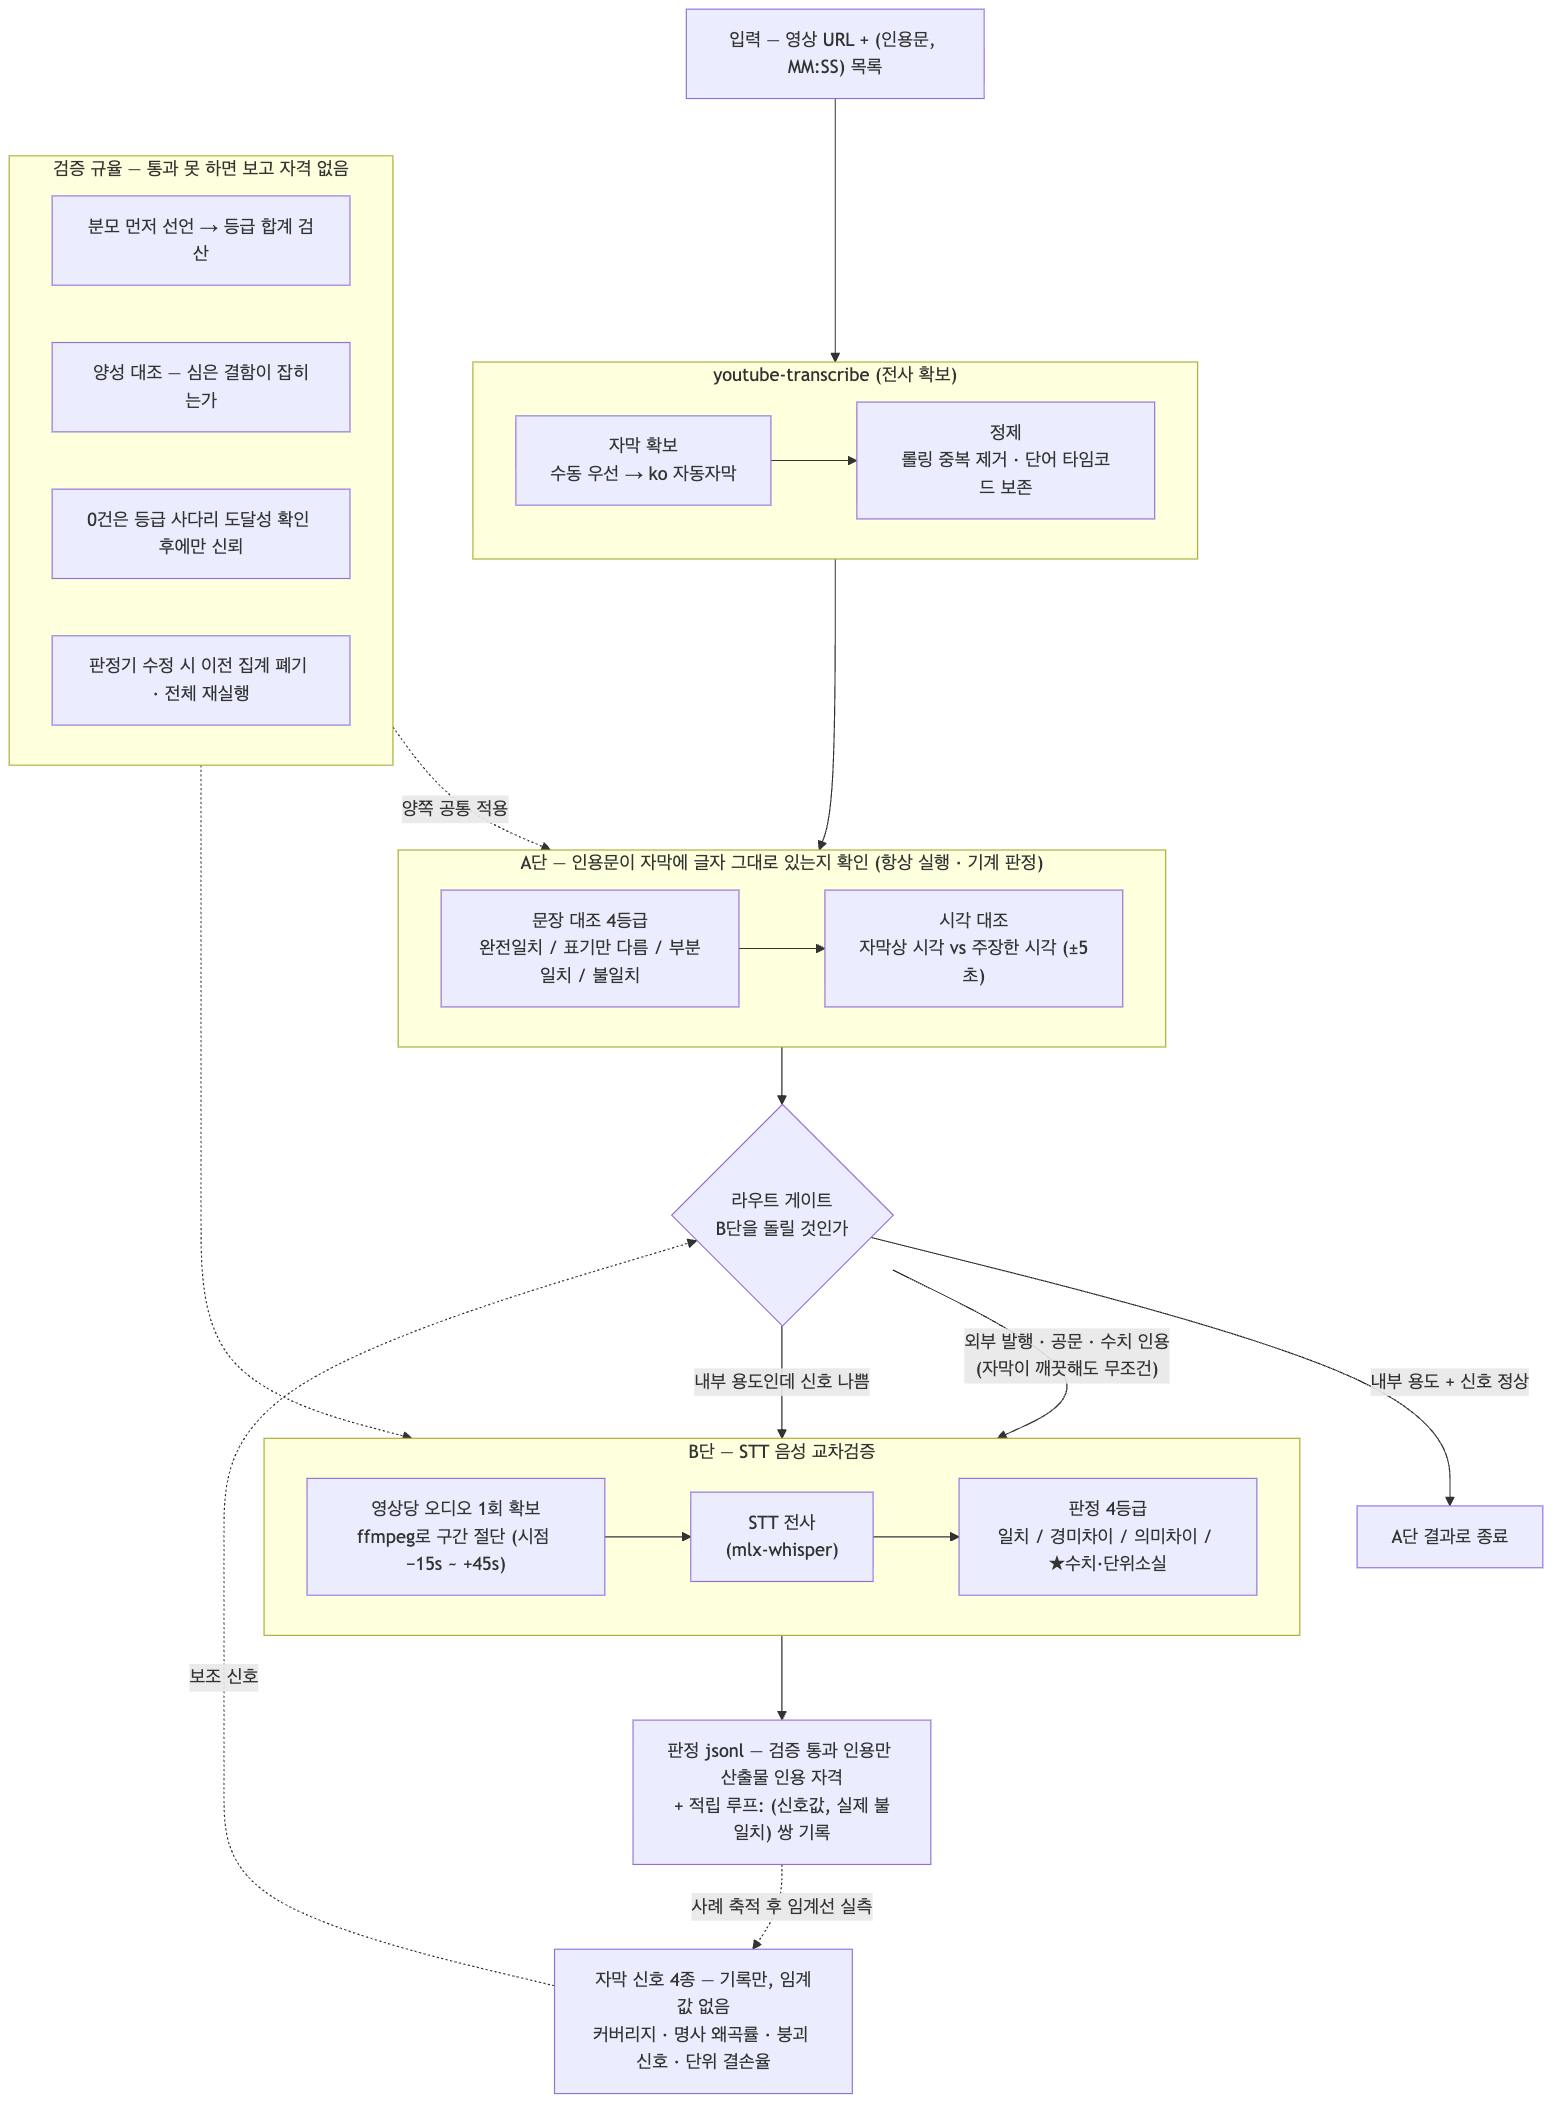
[베스트발표사례 참고이미지] 베스트발표회를 듣고 얼른 적용해본 skill tree 와 routing 운영방식.
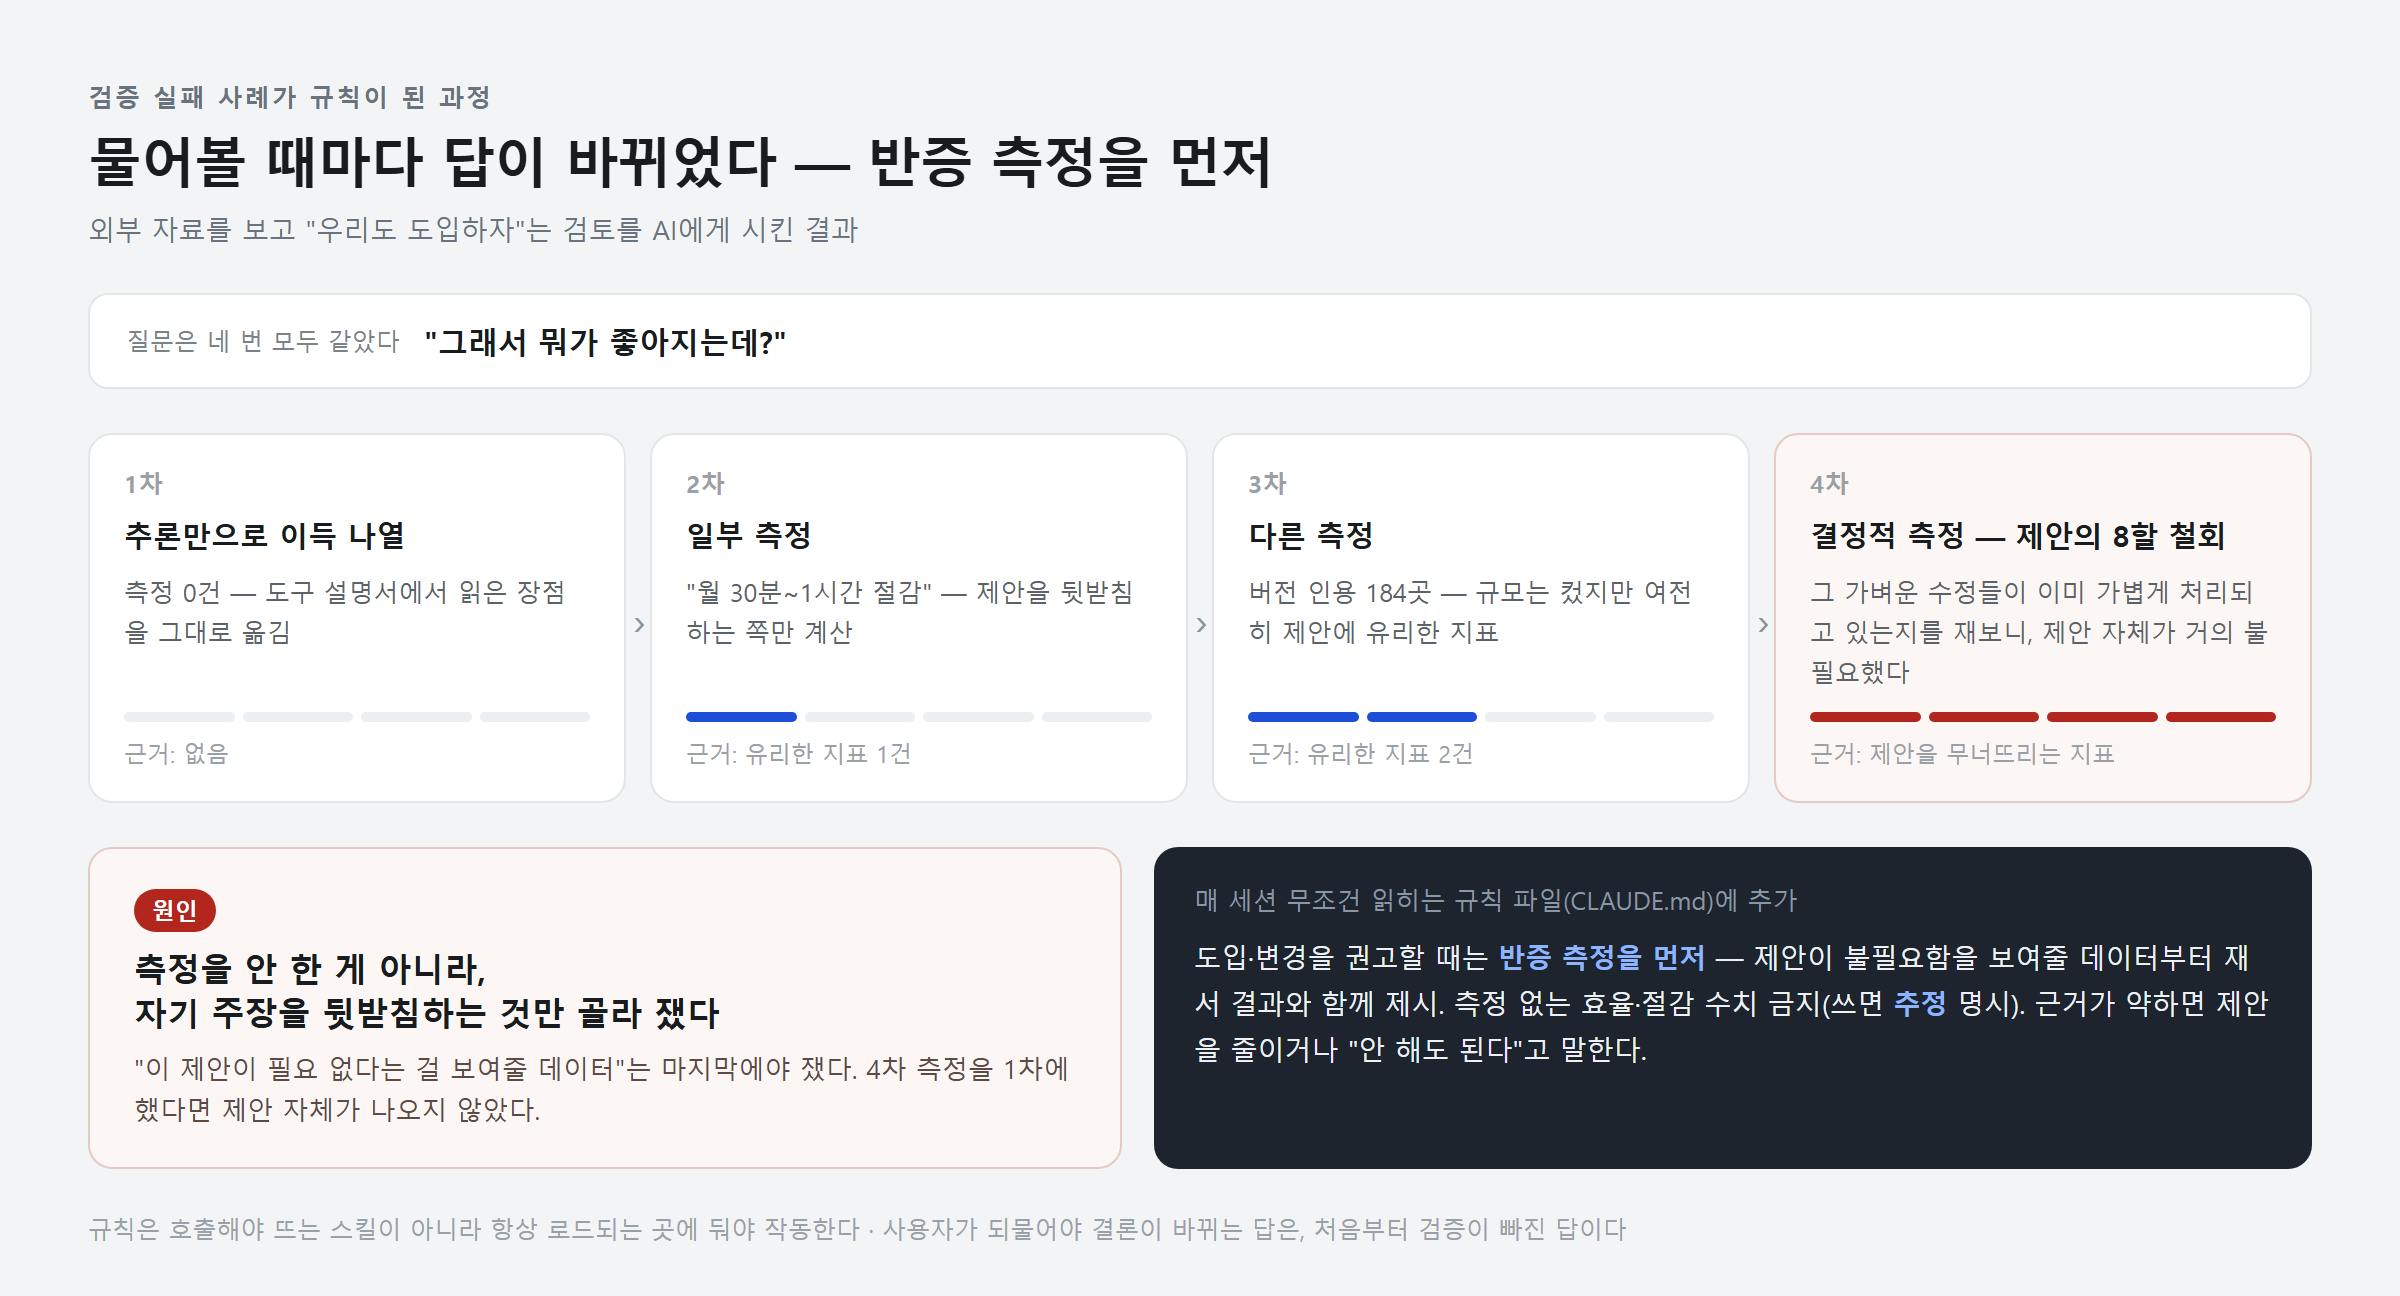
이날 하네스 관련 가장 뼈아픈 배움은 도구가 아니라 제 답변에서 나왔습니다.
에이전트 운영 자료(스킬 트리·라우팅)를 보고 "우리도 도입하자"는 검토를 AI에게 시켰는데, "그래서 뭐가 좋아지는데?"를 물을 때마다 답이 바뀌었습니다. 1차: 추론만으로 이득 나열 → 2차: 일부 측정("월 30분~1시간 절감") → 3차: 다른 측정(버전 인용 184곳) → 4차: 결정적 측정을 그제야 하고 나서 제안의 8할을 철회.
원인을 뜯어보니 측정을 안 한 게 아니라 자기 주장을 뒷받침하는 것만 골라 쟀던 것이었습니다. "이 제안이 필요 없다는 걸 보여줄 데이터"(= 그 가벼운 수정들이 이미 가볍게 처리되고 있는지)는 마지막에야 쟀고, 재보니 제안 자체가 거의 불필요했습니다.
그래서 CLAUDE.md(AI가 매 세션 무조건 읽는 규칙 파일)에 한 줄을 넣었습니다:
도입·변경을 권고할 때는 반증 측정을 먼저 한다 — 제안이 불필요함을
보여줄 데이터부터 재서 결과와 함께 제시. 측정 없는 효율·절감 수치
금지(쓰면 `추정` 명시). 근거가 약하면 제안을 줄이거나 "안 해도
된다"고 말한다.
저희 위키엔 원래 "생성자 ≠ 검증자" 원칙의 문서 검증 스킬이 있었는데 — 이 원칙 자체가 예전에 리서치 도구에서 이식해온 것입니다(뒤의 도메인 비교에서 다시 다룹니다) — 이번엔 그 원칙을 AI 자신의 권고에도 적용한 셈입니다.
3) 1인 운영 전환 — 절차는 폐지, 검증은 격상
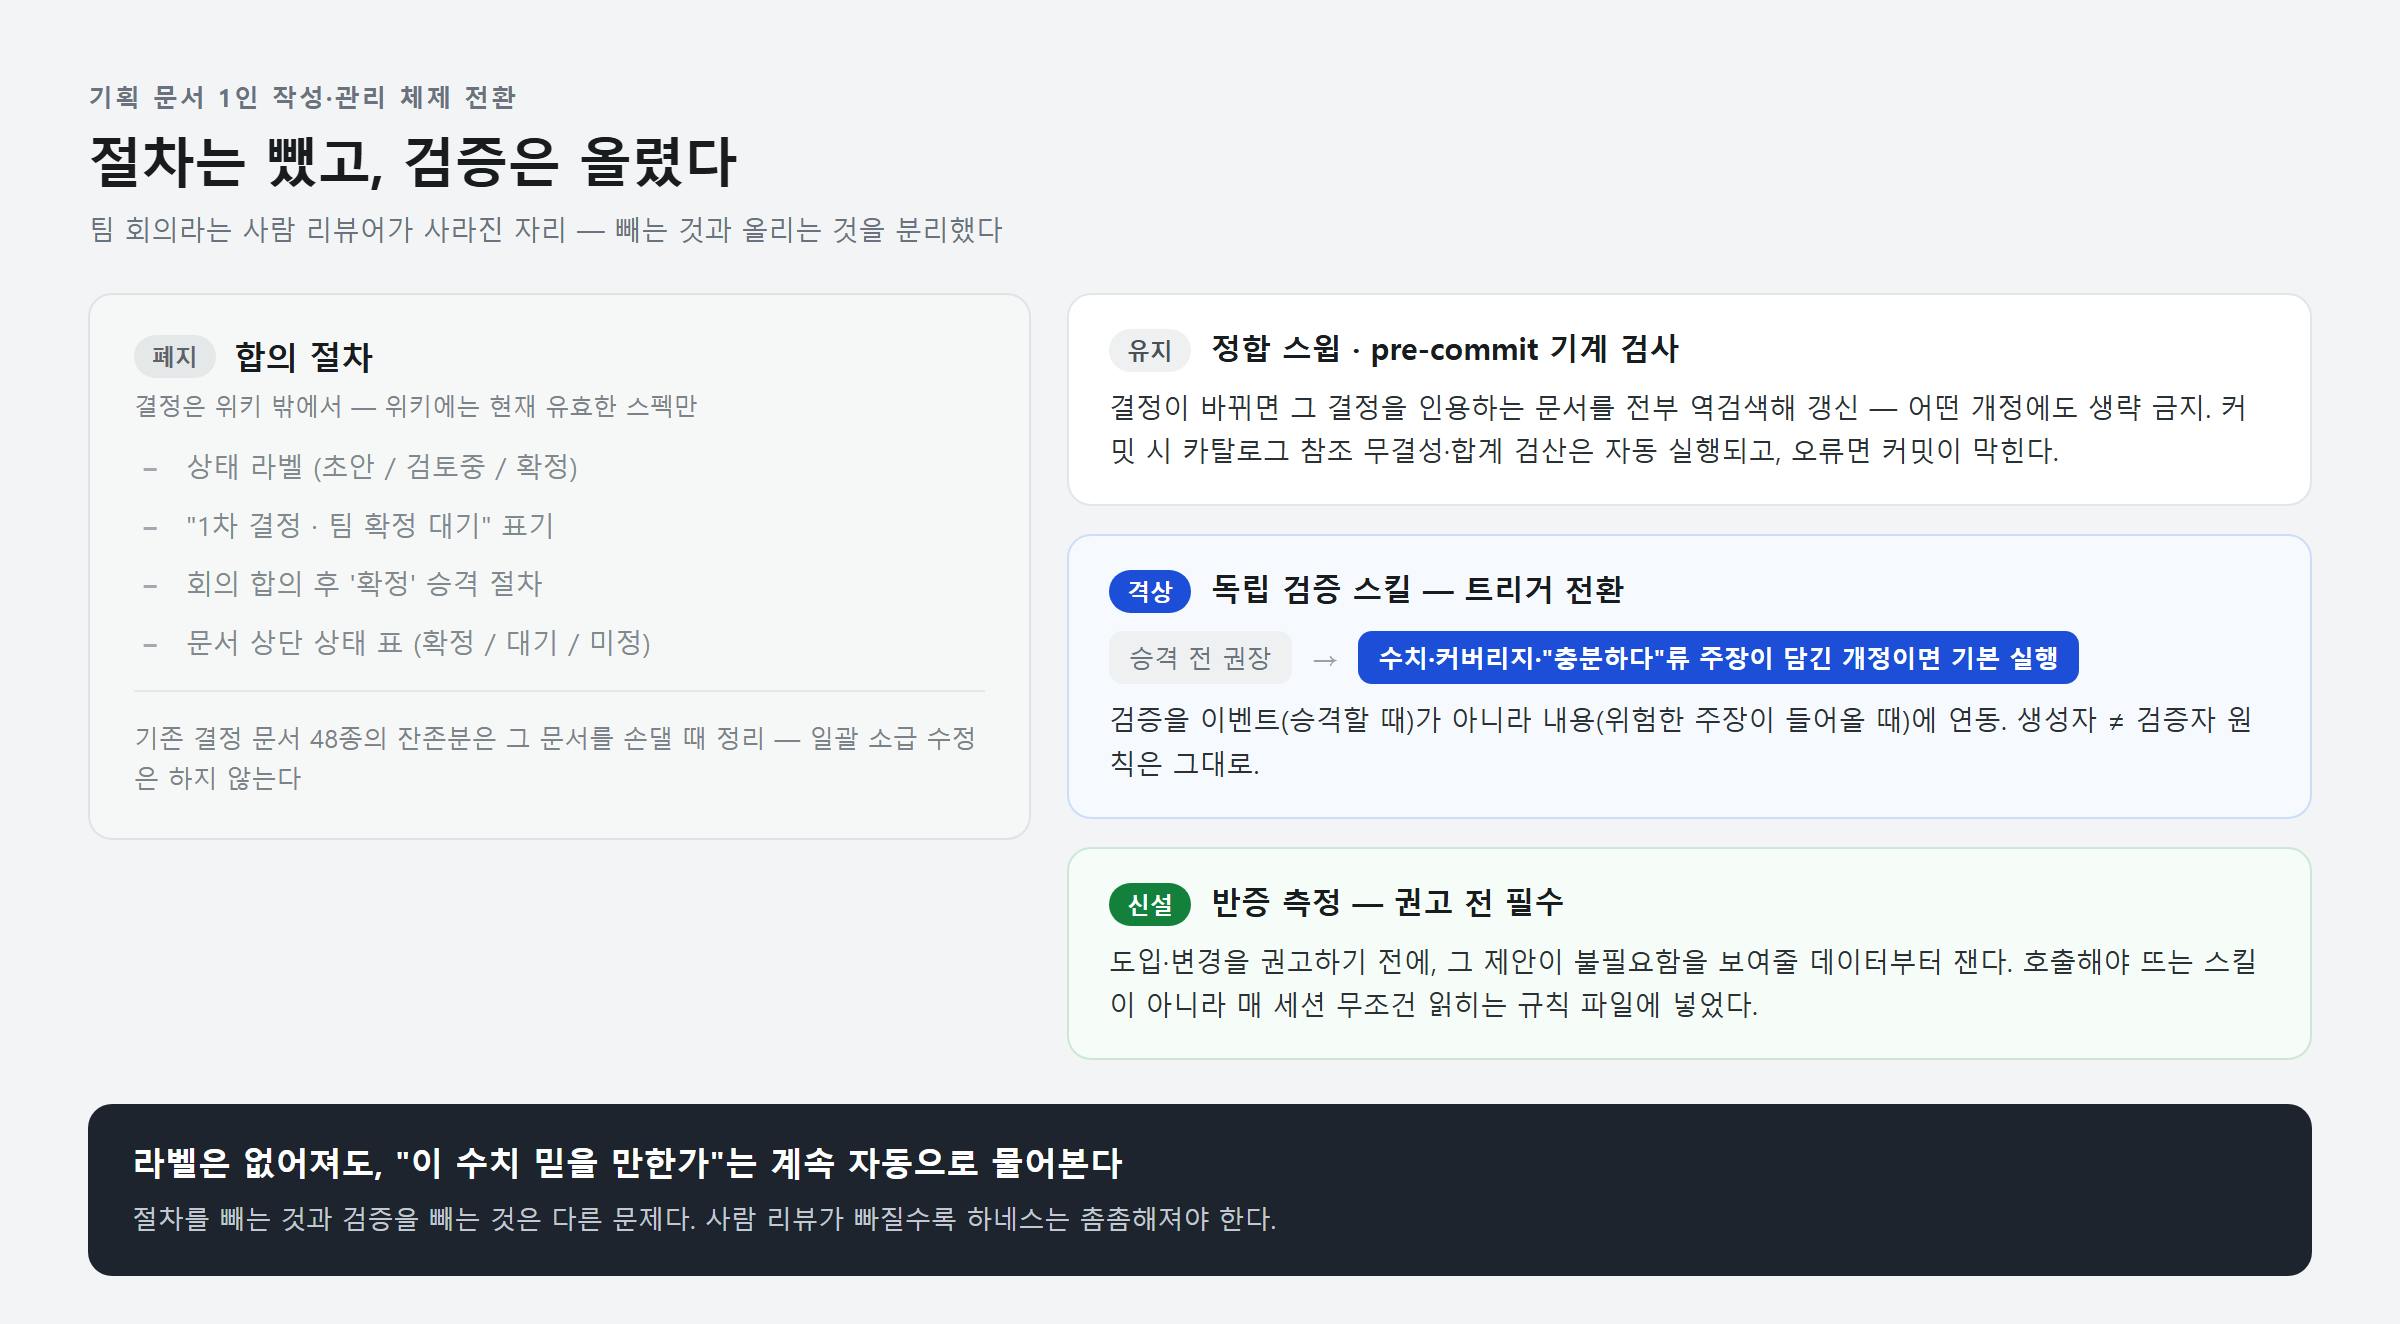
전환의 골자는 "빼는 것"과 "올리는 것"을 분리한 겁니다.
항목 | 처리 | |
|---|---|---|
폐지 | 상태 라벨(초안/검토중/확정) · "팀 확정 대기" 표기 · 승격 절차 · 문서 상단 상태 표 | 결정은 밖에서, 위키는 현재 유효한 스펙만. 기존 문서 잔존분은 손댈 때 정리(일괄 소급 없음 — 결정 문서 48종) |
유지 | 정합 스윕(결정이 바뀌면 인용 문서 전부 역검색·갱신) | 어떤 개정에도 생략 금지 — 문서 간 모순을 잡는 유일한 장치 |
격상 | 독립 검증 스킬 | 트리거를 "승격 전 권장"에서 "수치·커버리지·'충분하다'류 주장이 담긴 개정이면 기본 실행"으로 전환 |
유지 | pre-commit 기계 검사 | 커밋 시 카탈로그 참조 무결성·합계 검산 자동 실행, 오류면 커밋 차단 |
신설 | 반증 측정 (위 2번) | 권고 전 필수 |
검증 트리거 전환이 핵심입니다. 사람 게이트(승격)가 사라졌으니, 검증을 이벤트(승격할 때)가 아니라 내용(위험한 주장이 들어올 때)에 연동시켰습니다. 라벨은 없어져도 "이 수치 믿을 만한가"는 계속 자동으로 물어봅니다.
4) 하네스가 실전에서 일한 날 — push 전 검수가 자동 커밋 3건을 잡다
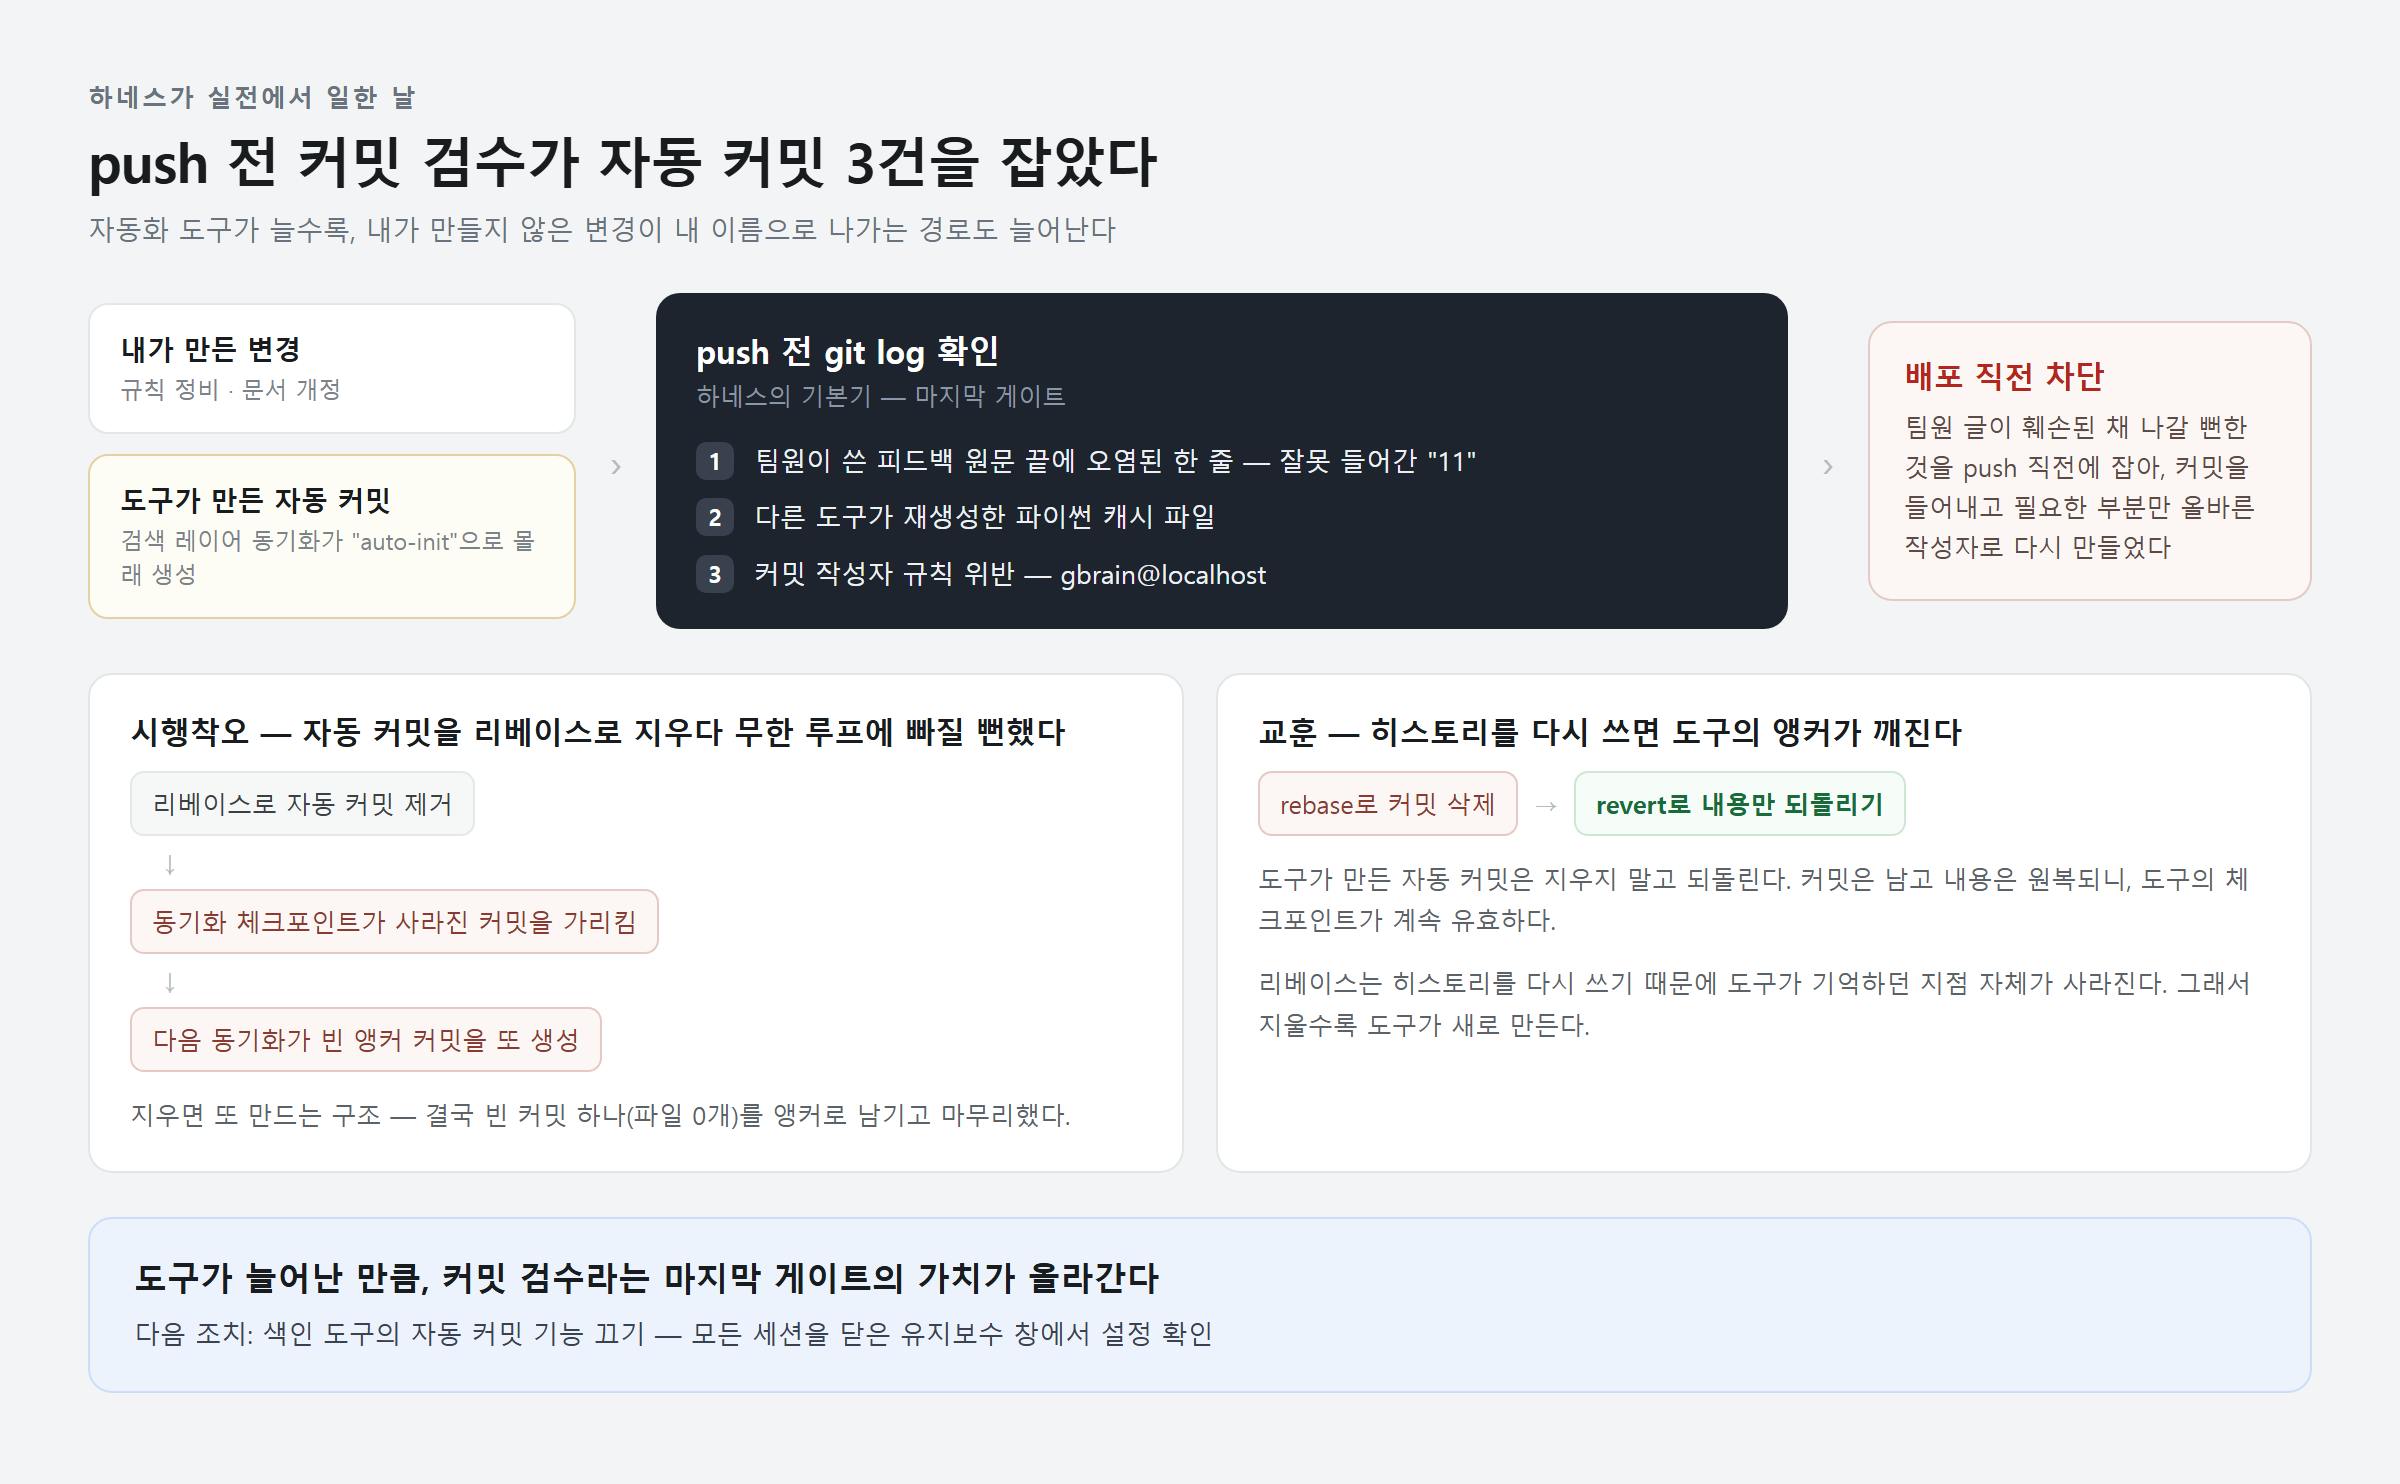
규칙 정비가 끝나고 push하려는 순간, 하네스의 기본기(push 전 git log 확인)가 실제로 일했습니다.
검색 레이어의 동기화 기능이 "auto-init" 커밋을 몰래 만들어 두고 있었습니다. 열어보니: ① 팀원이 쓴 피드백 원문 끝에 오염된 한 줄(잘못 들어간 "11")과 ② 다른 도구가 재생성한 파이썬 캐시 파일을 쓸어 담았고 ③ 커밋 작성자도 규칙 위반(gbrain@localhost)이었습니다. 팀원 글이 훼손된 채 배포될 뻔한 걸 push 직전에 잡아서, 커밋을 들어내고 필요한 부분만 올바른 작성자로 다시 만들었습니다.
이 사건이 시사하는 게 있습니다. 자동화 도구가 늘수록 "커밋 검수"라는 마지막 게이트의 가치가 올라갑니다. 도구가 늘어난 만큼, 내가 만들지 않은 변경이 내 이름으로 나가는 경로도 늘어나기 때문입니다.
5) 색인 위생 — "무제"가 검색에 뜨면 신뢰가 죽는다
고아 문서 조사(들어오는 링크가 없는 페이지 찾기)를 돌렸더니 색인에 "무제", 빈 캔버스 파일, 삭제된 지 오래인 유령 페이지 4건이 들어 있었습니다. 편집기가 만든 빈 파일 5종을 지우고, 규칙 밖 위치에 있던 초안 2건을 개인 폴더로 옮기고, 유령 페이지를 색인에서 제거했습니다. 최종: 121페이지, 임베딩 100%.
검색 레이어를 쓰기 시작하면 파일 시스템의 잡동사니가 곧바로 검색 품질 문제가 됩니다. "무제"가 검색 결과에 한 번 뜨는 순간 도구 전체의 신뢰가 깎입니다.
결과와 배운 점
같은 도구, 다른 체감 — 결국 도메인이 결정한다
이번에 검토한 도구 둘에, 예전에 도입했던 리서치 도구까지 나란히 놓고 보면 셋의 운명이 전부 달랐습니다. 검색 레이어(gbrain)는 통째로 도입해 실측 7~10배가 나왔고, 리서치 도구는 파이프라인은 버리고 원칙만 이식해 지금 검증 하네스의 뼈대가 됐고, 스킬 트리·라우팅은 8할이 과잉이라 규칙 한 줄만 남았습니다. 도구가 좋고 나빠서가 아니라 제 도메인과 도구의 원산지 도메인이 얼마나 겹치느냐가 갈랐습니다.
먼저 제 도메인을 정의해보면 이렇습니다:
산출물: 자연어 결정 문서 수십 편이 서로를 인용하는 그물 — 문서 165개, 문서 간 버전 인용 184곳(39개 문서), 위키링크 1,445개
작업 형태: 반복 파이프라인이 아니라 비정형 대화형 — 최근 30일 커밋 125건 중 같은 모양으로 반복되는 작업(표기 수정류)은 12%뿐, 나머지는 매번 다른 기획 작업
용어가 살아 움직임: 기능 이름이 개칭되고, 같은 개념이 문서마다 다른 표현으로 불림
팀 구조: 1인 + AI — 사람 리뷰어 없음
이 도메인의 병목은 회상(과거 결정·이력 찾기)과 문서 간 정합입니다. 실행 단계의 편차가 아닙니다.
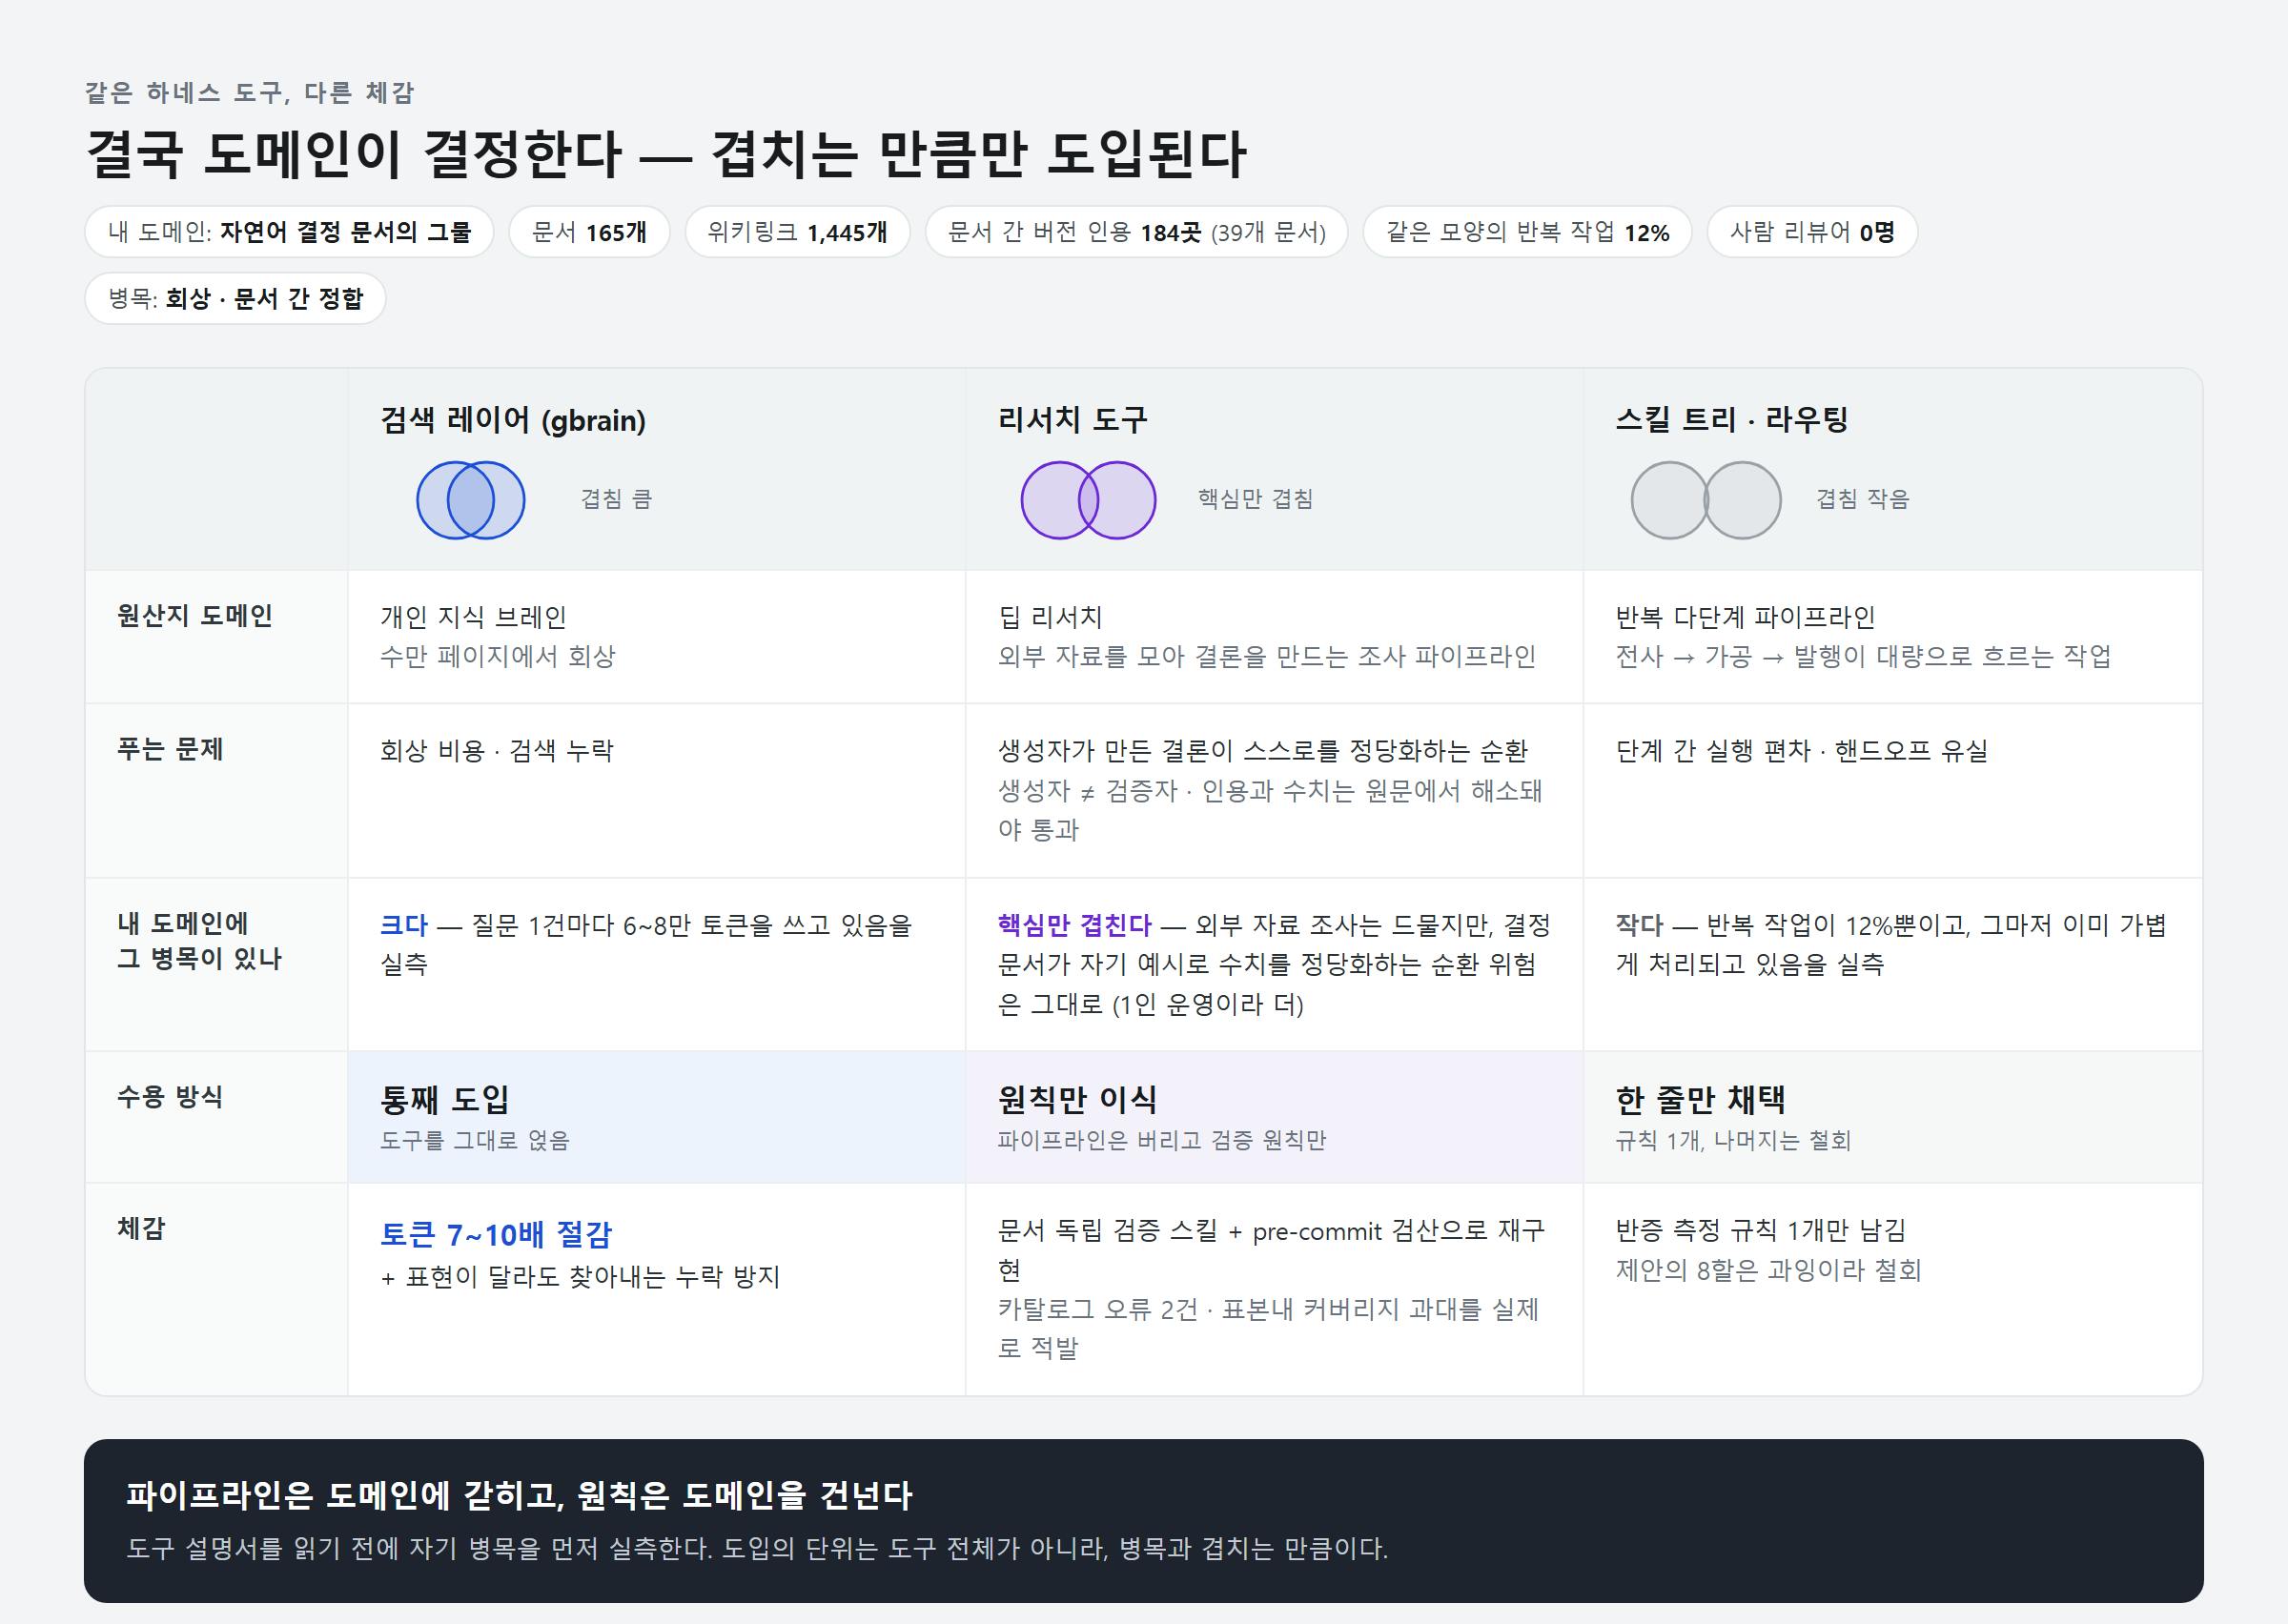
교훈을 일반화하면 두 가지입니다.
첫째, 도구 설명서를 읽기 전에 자기 병목을 먼저 실측하라. "이 도구가 푸는 문제가 내 도메인의 병목인가?"가 일치하면 체감이 크고(7~10배), 아니면 도입 비용만 남습니다.
둘째, 도입의 단위는 도구 전체가 아니라 병목과 겹치는 만큼이다. 위 표의 세 가지 수용 방식 — 통째 도입 / 원칙만 이식 / 한 줄만 채택 — 이 그대로 겹침의 크기 순서입니다. 특히 리서치 도구 사례가 재밌는데, 파이프라인(외부 자료 수집·조사)은 내 도메인에 없어서 버렸지만 그 안의 검증 원칙(생성자 ≠ 검증자, fail-closed)은 도메인을 건너서도 살아남았습니다. 파이프라인은 도메인에 묶이지만, 원칙은 이식됩니다. 반증 측정·커밋 검수도 같은 계층입니다 — 도구가 아니라 일하는 태도라서 어디에 얹어도 작동합니다.
만약 여러분의 도메인이 저와 반대라면 — 같은 모양의 작업이 대량으로 흐르는 파이프라인(콘텐츠 발행, 데이터 가공, 반복 리포트)이라면 — 판단은 뒤집힐 겁니다. 스킬 트리·라우팅·게이트가 본체가 되고, 검색 레이어는 보조가 됩니다.
배운 점 & 꿀팁
절차를 빼는 것과 검증을 빼는 것은 다른 문제입니다. 1인 운영 전환에서 라벨·승격 같은 합의 절차는 걷어냈지만, 검증은 트리거를 바꿔(이벤트→내용 연동) 오히려 강화했습니다. 사람 리뷰가 빠질수록 하네스는 촘촘해져야 합니다.
반증 측정이 최고의 검수입니다. 남의 벤치마크만이 아니라 내(그리고 AI의) 제안에도 적용해야 합니다 — "이 제안이 필요 없다는 걸 보여줄 데이터가 뭔가"부터 재기. 사용자가 되물어야 결론이 바뀌는 답은 처음부터 검증이 빠진 답입니다.
규칙은 항상 로드되는 곳에 둬야 작동합니다. 검증 스킬이 있어도 AI가 스스로 안 부르면 없는 것과 같습니다. 호출해야 뜨는 스킬에만 있던 게이트를 매 세션 무조건 읽히는 CLAUDE.md로 끌어올렸습니다.
실측은 생각보다 쌉니다. 이날 쓴 측정은 전부 커밋 로그 집계, 파일 크기 합산, grep 카운트 수준 — 각 1~2분이면 됩니다. 그 몇 분이 "추정"을 "사실"로 바꾸고, 제안서의 신뢰도를 완전히 다른 급으로 만듭니다.
시행착오
자동 커밋을 지우다 무한 루프에 빠질 뻔했습니다. 도구가 만든 자동 커밋을 리베이스로 들어냈더니, 동기화 체크포인트가 "사라진 커밋"을 가리키게 되면서 다음 동기화가 빈 앵커 커밋을 또 만들었습니다(지우면 또 만드는 구조). 결국 빈 커밋 하나(파일 0개)는 앵커로 남기고 마무리했습니다. 교훈: 도구의 자동 커밋은 리베이스로 지우지 말고, revert로 내용만 되돌리는 게 안전합니다 — 히스토리를 다시 쓰면 도구의 앵커가 깨집니다.
규칙을 넣으면서 그 규칙의 정신을 어길 뻔했습니다. "짧게 넣겠다"던 반증 측정 규칙이 처음엔 규칙 파일에서 가장 긴 210자 문장이었습니다. 규칙 문서가 비대해지면 사람도 AI도 끝까지 안 읽습니다 — 규칙 자체도 검수 대상입니다.
동시 세션 잠금이라는 운영 마찰이 실재합니다. 색인 DB가 단일 프로세스라 AI 세션을 여러 개 띄우면 먼저 뜬 세션만 검색 레이어를 씁니다. "Connection closed"가 보이면 고장이 아니라 잠금 충돌 — 진단 커맨드가 잠금을 쥔 프로세스 번호까지 알려줘서 처치는 몇 분이면 됩니다.
앞으로의 계획
기존 결정 문서 48종에 남은 구체제 라벨·상태 표를 문서 손댈 때마다 점진 정리
열린 미결 항목 660건(실측)의 실태 분류 — 주간 점검 루틴으로 소화할지 판단
색인 도구의 자동 커밋 기능 끄기 — 모든 세션을 닫은 유지보수 창에서 설정 확인
2주 뒤 회고: 이 하네스가 실제로 잡은 것 / 놓친 것을 세어보고 규칙을 다시 조정
도움 받은 글 (옵션)
gbrain 오픈소스 저장소 — 1편에서 도입한 검색 레이어. 이번 실측으로 "토큰 1/10" 추정을 7~10배로 보정
Skill Tree와 Routing 운영 방식 자료 (베스트발표회참석)— "하네스 = 규칙·게이트로 편차를 통제하는 장치"라는 어휘와, 게이트를 요청 진입점에 두는 발상을 빌려왔습니다. 내 도메인에는 대부분 과잉이라 한 줄만 채택했는데, 그 판단 과정이 이 글의 "도메인이 결정한다" 절과 반증 측정 사례가 됐습니다

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


2편도 꼼꼼하게 읽었어요. 1편에서 예고한 "내 데이터로 직접 재겠다"는 약속을 이번에 정말 이행하셨더라고요 — gbrain 도입 전후를 같은 위키에서 실측하셔서 7~10배 절감이라는 숫자가 나왔고, 추정치보다 소폭 낮다는 것도 솔직하게 병기하셨네요.
특히 인상 깊었던 건 에이전트 스킬 도입 검토 과정에서 발견한 자기확증편향 이야기예요. "이 제안이 필요 없다는 걸 보여줄 데이터"를 마지막에야 쟀더니 제안의 8할을 철회하게 됐다는 흐름 — 측정을 안 한 게 아니라 주장을 뒷받침하는 것만 골랐다는 자기 진단이 날카로웠어요. 그걸 CLAUDE.md에 반증 측정 규칙으로 남기신 것도요.
1인 체제로 전환하면서 절차를 걷어내는 대신 AI 하네스를 오히려 강화하는 방향을 택하셨다는 게 이번 2편의 핵심인 것 같아요. 3편도 기대하고 있을게요 🐈⬛