"진행해"만 눌렀더니, AI가 혼자 저-앞까지 가 있었다
2026.07.26
한 줄 요약
에이전트를 똑똑하게 만들려고 지식관리를 시작했는데, 정작 제가 이해를 못 한 채로 AI 혼자 한참 앞서 달려가 버린 첫 주 기록입니다. 결과물보다 어디서 어긋났는지가 남았습니다.
💭 Prologue : 에이전트는 만들었는데, 멍청했다
지난 기수에 에이전트를 만들어서 돌려봤습니다. 작동은 했습니다.
그런데 멍청했습니다.
이유는 명확했어요. 기록도 지식도 없었으니까요. 세션이 끝나면 다 잊어버리고, 다음에 같은 걸 또 설명해야 했습니다. 어제 내린 결정을 오늘 모릅니다.
그래서 이번 기수 목표를 정했습니다 — 내 에이전트들을 훈련하고 교육해서 업그레이드하기. 그러려면 AI 지식관리부터 들어가야 했습니다.
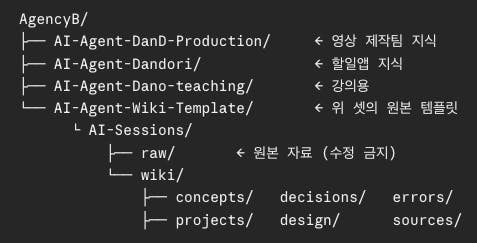
📁 몇 주 전 만들어둔 것 — AgentB
사실 준비는 좀 해뒀습니다. 몇 주 전 유튜브에서 본 어떤 분의 AI 지식관리 구조를 보고, 제 나름대로 접목해서 폴더 체계를 만들어놨거든요.
구조는 나쁘지 않았습니다. 원본과 가공본을 나눴고, 볼트마다 운영 규약(CLAUDE.md)도 넣었고, 검사 스크립트까지 있었습니다. 그런데 적용을 안 했습니다.
만들어만 놓고 어떻게 흘러가는지 몰랐습니다. 일을 시킬 때 에이전트가 지식 폴더 읽는 걸 실패하는 경우도 많았고요. 그냥 그런가보다 하고 넘어갔습니다.
🚀 첫 주: AKM 설치, 그리고 "진행해"
스터디 첫 주에 스터디장님이 만드신 AKM(Agentic Knowledge Management) 을 클로드 코드에게 설치하라고 시켰습니다.
git clone https://github.com/DECK6/akm.git akm-week1여기까지는 좋았습니다. 문제는 그다음이었어요.
저는 AKM이 뭔지 이해하지 못한 채로 진행했습니다.
AI가 계속 뭐라고 합니다. 이게 부족하고, 저게 어쩌고, 이건 이렇게 하는 게 좋고... 저는 내용을 따라가지 못한 채 그냥 "진행해"를 눌렀습니다. 몇 번을 그랬습니다.
😵 이상함을 느낀 순간
한참 뭔가가 만들어진 뒤에, 일단 사례글부터 써달라고 했습니다.
그런데 나온 글을 제가 이해할 수 없었습니다.
세션 로그를 채굴한다느니, 274건 중 40%가 오탐이라느니, 라우팅 실패가 기계 검증됐다느니... 제 이름으로 나갈 글인데 제가 무슨 소린지 모르겠더라고요.
거기서 멈췄습니다. 그리고 오푸스와 깊은 대화에 들어갔습니다.
"이게 뭘 한거지 내가 이해가 안가. 초보자도 쉽게 이해할 수 있도록 설명해줘."
설명을 들어도 방향이 제가 생각한 것과 달랐습니다. 그래서 다시 물었습니다.
"현재 세션을 처음부터 검토해서 어디서부터 어긋났는지 찾아봐줘. 그리고 방법이 틀렸다면 알려줘."
🙃 AI의 실토
돌아온 답이 뜻밖이었습니다. 자기가 제 말을 잘못 이해하고 혼자 저-앞으로 달려가고 있었다고 실토하더군요.
어긋난 지점을 짚어줬습니다.
① 제 요청은 "제안해줘"였는데, AI는 "만들었습니다" 제가 한 말은 "어떤 기록을 쌓는 게 도움될지 제안해줘" 였습니다. 앞에 "akm 구조가 정리됐으면" 이라는 조건도 붙였고요. 저는 배우는 중이고 다음 단계를 물은 것이었는데, AI는 이걸 구축 발주로 읽었습니다.
② "내가 운영하는 에이전트들"을 좁게 해석함 제가 말한 에이전트를 AI는 특정 폴더의 에이전트 10명으로 확정했습니다. 확인 없이요.
③ 결정적 지점 — 그 팀이 45일간 안 돌았다는 걸 발견했을 때 AI가 조사해보니 제 영상 제작 에이전트 팀이 6월 11일 이후 한 번도 안 돌았더군요. 그때 멈추고 "그럼 애초에 뭘 쌓고 싶으신 건지 다시 정합시다" 라고 했어야 했는데, 대신 "신호를 어디서 받을까요?" 라고 물었답니다. 선택지 4개가 전부 자기가 이미 정해놓은 틀 안에 있었고요.
질문은 했는데, 이미 정해놓은 틀 안에서만 물었다.
이 문장이 제일 뼈아팠습니다. 저는 선택지를 골랐으니 제가 방향을 정했다고 생각했는데, 사실 틀은 이미 정해져 있었던 겁니다.
덧붙이자면, 달려간 결과물이 완전 헛수고는 아니었습니다. 실제로 제가 5주간 .docx 파일 읽을 때마다 설치도 안 된 프로그램을 찾고 있었다는 걸 발견해줬거든요. 다만 순서가 틀렸습니다. 공장에 제품이 안 흐르는데 자동 품질검사 카메라부터 단 셈이었습니다.
🐢 다시, 천천히 — AgentB와 AKM은 뭐가 다른가
그래서 부탁했습니다. 제 삽질과 느린 이해를 도와달라고.
먼저 물은 건 이거였습니다 — "내가 이미 만든 AgentB랑 AKM은 뭐가 다른데?"
답을 듣고 나서야 뭔가 잡혔습니다.
AgentB는
주제별로 나누고, AKM은성숙도별로 나눈다.
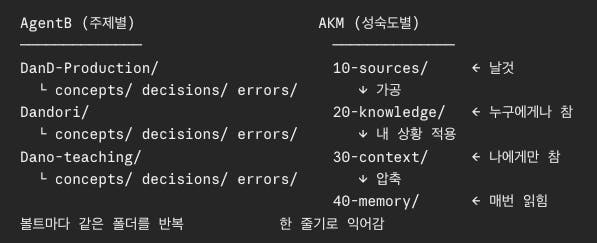
그리고 둘의 차이도 찾아봤습니다.
AKM 레이어 | 제가 이미 쓰던 것 |
|---|---|
|
|
|
|
|
|
| ⚠️ 없음 |
| ⚠️ 거의 없음 |
|
|
|
|
빠진 게 두 개. 그중 40-memory가 핵심이었습니다.
▷ 왜 내 볼트가 멈춰 있었나
제 운영 규약 1번 조항이 이겁니다.
작업 시작 전
index.md,log.md, 관련wiki/문서를 먼저 확인한다.
방향은 맞는데, "관련 문서"가 어느 것인지 안 적혀 있습니다. 그래서 실제로는 안 읽힙니다. 에이전트가 지식 폴더 읽기를 자꾸 실패했던 것도 이것 때문이었던 것 같습니다.
AKM의 40-memory는 이렇게 구체적입니다.
- 이 맥에 pandoc 없음. .docx는 docx 스킬로 → [[docx-처리]]- 미룸(postponed)과 언젠가(someday)는 구분 → [[todo-postponed-status]]
- 삭제는 rm 금지, _archive/ 이동 → [[안전규칙]]
세 줄짜리 포인터. 전문은 다른 데 있고 여기엔 "무엇을 알아야 하는지 + 어디 있는지"만. 이게 매 세션 로드됩니다. 제 진짜 문제는 노트를 안 쓴 게 아니라, 쓴 노트가 다시 안 읽힌다는 거였습니다.
▷ 검사 방식도 달랐다
AgentB | AKM | |
|---|---|---|
lint가 보는 것 | 폴더가 있는지만 | 노트 하나하나의 내용 |
규칙 어기면 | 아무 일도 안 일어남 | 통과 못 함 |
신뢰도 표시 |
| 5단계 (날것→미검증→검토됨→정본→폐기) |
제 검사 스크립트를 열어보니 required_dirs 목록만 확인하고 있더군요. 사람이 규칙을 지키는 구조였습니다. AKM은 기계가 검사합니다.
▷ 그리고 Learn Back
제가 쓴 사고 기록 하나가 있습니다. 잘못된 날짜 문자열 하나 때문에 앱 전체가 죽은 사건인데, 원인 4단계에 3중 방어까지 꽤 잘 써놨어요.
그런데 거기서 끝납니다.
AKM은 실패 기록에 한 칸을 더 요구합니다.
Learn Back- 고친 레이어: 50-procedures
- 고친 파일: [[입력-검증-규칙]]
실패 → 어느 레이어를 고칠지 지목 → 다음번 입력이 개선됨. 이 되먹임이 있어야 시스템이고, 없으면 그냥 창고입니다. 제 건 창고였습니다.
🤔 아직 못 정한 것들
솔직히 아직 다 이해한 건 아닙니다. 다만 갈 길이 보이기 시작했습니다.
지금 제 앞에 놓인 질문들:
어떤 구조로 지식관리를 할 것인가 — 주제별인가 성숙도별인가
남길 것인가, 버리고 새로 갈 것인가 — AgentB에 노트 21개가 이미 있습니다. AKM 볼트엔 이제 막 몇 개뿐이고요
내 에이전트들에게 뭐가 맞나 — 저는 헤르메스, 클로드 코드, 코덱스를 같이 씁니다. 셋이 같은 지식을 봐야 하는데, 어떤 구조가 셋 다에게 맞을지 아직 모릅니다
받은 제안은 "AgentB를 버리지 말고 AKM에서 세 가지만 이식하라"는 것이었습니다 — 40-memory, 신뢰도 5단계, Learn Back 칸. 그중 첫 번째만 해도 6주 정지 문제가 풀린다고요.
아직 결정 안 했습니다. 더 이해하고 정하려고요.
🎓 이번 주에 배운 것
1. "진행해"는 위임이 아니라 포기다. 저는 진행 버튼을 누르면서 위임한다고 생각했습니다. 실제로는 판단을 포기한 거였어요. 이해 못 한 상태에서 누른 "진행해"가 쌓이면, 나중에 내 이름으로 나갈 결과물을 내가 설명하지 못하게 됩니다.
2. 선택지를 골랐다고 방향을 정한 게 아니다. AI가 준 4개 선택지를 고르면서 제가 키를 잡았다고 생각했는데, 틀은 이미 정해져 있었습니다. "이 선택지들이 다 같은 전제 위에 있는 거 아니야?" 를 물었어야 했습니다.
3. 막히면 "어디서부터 어긋났는지 찾아봐줘"가 잘 먹힌다. 이 한마디로 AI가 자기 실수 네 개를 시간순으로 짚어줬습니다. 결과물을 고쳐달라고 하는 것보다, 과정을 되짚게 하는 게 훨씬 나았습니다.
4. 내 폴더는 이미 절반쯤 맞았다. 새로 다 갈아엎을 뻔했는데, 알고 보니 7개 중 5개는 이미 하고 있었습니다. 뭐가 빠졌는지 아는 게 먼저였습니다.
5. 노트를 쓰는 것과 노트가 읽히는 건 다른 문제다. 저는 6주 동안 "기록이 안 쌓인다"고 생각했는데, 21개나 있었습니다. 안 쌓인 게 아니라 안 읽힌 거였습니다.
⏭️ 다음에 할 것
오늘부터 다시 깊은 대화가 필요해 보입니다. 이번엔 "진행해" 말고요.
노트 21개를 ROUTER에 통과시켜 보면서 분류 연습
거기서 "매번 알아야 할 한 줄"을 뽑아
40-memory만들기헤르메스·클코·코덱스 셋이 같은 지식을 볼 수 있는 구조인지 확인
💁♀️ 사례글 쓰기 스킬의 도움을 받아 작성했습니다.
로그인하고 댓글을 남겨 주세요
1. "진행해"는 위임이 아니라 포기다. 저는 진행 버튼을 누르면서 위임한다고 생각했습니다. 실제로는 판단을 포기한 거였어요. 이해 못 한 상태에서 누른 "진행해"가 쌓이면, 나중에 내 이름으로 나갈 결과물을 내가 설명하지 못하게 됩니다.
와, 이 말 진짜... 너무 와 닿네요. 포기한 순간들이 떠오릅니다.^^

5주 동안 .docx를 읽을 때마다 설치되지 않은 프로그램을 찾고 있었다는 사실을 직접 발견해낸 과정이 특히 인상적이었어요. 자동화 결과만 받아들이지 않고, 실제 작업 흐름에서 무엇이 멈춰 있었는지 확인하신 덕분에 막연한 지식관리 문제가 구체적인 장면으로 드러난 것 같습니다. 아직 다 이해하지 못했다고 솔직하게 적으면서도 서두르지 않고 다시 배우려는 태도가 정말 좋네요.
_묘랑님, 결과물을 이해하지 못한 순간 멈추고 “현재 세션에서 어디서부터 어긋났는지 찾아봐줘”라고 되짚으신 판단이 가장 중요하게 읽혔습니다. AKM은 에이전트를 무조건 멀리 달리게 만드는 시스템이 아니라, 무엇을 근거로 실행했고 어디서 멈춰야 하는지 설명할 수 있게 만드는 시스템입니다.
AgentB는 주제별, AKM은 성숙도별이라는 구분은 조금 다릅니다. AKM의 폴더는 성숙도보다 지식의 책임과 역할에 따라 Source·Knowledge·Context·Memory·Procedure·Action·Evaluation·Output으로 나눕니다. 성숙도는 폴더가 아니라 raw·unverified·reviewed·canonical·deprecated 같은 trustLevel로 yaml frontmatter에 별도 표시합니다.40-memory의 역할을 “관련 문서를 읽어라”가 아니라 “반드시 알아야 할 짧고 안정적인 규칙과 정본 위치를 가리키는 포인터”로 이해하신 것은 맞습니다. 다만 작업별 지식이나 긴 절차를 Memory에 계속 넣으면 다시 과적재됩니다. 전문은 Context나 Procedure에 두고, Memory에는 언제 어떤 정본을 읽어야 하는지만 남기는 것이 핵심입니다.
lint도 모든 내용의 사실 여부를 판단하는 검증기는 아닙니다. 스키마, 허용값, 링크, 비밀정보 노출처럼 기계적으로 확인할 수 있는 규칙을 검사합니다. 문서 내용이 실제로 옳은지, 원문이 주장을 지지하는지는 별도의 Verify 과정과 직접 대조가 필요합니다. 구조 검사를 통과했다고 지식까지 검증된 것은 아닙니다.
기존 AgentB를 버리고 전면 이관할 필요는 없습니다. 21개 노트를 먼저 이동하지 않은 상태에서 ROUTER로 분류 제안만 만들어 보고, 대표 노트 3개 정도를 Source·Knowledge·Context·Procedure·Evaluation에 대응시켜 보는 편이 안전합니다. 그 과정에서 매 세션 반드시 필요한 규칙만 기존 네 개의 Memory 포인터에 반영하고, 반복 실패 한 건을 Procedure와 Evaluation까지 실제로 고쳐보면 두 구조의 차이를 충분히 확인할 수 있습니다.
Hermes·Claude Code·Codex가 같은 지식을 보게 하는 방법도 세 개의 볼트를 복제하는 것이 아닙니다. 하나의 로컬 AKM을 정본으로 두고, 각 도구에는 시작할 때 읽을 포인터와 해당 도구가 맡을 책임만 Adapter로 연결하는 방식입니다. 각 도구의 자체 메모리는 AKM 전체를 복사하는 공간이 아니라 정본으로 들어가는 입구가 됩니다.
“진행해” 자체가 항상 포기는 아닙니다. 범위·중단 조건·검증 기준이 합의된 계획 안에서는 정상적인 위임입니다. 문제는 이해되지 않은 계획에 계속 실행 권한을 준 상태였습니다. 이번 경험에서 그 경계를 직접 발견하신 것이 더 큰 성과라고 봅니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


'제안해줘'라고 했는데 AI가 '만들었습니다'로 읽고 혼자 앞서나간 지점을, 이해 안 되는 상태에서 멈춰 세우고 되짚어보신 과정이 이 글의 핵심입니다. '진행해는 위임이 아니라 포기다'라는 문장이 정확한 진단 같습니다.
AI가 준 선택지 4개를 고르면서 방향을 정했다고 생각했는데 사실 틀은 이미 정해져 있었다는 발견, 그리고 '이 선택지들이 다 같은 전제 위에 있는 거 아니야?'라는 한마디로 AI가 자기 실수 네 개를 시간순으로 짚어주게 만든 방법이 특히 실용적입니다. 결과물을 고쳐달라고 하는 대신 과정을 되짚게 한 것이 훨씬 나았다는 배움도 좋습니다.
AgentB와 AKM을 비교해서 7개 레이어 중 5개는 이미 하고 있었다는 걸 확인하신 부분, 그리고 40-memory와 60-actions가 빠져서 '노트를 안 쓴 게 아니라 쓴 노트가 다시 안 읽힌' 것이었다는 진단이 명확합니다. 검사 스크립트가 폴더 존재만 확인하는 사람이 규칙을 지키는 구조였다는 것도 좋은 발견입니다.
6주 동안 기록이 안 쌓인다고 생각했는데 노트가 21개나 있었다는 것, 문제는 '안 쌓인 게 아니라 안 읽힌 것'이었다는 결론이 인상적입니다. AgentB를 버리지 않고 40-memory, 신뢰도 5단계, Learn Back 세 가지만 이식하는 다음 단계도 응원합니다!