서비스를 켜둔 것만으로는 부족했다: 네트워크 전환·복구 백업·수동 경보 검증
2026.08.11
📝 한줄 요약
바쁘시면 이것만 읽어도 돼요:
24시간 AI 서버의 운영 마감 조건을 네트워크, 복구 지점, 이상 판정의 세 경계로 나뉈습니다.
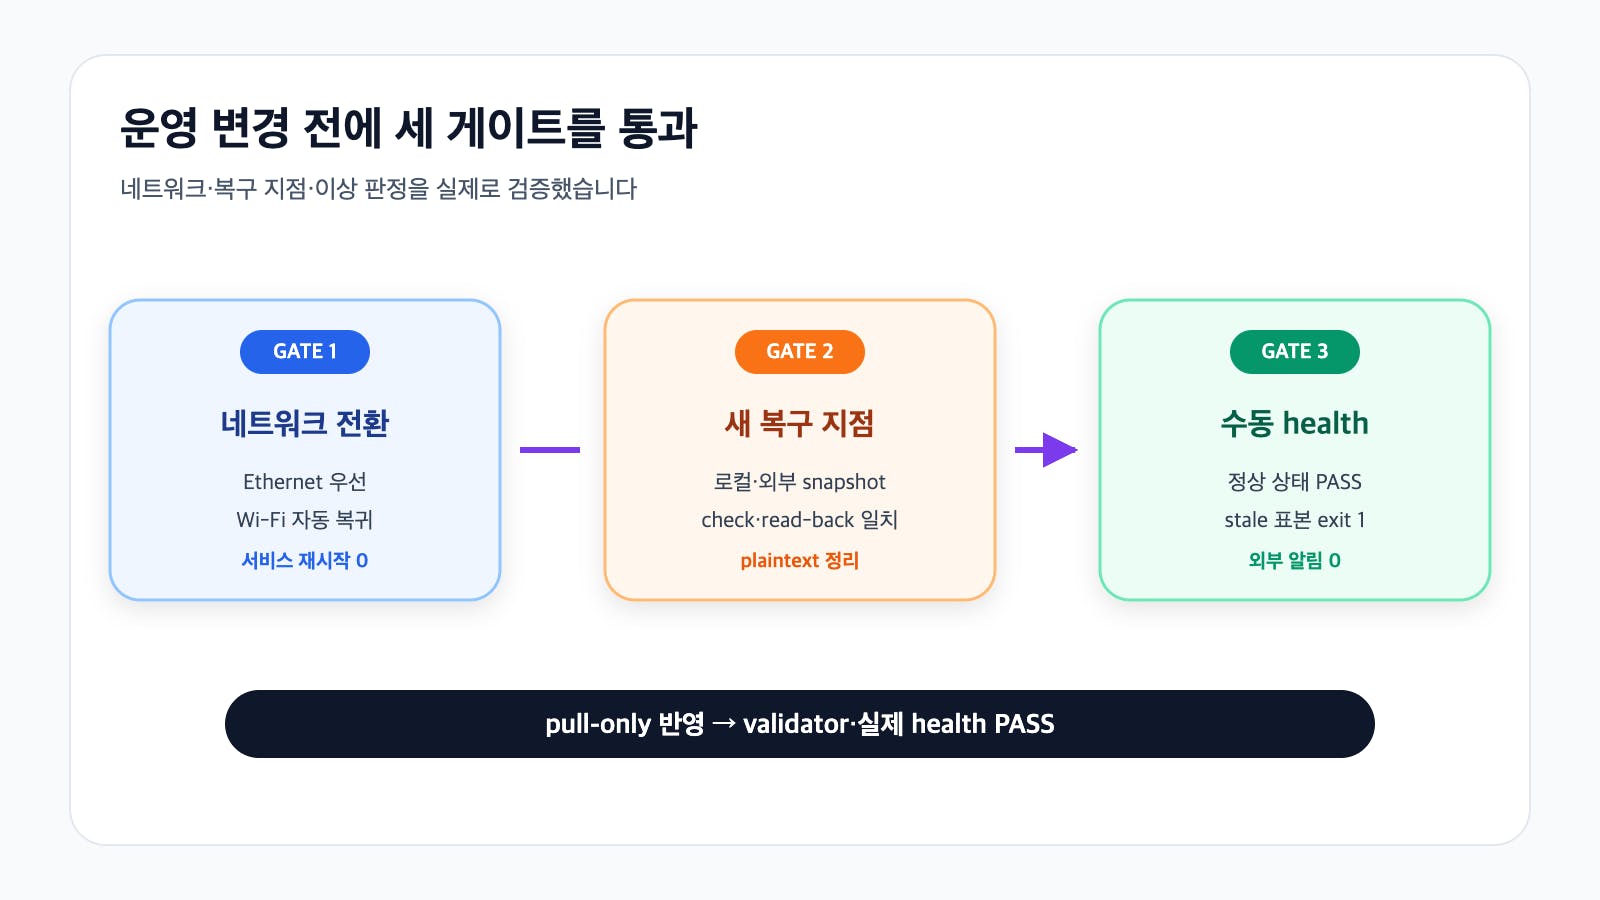
Ethernet을 연결하자 기본 경로가 1Gbps 유선으로 바뀌고, 케이블을 분리하자 Wi-Fi로 자동 복귀했습니다.
두 방향 전환 동안 Hermes·원격 접속·동기화 서비스는 재시작 없이 유지됐습니다.
변경 전 Hermes 전체 백업을 로컬과 외부 저장소에 새로 남기고, 양쪽에서 다시 읽은 내용이 원본과 같은지 확인했습니다.
자동 알림 대신 주 1회·변경 전에 실행하는 수동 read-only health 검사기를 만들었습니다.
검토된 코드만 pull-only로 운영 서버에 반영하고, 실제 점검의 경보 0개·PASS를 재확인했습니다.
네트워크, 복구 지점, 이상 판정의 세 게이트를 통과한 변경만 운영 서버에 반영했습니다.
🎯 이런 분들께 도움돼요
집이나 사무실에서 무인 AI 서버를 운영하는 분
네트워크 · 백업 · 상태 점검을 별개가 아니라 하나의 운영 게이트로 묶고 싶은 분
작은 시스템에 복잡한 자동 경보를 바로 추가해야 하는지 고민하는 분
😫 문제 상황 (Before)
재부팅과 약 25시간 안정성 점검을 통과했다고 해도 운영 준비가 모두 끝난 것은 아니었습니다. 유선 네트워크를 우선하도록 설정해 둔 것과 케이블 장애 뒤 Wi-Fi로 실제 돌아오는 것은 다른 문제입니다. 백업도 일주일 전 성공 기록만 남아 있어 다음 운영 변경의 rollback 근거로 쓰기 전에 갱신이 필요했습니다.
상태 점검도 여러 명령을 그때그때 실행하는 방식이었습니다. 어느 수치를 이상으로 볼지, 백업이 오래됐을 때 작업을 계속할지가 하나의 규칙으로 고정되지 않았습니다. 이 글은 이 세 공백을 닫고, 검토된 운영 점검기를 서버에 반영한 시점까지 다룹니다.
🛠️ 사용한 도구
도구·기술 | 역할 |
|---|---|
Ethernet·Wi-Fi | 주 네트워크와 자동 대체 경로 검증 |
Tailscale·SSH·Screen Sharing | 전환 중 원격 관리 경로 연속성 확인 |
restic | Hermes 전체 백업을 로컬·외부에 암호화 저장하고 다시 읽기 |
수동 health 검사기 | 자원·서비스·동기화·로그·백업을 read-only로 판정 |
Git pull-only 배포 | 운영 서버를 직접 편집하지 않고 검토된 변경만 반영 |
fail-closed는 필요한 상태를 확인할 수 없을 때 안전하다고 가정하지 않고 실패로 멈추는 방식입니다. pull-only는 운영 서버에서 파일을 직접 고치지 않고, 별도 작업 저장소에서 검토된 변경만 가져오는 배포 방식입니다.
🔧 작업 과정
케이블을 연결하고 다시 뽑았다
먼저 네트워크 서비스 우선순위를 읽기 전용으로 확인했습니다. Ethernet이 1순위였지만 케이블이 없어 현재 기본 경로는 Wi-Fi였습니다. Wi-Fi를 끌 필요가 없었고 설정 변경도 필요하지 않았습니다.
사용자가 Wi-Fi를 켜 둔 채 케이블을 연결하자 기본 경로가 Ethernet으로 바뀌고 1Gbps full-duplex 링크가 확인됐습니다. Tailscale, SSH, 화면 공유, Hermes Gateway·dashboard, OrbStack과 Syncthing은 기존 프로세스와 실행 횟수를 유지했습니다.
첫 OrbStack·Docker 조회는 비로그인 SSH 환경의 PATH에서 명령을 찾지 못했습니다. 이때 출력된 0을 정상 결과로 쓰지 않고, 정확한 절대 경로로 다시 조회해 OrbStack Running과 Docker container·volume 0을 확인했습니다.
이후 케이블을 분리하자 기본 경로가 Wi-Fi로 자동 복귀했고 같은 원격 접속·서비스·동기화 점검을 다시 통과했습니다. 운영 상태를 결정한 실제 사용자 요청은 간단했습니다.
맥미니는 우선 와이파이로 사용하고 추후 케이블로 연결해서 사용할 예정.
그래서 현재는 Wi-Fi를 쓰되, 케이블을 연결하면 Ethernet을 자동 우선하도록 기존 순서를 그대로 보존했습니다.
오래된 백업을 다음 변경의 복구 지점으로 쓰지 않았다
기존 Hermes 백업이 7일 stale 경계에 가까워졌습니다. 새 운영 스크립트를 반영하기 전에 live Hermes 전체 archive를 새로 만들었습니다. 비밀번호와 외부 저장소 키는 채팅·명령 인자·Git 출력에 남기지 않고 숨김 입력 창으로만 넣었습니다.
서버에서 작업 기기로 전송된 archive는 byte 단위로 같았고 ZIP 무결성을 통과했습니다. 같은 archive를 로컬과 private offsite restic에 각각 저장했습니다. 양쪽 저장소의 전체 검사와 정확한 snapshot 재선택, read-back hash가 모두 원본과 일치했습니다.
검증에 쓴 plaintext archive·log·임시 실행기는 정확한 대상을 다시 확인하고 사용자 승인 후 정리했습니다. 암호화된 두 snapshot은 보존했고, 기존 복원 증거는 건드리지 않았습니다.
복잡한 자동 알림 대신 수동 fail-closed 검사기를 만들었다
이 시스템의 규모에서 새 cron, listener, Telegram 알림을 추가하면 운영 구조만 더 복잡해질 수 있었습니다. 대신 주 1회와 production 변경 전에 운영자가 실행하는 수동 검사기를 선택했습니다.
검사기는 디스크·메모리 여유, Git·패키지 drift(검토한 기준에서 벗어난 변경), Hermes Gateway·dashboard·Syncthing·Tailscale·OrbStack의 상태와 실행 횟수, HTTP 응답, 예상하지 않은 Docker 대상, 로그 크기·권한·오류·비밀정보 표식, 로컬·외부 백업 상태를 한 번에 판정합니다.
초기 임계값은 디스크나 메모리 여유 10% 미만, 서비스 실행 횟수 3회 초과, GUI 로그 10MiB 초과, 일회성 로그 각 1MiB 초과, 기존 오류 표식 증가, 비밀정보 표식 1개 이상과 stale·failure 백업입니다.
ShellCheck(쉘 스크립트 정적 검사기)는 첫 검사에서 경로 하나의 인용부호 누락을 찾았습니다. 이를 고친 뒤 실제 상태는 alert.count=0, health.result=pass를 반환했습니다. 의도적으로 백업이 오래됐다고 입력한 표본은 외부 전송 없이 stdout(터미널 출력)에 알림을 남기고 exit 1(실패 상태)로 멈춰 fail-closed 경계도 통과했습니다.
작업 서버가 아닌 운영 서버에서 다시 검증했다
수동 health 검사기와 문서를 별도 authoring 저장소에서 검토한 뒤, 승인된 commit만 Mac mini 운영 저장소에 fast-forward로 반영했습니다. 첫 preflight는 원격 zsh가 awk 표현의 $1을 shell 인자로 해석해 pull 전에 멈춰습니다. 이 실패는 운영 파일을 바꾸지 않았습니다.
$가 필요 없는 cut으로 파싱을 바꿔 같은 guard를 다시 실행했습니다. 예상한 branch·HEAD·clean 상태와 live origin이 검토된 commit과 같을 때만 pull을 허용했습니다. 반영 후 repository validator, 검사기 파일 hash와 실제 health 점검이 모두 통과했고 운영 checkout도 clean이었습니다.
✅ 결과 (After)
Before vs After
항목 | Before | After |
|---|---|---|
네트워크 대체 | 우선순위 설정만 존재 | Ethernet→Wi-Fi 자동 복귀·서비스 연속 실증 |
변경 전 복구 지점 | 7일 경계에 가까운 기존 백업 | 로컬·외부 fresh snapshot과 read-back 일치 |
상태 점검 | 개별 명령과 수동 판단 | 일관된 read-only·fail-closed 검사기 |
이상 표본 | 정상 상태 중심 | stale backup 표본이 stdout·exit 1로 차단 |
운영 반영 | authoring 후 미배포 | pull-only 반영 후 validator·health PASS |
실제 운영 점검에서 디스크 여유 89%, 메모리 여유 91%, 핵심 서비스 실행 횟수 1, dashboard HTTP 200, Tailscale health 0, Syncthing idle, Docker container·volume 0, 경보 0개와 PASS를 확인했습니다. 이는 그 시점의 실행 결과이며 이후 상태는 이 검증에서 확인하지 않았습니다.
자동 health job, 자동 백업, 로그 자동 삭제·순환, Telegram·webhook 외부 알림은 추가하지 않았습니다. 현재 시스템은 운영자가 주 1회와 production 변경 전에 수동 검사를 실행하는 계약입니다.
💬 이 과정에서 배운 AI 활용 팁
효과적이었던 것
설정값이 아니라 케이블 연결·분리 뒤 실제 경로와 사용자 기능을 대조했습니다.
명령이 없어서 나온 0과 실제 대상이 0개인 결과를 구분했습니다.
백업 성공을 snapshot 존재가 아니라 repository check·정확한 snapshot 재선택·read-back hash로 판정했습니다.
실제 정상 상태뿐 아니라 의도적 실패 표본도 실행해 알림 경계를 검증했습니다.
이렇게 하면 안 돼요
Wi-Fi를 먼저 끄고 Ethernet을 시험하면 실패 시 원격 복구 경로를 잃을 수 있습니다.
오래된 백업을 최신 rollback 근거로 간주하거나, 스냅샷 존재만 보고 복구 가능하다고 표현하면 안 됩니다.
작은 시스템에 cron·listener·외부 알림을 일단 붙이면 점검할 대상이 더 늘어납니다.
검사기가 PASS했다는 사실과 장기적인 안정성 보장을 같은 뜻으로 쓰면 안 됩니다.
🌍 다른 업무에 적용한다면?
소규모 사내 서버, 점포 단말, 홈 자동화 허브에도 같은 세 게이트를 적용할 수 있습니다. 첫째, 주 네트워크를 끊어 대체 경로로 돌아오는지 확인합니다. 둘째, 변경 직전의 복구 지점을 새로 만들고 다시 읽습니다. 셋째, 정상과 의도적 실패 표본을 같은 검사기로 판정합니다.
🚀 앞으로의 계획
수동 health 결과와 운영 부담을 몇 차례 더 쌓은 뒤, 누락이나 대응 지연이 실제 문제로 확인될 때만 자동 알림을 재검토할 계획입니다. 현재는 주 1회·변경 전 수동 검사와 7일 backup stale 기준을 유지합니다.
📋 재사용 가능한 프롬프트
프롬프트 1: 운영 변경 전 세 경계 검증
[\uc11c\ubc84]의 다음 운영 변경 전에 세 가지를 검증해줘. 첫째, 주 네트워크와 대체 경로를 실제로 전환하고 핵심 서비스와 사용자 기능이 유지되는지 확인해줘. 둘째, 현재 백업을 로컬·외부 저장소에 새로 만들고 양쪽 repository check와 read-back 일치를 확인해줘. 셋째, 자원·서비스·동기화·로그·백업을 read-only·fail-closed로 판정하는 수동 검사기를 정상과 의도적 실패 표본으로 검증해줘. 자동 job·외부 알림·서비스 재시작은 별도 승인 없이 추가하지 마.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



첫 OrbStack·Docker 조회에서 PATH 때문에 나온 0을 정상 0으로 쓰지 않은 장면이 가장 먼저 눈에 들어왔어요. 도구의 절대 경로로 다시 조회해 OrbStack은 실행 중이고 Docker 컨테이너·볼륨은 0개임을 확인한 덕분에 ‘대상이 없음’과 ‘관찰 도구가 없음’이 섞이지 않았습니다.
유선→Wi‑Fi와 Wi‑Fi→유선을 모두 시험해 서비스 재시작 없이 전환했고, 백업은 정확한 스냅샷을 고른 뒤 읽기 복원 지문까지 확인했습니다. 오래된 백업을 의도적으로 실패시키고 변경 전에는 pull-only dry-run을 둔 기록도, 정상 결과만 모으지 않고 잘못된 복구점과 경로 오염을 먼저 차단한 증거로 읽혀요.
운영을 화려하게 자동화하기보다 도구 부재의 0과 실제 0을 구분하고, 백업·네트워크·변경 전 상태를 각각 확인한 태도가 믿음직했어요. 매뉴얼 실행을 선택한 이유와 그 경계까지 남겨서 작은 서버를 책임 있게 돌리는 기준이 또렷합니다.