소개
스타트업 퇴사 후, 잉여처럼 지낸지 어언 1개월
아직도 대학교 졸업을 못하고있어, 이제는 정말 학교를 졸업해야겠다 싶을 무렵
우연히 글로벌 이커머스 플랫폼 A사로 부터 서류합격을 받았습니다.
면접을 준비하며, 플랫폼 내 상품데이터와 국내 입점사 동향을 파악해야겠다 싶어 상품데이터분석을 진행해봐야겠다 싶었습니다.
시작 전 환경 세팅
1. 강의 수강
수업 듣기전에, 개발자 친구의 추천으로 n8n 강의를 하나 영업당해버렸습니다.
https://www.inflearn.com/course/ai-%EC%9E%90%EB%8F%99%ED%99%94-n8n/dashboard
내용 알차고 따라하기 좋으니, 한번 수강해보셔도 좋을 것 같습니다.
2. claude 비서 세팅
추가로 환경세팅을 위해 claude context7 mcp를 설치해두었습니다.
https://youtu.be/3eDguAZOFsA?si=VAPPwGSEl85Ph5e0
사실 썸네일대로, 정말 '원딸깍' 을 기대했으나
json 파일 그대로 n8n 구축하는건 불가능했습니다. n8n 개발 환경에 직접적으로 연결이 안되어있다보니, 거의 무용지물이더라구요. 시작전에 아키텍처 잡고 들어가는 용 + 모르는것 물어보기 용도로는 조금 쓸만했습니다.
--------------------------------------------------
1. 크롤링 직접 구동시키기 ( 대실패 )
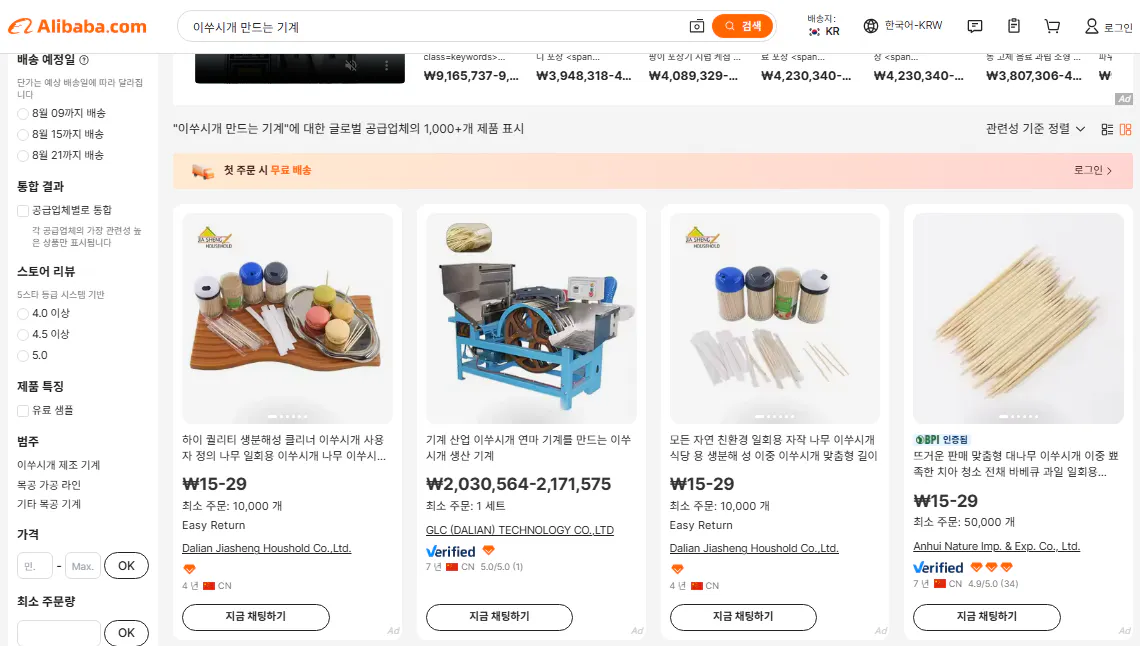
한국 전자 상거래 웹 사이트의 스크린 샷
http 요청으로 직접 긁어오려고 했으나 안되었고, 우회 api를 시도해보았으나 처참히 실패했습니다. 내가 세팅을 잘못한줄알고 계속 만지다가 계속 빈값만 호출되는걸 발견하고서, 클로드에게 검색을 시켰습니다.
여기서 깨달음을 얻었습니다.
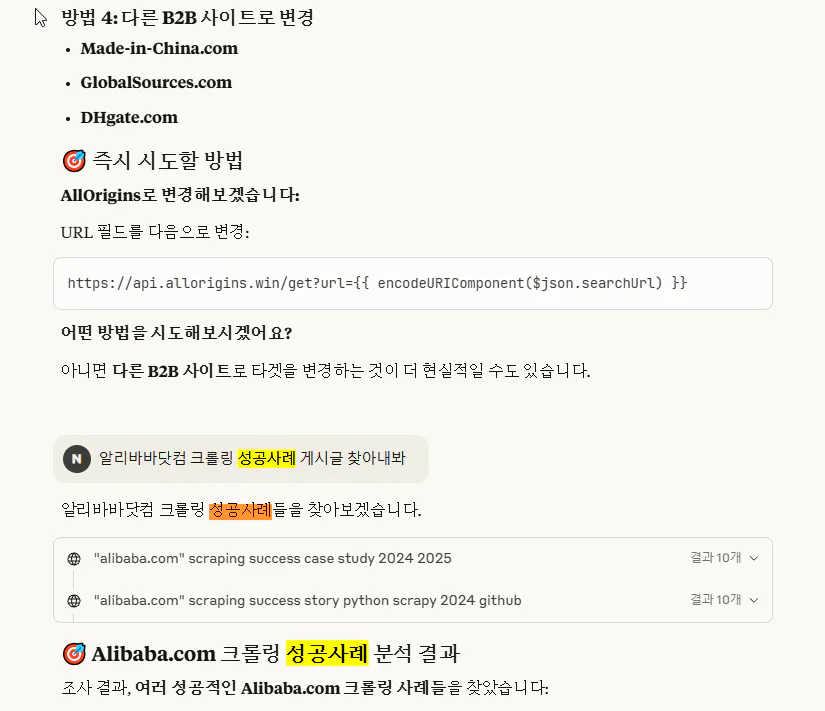
한국 및 중국어 텍스트가있는 페이지의 스크린 샷
앞으로 작업할때는 Claude Context7로 전체 작업 PRD => 성공사례 검색 => 각 구획별 PRD 재구성 => json 다운로드 => 다시 수정 작업
이 루트대로 작업을 해야겠습니다.
2. API 구매하기
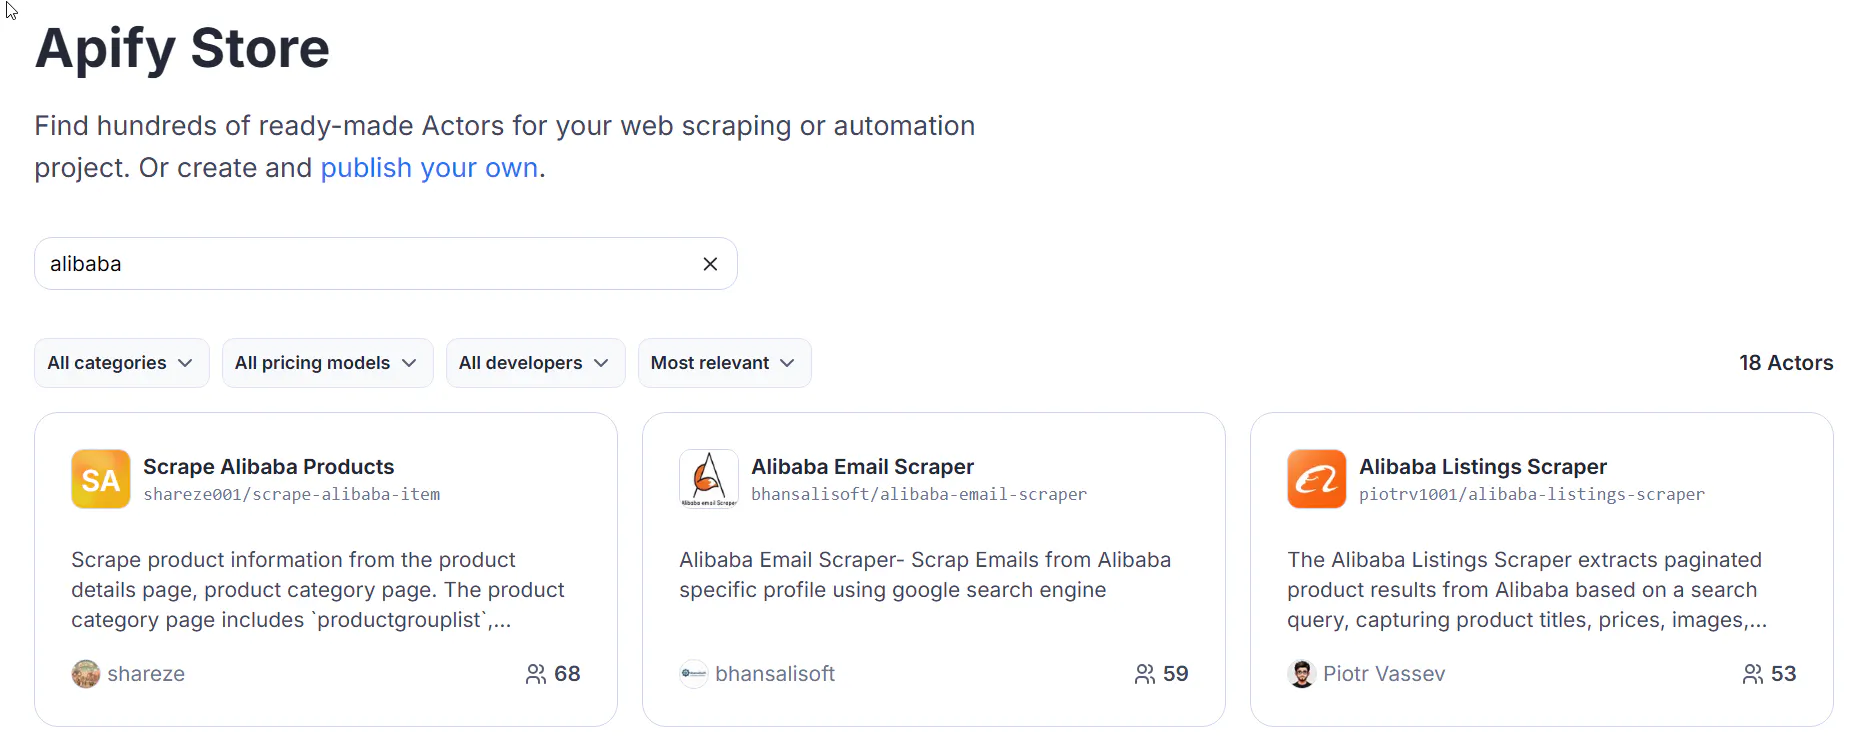
적용 상점 페이지의 스크린 샷
역시 누군가 만들어놓은게 있습니다.
구매해서 API 연동을 진행했습니다.
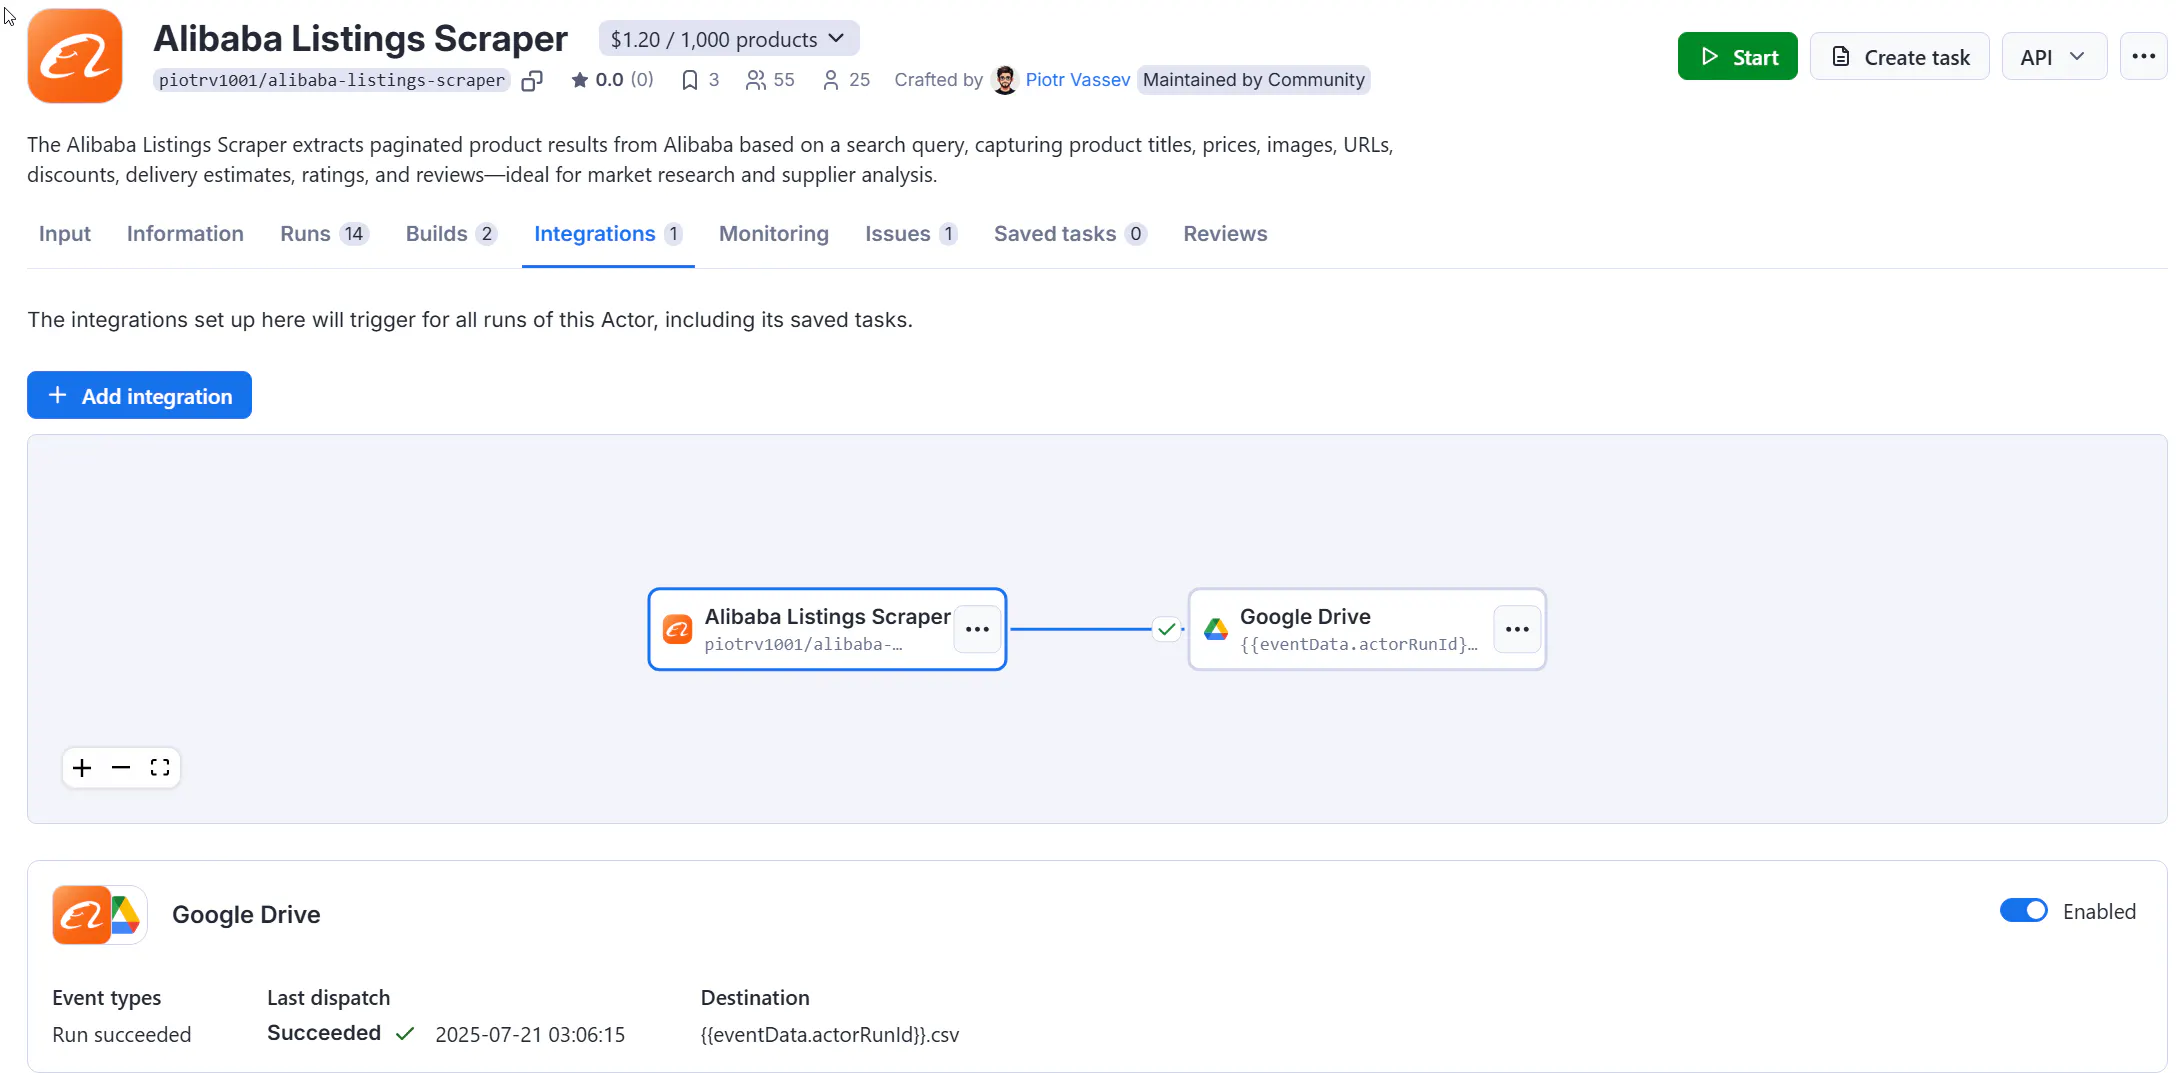
방문 페이지에 대한 링크가있는 페이지의 스크린 샷
데이터 적재와 연동을 위해 drive로 csv로 떨궈줬습니다.
데이터가 10만개도 안쌓일것같아 sheet로 계속 적재해줍시다. 추후 많아지면 supabase로...
이렇게 잘 작동됩니다.
( google 토큰 인증이 몇시간마다 계속 끊기는.. )
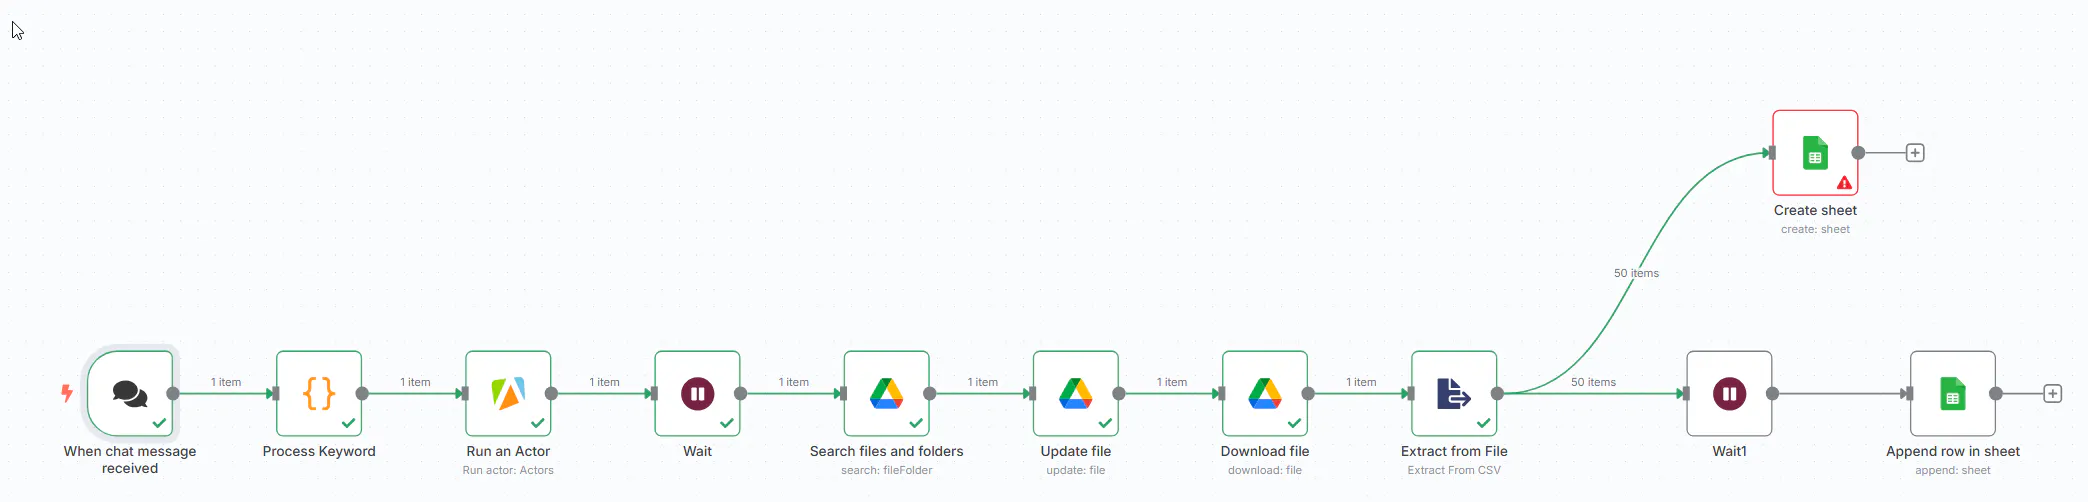
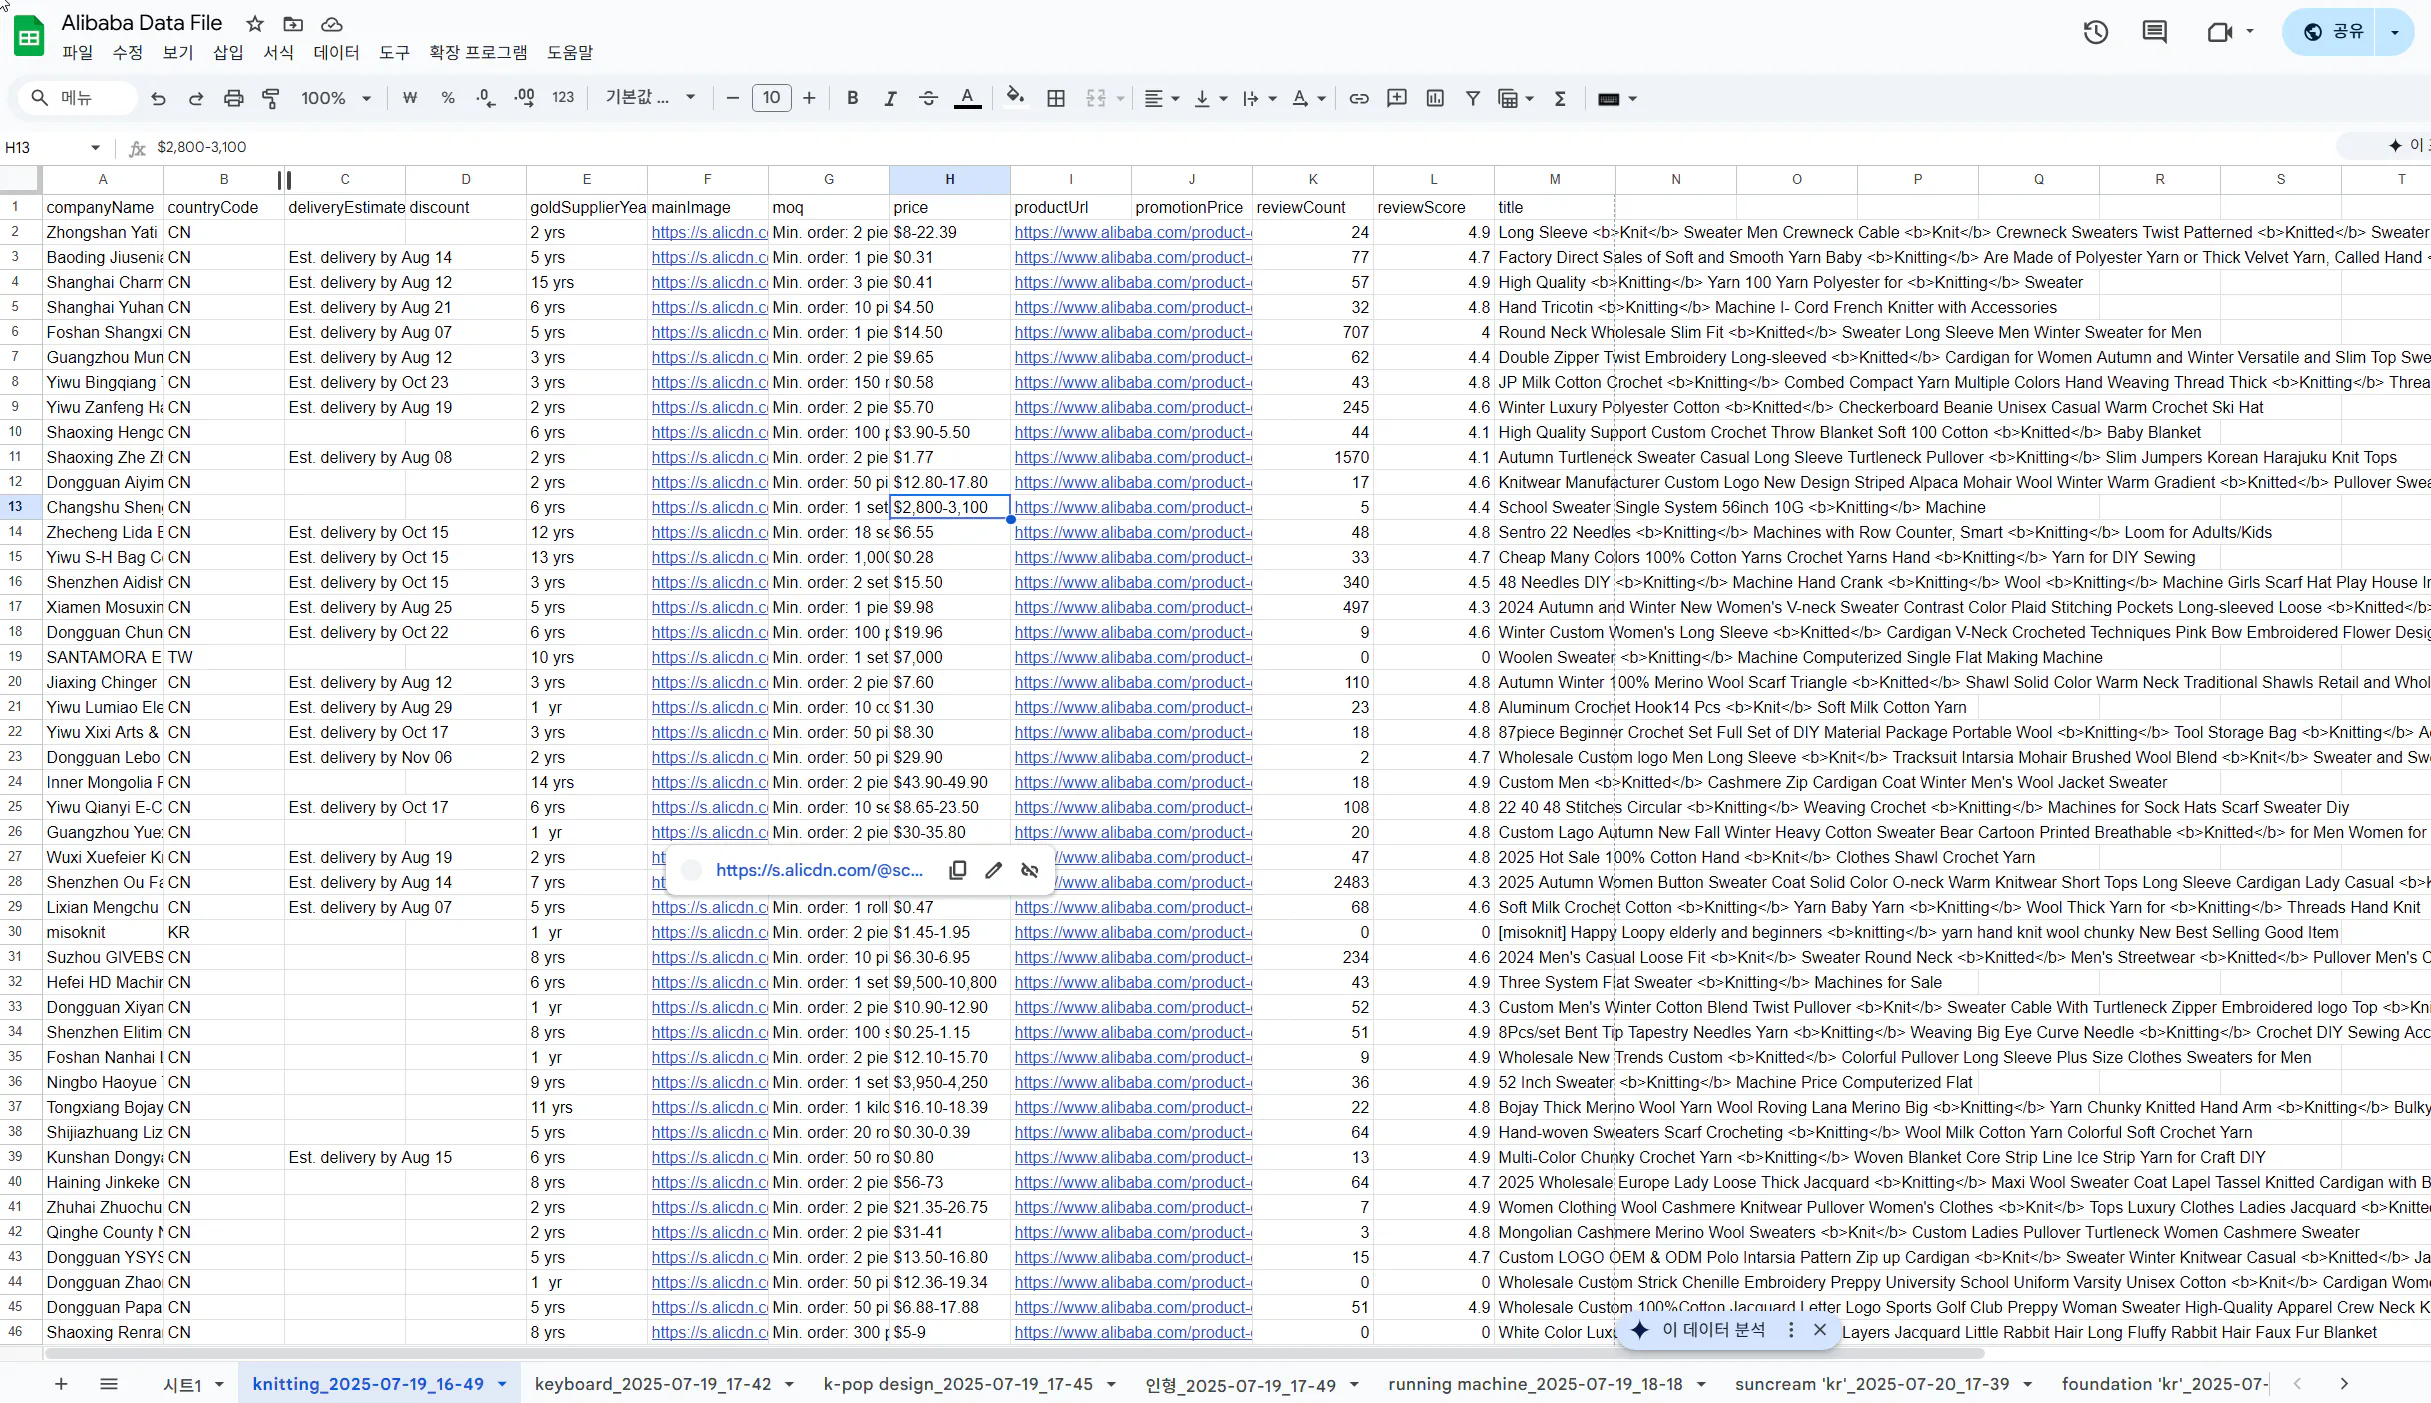
정보가 많은 스프레드 시트의 스크린 샷
다음 2탄 미리보기
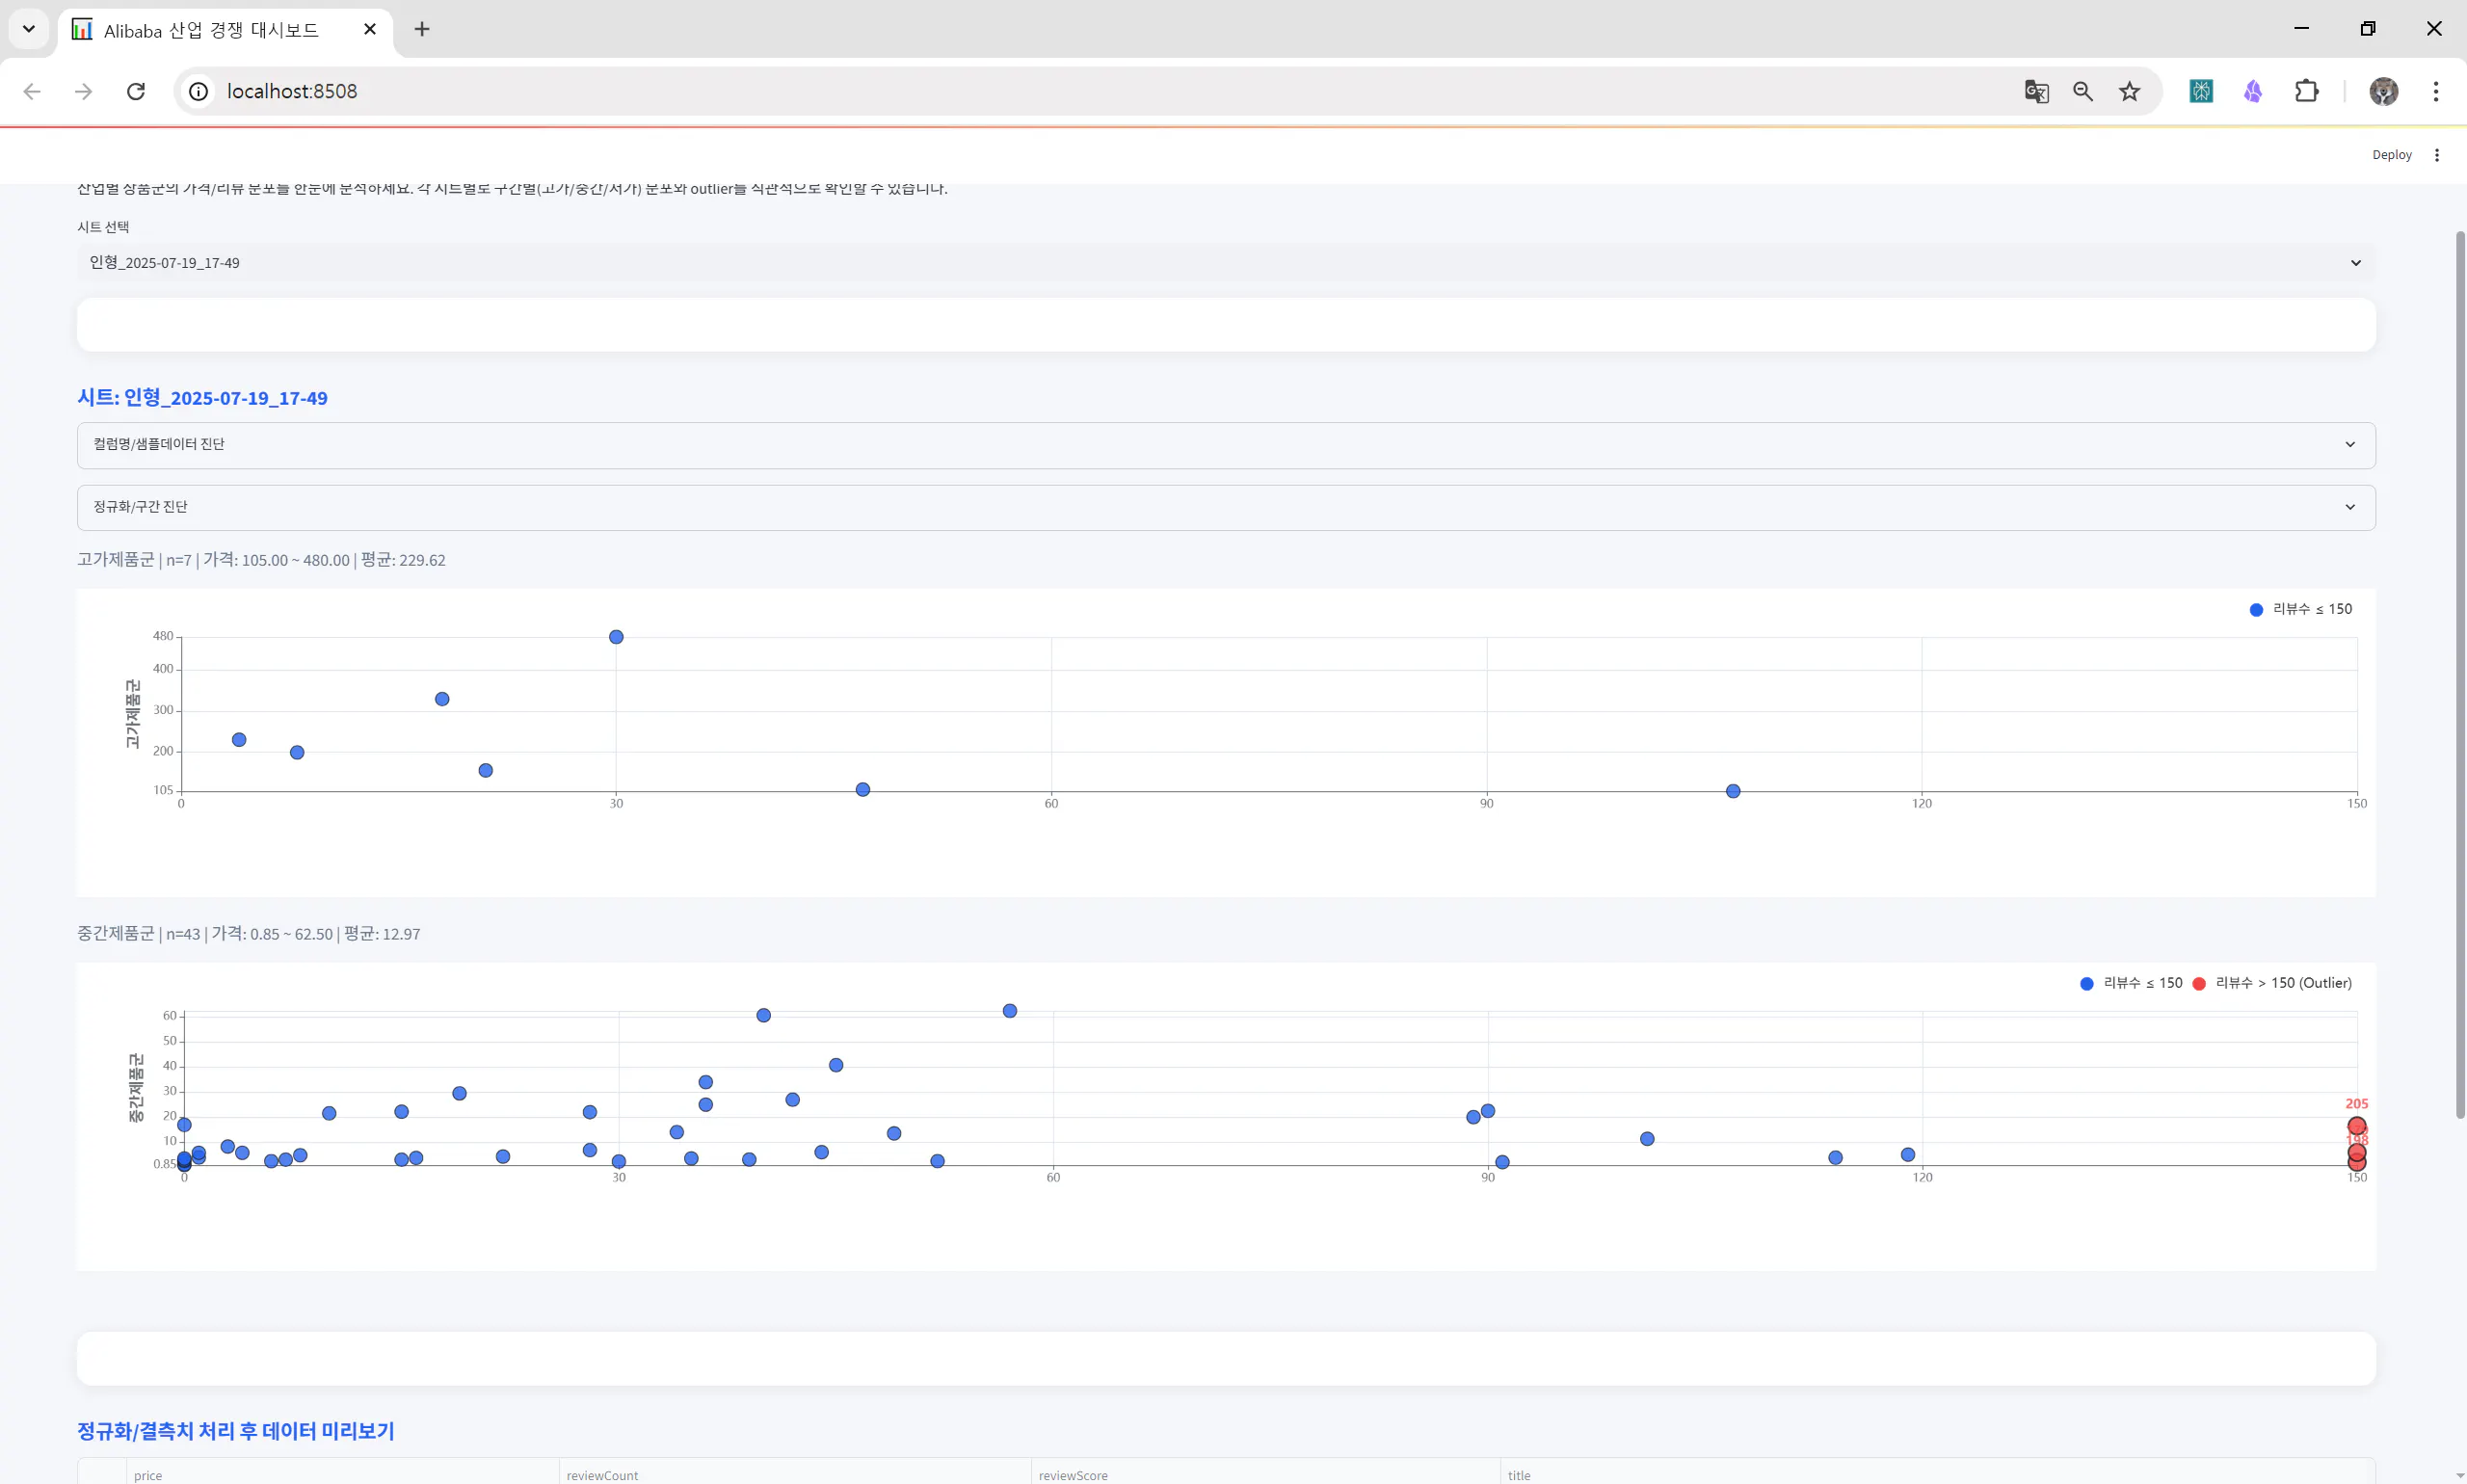
키워드 검색 => n8n으로 데이터 가져오기 => google sheet => webhook으로 streamlit 대시보드에 연동