LLM vs DLM, 정말 빠를까? Mercury 3로 실험해봤다

2026.10.29
DLM(확산형 언어모델)은 일반 LLM처럼 한 낱말씩 쓰지 않고 빈칸을 한꺼번에 채워요. DLM인 머큐리 3(Mercury 3)를 클로드·GPT 4종과 비교하니, 9편 합친 번역을 53초에 끝내 Haiku보다 2.5배 빨랐습니다(2026년 10월 29일 제가 잰 값).
Inception 홈페이지에는 머큐리 3가 초당 1,068토큰, Claude Haiku 5.5가 240토큰이라는 그래프가 걸려 있어요(2026년 10월 28일 확인). 4배 넘게 빠르다는 건데요, 정말 그런지 요약·번역·코딩 세 가지로 직접 재 봤어요.
머큐리 3의 빈칸 채우기 방식
확산형 언어모델(DLM)은 빈칸이 가득한 문장에서 시작해 여러 칸을 동시에 채워요. 챗GPT나 클로드 같은 일반 LLM은 앞에서부터 한 낱말씩 쓰고요. 열 낱말짜리 문장이면 일반 LLM은 열 번을 차례로 거쳐야 합니다.
확산형은 모든 빈칸을 한 번에 예측하고, 그중 확신이 큰 칸만 확정해요. 확신이 낮은 칸은 다시 빈칸으로 두고 다음 단계에서 또 골라요. 이걸 몇 번 반복하면 문장이 완성되는데, 여러 칸을 동시에 채우니까 빠르다는 게 확산형의 장점입니다.
뒤에 올 말을 보면서 앞 칸을 고를 수 있다는 점도 달라요. 이 설명은 LLaDA 같은 대표적인 마스크 방식을 기준으로 했고, 머큐리가 안에서 정확히 어떻게 하는지는 공개되지 않았어요.
확산형의 사용 제한 요인
가장 큰 약점은 동시에 정한 칸끼리 서로 안 맞을 수 있다는 점이에요. Fast-dLLM 논문에 나오는 예가 있는데요, 포커 족보가 들어갈 두 칸에 "high card"와 "full house"가 둘 다 그럴듯하면 "high house"라는 없는 말이 나올 수 있어요.
이걸 줄이려면 한 번에 확정하는 칸 수를 줄여야 하고, 그러면 빠르다는 장점도 줄어듭니다. 그래서 확실한 칸만 골라 동시에 푸는 방법 같은 개선책이 연구되고 있어요.
크기와 쓰는 환경도 아직 일반 LLM을 따라오지 못했어요. 2025년 확산형 언어모델 서베이에 따르면 초기에 공개된 확산형 모델은 대부분 70억에서 80억 파라미터였고, 한 번에 다룰 수 있는 글 길이도 대부분 4,096토큰까지였습니다.
답 길이를 미리 정해야 한다는 점도 걸려요. 빈칸을 몇 개 깔고 시작할지 먼저 정해야 하거든요. 속도를 높이는 기존 기술도 일부는 확산형에 그대로 쓸 수 없어서 새로 만들어야 했어요. 머큐리 3는 컨텍스트가 100만 토큰이라 이 숫자들이 그대로 들어맞지는 않습니다.
짧은 요약에서의 성능 비교
3문장 요약에서는 머큐리 3가 1.85초, Haiku가 2.34초로 0.5초밖에 차이 나지 않았어요. 뽀짝이님이 지피터스에 1주일 동안 올린 9편에 "다음 글을 3문장으로 요약해줘."를 똑같이 주고, 글마다 3번씩 불러 잰 평균입니다.
3문장 요약 (글 9편 × 3번)
머큐리 3 (medium) | Haiku | Sonnet | GPT-6.1 Terra | GPT-6 Luna | 머큐리 3 (low) | |
|---|---|---|---|---|---|---|
평균 시간 | 1.85초 | 2.34초 | 3.09초 | 4.03초 | 3.12초 | 1.94초 |
출력 토큰 (숨은 추론) | 582 (389) | 334 | 346 | 151 (0) | 176 (15) | 454 (257) |
핵심 포함 (41개 중) | 74% | 80% | 91% | 76% | 77% | 77% |
나머지는 Sonnet 3.09초, GPT-6 Luna 3.12초, GPT-6.1 Terra 4.03초였어요. 다섯 모델 중 머큐리가 가장 빨랐지만 1초에서 2초 차이예요.
시간을 쓰는 모양은 달랐어요. Haiku는 1.1초쯤 뒤에 첫 글자가 나오고 그다음부터 글자가 흘러나와요. 머큐리는 1.6초 동안 아무것도 안 보이다가 0.2초에서 0.3초 만에 요약 전체가 한꺼번에 나옵니다. 앞쪽 1.6초는 화면에 안 보이는 추론 시간이에요.
토큰으로 보면 머큐리는 한 번에 평균 582개를 냈고, 그중 389개(67%)가 숨은 추론이었어요. Haiku는 334개, Sonnet은 346개, Terra는 151개, Luna는 176개였습니다.
품질은 글마다 미리 뽑아 둔 핵심 41개가 요약에 들어갔는지로 채점했어요. Sonnet이 91%로 가장 높았고, 나머지 넷은 74%에서 80%로 비슷했습니다.
긴 번역에서의 속도 우위
9편을 하나로 합친 한국어 약 4만 5천 자를 영어로 번역시키니 머큐리 3가 53초에 끝냈어요. Luna는 2분 1초, Haiku는 2분 14초, Sonnet은 3분 13초, Terra는 3분 39초가 걸렸습니다. 답이 길어지자 확산형의 속도가 확실히 드러났어요.
영어 번역
머큐리 3 (medium) | Haiku | Sonnet | GPT-6.1 Terra | GPT-6 Luna | 머큐리 3 (low) | |
|---|---|---|---|---|---|---|
글 한 편 평균 시간 | 14.3초 | 15.8초 | 24.0초 | 30.7초 | 21.2초 | 5.4초 |
첫 글자까지 | 10.3초 | 1.4초 | 2.3초 | 2.9초 | 5.0초 | 0.9초 |
한 편 보이는 토큰 | 2,260 | 3,466 | 3,600 | 2,358 | 2,400 | 2,260 |
한 편 숨은 추론 토큰 | 5,466 | 126 | 149 | 28 | 188 | 185 |
9편 합친 글 | 53초 | 2분 14초 | 3분 13초 | 3분 39초 | 2분 1초 | 46초 |
글 한 편씩 번역할 때는 달랐어요. 머큐리가 첫 글자를 내기까지 평균 10.3초를 생각해서 한 편에 14.3초가 걸렸고, Haiku는 15.8초였어요. 추론 설정을 기본값 low로 낮추면 0.9초만 생각하고 5.4초에 끝났습니다.
숨은 추론 토큰을 보면 이유가 보여요. medium 머큐리는 한 편에 평균 5,466개를 생각했고, low 머큐리와 다른 네 모델은 200개 아래였어요. 보이는 번역 토큰은 머큐리 2,260개, Terra 2,358개, Luna 2,400개, Haiku 3,466개, Sonnet 3,600개였습니다.
같은 영어 번역인데 클로드 쪽이 1.5배쯤 많게 세는 거예요. 9편 합친 글도 머큐리 1만 8,976개, Haiku 3만 1,348개로 차이가 같았어요. 그래서 이 글에서는 토큰보다 끝나는 시간으로 비교했습니다.
번역 품질은 검토 에이전트에게 모델 이름을 가리고 맡겼어요. 빠진 문장, 틀린 숫자나 이름, 뜻이 바뀐 번역을 세니 Sonnet 0건, Haiku 11건, Luna 11건, Terra 13건, 머큐리 13건이었어요. 근데 검토할 때마다 Haiku가 26건에서 11건까지 흔들려서, Sonnet이 가장 적다는 것만 믿을 만했습니다.
회의 타이머 제작 실험
"발표자 이름을 넣으면 순서를 섞고 1인당 3분씩 재 주는 타이머 만들어줘. HTML 파일 하나로 만들어줘."를 다섯 모델에 3번씩 줬어요. 머큐리 3는 권장 설정 medium에서 평균 30.5초, 기본값 low에서 6.0초가 걸렸습니다.
회의 타이머 (3번)
머큐리 3 (medium) | Haiku | Sonnet | GPT-6.1 Terra | GPT-6 Luna | 머큐리 3 (low) | |
|---|---|---|---|---|---|---|
평균 시간 | 30.5초 | 16.5초 | 45.1초 | 44.0초 | 19.8초 | 6.0초 |
보이는 토큰 | 4,704 | 4,640 | 6,879 | 3,082 | 3,143 | 3,633 |
숨은 추론 토큰 | 14,573 | 153 | 963 | 525 | 540 | 655 |
동작 확인 | 정상 | 정상 | 정상 | 정상 | 정상 | 정상 |
medium의 세 번은 22.8초, 59.9초, 8.9초로 들쭉날쭉했고, 대부분이 첫 글자 전 생각하는 시간이었어요. 다른 모델은 Haiku 16.5초, Luna 19.8초, Terra 44.0초, Sonnet 45.1초였어요.
숨은 추론 토큰은 medium 머큐리가 평균 1만 4,573개로 low(655개)의 22배였어요. 다른 모델은 1,000개 아래였습니다. 보이는 코드는 Sonnet 6,879개, 머큐리 4,704개, Haiku 4,640개, Luna 3,143개, Terra 3,082개였어요.
만든 타이머는 브라우저에서 이름 넣기, 순서 섞기, 3분 카운트다운, 일시정지, 다음 발표자 넘기기를 하나씩 눌러 봤는데요, 쉬운 과제라 다섯 모델이 다 잘 만들었어요.
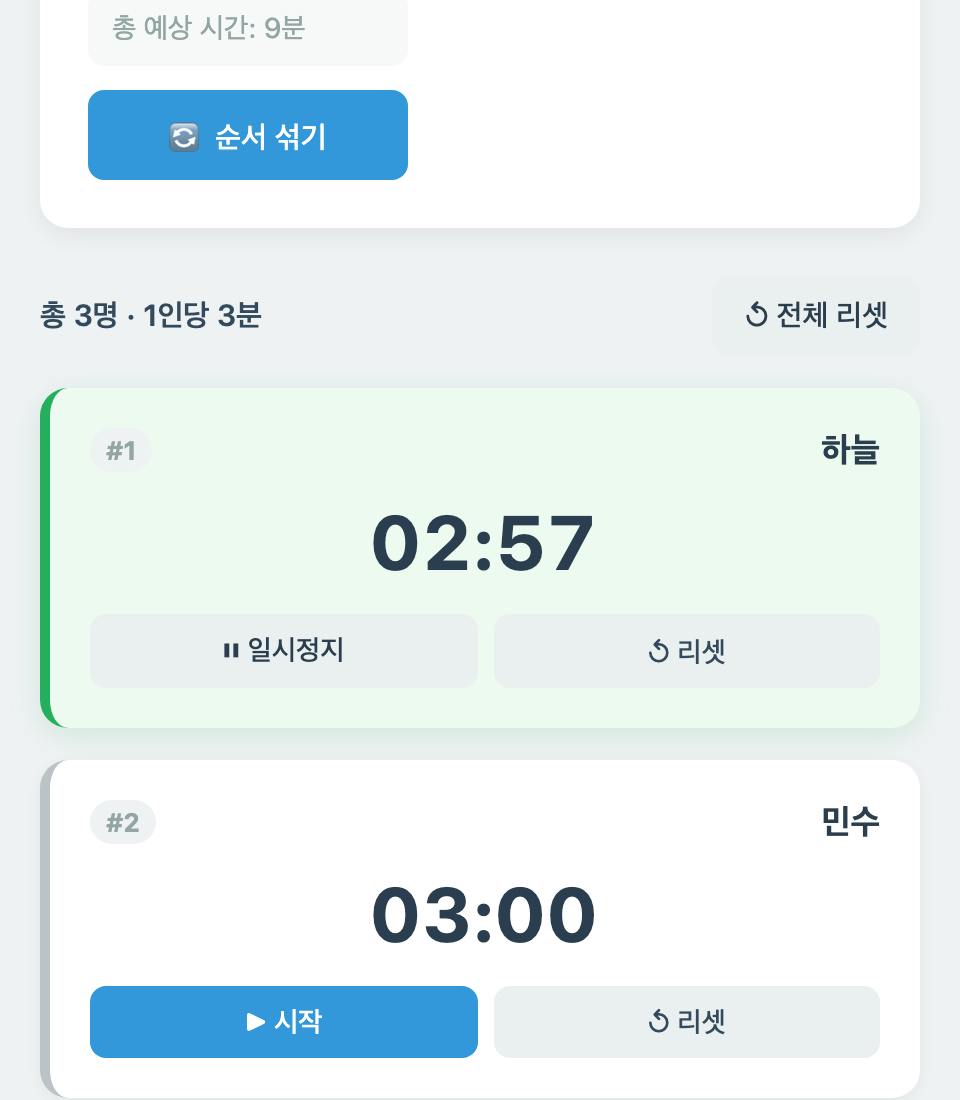
머큐리 3(medium)가 만든 회의 타이머. 발표자마다 카드에 타이머가 따로 있어요.
웹 엑셀 제작 도전
어려운 과제로 HTML 파일 하나짜리 웹 엑셀을 시켰어요. 수식 계산, SUM·AVERAGE·IF 같은 함수 8개, 다시 계산, 순환 참조 오류까지 넣어야 하는 과제예요. 시험 시트 26칸을 넣어 맞힌 칸을 셌습니다.
웹 엑셀 (3번)
머큐리 3 (medium) | Haiku | Sonnet | GPT-6.1 Terra | GPT-6 Luna | 머큐리 3 (low) | |
|---|---|---|---|---|---|---|
평균 시간 | 답 없음 | 2분 0초 | 1분 57초 | 1분 0초 | 43.5초 | 35.2초 |
보이는 토큰 | 0 | 9,042 | 8,820 | 4,281 | 4,375 | 5,907 |
숨은 추론 토큰 | 약 128,000 (한도 초과) | 21,300 | 8,829 | 963 | 1,866 | 16,847 |
맞힌 칸 (78칸 중) | 0 | 78 | 78 | 78 | 54 | 70 |
Haiku, Sonnet, Terra는 세 번 모두 78칸 중 78칸을 맞혔어요. 머큐리 3는 low에서 35초 만에 가장 먼저 내놓았지만 70칸이었고, Luna는 54칸이었습니다.
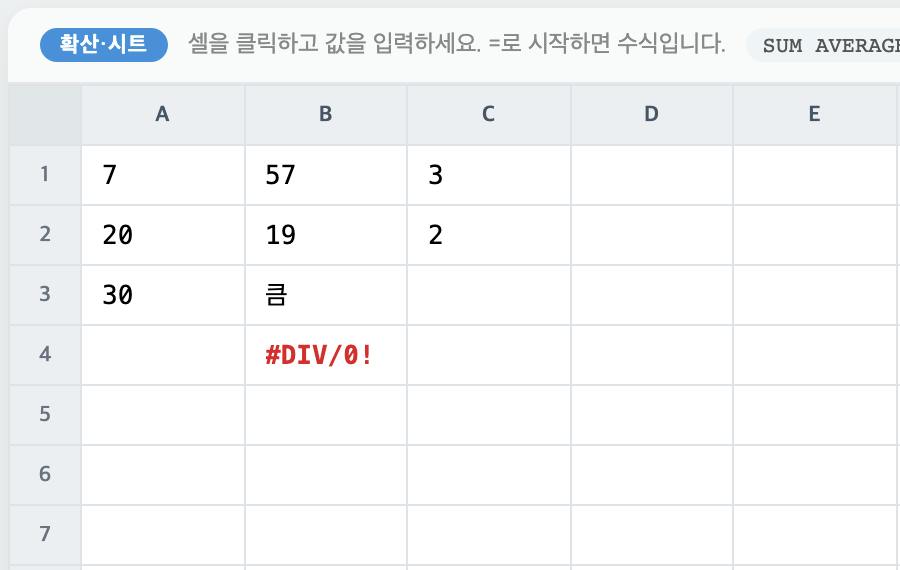
머큐리 3(low)가 만든 웹 엑셀. 순환 참조 오류가 떠야 할 C1·C2에 3과 2가 나왔어요.
숨은 추론 토큰은 Haiku 2만 1,300개, low 머큐리 1만 6,847개, Sonnet 8,829개, Luna 1,866개, Terra 963개였어요. 보이는 코드는 Haiku 9,042개, Sonnet 8,820개, 머큐리 5,907개, Luna 4,375개, Terra 4,281개였습니다.
medium 머큐리는 일곱 번 불러 일곱 번 다 답을 내지 못했어요. 출력 한도 64,000토큰을 화면에 안 보이는 추론으로 다 채우고 끝났거든요. 한도를 API 최대값인 131,072토큰으로 올려도 추론이 평균 12만 8,471개, 많게는 13만 231개로 늘어나 또 걸렸어요.
한 번에 2분 30초에서 3분이 걸렸고 글자는 한 자도 안 나왔어요. 추론 내용은 API가 보여 주지 않아서, 같은 생각을 되풀이했는지는 알 수 없습니다. 이 결과는 API로 한 번에 다 짜게 했을 때 이야기예요.
실험 과정과 문제점
처음에 크게 헛짚은 곳이 있었어요. Haiku를 클로드 코드(Claude Code)의 서브에이전트로 돌렸더니 24초가 나와서 머큐리(1.9초)보다 12배 느린 줄 알았거든요. 알고 보니 에이전트를 띄우고 파일을 읽는 시간까지 다 들어간 값이었어요.
그래서 이 순서로 다시 쟀어요.
모든 모델을 API로 직접 부르고 같은 지시문을 줘요. 예: "다음 글을 3문장으로 요약해줘."
추론 설정은 회사마다 권장하는 값으로 맞춰요. 이번엔 머큐리·Haiku·GPT는 medium, Sonnet은 high였어요. 머큐리 API는 기본값이 low라 따로 넣어야 해요.
초당 토큰보다 끝나는 시간과 초당 글자 수로 비교해요. 같은 영어 글을 Haiku 쪽이 1.5배쯤 많은 토큰으로 셉니다.
출력 한도는 숨은 추론까지 들어간다고 보고 넉넉히 잡아요.
GPT 두 모델은 렛서 게이트웨이를 거쳐 불렀고, GPT의 숨은 추론 토큰은 게이트웨이가 알려 준 값이에요. 머큐리 3도 OpenAI와 같은 형식이라 주소와 모델 이름(mercury-3)만 바꾸면 됩니다.
머큐리 3의 최적 활용법
머큐리 3는 기본값 low로 긴 답을 받을 때 가장 빨랐어요. 짧은 요약에서는 1초에서 2초 차이였고, 어려운 코딩에서는 머큐리도 30초 가까이 생각했습니다. 정확도는 Sonnet이 가장 높았고, 머큐리는 Haiku·Terra·Luna와 비슷했어요.
권장 설정 medium으로 올리면 생각하는 시간이 늘어요. 이번 실험에서는 그만큼 결과가 좋아진 곳은 찾지 못했어요. 긴 번역처럼 생각할 게 적고 답이 긴 일에 low로 쓰는 게 머큐리 3에 맞는 자리였습니다.
가격은 출시 할인으로 입력 100만 토큰에 0.10달러, 출력 100만 토큰에 0.35달러예요(2026년 10월 29일 기준).
참고한 자료
Inception, 추론 설정(reasoning effort) 문서: https://docs.inceptionlabs.ai/capabilities/reasoning-efforts.md
Fast-dLLM ("high house" 예시): https://arxiv.org/abs/2505.22618
확산형 언어모델 서베이: https://arxiv.org/abs/2508.10875
지피터스가 사내 AX를 어떻게 하는지는 지피터스는 사내 AX를 어떻게 할까에 모아 두었어요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
우리 회사에도 이런 자동화를 도입하고 싶다면
회사 업무에 맞춘 AI 교육을 함께 설계해요.
모션 그래픽은 전에 만들어둔 그 스킬인건가요? 이런 기술적인 거 설명할 때 아주 좋네요.
머큐리는 답변 고정 길이랑 context 크기가 어떻게 되나요?
채점은 어느 모델로 진행했나요? 추론 모델과 채점 모델이 같은 계열 모델이면 자기 선호 편향이 있을 수 있어서, 다른 계열 모델으로 하는게 좋습니다.
음... 현재 보여준 수준은 로컬에서 띄울 수 있는 고성능 오픈소스 모델이랑 비교를 더 해보면 좋을 것 같다는 생각이 드네요.