


소개
이번 교육을 들으면서 로컬 LLM(내 컴퓨터에서 직접 돌리는 AI)을 쓰기 시작했어요. 그런데 쓰다 보니 문득 이런 의심이 들더라고요.
"이 작은 모델이 답해주는 내용… 얼마나 믿어도 되는 거지?"
ChatGPT처럼 그럴듯하게 답은 하는데, 정말 맞는 말인지 확인할 길이 없잖아요. 그래서 같은 주제(일본 GDP 2020~2024)를 7개의 로컬 모델에 똑같이 물어서, 누가 얼마나 정확한지 직접 비교해봤습니다.
진행 방법
질문
일부러 사실 확인이 명확한 주제를 골랐어요. (요약처럼 주관적인 게 아니라, 정답이 있는 지식 질문)
"2020년부터 2024년까지 일본 GDP 알려줘"
테스트한 모델 7개
Gemma 4 (31B / 26B / E2B), Qwen 3.5 9B, EXAONE 3.5 (7.8B) / EXAONE 4.0 (1.2B) — 크기를 일부러 다양하게 골랐어요. 전부 LM Studio에서 같은 조건으로 돌렸습니다.
채점 기준 (실제 정답)
IMF·세계은행 기준 일본 명목 GDP(달러)는 이렇습니다.
2020
2021
2022
2023
2024
5.06조 $
5.04조 $
4.26조 $
4.20조 $
~4.0조 $
핵심은 2022년에 엔저(엔화 약세)로 5조 → 4.2조로 뚝 떨어진 흐름이에요. 이 하락 패턴을 잡았는지가 정확도의 관건이었습니다.
한국 게임 리더보드 스크린샷
결과와 배운 점
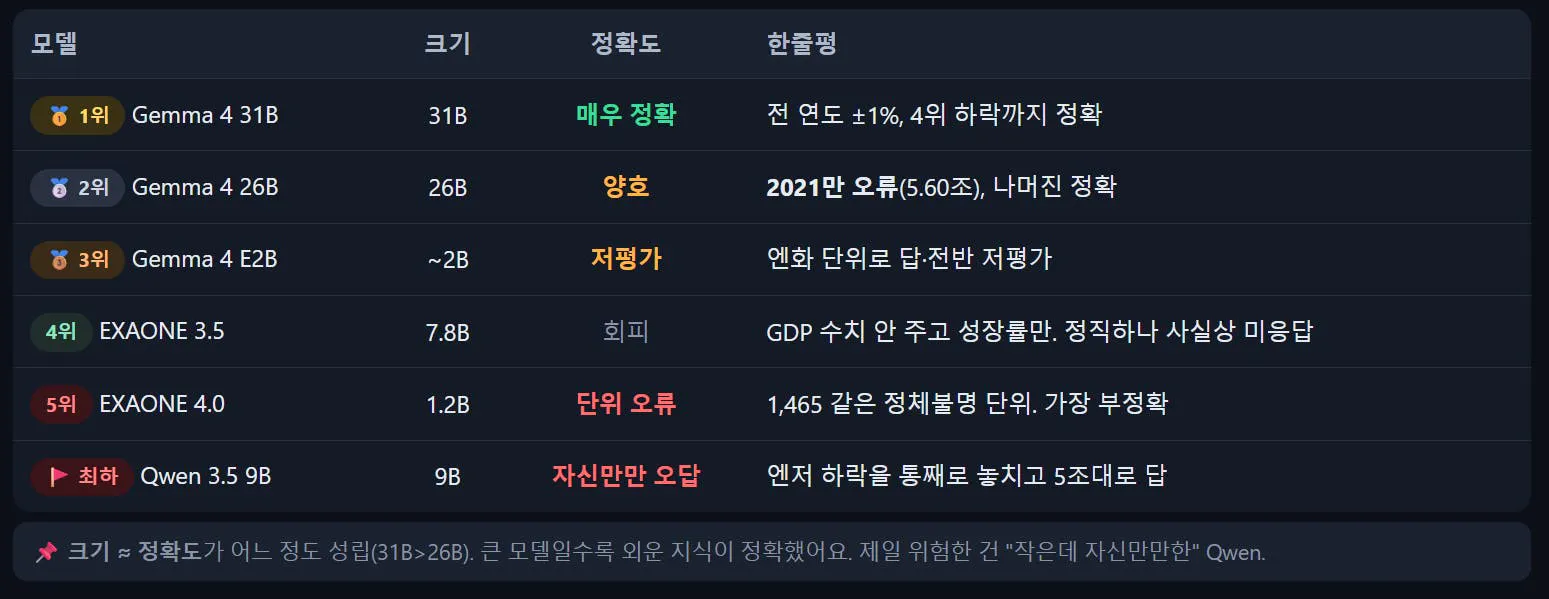
1. 큰 모델일수록 정확했어요. 31B가 거의 만점(전 연도 ±1%, "독일에 밀려 4위"까지 정확)이었고, 작아질수록 부정확해졌습니다. "지식을 묻는 작업"은 모델 크기를 어느 정도 따라가더라고요.
2. 작은 모델이 무조건 나쁜 건 아니었어요. 26B는 31B보다 가벼운데도 2021년 한 곳만 빼고 정확했거든요. "제일 정확한 것"과 "쓸 만한 것"이 꼭 같진 않다는 걸 느꼈습니다.
3. 제일 무서운 건 "자신만만한 오답"이었어요. Qwen 9B는 GDP 숫자에서 엔저 하락을 통째로 놓치고 5조대로 답하면서 그럴듯한 분석까지 붙였어요. 차라리 EXAONE처럼 "모르겠다"고 회피한 게 나았죠. 틀린 걸 자신 있게 말하는 게 초보자한텐 제일 위험하더라고요.
그래서 배운 것
로컬 LLM의 "기억"은 그대로 믿으면 안 된다. 같은 질문인데 답이 4.1조~5.6조까지 출렁였어요.
로컬 LLM에게는 "외운 지식을 꺼내달라"고 하기보다, "이 자료를 보고 답해줘"라고 자료를 직접 깔아주는 방식이 훨씬 안전하고 정확하더라고요. 즉 모델의 머릿속 기억에 의존하지 말고, 답에 필요한 자료를 직접 제공(RAG)해서 그 안에서 답하게 하는 거죠. 혹은 Hermes 같은 에이전트에 검색 스킬을 붙여서 "수치 같은 건 검색해서 답해줘"라고 시키면 많은 보완이 되지 않을까 싶었어요. (아직 실험은 안 해봤고, 이건 다음에 직접 해보고 공유할게요.) 작은 모델일수록 이런 방식이 더 잘 맞고 답변 속도가 빨라 유용할 것 같아요.
생각해보면 당연해요. 작은 모델은 "외워둔 지식"은 부족해도, 눈앞에 자료를 깔아주면 그걸 읽고 정리하는 건 잘하거든요. (그래서 요약 같은 작업은 작은 모델로도 충분합니다 — 이건 다음 편에서!)
한 가지 더 — 모델마다 "지식이 멈춘 시점"이 다 달라요. 예를 들어 EXAONE 3.5(7.8B)는 LM Studio에 올라온 지 1년 반쯤 된 버전이라 학습 컷오프가 오래됐고, 그래서 최신 수치엔 보수적으로 "실시간 데이터 접근 불가"라며 회피했어요. 모델 목록을 보면 업로드 시점이 286일~538일로 제각각인데, 이렇게 모델마다 아는 시점이 다르니 "최신·정확한 지식"을 모델 기억에 맡기는 것 자체가 불안정하더라고요. 결국 답은 같아요 — 필요한 자료를 직접 줘서(RAG) 그 안에서 답하게 하기.
도움 받은 글 (옵션)
정답 기준: IMF·세계은행·Macrotrends 공개 데이터
