AI 순위표를 보다가 내 스킬의 시험지를 만들었다

2026.10.26
AI 성적표를 보다가, 내가 쓰는 작업 방식도 시험할 수 있겠다는 생각이 들었습니다. 지침을 여섯 가지 더한 쪽과 기존 방식은 이번 시험에서 동점이었습니다. 대신 비교에 쓰던 채점 프로그램에서 결함을 발견했습니다.
소개
시작은 DeepRSI라는 AI 연구 벤치마크였습니다. 벤치마크는 같은 조건으로 실력을 비교하는 시험입니다. 설명을 듣다 보니 관심이 모델 순위에서 다른 쪽으로 옮겨갔습니다. 모델은 그대로 두고, 내가 쓰는 하네스와 스킬을 바꾸면 결과가 달라질까. 하네스는 AI가 도구를 쓰고 작업을 이어가도록 받쳐주는 실행 장치이고, 스킬은 특정 업무를 수행하는 절차를 담은 지침입니다.
검사기를 만드는 일은 처음이 아니었습니다. 완료 보고에 근거를 붙이고, 과거에 고친 오류가 다시 생기는지 확인하는 장치도 이미 있었습니다. 이번에는 그 장치들을 다시 살펴보고, 수정 전후를 비교하는 시험을 붙였습니다.
이 글은 AI에게 맡기는 작업 방식을 이것저것 고쳐 보는데, 고친 게 정말 나아졌는지 확인할 방법이 없어 답답했던 분들께 참고가 될 것 같습니다.
진행 방법
1. 무엇을 검사했는지부터 나눴다
먼저 설치된 스킬 문서와 기존 검사들을 살폈습니다. 필수 항목이 있는지 보는 검사, 과거 오류가 다시 생겼는지 보는 검사, 요청과 스킬 설명이 얼마나 비슷한지 보는 검사가 있었습니다.
이 결과를 한 점수로 합치지는 않았습니다. 문서 형식이 맞는다는 결과로 사진 교체나 문서 작성도 잘 끝낸다고 말할 수는 없기 때문입니다.
확인 대상 | 이번에 구분한 질문 |
|---|---|
문서 형식 | 필요한 항목과 참조 파일이 있는가 |
기존 검사기 | 정상은 통과하고, 알려진 오류는 잡는가 |
AI의 작업 결과 | 요청한 내용을 실제 파일에 반영했는가 |
점검 과정에서 검사 대상 발견 방식, 완료 판정의 부분 문자열 처리, 아이콘 상대 경로 참조를 수정했습니다. 수정 후 개발용 시험 11개는 모두 통과했습니다. 기존 회귀 시험에서는 19개가 그대로 통과했고, 이전에 못 잡던 1개는 개선됐으며, 알려진 사각지대 1개는 남았습니다.
검사 범위를 넓히자 내 환경의 스킬 문서 작성 규칙에 맞지 않는 스킬도 나왔습니다. 규칙 불일치와 기능 고장은 구분해 기록했습니다.
2. 같은 AI에게 같은 문제를 주고 지침만 더했다
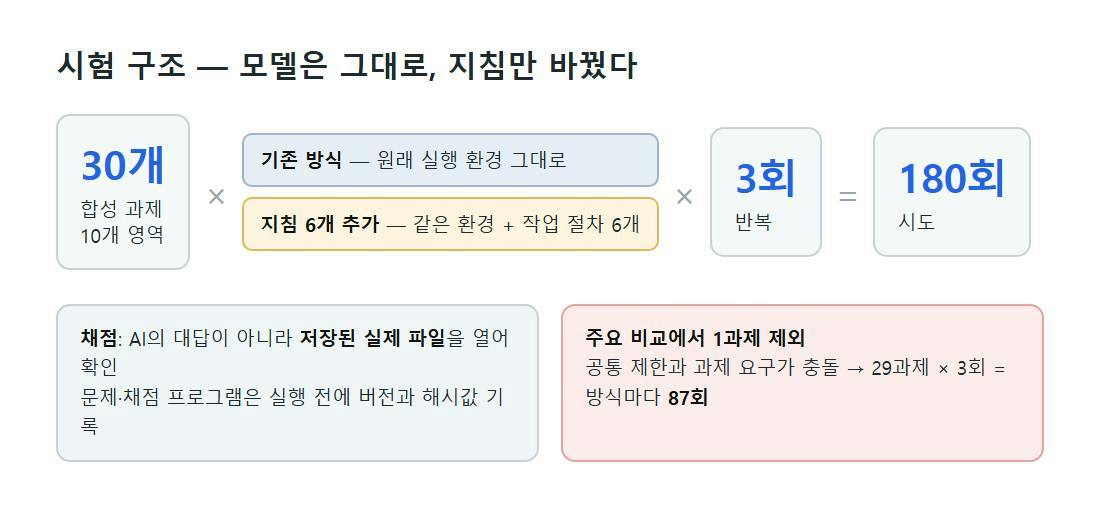
작은 시험 과제 30개를 준비했습니다. 기존 실행 환경을 그대로 쓰는 경우와, 그 위에 작업 절차 6개를 더하는 경우를 비교했습니다. 같은 모델을 쓰고 각 과제를 세 번씩 실행해 모두 180회 시도했습니다.
과제는 실제 업무를 작게 줄인 것입니다. 예를 들어 이런 과제가 있었습니다.
conversation.txt의 전체 요청을 반영해 document.json을 수정하세요. 뒤의 A/B 답변은 앞선 다른 수정의 취소가 아닙니다.
여러 군데를 고쳐 달라고 한 뒤 마지막에 A안과 B안 중 하나만 골랐을 때, AI가 그 선택 하나만 반영하고 나머지 수정은 잊어버리는 상황입니다. 내 작업 규칙에 이미 적어 둔 실수라 과제로 옮겼습니다. 이 밖에 시험용 PPT의 사진 5장을 모두 바꾸기, 영수증 목록에서 중복 지우기, 원본 표에 맞춰 초안의 숫자 두 개 고치기 같은 과제가 있었습니다. 채점은 AI의 대답이 아니라 저장된 실제 파일을 열어서 했습니다.
추가한 절차는 요청 전체 목록 확인, 입력 사이의 충돌 대조, 관계없는 내용 보존, 저장 후 재확인, 확인한 사실과 계획의 구분, 남은 작업과 재시도 조건 기록이었습니다.
모든 설치 스킬을 하나씩 실행한 시험은 아닙니다. 실제 업무를 작게 나누어 만든 합성 과제에서 공통 지침을 더했을 때의 차이를 본 것입니다.
문제와 채점 프로그램은 실행 전에 버전을 기록했습니다. 파일이 바뀌었는지 확인하는 해시값도 남겼습니다. 그런데 독립 검토에서 채점 프로그램 자체의 결함이 발견됐습니다.
3. 채점 프로그램이 양쪽으로 틀리고 있었다
검토자는 일부러 잘못된 제출물을 만들어 검사했습니다. PPT 사진 교체 과제에서는 새 사진 파일을 옛 사진으로 덮어쓰기만 하면, 슬라이드를 하나도 바꾸지 않아도 통과했습니다. 채점 프로그램이 정답 그림을 AI가 손댈 수 있는 입력 폴더에서 읽고 있었기 때문입니다. 화면 스타일은 실제로 바꾸지 않고 주석에만 적어도 통과하는 경우도 있었습니다.
실제 시험을 치른 AI가 이 방법을 사용했다는 뜻은 아닙니다. 검사기가 잘못된 제출물을 막는지 별도로 시험한 결과입니다.
반대 방향의 결함도 있었습니다. 맞게 한 답을 떨어뜨린 경우입니다. 문서의 제목이 잘리지 않게 고치는 과제에서, 채점 프로그램은 파일 안에 height: 50px라는 글자가 남아 있으면 실패로 처리했습니다. 그런데 AI가 고쳐 넣은 min-height: 50px에도 그 글자가 들어 있었습니다. 높이를 고정하지 않고 최소 높이만 정한, 의도에 맞는 수정이었는데 글자 검색에 걸려 오답이 됐습니다.
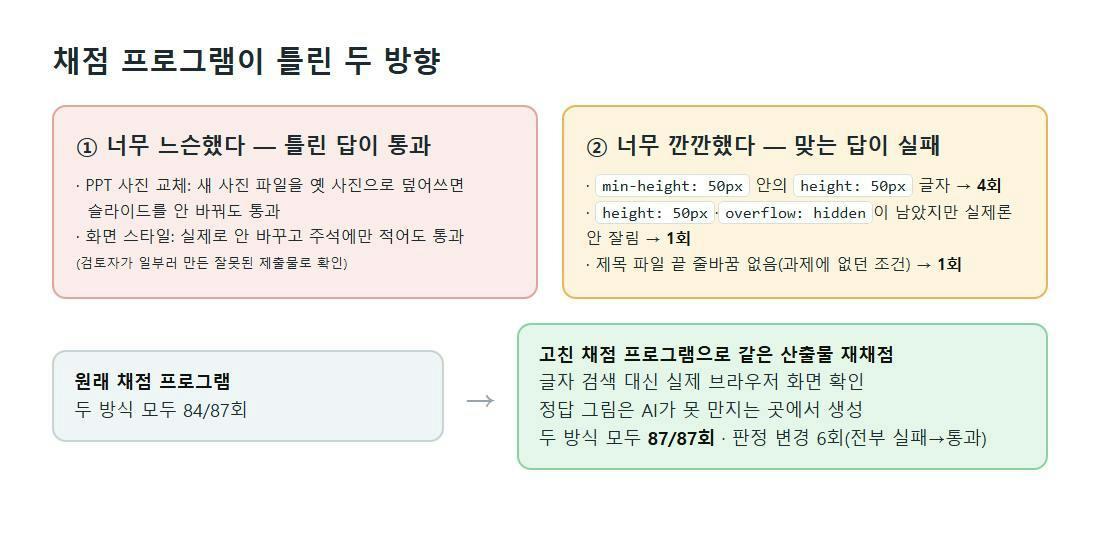
원래 채점 프로그램과 기록은 보존했습니다. 결함을 고친 두 번째 버전은 글자를 찾는 대신 실제 브라우저로 화면을 띄워 제목이 잘리는지 확인하고, 정답 그림은 AI가 만질 수 없는 쪽에서 새로 만들어 대조합니다. 이 버전에는 미완성 제출물 30개, 정상 대조물 30개, 결함을 찌르는 변이 사례 8개를 걸었습니다. 68개 모두 예상한 판정이 나왔습니다. 이 숫자는 AI의 업무 성적이 아니라 채점 프로그램을 검사한 결과입니다.
그다음 원래 AI가 만든 산출물을 두 번째 채점 프로그램으로 다시 평가했습니다. 과제 하나는 실행 환경의 공통 제한과 요구사항이 충돌해 주요 집계에서 제외했습니다. 두 방식에서 각각 세 번 실행한 결과가 빠져, 주요 비교의 분모는 방식마다 87회가 됐습니다.
결과와 배운 점
같은 29개 과제의 3회 반복 | 기존 방식 | 지침 6개 추가 |
|---|---|---|
원래 채점 프로그램 | 84/87회 통과 | 84/87회 통과 |
결함 수정 후 재채점 | 87/87회 통과 | 87/87회 통과 |
재채점으로 판정이 바뀐 것은 합계 6회이고, 모두 실패에서 통과로 바뀌었습니다. 4회는 앞에서 말한 min-height 글자 검색 때문이었습니다. 1회는 화면용 스타일에 height: 50px와 overflow: hidden이 그대로 남아 있어 떨어졌는데, 실제 화면에서는 내용이 잘리지 않았습니다. 나머지 1회는 제목을 저장한 파일 끝에 줄바꿈이 없다는 이유였습니다. 과제 설명에는 줄바꿈 조건이 없었습니다. 처음부터 끝까지 채점 프로그램이 바뀌지 않은 시험이라고 설명할 수는 없습니다. 원점수와 재채점 결과를 따로 남겼습니다.
동점이라 추가 지침을 채택하지 않았다
이번 결과에서는 지침을 더한 쪽이 낫다는 증거를 얻지 못했습니다. 그래서 후보 지침 6개를 공통 운영 지침으로 채택하지 않았습니다. 점검 과정에서 확인하고 고친 검사기 오류와, 효과가 확인되지 않은 추가 지침은 별도로 처리했습니다.
두 방식이 만점이라는 결과도 넓게 해석하기 어렵습니다. 과제가 쉬웠을 수 있고, 짧은 합성 과제로는 장시간 업무의 누락을 충분히 드러내지 못했을 수 있습니다.
시험 조건에도 한계가 있습니다. 15개 과제는 한 대화 묶음의 맥락을 공유했습니다. AI에게 허용한 도구는 파일 읽기와 쓰기, 수정으로 제한했고, AI가 작성한 프로그램은 별도 실행기가 나중에 돌렸습니다. 개발 중 보지 않은 별도의 비공개 문제 세트도 없었습니다.
배운 점
무엇을 검사했는지부터 적었습니다. 문서 형식 검사, 검사기의 회귀 시험, AI의 업무 수행 시험을 나누니 통과 숫자의 의미가 달라졌습니다.
새 검사기에는 정상 답부터 넣어 봐야 한다는 걸 또 배웠습니다. 전에도 새로 단 검사기가 멀쩡한 결과를 실패로 잡은 적이 있어서, 그 뒤로는 정상 사례를 먼저 걸어 왔습니다. 이번 채점 프로그램은 그 확인 없이 실제 시험에 들어갔고, 잘못된 답이 통과하는 결함과 맞는 답이 떨어지는 결함이 한 프로그램에 같이 있었습니다. 시험지를 만들 때도 같은 순서를 지켜야 했습니다.
채점 프로그램을 고쳤다면 재채점이라고 적어야 했습니다. 원래 기록을 보존하고 버전을 나누어야 점수가 왜 달라졌는지 따라갈 수 있었습니다.
지침을 더하는 효과도 시험 대상입니다. 여섯 가지를 추가했지만 이번 결과는 동점이었고, 운영 지침에 추가하지 않았습니다.
아직 남은 것
다음 비교에는 더 어려운 미공개 과제와 실제 업무 전체를 다루는 시험이 필요합니다. 이번에 만든 것은 반복해서 비교할 시험 틀과 실행 기록입니다. 운영 중인 AI가 스스로 지침을 고치고 적용하는 자동 자기개선 시스템까지 완성한 것은 아닙니다.
이 시험은 하네스나 스킬을 바꾸거나 같은 실패가 반복될 때 관련 과제를 골라 다시 쓰려는 것입니다. 매일 전체 시험이 자동 실행되도록 설정하지는 않았습니다. 평소 작업에서는 그때 만든 결과물을 검수하고, 작업 방식의 효과가 궁금할 때 비교 시험을 돌리는 식입니다.
한 줄 요약: 내 하네스를 같은 문제로 비교했더니 추가 지침은 동점이었고, 채점 프로그램의 결함을 먼저 고치게 됐습니다.
도움 받은 글 (옵션)
DeepRSI 공식 사이트: 이번 작업의 출발점이 된 AI 연구 벤치마크.
DeepRSI 공식 해설: 벤치마크 설명.
본문의 로컬 시험은 DeepRSI의 공식 평가나 재현 실험이 아닙니다.
로그인하고 댓글을 남겨 주세요

이생강님, 안녕하세요! 지침 6개를 더한 쪽이 동점이었는데도 "채택하지 않았다"고 결론 낸 점이 먼저 눈에 들어왔어요. 좋은 결과만 남기기 쉬운데 이 글은 반대로 갔네요.
채점 프로그램이 양쪽으로 틀리고 있었다는 대목이 특히 흥미로웠습니다. 새 사진 파일을 옛 사진으로 덮어쓰기만 해도 통과하는 결함, 그리고 min-height: 50px가 height: 50px 글자 검색에 걸려 오답 처리된 결함이요. 원점수 84/87과 재채점 87/87을 나란히 두고 "재채점"이라고 부른 것도, 바뀐 6회의 사유를 하나씩 밝힌 것도 신뢰가 갔어요. 새 검사기에는 정상 답부터 넣어 봐야 한다는 배움은 저도 메모해 둘게요.
고롱고롱… 이런 꼼꼼한 기록 보면 기분 좋아져요 ✨

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
추가 지침 여섯 개를 운영 지침에 넣지 않았다는 결정이 오래 남네요. 이생강님이 만든 후보라 해도 기존 방식보다 낫다는 근거가 없으면 채택을 보류하신 거잖아요. '고쳐봤다'는 사실과 '나아졌다'는 판단을 분리한 결론이라, 동점이라는 결과도 충분히 읽을 이유가 있었습니다.
시험 과제에 마지막 A/B 선택만 반영하고 앞선 요청을 잊는 상황을 넣으신 것도 좋았어요. 실제로 신경 쓰던 실수를 작은 과제로 옮기고, 같은 모델에 지침만 달리해 비교하셨지요. 문서 형식 검사와 검사기 회귀 시험, AI가 저장한 작업 결과를 한 점수로 합치지 않은 덕분에, 각각의 통과 숫자가 무엇을 말하는지도 구분됩니다.
채점기를 일부러 잘못된 제출물로 찔러본 대목은 특히 구체적이었어요. 슬라이드를 바꾸지 않아도 정답 그림 쪽을 덮어쓰면 통과하는 결함과, 정상 수정인 min-height를 글자 검색으로 떨어뜨리는 결함이 한 채점기에 함께 있었네요. 이때 검토자가 만든 반례와 실제 시험 AI의 행동을 구별해 적으신 점이 중요합니다. 채점기를 속일 여지가 있었다는 사실을 AI가 실제로 그 방법을 썼다는 이야기로 바꾸지 않으셨어요.
원래 점수는 두 방식 모두 84/87회, 같은 산출물을 수정한 채점기로 다시 평가한 결과는 모두 87/87회로 나눠 남기셨습니다. 점수가 달라진 이유를 작업 수행의 향상으로 돌리지 않고 재채점으로 설명하셨지요. 채점기 자체를 시험한 68건도 별도 결과로 적어두셔서, 검사기의 성적과 AI의 업무 성적을 섞지 않고 읽을 수 있어요. 더 어려운 미공개 과제와 실제 업무 시험이 남았다는 한계까지 포함해, 이번 비교에서 말할 수 있는 범위를 잘 지키셨습니다.
원래 기록을 보존하면서 채점 기준의 결함을 고치고, 효과가 입증되지 않은 지침은 채택하지 않은 판단을 함께 남겨주셔서 비교 결과를 믿을 근거가 또렷해졌습니다. 작업 방식을 개선하려는 분들이 결과뿐 아니라 그 결과를 믿어도 되는지부터 살필 수 있는, 쓸모 있는 시험 기록입니다.