대시보드를 다시 확인히다

2026.08.12
소개
고무 생산 식물(Rubber-Producing Plant) 연구 논문을 모아 왔다. 카자흐스탄, 중국, 독일, 미국의 연구 그룹별로, 그리고 같은 주제별로 폴더를 나눠 PDF를 쌓아 두는 방식이었다.
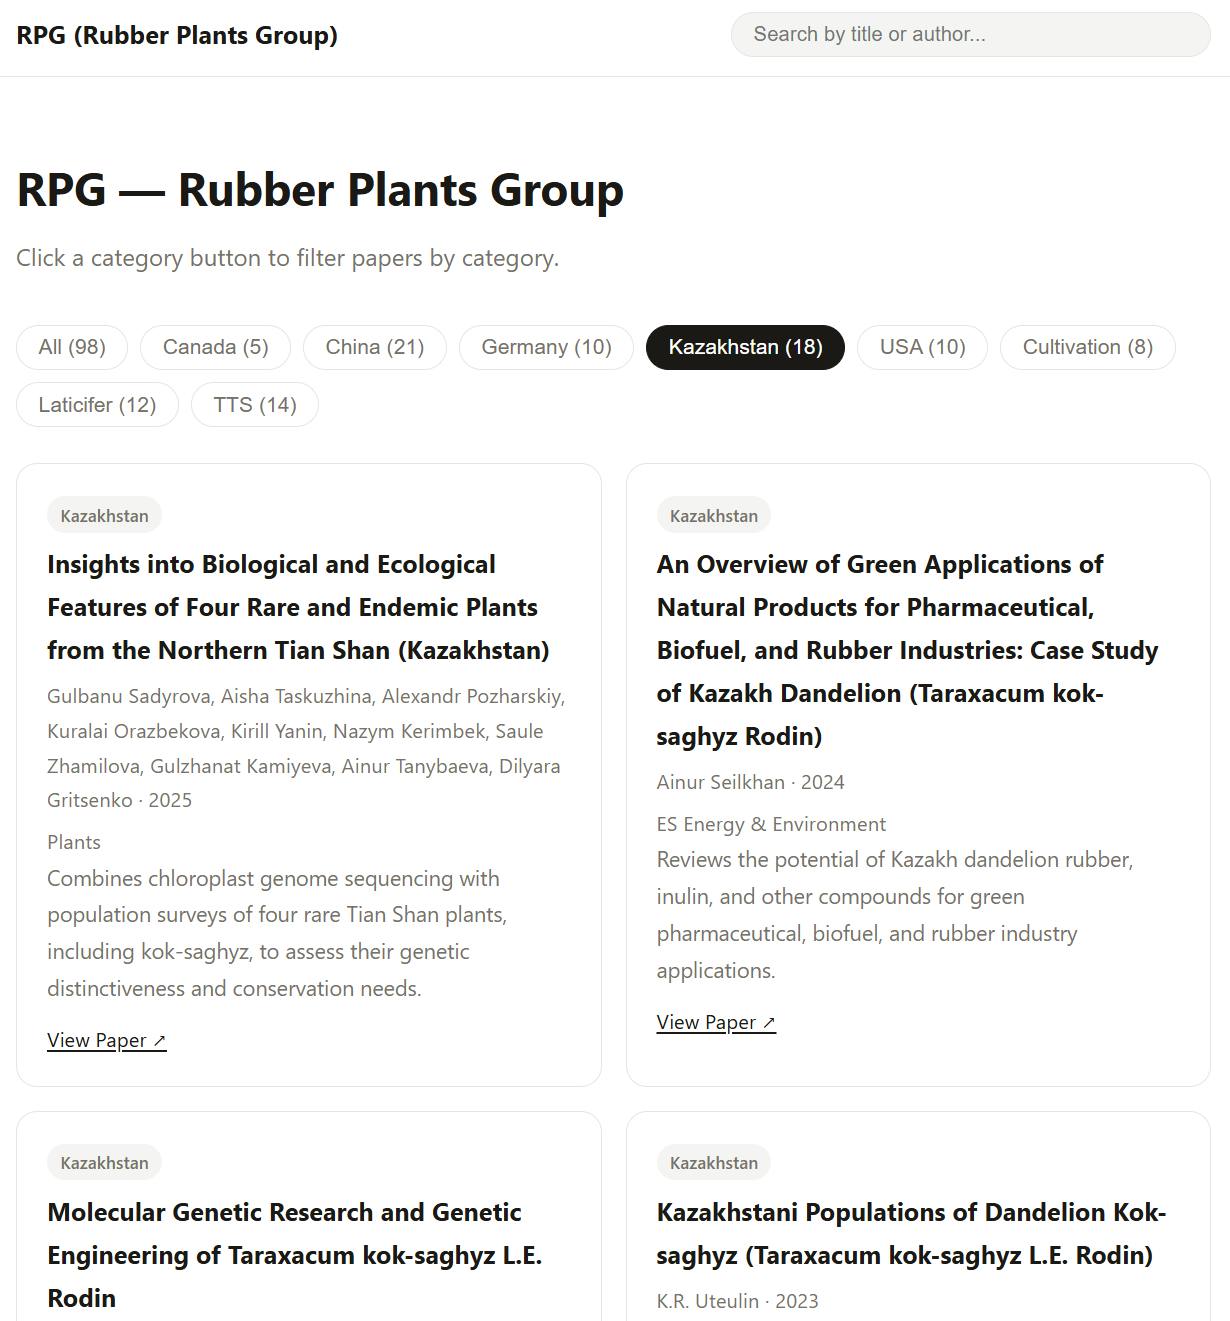
문제는 쌓아 두기만 해서는 전체가 보이지 않는다는 점이다. 어느 나라가 어느 주제를 파고 있는지, 최근 무엇이 늘었는지, 특정 저자의 논문이 몇 편인지를 폴더 탐색기로는 알 수 없다. 그래서 이 PDF 더미를 검색과 필터가 되는 웹 대시보드로 바꾸기로 했다.
이번 회차의 목표는 화면을 예쁘게 만드는 것이 아니라 데이터를 믿을 수 있게 만드는 것이었다. 대시보드에 논문 97 편이 올라가 있고 PDF 폴더에도 얼추 비슷한 수가 있는데, 이 둘이 정말로 일치하는지 한 번도 확인한 적이 없었기 때문이다.
진행 방법
사용한 도구
도구 | 용도 |
|---|---|
Claude Code (Opus 5) | 전 과정 진행 |
Astro 4.16 (Content Collections) | 정적 사이트 생성, 논문 메타데이터 스키마 검증 |
Vercel + GitHub | 배포와 버전 관리 |
PowerShell | PDF 폴더와 마크다운 전수 대조 스크립트 |
Claude Code 브라우저 미리보기 | 로컬 개발 서버 결과 확인 |
대시보드 구조
논문 1 편이 마크다운 파일 1 개다. 본문 없이 frontmatter만 쓴다. Astro의 Content Collections가 이 frontmatter를 스키마로 검증해 주기 때문에, 필드를 빠뜨리면 빌드가 실패한다. 데이터 품질 관리가 빌드 단계에서 자동으로 걸리는 셈이다.
전수 대조 스크립트
핵심은 이 부분이다. 마크다운 98 개의 frontmatter를 전부 파싱해서 중복 링크, 중복 제목, DOI가 아닌 링크를 한 번에 뽑아낸다. Claude가 짜서 바로 돌렸다. 나는 무슨 말인지 잘 모른다!
$rows = Get-ChildItem "src\content\papers\*.md" | ForEach-Object {
$t = Get-Content $_.FullName -Encoding UTF8 -Raw
$l = if ($t -match '(?m)^링크:\s*"(.*?)"') { $matches[1] } else { "" }
$ti = if ($t -match '(?m)^title:\s*"(.*?)"') { $matches[1] } else { "" }
[pscustomobject]@{ File=$_.BaseName; Link=$l; Title=$ti }
}
"총 $($rows.Count) 편"
"--- 중복 링크 ---"
$rows | Group-Object Link | Where-Object Count -gt 1 |
ForEach-Object { $_.Name; $_.Group.File }
"--- 중복 제목 ---"
$rows | Group-Object Title | Where-Object Count -gt 1 |
ForEach-Object { $_.Name; $_.Group.File }
"--- DOI 아닌 링크 ---"
$rows | Where-Object { $_.Link -notmatch 'doi.org' } |
Select-Object File, Link | Format-Table -AutoSize -Wrap
이런 대시보드가 만들어졌다.
결과와 배운 점
결과
논문 97 편 → 98 편. 누락돼 있던 Tan 2026 을 찾아 채웠다.
PDF 원본 99 개와 대시보드 항목의 전수 대응 관계를 처음으로 확정했다.
저널명 표기를 통일했고, 중복 링크와 중복 제목이 없음을 확인했다.
연도 오류 의심 2 건은 대시보드가 아니라 PDF 파일명이 틀린 것으로 판명났다.
배운 점
1. 개수가 맞는다고 내용이 맞는 것이 아니다
이게 제일 큰 교훈이다. 대조 전 대시보드는 97 편, PDF는 중복 2 건을 빼면 고유 97 편이었다. 숫자가 딱 맞으니 다 됐다고 넘어갈 뻔했다. 그런데 뜯어 보니 Tan 2026 이 빠져 있고, 대신 PDF가 없는 Mahlberg 1993 이 들어 있어서 우연히 숫자만 맞은 상태였다. 총계 검증은 검증이 아니다. 항목 대 항목으로 맞춰야 한다.
2. 파일명에 적어 둔 메타데이터를 믿지 말 것
"Gabit 2020", "Volis 2012" 처럼 파일명에 연도를 박아 두는 습관이 있는데, 이번에 둘 다 틀렸다. 하나는 접수 연도를 적은 것이고 하나는 그냥 오기였다. 다운로드하면서 대충 적은 이름이 몇 년 뒤에 원본 행세를 한다. 연도가 궁금하면 반드시 PDF 표제부를 볼 것.
3. 스키마가 있으면 품질 관리가 공짜
Astro Content Collections에 스키마를 걸어 두니, 필드를 빠뜨리거나 카테고리를 오타 내면 빌드가 실패한다. 사람이 검사하지 않아도 되는 영역이 생긴다.
앞으로의 계획
시각화와 통계 — 연도별 논문 수 추이, 국가별 주제 분포, 키워드 빈도를 차트로 얹으면 "요즘 어디가 무엇을 파고 있는지"가 한눈에 보일 것이다.
논문 추가 자동화 — 지금은 PDF를 넣고 마크다운을 만드는 흐름인데, PDF만 폴더에 떨어뜨리면 메타데이터가 채워지도록 만들고 싶다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

"개수가 맞는다고 내용이 맞는 것이 아니다"는 문장이 인상 깊어요. 97/97 숫자가 딱 맞아서 검증 끝났다고 넘어갈 수 있었는데, 항목 대 항목 전수 대조를 직접 돌려서 Tan 2026 누락을 잡아낸 과정이 설득력 있어요.
Astro Content Collections에 스키마를 걸어서 품질 검증을 빌드 단계에서 자동화한 것도 좋고요. 파일명에 적은 연도를 믿지 말고 PDF 표제부를 열어 확인해야 한다는 교훈도, 실제로 두 건이나 틀렸다는 게 있어야 납득이 되는 얘기인데 증거가 있어서 설명이 쉬워지네요.
시각화와 자동화 계획도 자연스럽게 다음 단계가 보여서, 다음 회차 글도 기대돼요 🐈⬛