텔레그램 봇 "하루"가 fal.ai 대신 로컬 FLUX로 그림 그리게 만들기 — Hermes 백엔드 교체 전말
2026.06.03
소개
나는 텔레그램 봇 "하루"(@yippunyi_bot) 를 Hermes라는 오픈소스 에이전트로 굴리고 있다. 하루한테 평소처럼 말로 "그림 그려줘" 하면 이미지가 돌아오게 만들고 싶었다. 마침 Mac(M4 Max)에 ComfyUI랑 FLUX 이미지 모델도 깔아둔 상태였다. "환경 다 됐겠지?" 하고 가볍게 점검부터 시켰는데 — 그 "다 됐겠지"가 오늘 하루를 잡아먹은 함정이었다.
목표: 하루에게 말로 지시 → 로컬 ComfyUI(FLUX) 로 무료 생성 → 텔레그램으로 그림 회신. fal.ai 같은 유료 클라우드는 안 쓰고.
왜 굳이? 봇이 그림을 그릴 때마다 fal.ai 크레딧이 깎였고, 결국 "크레딧 소진" 에러가 났다. 손에 M4 Max가 있는데 클라우드에 돈을 태우는 게 아까웠다.
> 전체 그림:
텔레그램 하루 → Hermes(두뇌 LLM) → ComfyUI(FLUX 화가) → 텔레그램으로 이미지
진행 방법
쓴 도구: Claude Code(점검·코딩 페어), ComfyUI(이미지 엔진), FLUX.1-dev fp8 16GB(이미지 모델), Hermes(텔레그램 봇 에이전트), Ollama(로컬 LLM: gemma4·qwen3.6), macOS launchd(자동시작).
"환경 됐겠지"의 배신 — 점검부터 헛발질
처음
~/Documents/ComfyUI를 열었더니main.py도 없고 모델 폴더도 텅 비어 있었다. 알고 보니 그건 데스크톱 앱의 데이터 폴더일 뿐, 진짜 프로그램이 아니었다. 진짜 설치본은 `~/comfy` 에 있었다(FLUX 16GB 포함, 이미 작동).하루의 정체: 단독 봇이 아니라 Hermes 에이전트가 구동하고 있었다. 그리고 내가 "준비해야 한다"던 텔레그램 토큰은 — 이미 Hermes의
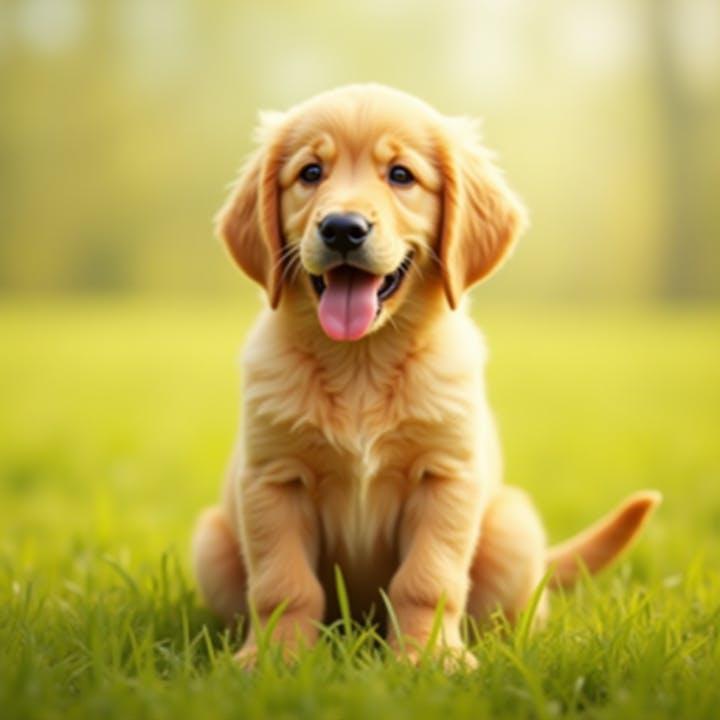
.env에 들어 있었다. 새로 발급이 아니라 이미 있던 것. (토큰 = @BotFather가 봇 만들 때 준 그 값)1차 테스트: ComfyUI 서버 켜고 스킬로 골든리트리버 한 장 뽑아봤다. 성공. "오 되네" 하고 곧장 텔레그램에서 하루한테 시켜봤더니…
[📷 로컬에서 처음 뽑은 골든리트리버 — retriever.png]
진짜 함정 — 하루는 fal.ai를 쓰고 있었다
텔레그램에서 "그려줘" → 하루의 답:
> "아이고, 죄송해요 😅 이미지 생성 서비스(fal.ai) 크레딧이 소진됐어요! … ComfyUI 로컬 셋업이 되면 거기서 무료로 그릴 수 있어요!"
로컬 ComfyUI가 멀쩡히 켜져 있는데, 봇은 엉뚱하게 유료 클라우드 fal.ai를 쓰고 있었다. 코드를 까보니 원인이 나왔다.
Hermes의
image_generate도구가 fal.ai 전용 하드코딩. 로컬 ComfyUI는 '스킬'로만 존재해서, 봇이 손쉬운 fal.ai 도구를 먼저 집어들었다.오늘의 핵심 깨달음:
"ComfyUI가 된다"≠"봇이 ComfyUI를 쓴다". 엔진이 도는 것과 봇이 그 엔진을 호출하는 건 완전히 다른 문제였다. 1부의 "되네"는 착각이었다.
백엔드를 갈아끼우다 — localhost URL이라는 결정타
가장 먼저 검증한 것: 텔레그램으로 이미지가 어떻게 전달되는가? 어댑터 코드를 팠더니, Hermes가 이미지 URL을 자기 서버에서 먼저 다운로드한 뒤 텔레그램에 업로드하는 구조였다.
이게 결정타였다. 즉 http://127.0.0.1:8188/view?... 같은 로컬 URL을 돌려줘도 텔레그램이 직접 접근할 필요가 없다. ngrok이나 공개 URL, 터널링 전부 불필요. ComfyUI가 자기 PNG를 HTTP로 서빙하니, 그 로컬 주소만 반환하면 끝.
그래서 image_generate 도구에 가드를 한 줄 넣어, 환경변수 HERMES_IMAGE_BACKEND=comfyui일 때 로컬 ComfyUI 백엔드로 위임하게 했다. 반환 형식({"success", "image": <url>})은 fal.ai와 똑같이 맞춰서 텔레그램 전송 배관을 그대로 재사용했다.
도구 진입부에 넣은 가드(핵심만):
# image_generation_tool.py — image_generate_tool() 시작부
if os.getenv("HERMES_IMAGE_BACKEND", "").strip().lower() == "comfyui":
    from tools.comfyui_image_backend import generate as comfyuigenerate
    return comfyuigenerate(
        prompt=prompt, aspect_ratio=aspect_ratio,
        num_inference_steps=num_inference_steps, seed=seed,
        num_images=num_images, output_format=output_format,
    )
# (실패 시 HERMES_IMAGE_FALLBACK_FAL=1이 아니면 fal로 안 넘어가고 에러 반환)
새로 만든 백엔드 모듈(표준 라이브러리만 사용 — Hermes 어떤 venv에서도 동작):
# tools/comfyui_image_backend.py (핵심 발췌)
import copy, json, os, random, time, uuid
from urllib import request as _request
from urllib.parse import urlencode
COMFYUI_URL = (os.getenv("COMFYUI_URL") or "http://127.0.0.1:8188").rstrip("/")
OLLAMA_URL = (os.getenv("OLLAMA_URL") or "http://127.0.0.1:11434").rstrip("/")
WORKFLOW = os.path.expanduser(os.getenv("COMFYUI_WORKFLOW") or "~/.hermes/comfyui_flux_workflow.json")
DEFAULT_STEPS = int(os.getenv("COMFYUI_STEPS") or "10")
_ASPECT = {"square": (1024,1024), "landscape": (1216,832), "portrait": (832,1216)}

def _post(url, obj, t=30):
    req = _request.Request(url, data=json.dumps(obj).encode(),
                           headers={"Content-Type": "application/json"}, method="POST")
    return json.loads(_request.urlopen(req, timeout=t).read() or b"{}")

def _get(url, t=10):
    return json.loads(_request.urlopen(url, timeout=t).read() or b"{}")

def evictollama(): # 순차정책: FLUX 로드 전 로컬 LLM 메모리 비우기
    try:
        for m in get(f"{OLLAMAURL}/api/ps", 5).get("models", []):
            name = m.get("name") or m.get("model")
            if name:
                post(f"{OLLAMAURL}/api/generate",
                     {"model": name, "prompt": "", "keep_alive": 0, "stream": False}, 10)
    except Exception:
        pass

def freecomfy(): # 순차정책: 생성 후 FLUX 언로드 (PNG는 디스크에 남아 /view 가능)
    try:
        post(f"{COMFYUIURL}/free", {"unload_models": True, "free_memory": True}, 10)
    except Exception:
        pass

def generate(prompt, aspect_ratio="landscape", num_inference_steps=None,
             seed=None, num_images=None, output_format=None):
    w, h = ASPECT.get((aspectratio or "landscape").lower(), _ASPECT["landscape"])
    seed = random.randint(0, 2**63 - 1) if (seed is None or int(seed) < 0) else int(seed)
    wf = copy.deepcopy(json.load(open(WORKFLOW, encoding="utf-8")))
    wf["6"]["inputs"]["text"] = prompt.strip() # 프롬프트
    wf["25"]["inputs"]["noise_seed"] = seed # 시드
    wf["27"]["inputs"]["width"], wf["27"]["inputs"]["height"] = w, h
    wf["17"]["inputs"]["steps"] = int(num_inference_steps or DEFAULT_STEPS)
    evictollama() # ← LLM 먼저 내림
    pid = post(f"{COMFYUIURL}/prompt", {"prompt": wf, "client_id": uuid.uuid4().hex})["prompt_id"]
    outputs = None
    deadline = time.time() + 600
    while time.time() < deadline: # /history 폴링
        entry = get(f"{COMFYUIURL}/history/{pid}").get(pid)
        if entry and entry.get("outputs"):
            outputs = entry["outputs"]; break
        time.sleep(1.5)
    img = next(i for n in outputs.values() if n.get("images") for i in n["images"])
    url = f"{COMFYUI_URL}/view?" + urlencode(
        {"filename": img["filename"], "subfolder": img.get("subfolder",""), "type": img.get("type","output")})
    freecomfy() # ← FLUX 내림
    return json.dumps({"success": True, "image": url, "backend": "comfyui", "seed": seed}, ensure_ascii=False)
막힌 점과 해결 — 36GB 메모리 압박
M4 Max인데 RAM이 로그마다 64GB / 36GB로 엇갈렸다. 직접 확인(
sysctl hw.memsize)하니 실제 36GB였다(64GB 로그는 데스크톱 앱의 오기).계산해보니 FLUX(~16GB) + 로컬 LLM Gemma4(~10GB) + OS(~10GB) ≈ 40GB > 36GB → 스왑·발열. 동시 상주하면 안 됐다.
해결 = 순차 정책. 백엔드가 FLUX 로드 전 Ollama 모델을 언로드(
keep_alive:0)하고, 생성 후 ComfyUI/free로 FLUX를 내린다. → 두 모델이 절대 같은 순간에 메모리에 안 올라온다. (위 코드의_evict_ollama()/_free_comfy())
설정은 ~/.hermes/.env에 추가하고 게이트웨이를 재시작했다:
# ~/.hermes/.env
HERMES_IMAGE_BACKEND=comfyui
COMFYUI_URL=http://127.0.0.1:8188
COMFYUI_WORKFLOW=~/.hermes/comfyui_flux_workflow.json
COMFYUI_STEPS=10
COMFYUI_EVICT_OLLAMA=1 # FLUX 전에 로컬 LLM 내림
COMFYUI_FREE_AFTER=1 # 생성 후 FLUX 내림 (순차 보장)
HERMES_IMAGE_FALLBACK_FAL=0 # fal.ai로 자동 폴백 안 함
# .env 변경은 게이트웨이 재시작해야 반영됨 (SOUL.md 페르소나는 핫리로드)
~/.hermes/hermes-agent/venv/bin/python hermes_cli/main.py gateway restart
결과와 배운 점
결과
텔레그램에서 하루에게 "풀밭에서 나비랑 뛰노는 너 그려줘" → fal.ai 에러 없이 로컬 FLUX로 코기 그림 생성 성공. 🎉
비용 0원(완전 로컬), 두뇌는 Claude+Gemma4 그대로, 화가만 로컬 FLUX로 교체.
마지막으로 ComfyUI 서버를 launchd LaunchAgent로 등록 → Mac 재부팅(로그인) 시 자동 기동 + 크래시 시 자동 복구.
[📷 텔레그램 하루가 보내준 코기 — corgi.png]
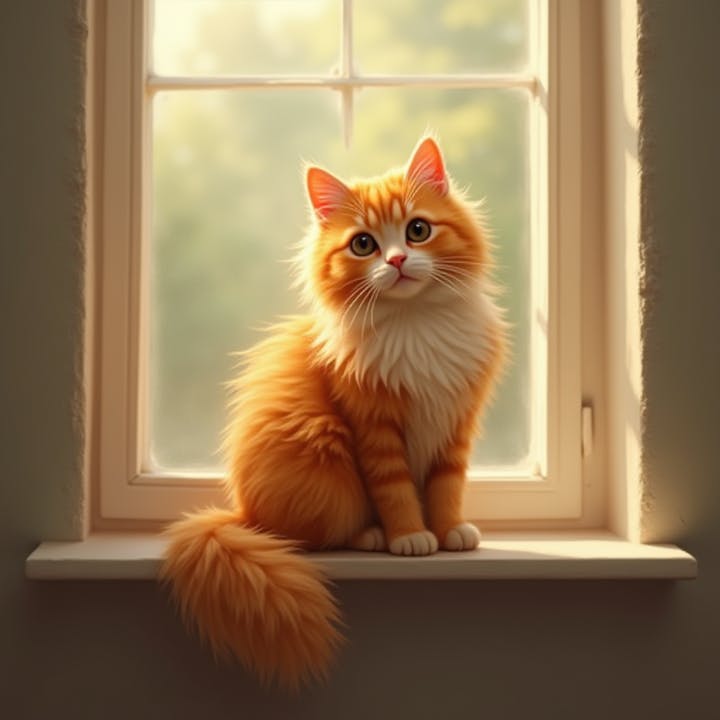
[📷 중간 테스트로 뽑은 창가의 고양이 — cat.png]
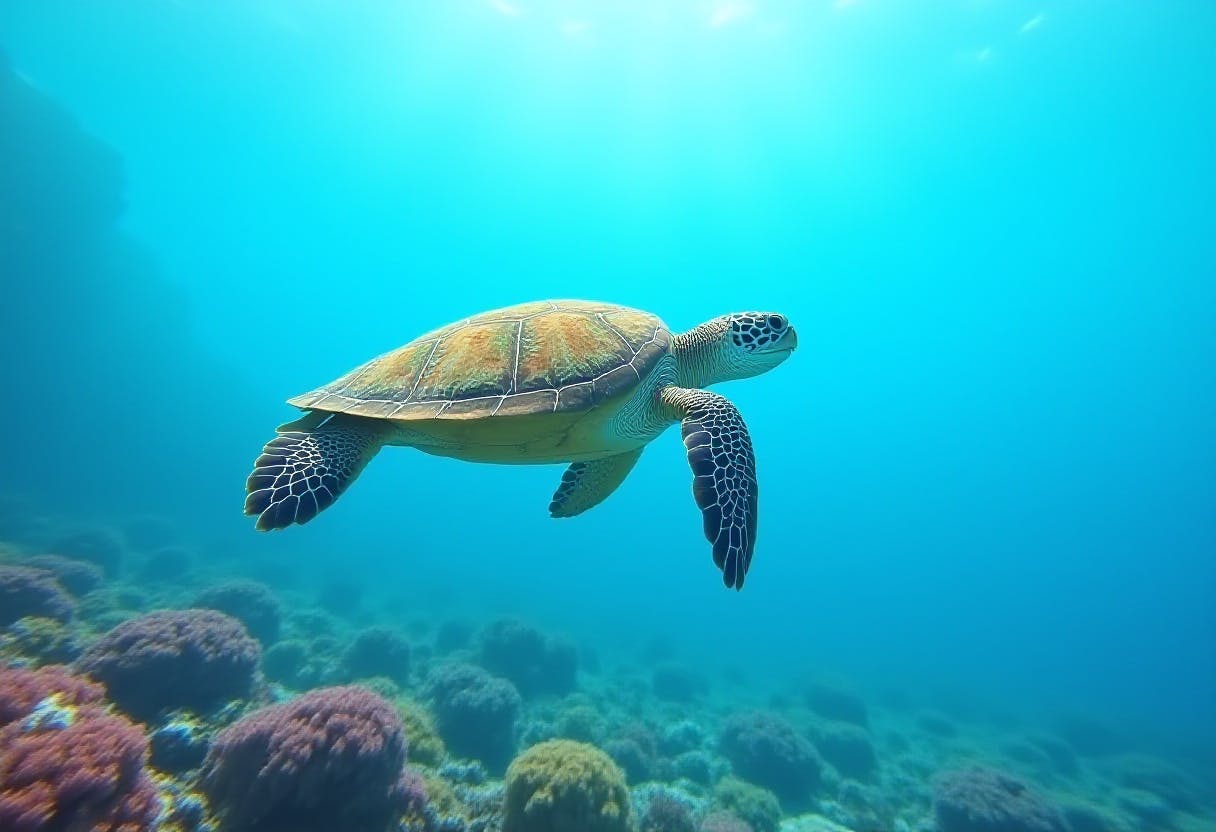
[📷 최종 하루에게 지시해 그린 거북이— turtle.png]
launchd 자동시작 plist:
<!-- ~/Library/LaunchAgents/com.kyuhwangyeon.comfyui.plist -->
<plist version="1.0"><dict>
    <key>Label</key><string>com.kyuhwangyeon.comfyui</string>
    <key>ProgramArguments</key>
    <array>
        <string>/Users/kyuhwangyeon/comfy/.venv/bin/python</string>
        <string>main.py</string><string>--port</string><string>8188</string>
    </array>
    <key>WorkingDirectory</key><string>/Users/kyuhwangyeon/comfy</string>
    <key>RunAtLoad</key><true/> <!-- 로그인 시 자동시작 -->
    <key>KeepAlive</key><true/> <!-- 크래시 시 자동복구 -->
</dict></plist>
# 등록 / 재시작 / 해제
launchctl bootstrap gui/$(id -u) ~/Library/LaunchAgents/com.kyuhwangyeon.comfyui.plist
launchctl kickstart -k gui/$(id -u)/com.kyuhwangyeon.comfyui
launchctl bootout gui/$(id -u)/com.kyuhwangyeon.comfyui
> 포인트: GPU(MPS) 쓰는 서버라 LaunchDaemon이 아니라 LaunchAgent로 등록한다. MPS는 로그인된 GUI 세션이 필요하기 때문.
핵심 팁
"엔진이 된다"와 "봇이 그 엔진을 쓴다"는 별개다. 반드시 봇으로 직접 끝까지 테스트할 것. (나는 스킬로만 테스트하고 "됐다"고 착각했다가 fal.ai 함정에 빠졌다.)
채팅 플랫폼이 이미지 URL을 서버에서 다운로드→업로드한다면,
localhostURL로 충분하다. 공개 URL·터널 불필요. 코드를 까서 이 전송 방식을 먼저 확인한 게 제일 큰 한 수였다.작은 메모리에서 LLM + 이미지모델은 순차로. 한쪽 쓰기 전에 다른 쪽을 명시적으로 언로드(
keep_alive:0//free)하면 36GB에서도 둘을 안전하게 굴린다.백엔드는 같은 반환 계약으로 갈아끼워라. fal과 동일한
{"success","image":url}을 돌려주니 봇·전송 코드를 한 줄도 안 고치고 교체됐다..env는 게이트웨이 재시작 필요, 페르소나 파일(SOUL.md)은 핫리로드. 둘을 헷갈리지 말 것.
시행착오 (숨기지 않고)
~/Documents/ComfyUI헛다리(실설치는~/comfy), RAM 64/36 혼선, "환경 됐겠지" 과신 → fal.ai 함정. 점검을 봇 단까지 안 끌고 간 게 패착.속도 대가: 순차 정책(생성 후 FLUX 언로드) 때문에 매번 FLUX를 16GB 재로드 → 1장에 ~2.5~3분(MPS, 10스텝). 빠르게 하려면
COMFYUI_FREE_AFTER=0으로 FLUX를 상주시키면 되지만, 그러면 Gemma4와 메모리 경쟁이 생긴다. 속도 vs 메모리의 트레이드오프.스킬 기본 FLUX 워크플로는 분리형 모델(t5xxl/ae 등)을 요구했는데, 내가 가진 건 올인원
flux1-dev-fp8라 안 맞았다. →CheckpointLoaderSimple기반 워크플로로 교체해서 해결.
앞으로 할 일
FLUX GGUF Q8로 경량화(~12.5GB, 메모리 절반)해서
free-after를 꺼도 여유 있게 → 속도 개선.화풍 프리셋, img2img(사진 넣고 변형), 그리고 두뇌까지 완전 로컬(Qwen3.6)로 오프라인 그림봇.
도움이 필요한 부분
M4 Max에서 FLUX 1장 ~2.5분은 좀 답답하다. MPS 가속/스텝 수/샘플러 튜닝으로 단축해본 분 계시면 팁 부탁드린다. (특히 fp8 vs GGUF 체감 속도 비교)
도움 받은 글 (옵션)
ComfyUI 공식 문서 — REST/`/prompt`·`/history`·`/view`·`/free` API
Hermes 에이전트 저장소 (텔레그램 게이트웨이 / 도구 구조)
(해당 시 참고한 지피터스 글 링크를 여기에)
로그인하고 댓글을 남겨 주세요

도구 백앤드를 추상화 시켜서 붙이기 좋겠네요!!!! 요사례는 그냥 클로드 코드에 이미지 처리로 하나 스킬박고 써도 좋을거같습니다. ㅎㅎ

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
오....도구만 바꾸고 기존 코드는 그대로 사용하신거 너무 좋네요
저도 comfyUI 사용해보려다 무슨 모델을 써야할지 몰랐는데 참고해서 저도 FLUX 한번 사용해봐야겠네요 나온 이미지가 괜찮은데요? 사람도 어떻게 나오는지 궁금하군요 ㅎㅎ