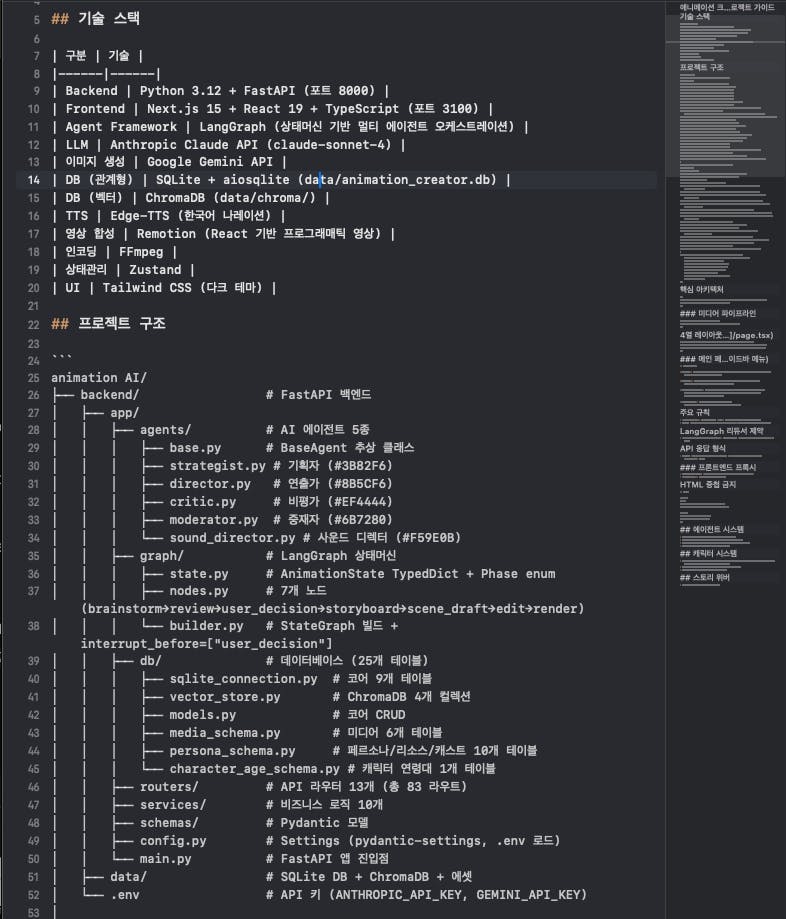
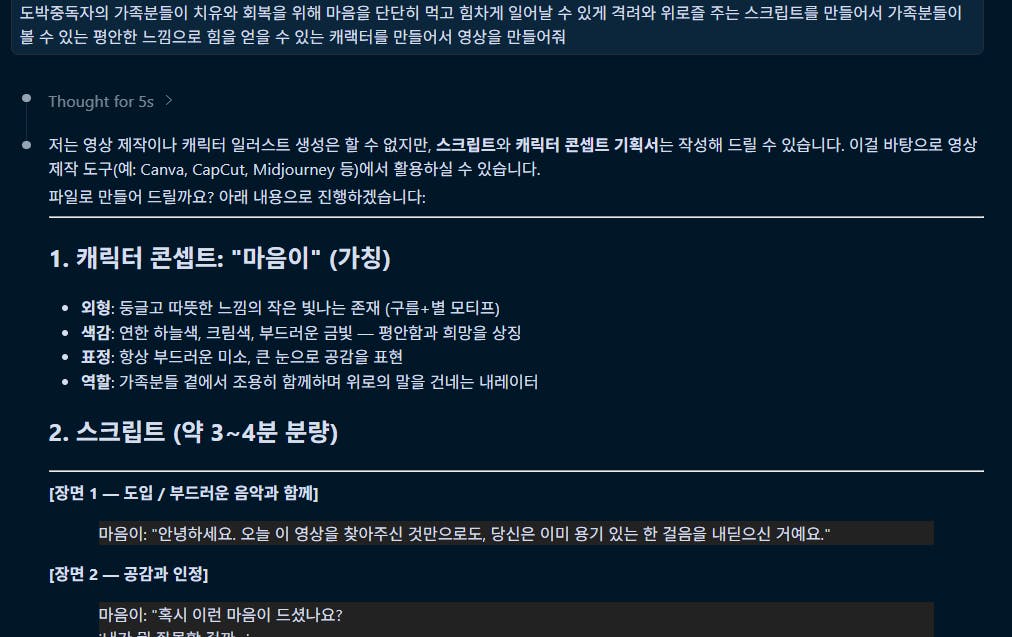
유튜브 shorts 업로드까지 자동화 과정 수정
2026.04.08
소개
21기 네트워킹방에서 스니이님께서 Typecast 정보 주셔서 tts 바꾸는 김에, 파이프라인 전체 수정했습니다. 개입단계 2번 추가(대본 완성 후, 업로드 하기 전)하고 typecast 사용해서 /shortform 스킬을 만들었습니다. 'AI 시대에 글쓰기를 해야 하는 이유'라는 주제로 두번째 영상을 만들어 업로드 했습니다. 영상 제작 비용이 궁금해서 토큰 로깅 시스템도 구축했습니다.
https://youtube.com/shorts/zwcG3ke7dbQ
진행 방법
숏폼 영상 제작 비용 확인 및 토큰 로깅 시스템 구축
숏폼 영상 제작에 사용된 API 서비스별(Claude, Gemini, edge-tts, Remotion) 비용 확인 방법 안내
Gemini API 토큰 사용량 로깅 시스템 구축
agents/token-logger.mjs유틸리티 생성agents/story-writer.mjs,character-designer.mjs,scene-director.mjs에 로깅 추가scripts/deep-research.mjs에 로깅 추가producer.mjs에 파이프라인 완료 후 토큰 사용량 요약 출력 기능 추가
workspace/token_usage.json에 누적 저장 방식으로 구현
역할 | 도구 | 비용 |
|---|---|---|
오케스트레이션 | Claude Code (Opus 4.6) | - |
대본 생성 | Gemini 2.5 Flash | $0.001 |
캐릭터/씬 설계 | Gemini 2.5 Flash | $0.004 |
이미지 생성 | Imagen 4.0 (12장) | ~$0.05 |
TTS 음성 | Typecast API (ssfm-v30) | 구독 내 |
영상 렌더링 | Remotion 4.x | 무료 |
업로드 | YouTube Data API v3 | 무료 |
/shortform 커맨드 워크플로우 수정
기존: 모드 선택(전체자동/대본까지만/중간재개) 방식
변경: 항상 대본 생성 후 멈추고 사용자 확인을 받은 뒤 나머지 파이프라인 진행
/shortform스킬 파일(~/.claude/commands/shortform.md) 수정
사용 도구: Claude Code
결과물: ~/.claude/commands/shortform.md 수정
TTS를 edge-tts에서 Typecast API로 전환
Typecast API 문서 조사 (최신 API:
api.typecast.ai,X-API-KEY인증, ssfm-v30 모델)API 토큰 설정 (
.env에TYPECAST_API_TOKEN추가)사용 가능한 목소리 542개 조회, 교육/대화 적합 + ssfm-v30 지원 116개 필터링
후보 6명 샘플 음성 생성 및 비교 청취
책쌤 후보: Jinhan, Sanghoon, Wonwoo
글쌤 후보: Moonjung, Seoyeon, Gowoon
최종 선택: 책쌤 = Wonwoo, 글쌤 = Seoyeon
agents/audio-creator.py전면 재작성edge-tts 의존성 제거, Typecast API(urllib) 사용
출력 포맷 MP3 → WAV
화자별 voice_id 매핑
CLAUDE.md, /shortform 스킬의 TTS 관련 설정 업데이트
사용 도구: Typecast API, edge-tts(비교용), Claude Code
결과물: agents/audio-creator.py 재작성, data/tts_samples/ 샘플 6개, .env 업데이트, CLAUDE.md 업데이트
/shortform 스킬로 영상 작업
1단계: 대본 생성 + 캐릭터 설정 커스텀
기존 파이프라인은 책쌤+글쌤 2인 대화 구조였는데, 이번 에피소드는 글쌤(선생님) + 호기(초5 학생) 주인공에 책쌤은 도우미로 변경. config.json의 additionalNotes에 캐릭터 관계, 말투, 존댓말 규칙을 상세히 지정.
{
  "additionalNotes": "글쌤은 선생님이므로 존댓말, 호기는 초등 5학년 반말+존댓말 혼용, 책쌤은 보조 1~2회 등장"
}
배운 점: AI 대본 생성 시 캐릭터 관계와 말투를 additionalNotes로 오버라이드하면 시스템 프롬프트를 수정하지 않고도 유연하게 바꿀 수 있다.
2단계: 호기 음성 교체 — 성인 남성 → 소년 목소리
파이프라인에 호기 전용 음성이 없어서 기본값(Wonwoo, 성인 남성)으로 나옴. 초등 5학년인데 아저씨 목소리가 나오는 문제.
해결법: Typecast API에서 후보 음성 10개를 같은 대사로 테스트 클립 생성 → 비교 청취 → Haerang 선택.
# audio-creator.py에 호기 전용 음성 추��
VOICE_CONFIG = {
    "책쌤": {"voice_id": "tc_686dc43e...", "voice_name": "Wonwoo"},
    "글쌤": {"voice_id": "tc_637cbfee...", "voice_name": "Seoyeon"},
    "호기": {"voice_id": "tc_6788847e...", "voice_name": "Haerang"},  # 추가!
}
팁: TTS 음성 선택은 반드시 실제 대사로 테스트해야 한다. 이름만 보고 고르면 캐릭터와 안 맞을 확률 높음.
3단계: TTS 반복 버그와의 전쟁 (가장 큰 삽질)
53초 지점에서 "자신만의 경험이나 느낌을 담은 글은 못쓴답니다"가 반복 재생되고, 1:06에서 "멋진 여행이에요"가 또 반복. Typecast TTS의 특성상 긴 문장(40자 이상)에서 반복 생성 현상 발생.
대사 | 글자 수 | TTS 길이 | 문제 |
|---|---|---|---|
"AI는 이미 있는 정보를 조합해서..." | 52자 | 14.10초 | ❌ 반복 |
"맞아요! 글쓰기는 스스로 생각하고..." | 48자 | 11.45초 | ❌ 반복 |
"글쓰기는 생각하는 힘을 길러주거든요." | 18자 | 2.75초 | ✅ 정상 |
해결: 모든 대사를 35자 이내로 분리. 10개 → 12개 대사로 재구성.
Before: "AI는 이미 있는 정보를 조합해서 글을 만들어요. 하지만 우리 호기처럼
        자신만의 경험이나 느낌을 담은 글은 못 쓴답니다. 그게 바로 '진짜 나'의 이야기죠."

After:  ① "AI는 정보를 조합해서 글을 만들어요. 하지만 자기만의 경험을 담진 못해요."
        ② "그게 바로 진짜 나만의 이야기인 거죠."
4단계: 이미지-씬 매핑 불일치 (두 번째 큰 삽질)
대사를 10개 → 12개로 바꿨는데 이미지는 옛 10개 기준 그대로. 글쌤이 말하는 장면에 호기 이미지가 나오는 상황 발생.
원인: batch-image-gen.mjs가 이미 존재하는 이미지를 건너뛰는 로직 때문. 대사 순서가 바뀌었는데 같은 파일명(scene_02.png)의 이미지가 남아있어서 다른 캐릭터 이미지가 재사용됨.
해결: 기존 이미지 전부 삭제 → 12개 새로 생성.
scene_02.png: 원래 호기(curious) → 지금 글쌤(confident) ❌ 불일치!
→ 전체 삭제 후 재생성으로 해결
교훈: 파이프라인 중간 단계를 수정하면, 그 이후 단계의 캐시/기존 파일을 반드시 초기화해야 한다.
5단계: 최종 렌더링 + 업로드
모든 문제 해결 후 Remotion 렌더링 → YouTube 비공개 업로드 완료.
✅ 결과 (After)
항목 | 값 |
|---|---|
에피소드 | EP.002 "AI 시대, 왜 글쓰기를 해야 할까요?" |
영상 길이 | 67.7초 |
대사 수 | 12개 (글쌤 7, 호기 4, 책쌤 1) |
이미지 | Imagen 4.0으로 12장 생성 |
TTS | Typecast 3음성 (Seoyeon, Haerang, Wonwoo) |
Gemini API 비용 | $0.005 |
총 소요 시간 | 약 30분 (대화+디버깅 포함) |
YouTube |
결과와 배운 점
효과적이었던 것:
대본 먼저 확인하고 진행 — 대본 승인 후 나머지 파이프라인 실행. "한 번에 다 돌리기"보다 중간 체크포인트가 수정 비용을 줄여줌
TTS 음성은 테스트 클립으로 비교 — API에서 후보 10개를 같은 대사로 뽑아 비교 청취. 이름만으로는 절대 판단 불가
긴 문장 분리 — TTS 안정성을 위해 35자 이내 원칙. 길면 반복 생성되는 건 Typecast만의 문제가 아님
파이프라인 의존성 인식 — 중간 단계 수정 시 하위 단계 캐시 초기화 필수
하면 안 되는 것:
대사 수를 바꾸고 이미지를 재생성 안 하기 → 화자-이미지 불일치
한국어 텍스트를 부분 편집으로 수정하기 → 유니코드 깨질 위험 (파일 전체 재작성이 안전)
TTS에 40자 이상 문장 넣기 → 반복 생성 확률 급증
음성 선택 없이 기본값으로 가기 → 캐릭터와 안 맞는 목소리

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요