


「홈랩에서 24시간 멈추지 않는 AI 에이전트 운영 인터페이스 개발하기」 2주차 사례발표
💬 들어가기 전에 — "네이버 검색량"이 뭔가요?
네이버 검색창에 사람들이 특정 단어를 얼마나 입력했는지를 보여주는 데이터입니다.
네이버가 '데이터랩'이라는 서비스로 공개하고 있고, 누구나 볼 수 있어요.
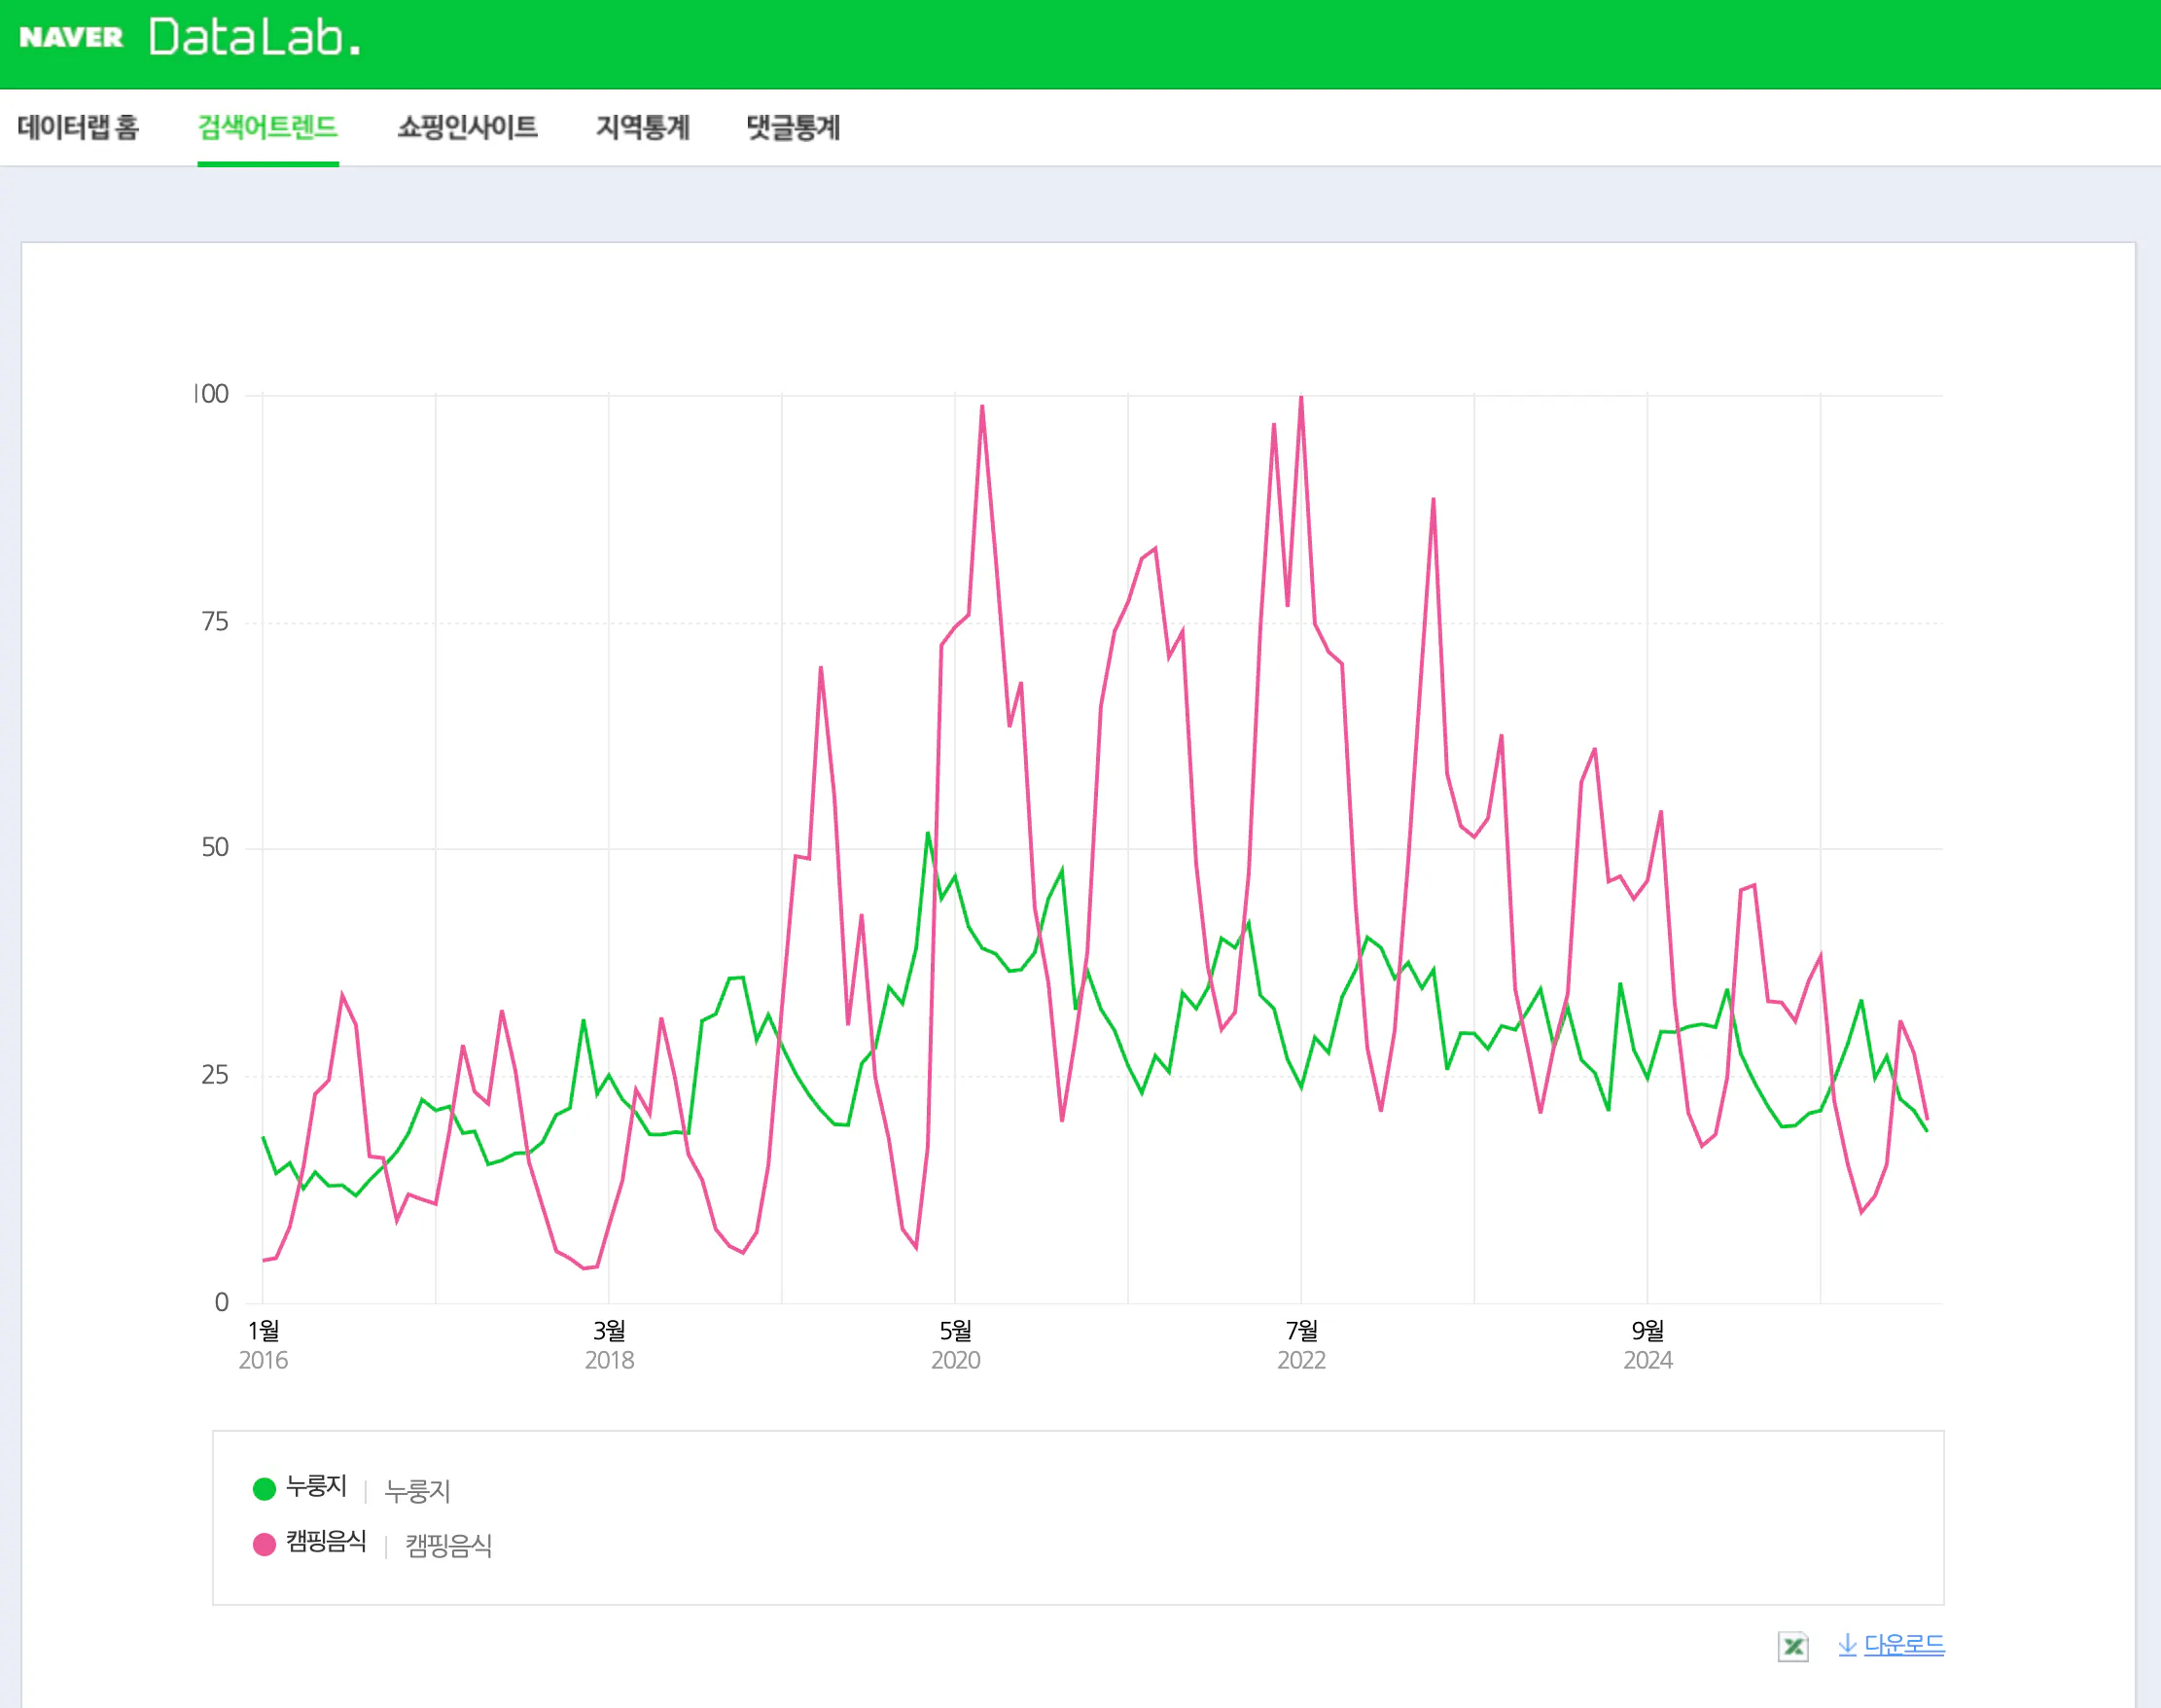
녹색 선과 분홍색 선이 있는 그래프의 스크린샷
이 데이터의 모습은 이렇게 생겼습니다:
· 날짜별로 — 2016년01월01일~어제, 1일 단위로
· 성별별로 — 남성, 여성
· 연령별로 — 연령대 (~12세, 13~18, 19~24, 25~29,..., 60~ 등 11개 구간)
· 기기별로 — PC, 모바일
· 예를 들면 "2026-01-15 · 모바일 · 여성 · 50~54세 · '누룽지' 검색량 1,234회"
검색량이 곧 판매량은 아니지만, 소비자 관심의 방향과 리듬을 보여줍니다.
언제 관심이 몰리는지(계절성), 누가 찾는지(타깃), 관심이 커지는 중인지 식는 중인지(추세)
— 광고 시즌, 타깃 설정, 신제품 시장성 판단의 근거가 되죠.
한 가지 문제는, 네이버가 원본을 "상대값"으로만 줍니다 (기간 중 최고점을 100으로 놓은 비율).
그래서 검색량이 이미 검증된 레퍼런스 키워드와 비교하는 방식으로 실제 검색 횟수를 추정해서 씁니다
— 이 변환 과정도 아래에서 소개할 시스템이 자동으로 처리합니다.
📍 1. 시작점 — 실제로 하고 있는 일
저는 1인 기업 소굿마켓을 운영합니다. 이커머스에서 화장품과 식품을 유통하며,
신제품 런칭 전에 네이버 검색량 데이터 분석을 통해 마케탕 전략을 수립합니다
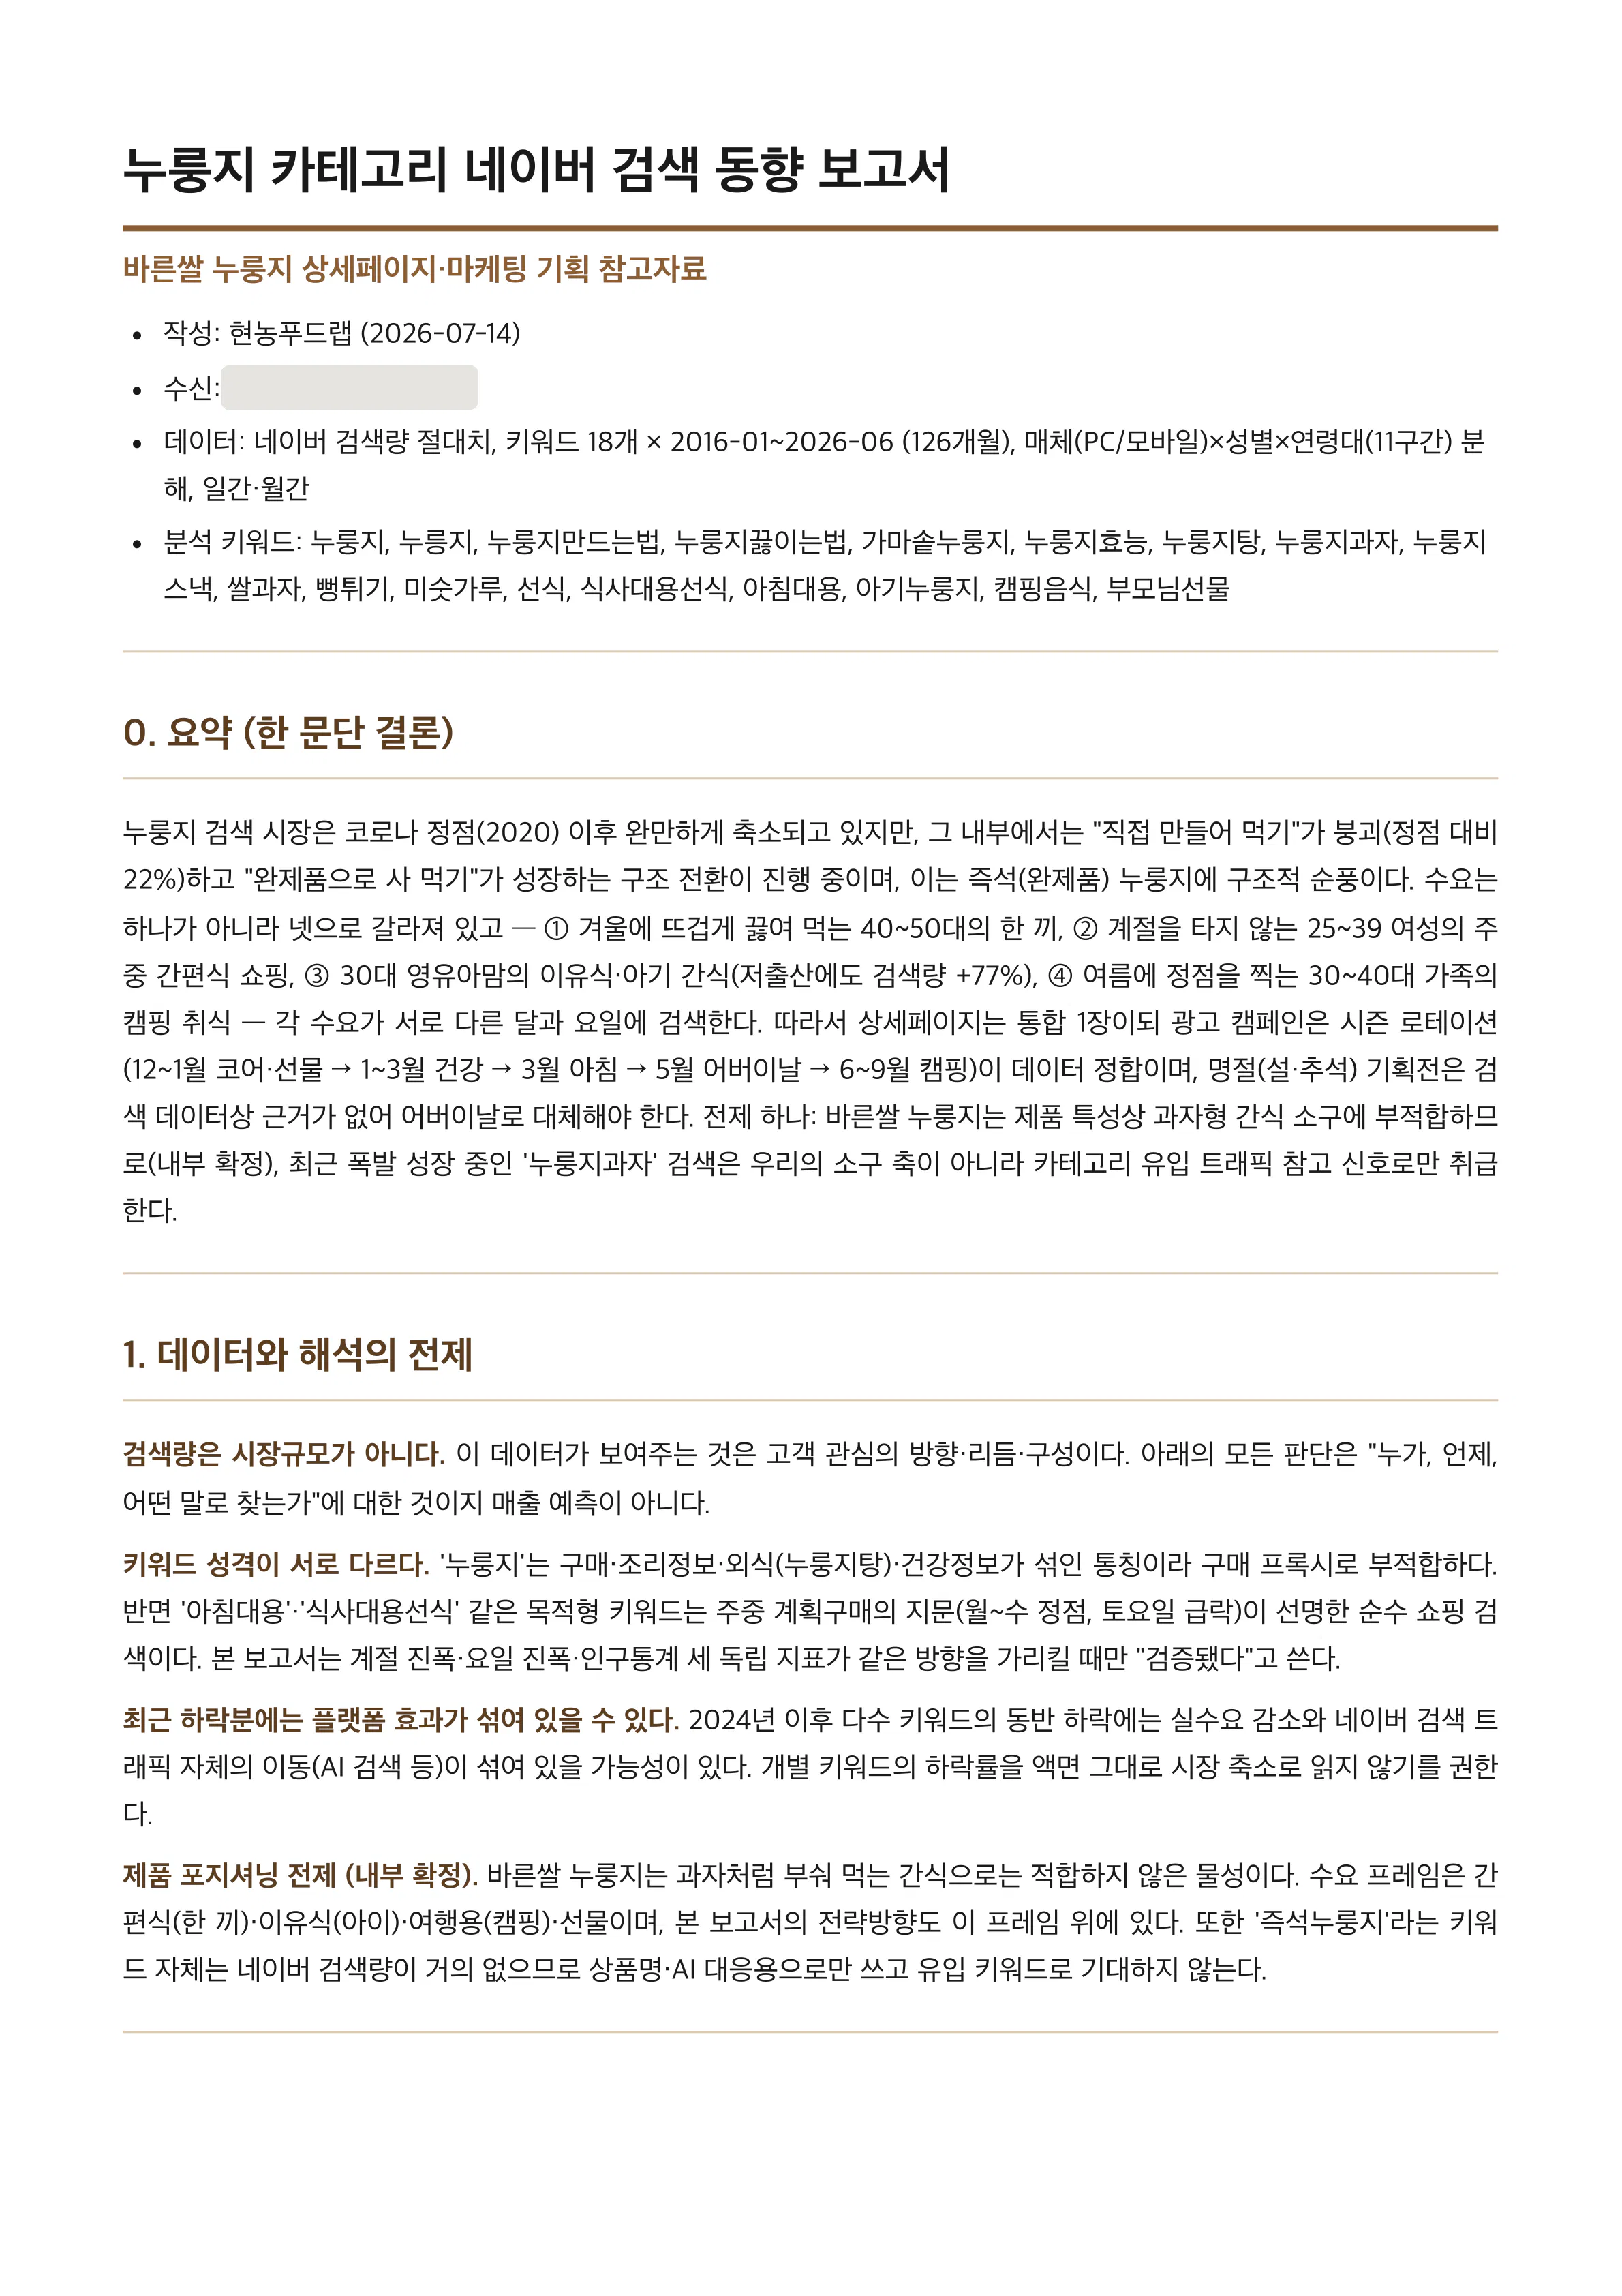
실제 사례: 바른쌀누룽지 런칭 전 누룽지 연관키워드 분석 (2026.07)
· 연관 키워드 18개 수집: 누룽지, 아기누룽지, 누룽지스낵, 미숫가루, 식사대용선식, 캠핑음식 …
· 2016년부터 10년치 일간 검색량 → 추세 · 계절성 · 성별/연령 · 요일 패턴 분해
· Claude가 5개 렌즈로 교차 분석 → 소비 장면 도출 → 런칭 전 체크리스트까지
한국어와 중국어가 적힌 문서
이 파이프라인은 이미 검증되어 있고, 실전에서 의사결정에 쓰이고 있습니다.
😫 2. 문제 — 검증된 역량이 "내 시간"에 묶여 있다
이 분석은 강력하지만, 실행이 전부 제 수작업입니다.
(현재)
분석이 필요한 순간
→ 내가 PC 앞에 앉아서
→ Python 스크립트 실행 (키워드당 네이버API 44회 호출)
→ 엑셀 확인
→ Claude Code로 분석 실행
→ 보고서 작성
(문제점)
· 실행이 나에게 묶여 있으니 분석 빈도가 내 시간만큼으로 제한됨
· 함께 일하는 파트너와 협업할 때도 매번 내가 병목
· 쓸수록 쌓여야 할 데이터가, 실행이 무거우니 천천히 쌓임
(개선방향)
분석 역량을 "나"에서 "시스템"으로 옮기면
- 내가 없어도 돌아가고, 돌아갈수록 데이터가 쌓입니다.
- 축적된 키워드 DB와 분석 경험은 소굿마켓의 비즈니스 자산이자 경쟁력이 됩니다.
💡 3. 아이디어 — 파이프라인을 24시간 웹 서비스로
(목표)
나&파트너: 로그인
→ 연관 키워드 일괄 입력
→ 맥스튜디오가 알아서 수집 (백그라운드 작업)
→ 대시보드로 탐색 (Tableau처럼, 그러나 이 데이터에 맞춤)
→ AI 채팅으로 추가 분석 ("30대 여성 비중 추이만 다시 보여줘")
→ 분석 보고서는 마크다운으로 옵시디언에 저장하고, 필요하면 보고서 PDF 생성
이름은 SoGood DataLab.
나와 파트너 몇 명이 쓰는 사내 분석 서비스로 시작해서,
데이터 분석 대시보드 플랫폼으로 확장 가능성을 봅니다.
램프 옆 테이블에 앉아 있는 프로젝터
🔍 4. 분석 철학 — 연관 키워드가 해석을 만든다
단일 키워드의 검색량은 그냥 숫자입니다. 해석은 연관 키워드와의 비교에서 나옵니다.
누룽지 검색량 분석에서 실제로 있었던 일:
① 누룽지 ↔ 캠핑음식 : 정확히 반대 계절성 → 여름 비수기를 방어할 유일한 앵글
② 누룽지 ↔ 아침대용 : 코어는 겨울, "아침 결심"은 3월 → 광고 시즌을 분리해야 함
③ 누룽지 ↔ 부모님선물 : 명절 리프트 없음, 화력은 어버이날 → 명절 기획전을 어버이날로 재배치
이 발견들은 어느 단일 키워드 그래프에서도 나올 수 없습니다.
그래서 이 앱의 분석 단위는 "키워드 세트"입니다.
연관 키워드 2~30개를 일괄 입력받아, 세트로 수집하고 비교하고 해석합니다.
그리고 자산은 두 겹으로 쌓입니다:
보고서가 자산이듯, 분석 방법도 그에 버금가는 자산입니다
① 결과 보고서 — 스키마를 갖춘 마크다운으로 LLM 위키(옵시디언)에 축적되는 지식 자산
② 분석 방법 — 연관 키워드 세트를 어떻게 구성하고 교차 해석하는가, 그 노하우가 분석 스킬과 사례 카드로 축적. 사례가 쌓일수록 분석 자체가 좋아집니다
🖥️ 5. 왜 "24시간 홈랩 서버"여야 하는가 — 스터디 주제와의 연결
에이전트 프레임워크(Hermes 등)의 크론 작업으로도 많은 자동화가 됩니다.
하지만 에이전트로는 불가능하고 24시간 홈랩 서버만 가능한 기능이 필요했습니다
에이전트 vs 24시간 홈랩 서버:
① 정기 수집, 정기 리포트 → 남이 아무 때나 보내는 요청에 응답 (인바운드 서빙)
② 단발 작업 실행 → 수 분~수십 분짜리 장시간 백그라운드 작업 관리
③ 메신저로 텍스트 응답 → 웹 프론트엔드 (대시보드, 차트, 채팅 UI)
④ 혼자 쓰는 도구 → 로그인 기반 멀티 유저 서비스
여기에 작업 큐 · 사용량 · 비용을 보는 관리자 페이지까지 —
스터디 주제인 "에이전트 운영 인터페이스"를 그대로 구현하는 프로젝트입니다.
📥 6. 핵심 기능 ① 수집 — 요청하면 알아서 쌓인다
· 네이버 데이터랩 API로 키워드당 매체 2 × 연령 11 × 성별 2 = 44개 세그먼트 수집 필요
· 기준 키워드 대비 환산으로 상대값 → 절대 검색량 추정 (기존 검증된 로직 이식)
· 수집 데이터는 SQLite에 적재 → 한 번 수집한 키워드는 즉시 조회 (재수집 불필요)
· API 한도는 계정당 일 1,000회.
① 배치 수집 (4+1) — API는 요청당 키워드 5개까지 허용. 레퍼런스 키워드 1 + 목표 키워드 4를 함께 실어 호출하면 최대 1일 88개 키워드 수집 가능
② 캐시 우선 — 이미 수집했었던 키워드는 기존 저장해놓은 데이터 활용
③ 복수 API 키 로테이션 — 키별 호출량을 카운트하며 순환, 사실상 한도 없이 운영
· 수집은 백그라운드 작업 큐로: 제출 → 진행률 표시 → 완료 알림
쌓일수록 좋아지는 구조 — 키워드 DB 자체가 회사의 데이터 자산이 됩니다.
📊 7. 핵심 기능 ② 대시보드 — Tableau/PowerBI를 흉내내지 않는다
Tableau/Power BI가 무거운 이유는 "아무 데이터나" 탐색하게 해주기 때문.
이 앱의 데이터는 스키마가 하나로 고정되어 있습니다:
키워드 × 날짜 × 매체 × 성별 × 연령대 × 검색량
스키마가 고정이면 범용 BI 대신 잘 설계된 대시보드 템플릿 한 벌이면 됩니다.
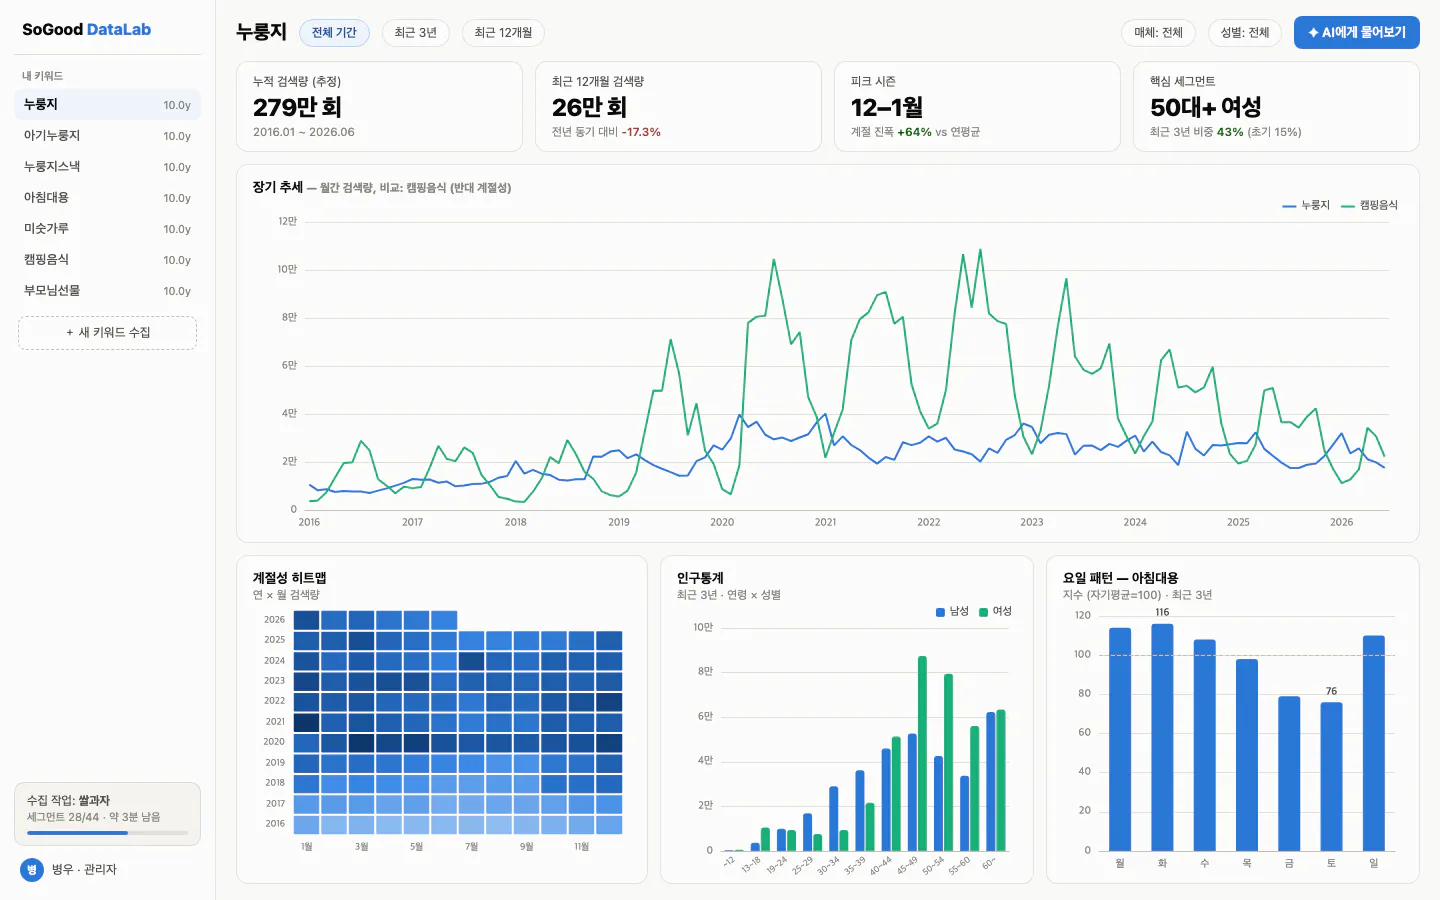
· 기본 화면은 세트 개요 — 키워드 비교(규모·추세·계절성)가 먼저, 키워드 상세는 드릴다운
· 장기 추세 + 연도별 비교
· 계절성 히트맵 (연 × 월)
· 인구통계 — 성별/연령 구성, 매체 비중
· 요일 패턴
· 키워드 간 비교 뷰 (누룽지 사례: 18개 키워드 교차 비교)
모든 키워드에 같은 템플릿이 재사용되고, 인터랙션(기간 줌, 세그먼트 토글)은 ECharts로 직접 구현합니다.
한국의 구글애널리틱스 대시보드
💬 8. 핵심 기능 ③ 대화형 분석 — 대시보드가 못 받는 질문은 채팅이 받는다
고정 대시보드는 정해진 질문에만 답합니다. 롱테일 질문은 AI 채팅이 담당:
사용자: "이 키워드, 코로나 이후로 연령대 구성이 어떻게 바뀌었어?"
→ 서버의 Claude Agent 세션이 SQLite 조회
→ 텍스트 답변 + 그 자리에서 차트 렌더
사용자: "좋네. 이거 정식 보고서로 정리해줘"
→ 기존 분석 스킬 실행 → PDF 다운로드
· 서버에서 Claude Agent SDK 세션 구동 — 키워드 세트를 컨텍스트로, 도구: 데이터 조회 · 수집 제출 · 차트 스펙 생성 · 보고서 생성
· Claude가 답변에 차트 스펙(JSON)을 섞어 보내면 프론트가 그래프로 렌더
· Hex, Julius 같은 AI 분석 서비스와 같은 패턴 — "고정 대시보드 + 대화형 커스텀 분석" 조합
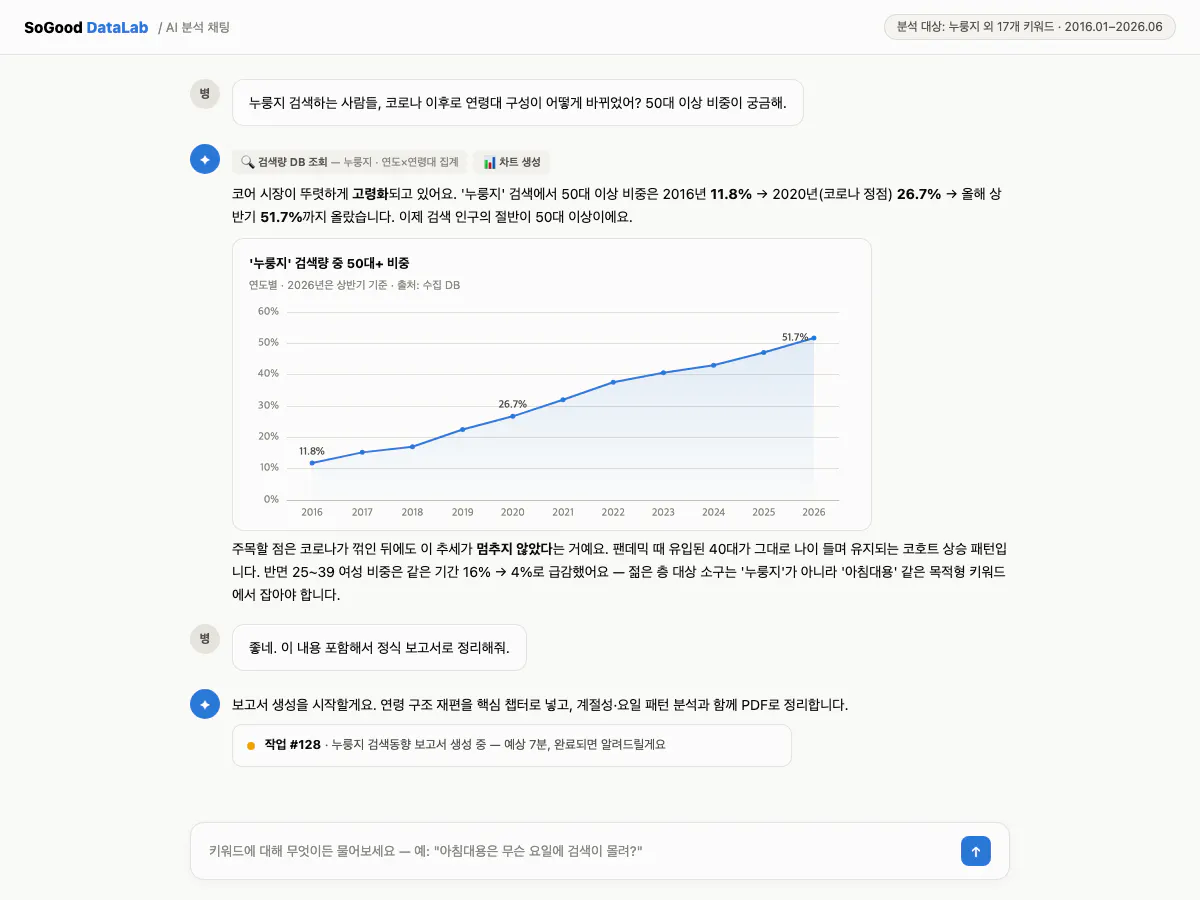
그래프를 보여주는 한국 웹사이트의 스크린샷
🛠️ 9. 아키텍처
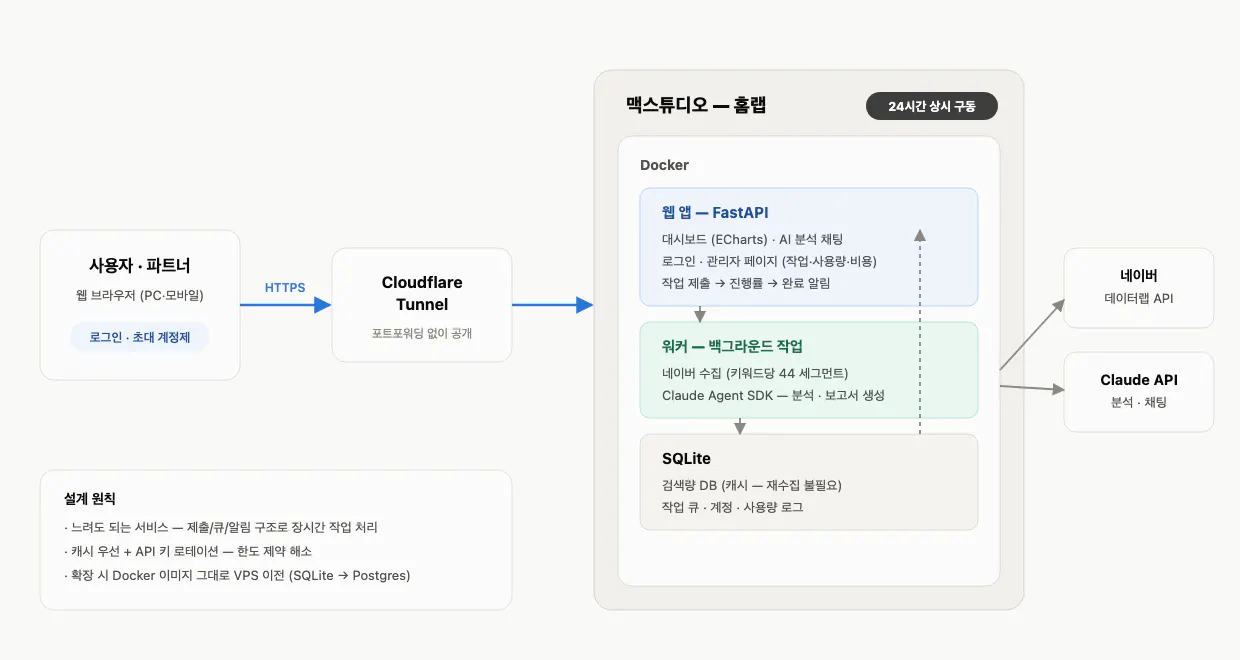
한국어 앱 다이어그램
[사용자]
   │  HTTPS
   ▼
Cloudflare Tunnel  ←  외부 공개 (포트포워딩 없음, 무료)
   │
   ▼
맥스튜디오 (홈랩, 24시간)
 └─ Docker
     ├─ 웹 앱 (FastAPI + 프론트엔드/ECharts)
     │    ├─ 자체 로그인 (초대 계정제)
     │    ├─ 대시보드 / 채팅 UI
     │    └─ 관리자 페이지 (작업 큐 · 사용량 · 비용)
     ├─ 워커 (백그라운드 작업)
     │    ├─ 네이버 DataLab 수집
     │    └─ Claude Agent SDK (분석 · 보고서)
     └─ SQLite (검색량 DB · 작업 큐 · 계정)
· 속도 다소 느려도 문제 없는 서비스: 수집 수 분 + AI 분석 수 분 → 작업 제출 → 진행률 → 완료 알림 구조
· 이전 전략: 사용량이 늘면 Docker 이미지 그대로 VPS로 이전, SQLite → Postgres 교체
🗓️ 10. 일정 — 개발 기간 2주 반
① 스프린트 0 (~7/30) : 데이터 계층 — 수집 모듈화 + SQLite + 작업 큐 + API 골격 → 2주차 발표 (이 자료) + 백엔드 데모
② 스프린트 1 (7/31~8/5) : 대시보드 + 로그인 → 3주차 발표: 대시보드 시연
③ 스프린트 2 (8/7~8/12) : AI 채팅 + Docker + Cloudflare Tunnel 오픈 → 4주차 발표: 실서비스 시연
스코프 컷 기준 (일정 방어):
· 채팅 차트 렌더가 밀리면 → 텍스트 답변만으로 축소
· 보고서 스킬 연동은 스트레치 골
· 관리자 페이지는 사용량 로그 테이블 수준으로 최소화
🔧 부록 — 기술 스택 요약
· 서버 : 맥스튜디오 (홈랩) — 상시 구동, 이미 보유, 유니파이드 메모리 여유
· 컨테이너 : Docker (OrbStack) — VPS 이전 대비, 환경 재현성
· 백엔드 : Python FastAPI — 기존 수집·분석 코드가 Python (pandas)
· 작업 큐 : SQLite 기반 큐 + 단일 워커 — 규모에 맞는 최소 구성, Redis 불필요
· 프론트 : React + ECharts — 대시보드 인터랙션 자유도
· AI : Claude Agent SDK — 기존 분석 스킬 재사용, 도구 호출 + 스트리밍
· 공개 : Cloudflare Tunnel — 포트포워딩 없이 안전한 외부 공개, 무료
· 인증 : 자체 로그인 (초대 계정제) — 회원가입 없음, 파트너 규모에 맞춤
· 데이터 : 네이버 데이터랩 API — 계정당 일 1,000회 무료 → 배치 수집 + 복수 키 로테이션으로 확장
