학습 데이터 이름을 정규화해 모델 노트의 같은 데이터 쌍 다시 세기
2026.10.20
소개
2주차에 제 지식 허브의 바이오 파운데이션 모델 노트 4개를 JSON 온톨로지로 옮기면서, 같은 데이터를 학습한 모델 쌍이 0쌍이라는 결과를 얻었습니다. 이번 주에는 학습 데이터 칸의 이름을 정규화하고 논문 원문으로 확인해서 이 쌍을 다시 세었습니다. 표에서 "같은 데이터를 쓴 항목"을 찾으려는데 값이 글자 그대로 일치하지 않아 막힌 분께 권합니다.
3주차 강의는 한국사의 "태조가 누구인가"라는 질문 하나로 위키와 온톨로지를 만드는 시연이었습니다. 태조는 고려의 왕건과 조선의 이성계처럼 같은 호칭이 서로 다른 인물을 가리켜서, 스터디장 DECK은 두 인물에 서로 다른 ID를 주어 구별했습니다. 교안에는 "두 기록이 실제로 같은 인물인지는 맥락과 근거를 확인해 판별한다"는 문장이 있었습니다. 제 상황은 그 반대입니다. 이름이 다른 두 칸이 사실은 같은 데이터인지 가려야 하는 문제입니다.
이 작업은 2주차 사례글에 DECK 님이 남긴 댓글에서 시작했습니다. 0쌍이라는 숫자를 보고 곧바로 "같은 데이터를 쓴 모델이 없다"고 읽을 뻔했는데, 이름을 맞추지 못한 상태일 수도 있다는 지적이었습니다. 저는 청강생이라 스킬 설치와 인터뷰 실습은 하지 않고, 이 지적을 직접 시험했습니다. 측정일은 2026-10-15입니다. 허브의 노트는 읽기만 했고, 복사본 4개를 스터디 폴더에 두고 그 위에서 작업했습니다.
진행 방법
사용 도구: Claude Code, Python 3, pytest, grep, pdftotext
Step 1. 3주차 강의가 정한 기준
강의에서 이번 작업에 해당하는 말을 세 가지로 추렸습니다.
강의에서 나온 말 | 이번에 재는 방법 |
|---|---|
같은 호칭이라도 다른 인물이면 다른 ID를 주고, 같은 대상인지는 근거로 판별한다 | 학습 데이터 칸마다 데이터셋 ID를 붙이고 근거 문장을 함께 적는다 |
모르는 것은 "없다"가 아니라 "모른다"로 두고, 교안의 확장 기록도 답변 6개와 보류 2개로 나눠 적었다 | 쌍을 네 가지로 판정하고, 데이터를 모르는 모델이 낀 쌍은 "미판정"으로 둔다 |
구조 검사에서 지적이 0건이어도 내용이 정확하다는 인증은 아니다 | 숫자를 내는 코드는 참값을 아는 입력에 먼저 걸고, 근거 문장은 원문과 대조한다 |
Step 2. 검사를 먼저 쓰고 실패 확인
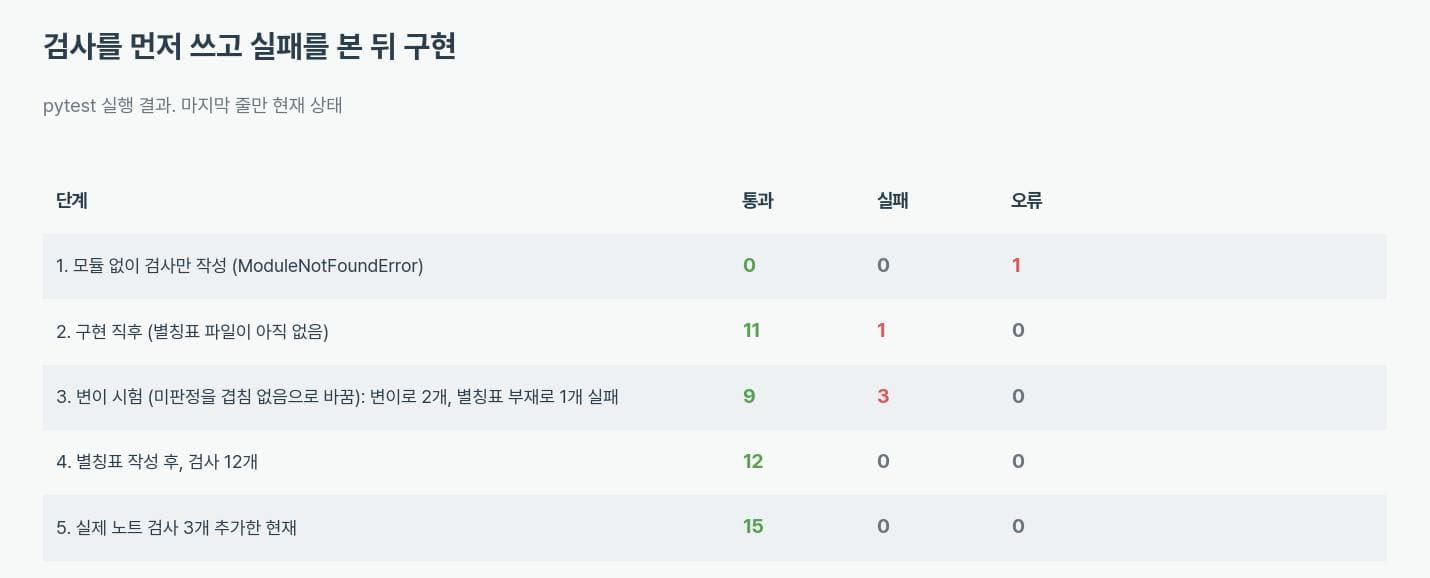
쌍 판정 코드는 눈으로 확인하기 어려운 숫자를 내므로 구현 전에 검사를 먼저 썼습니다. 장난감 모델 여섯 개에 참값을 정해 두었습니다. 문자열은 모두 다르지만 같은 데이터셋인 두 모델, 같은 출처 계열의 다른 스냅샷인 두 모델, 데이터를 모르는 모델 하나가 들어 있습니다.
def test_unknown_model_is_undetermined_never_disjoint():
    res = pair_labels(dp.classify_pairs(MODELS, ALIASES))
    for other in "ABCDE":
        assert res[tuple(sorted((other, "U")))] == "undetermined"
모듈을 만들기 전에 실행하니 실패했습니다.
python3 -m pytest -q test_dataset_pairs.py
E   ModuleNotFoundError: No module named 'dataset_pairs'
1 error in 0.35s
구현한 뒤에는 11개가 통과하고 1개가 실패했는데, 이 실패는 별칭표 파일이 아직 없어서였습니다. 검사가 실제로 잡는지 보려고 구현을 일부러 틀리게 바꿔 보기도 했습니다. "모르는 모델이 낀 쌍"을 "겹침 없음"으로 판정하게 고치자 검사 2개가 실패했습니다.
Step 3. 22개 칸을 세 단계로 정규화
대상은 모델 표가 있는 노트 4개 가운데 "학습 데이터" 칸이 있는 모델 22개입니다. 가능한 쌍은 231개입니다. 합성 인핸서 노트의 모델 4개는 표에 그 칸이 없어서 뺐습니다. 별칭표(dataset_alias.csv)는 모델마다 데이터셋 ID, 출처 계열, 근거의 종류, 근거 문장과 주소, 확인일을 적은 30행짜리 파일입니다.
python3 -I run_pairs.py
1_문자열_그대로         same_dataset 0, undetermined 231
2_칸_글자로_정규화      same_dataset 1, disjoint 9, undetermined 221
3_논문_원문_확인_추가   same_dataset 7, same_family 9, disjoint 137, undetermined 78
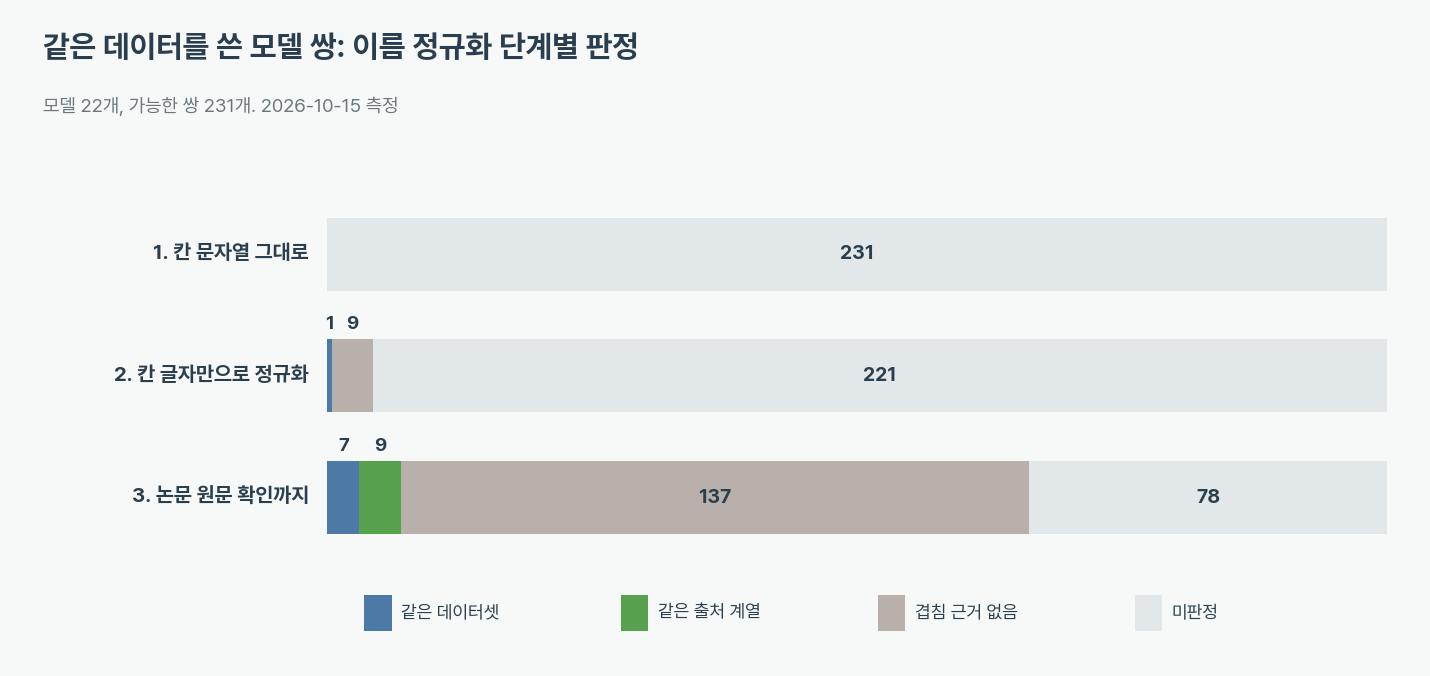
2단계는 칸에 적힌 글자만 보고 이름을 맞춘 결과입니다. "인간 유전체"(DNABERT)와 "인간 참조 유전체"(HyenaDNA)가 같다고 합쳤고, 이름이 적힌 Geneformer, scPRINT, Prov-GigaPath 세 모델을 더해 5개 모델만 판정할 수 있었습니다. 나머지 17개 모델은 칸에 규모와 종류만 적혀 있어 이름으로는 아무것도 말할 수 없었습니다.
Step 4. 논문 원문으로 근거 확인
3단계에서는 모델마다 주 논문이나 사전 공개본을 열어 학습 데이터 이름을 찾고, 해당 문장을 별칭표에 인용으로 달았습니다. 이름이 확인된 모델은 18개이고, scFoundation, CONCH, PathChat, MUSK 4개는 논문이 데이터를 설명할 뿐 이름을 주지 않아 미판정으로 남겼습니다.
pdftotext -layout 2403.03234.pdf - | grep -i -m1 "human reference genome"
For pre-training we use the HG38 human reference genome (Consortium et al., 2009).
Caduceus의 칸에는 "(Mamba 기반 DNA 사전학습)"이라고만 적혀 있어서 이름으로는 어떤 모델과도 이어지지 않았습니다. 논문을 열자 HyenaDNA와 같은 인간 참조 유전체였습니다. 인용 문장이 달린 21행 가운데 11행은 제가 논문 원문을 내려받아 문장을 직접 대조했고, 나머지 10행은 조사를 맡긴 보조 에이전트가 가져온 문장이라 원문 대조를 하지 않았습니다.
Step 5. 묶인 모델 확인
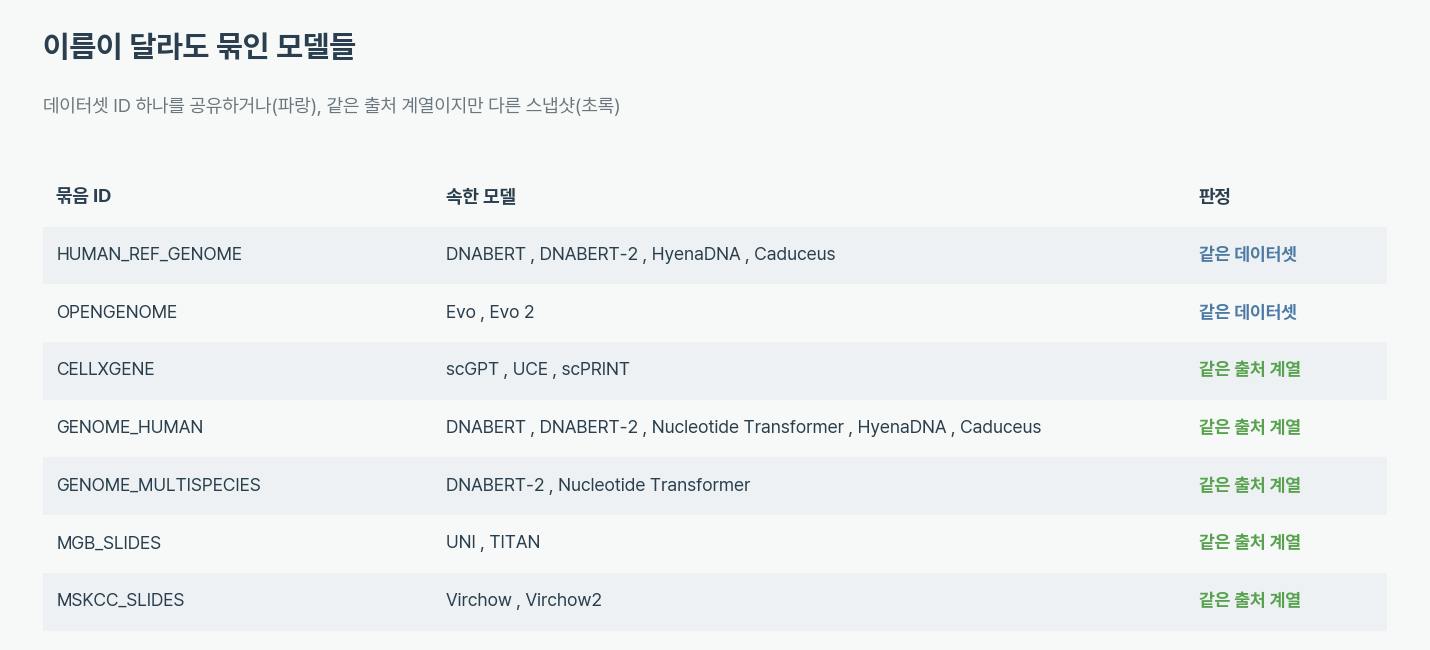
같은 데이터셋 7쌍 가운데 6쌍은 인간 참조 유전체 하나로 묶인 네 모델(DNABERT, DNABERT-2, HyenaDNA, Caduceus) 안의 조합이고, 1쌍은 Evo와 Evo 2입니다. Evo 2 논문에 "이전에 공개한 OpenGenome을 통째로 썼다"는 문장이 있어 OpenGenome이 두 모델에 공통으로 들어갑니다. 같은 출처 계열 9쌍에는 scGPT, UCE, scPRINT가 모두 CELLxGENE에서 받았지만 스냅샷 시점이 다르거나 명시되지 않은 경우가 들어 있습니다. scGPT는 2023년 5월 15일판, UCE는 2023년 7월 10일판을 썼다고 적었습니다.
Step 6. 허브 재측정
2주차와 같은 정의의 스크립트를 다시 돌렸습니다.
python3 -I ../2주차/assets/measure_hub.py | head -1
grep -cE '^\s*- \*\*query\*\*' ~/knowledge-hub/log.md
md total 781 notion 604 settings 4 index 17 notes 156
0
노트 156개와 링크 426건은 2026-10-13에 잰 값과 같고, 못 찾은 질의 기록은 0건입니다. 이 주에는 허브 쪽 변화가 없었습니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
학습 데이터 칸이 있는 모델과 가능한 쌍 | 22개, 231쌍 |
칸 문자열이 글자 그대로 같은 쌍 | 0쌍 |
칸 글자만으로 정규화한 뒤 같은 데이터셋 | 1쌍 (판정 가능한 모델 5개) |
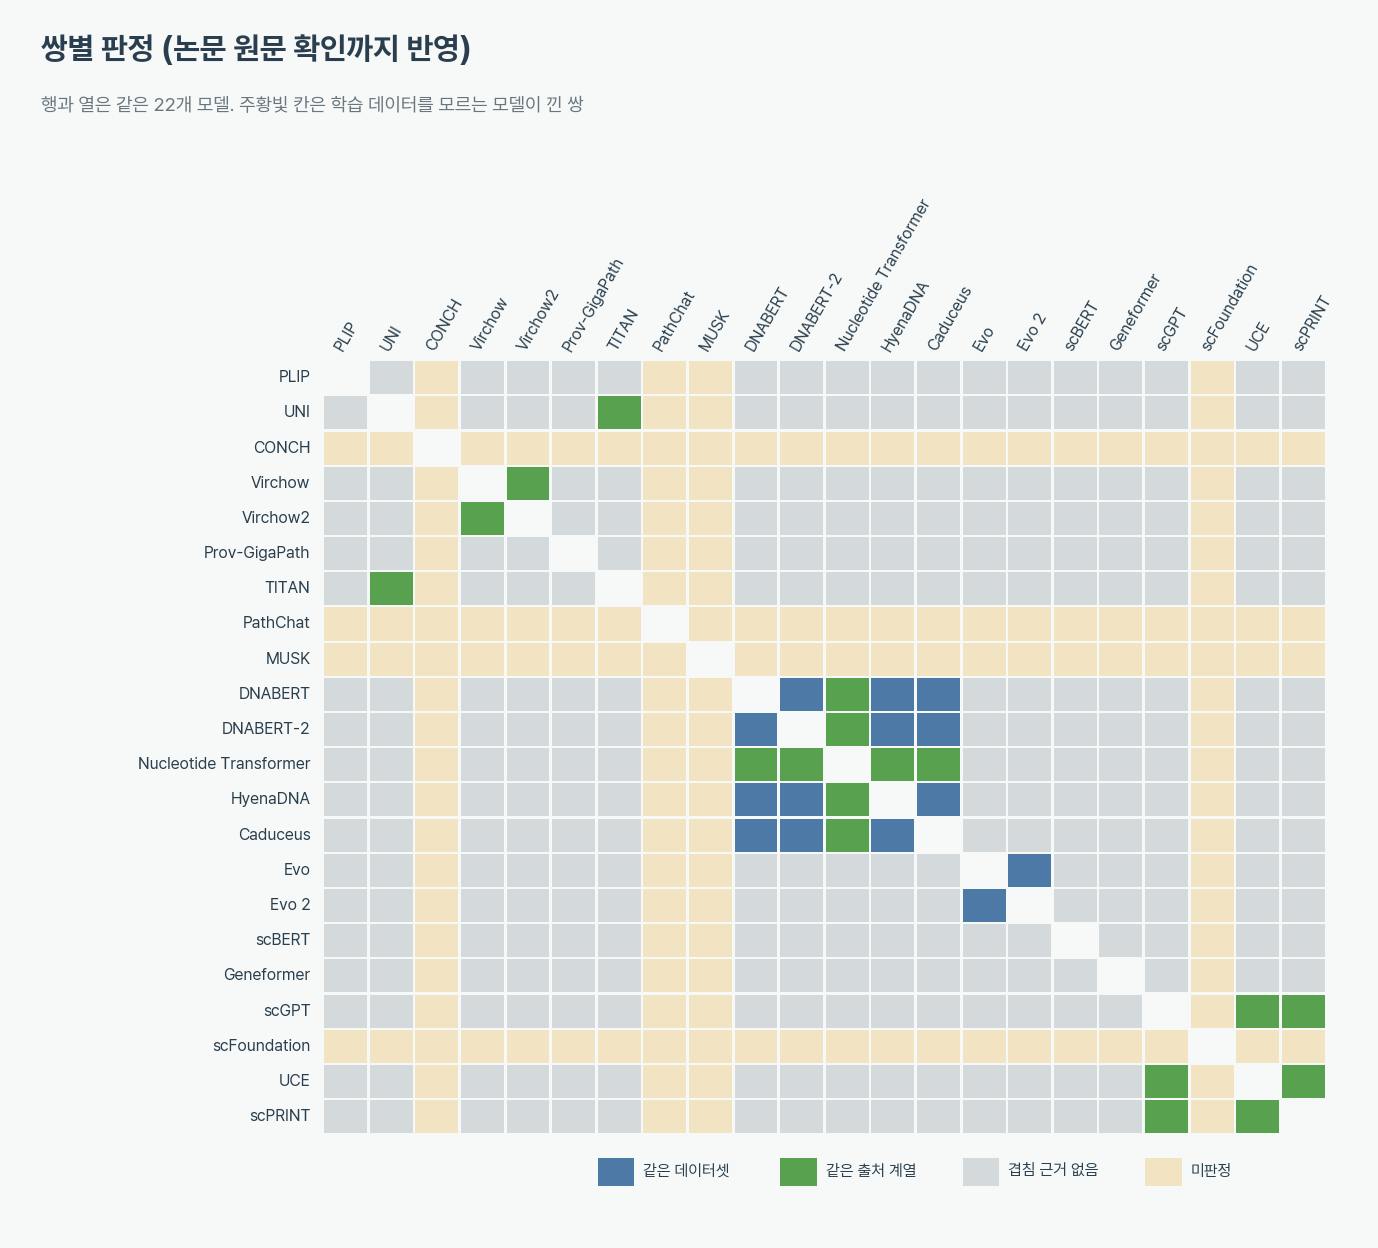
논문 원문 확인까지 반영한 뒤 | 같은 데이터셋 7쌍, 같은 출처 계열 9쌍, 겹침 근거 없음 137쌍, 미판정 78쌍 |
데이터셋 이름이 확인된 모델 | 22개 중 18개 (정규화 전 칸 문자열은 22가지 모두 달랐음) |
검사 | 15개 통과, 구현 전 오류 1건과 일부러 틀리게 고친 판정에서 실패 2개 확인 |
배운 점
0쌍은 "없음"이 아니라 "이름이 안 맞음"이었습니다. 같은 방식으로 다시 세자 0쌍이 7쌍(같은 출처 계열까지 16쌍)이 되었습니다. 2주차 글의 "같은 데이터셋을 공유하는 모델 쌍은 0쌍(모름)"이라는 표기는 방향이 맞았고, 이번에 "모름"의 크기를 쟀습니다.
칸의 글자를 정규화하는 것만으로는 부족했습니다. 칸 글자만으로 찾은 쌍은 1쌍이었고, 나머지 6쌍은 논문을 열어야 보였습니다. 정규화의 대상은 칸의 문자열이 아니라 그 데이터가 어디서 왔는지였습니다.
"같은 데이터"라는 말의 뜻을 먼저 정해야 합니다. HyenaDNA와 Caduceus는 둘 다 인간 참조 유전체를 썼지만, Caduceus는 Enformer 연구의 분할(34,021개 구간)을 따랐다고 합니다. 같은 원천이지 같은 학습 표본은 아닙니다. 그래서 "같은 데이터셋"과 "같은 출처 계열"을 나눠 셌고, 어느 정의를 쓰느냐에 따라 쌍 수가 7쌍에서 16쌍까지 달라집니다.
"겹침 근거 없음" 137쌍은 겹치지 않는다는 보증이 아닙니다. 이름이 다르고 겹친다는 문서 근거를 찾지 못했다는 뜻입니다. scBERT의 PanglaoDB와 Geneformer의 Genecorpus-30M처럼 공개 데이터를 모은 코퍼스는 서로 일부가 겹칠 수 있습니다. 미판정 78쌍은 전체의 34%이고 모두 이름이 확인되지 않은 4개 모델이 낀 쌍입니다.
참값이 있는 곳은 검사로, 없는 곳은 근거를 남기는 방식으로 나눴습니다. 판정 규칙은 검사가 지켜 주고, 별칭표는 모델마다 근거 문장, 주소, 확인일을 같은 행에 남겼습니다. 결정 이유를 나중에 사실처럼 읽을 수 있다는 DECK 님의 1주차 글 댓글을 이 방식으로 반영했습니다. 근거가 인용 문장이면 논문이 바뀌지 않는 한 다시 대조할 수 있습니다.
시행착오와 한계
DNABERT의 인간 유전체 조립본(예: hg38)은 제가 읽은 본문에서 찾지 못했습니다. DNABERT-2 논문이 "DNABERT가 쓴 인간 유전체 데이터셋"이라고 적은 것에 기대어 같은 ID로 묶었습니다.
Evo 2의 학습 데이터에 인간 참조 유전체가 들어 있다는 설명은 조사 결과에는 있었지만 제가 원문에서 대조하지 못해 별칭표에 넣지 않았습니다. 들어 있다면 Evo 2와 HyenaDNA 같은 쌍이 지금은 "겹침 근거 없음"으로 분류된 오류일 수 있습니다.
PathChat은 시각 인코더로 UNI를 쓰지만 칸의 "명령 데이터"와 다른 데이터여서 미판정으로 두었고, UNI와 TITAN은 같은 병원 계열이라는 이유로 같은 출처 계열이라고 적었는데 실제 데이터 일부가 겹치는지는 알 수 없습니다.
출처 계열의 묶음(예: CELLxGENE, MGB_SLIDES)은 제가 정한 분류입니다. 다르게 정하면 같은 출처 계열 9쌍이 바뀝니다.
이 측정은 2026-10-15에 허브의 bio-fm-* 노트 4개의 복사본에서 학습 데이터 칸이 있는 모델 22개와 쌍 231개를 Python으로 판정한 결과입니다. 별칭표 근거는 논문 본문과 사전 공개본이며, 모델이 쓴 데이터가 서로 실제로 얼마나 겹치는지는 데이터 수준에서 대조하지 않았습니다.
도움 받은 글
24기 AI지식관리 2주차 사례글에 달린 DECK 님의 댓글: 0쌍을 "같은 데이터를 쓴 모델이 없다"로 읽지 말고 이름을 맞추지 못한 상태일 수 있다는 지적. 이번 작업의 출발점이었습니다.
24기 AI지식관리 1주차 사례글에 달린 DECK 님의 댓글: 결정 이유를 적을 때 그때의 근거와 날짜를 함께 남기라는 제안. 별칭표의 근거 문장, 주소, 확인일 열로 반영했습니다.
24기 AI지식관리 3주차 강의와 교안 (스터디장 DECK): 같은 호칭이라도 다른 ID로 구별하고 같은 대상인지는 근거로 판별한다는 설명, 열린 세계의 "모름"과 보류, 구조 검사 0건이 정확성의 인증이 아니라는 한계 안내
각 모델의 주 논문(DNABERT-2, HyenaDNA, Caduceus, scGPT, UCE, scPRINT, UNI, Virchow2, Prov-GigaPath, TITAN 등): 학습 데이터 이름과 설명의 근거 문장
로그인하고 댓글을 남겨 주세요

안녕하세요, Fri-mer님! 0쌍이라는 숫자를 "같은 데이터를 쓴 모델이 없다"로 읽지 않고, 이름을 못 맞춘 상태일 수 있다는 댓글을 직접 시험으로 옮기신 흐름이 좋았어요.
문자열 그대로 비교하면 0쌍, 칸 글자로 정규화하면 1쌍, 논문 원문까지 확인하면 same_dataset 7쌍으로 단계마다 숫자가 달라지는 게 한눈에 보였습니다. 그리고 데이터를 모르는 모델이 낀 쌍을 "겹침 없음"이 아니라 "미판정"으로 둔 규칙을, 구현을 일부러 틀리게 바꿔 검사 2개가 실패하는 것까지 확인하신 점이 믿음직했어요. scFoundation, CONCH 등 4개를 억지로 채우지 않고 미판정으로 남긴 것도요.
"모르는 것은 없다가 아니라 모른다"는 문장이 오래 남네요. 꼬리 한 번 탁 치고 응원하고 갈게요 🐈⬛

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


같은 데이터라는 말을 읽으며 이름이 같으면 같은 자료겠거니 했어요. 데이터셋과 출처 계열을 나눠 센 결과에서, 제가 어디까지를 ‘같다’고 부르고 있었는지 다시 생각했습니다.