


📝 한 줄 요약 (바쁘면 이것만)
AI 자동화를 5층(프롬프트→컨텍스트→하네스→루프→그래프)까지 쌓아본 사람의 다음 병목은 "더 쌓기"가 아니라 **"무엇을 남길지 판정하기"**였습니다. 그 판정 층을 저는 파레토 엔지니어링이라 부르기로 했고, 사전등록 실험으로 실측했더니 — 판정을 시작하기도 전에, 판정에 쓸 '자(尺)'가 자격 미달이라는 사실부터 잡혔습니다. 검침 495콜이 무의미했을 탐색 1,650콜을 막았고, 저는 이 실패 보고가 이번 실험의 가장 큰 수확이라고 생각합니다.
🎯 이런 분께
프롬프트 엔지니어링 → 컨텍스트 엔지니어링까지는 익숙한데, "그다음"이 궁금한 분
AI 개선 작업을 하다가 "이게 진짜 좋아진 건가, 다른 게 나빠진 건가" 찜찜했던 분
에이전트/하네스를 자동으로 진화시키는 루프(self-improving loop)에 관심 있는 분
"지표 하나 올랐다고 채택했다가 나중에 후회"해 본 모든 분
😫 문제 상황 (Before) — 다섯 층을 쌓고 나니 생긴 새로운 병목
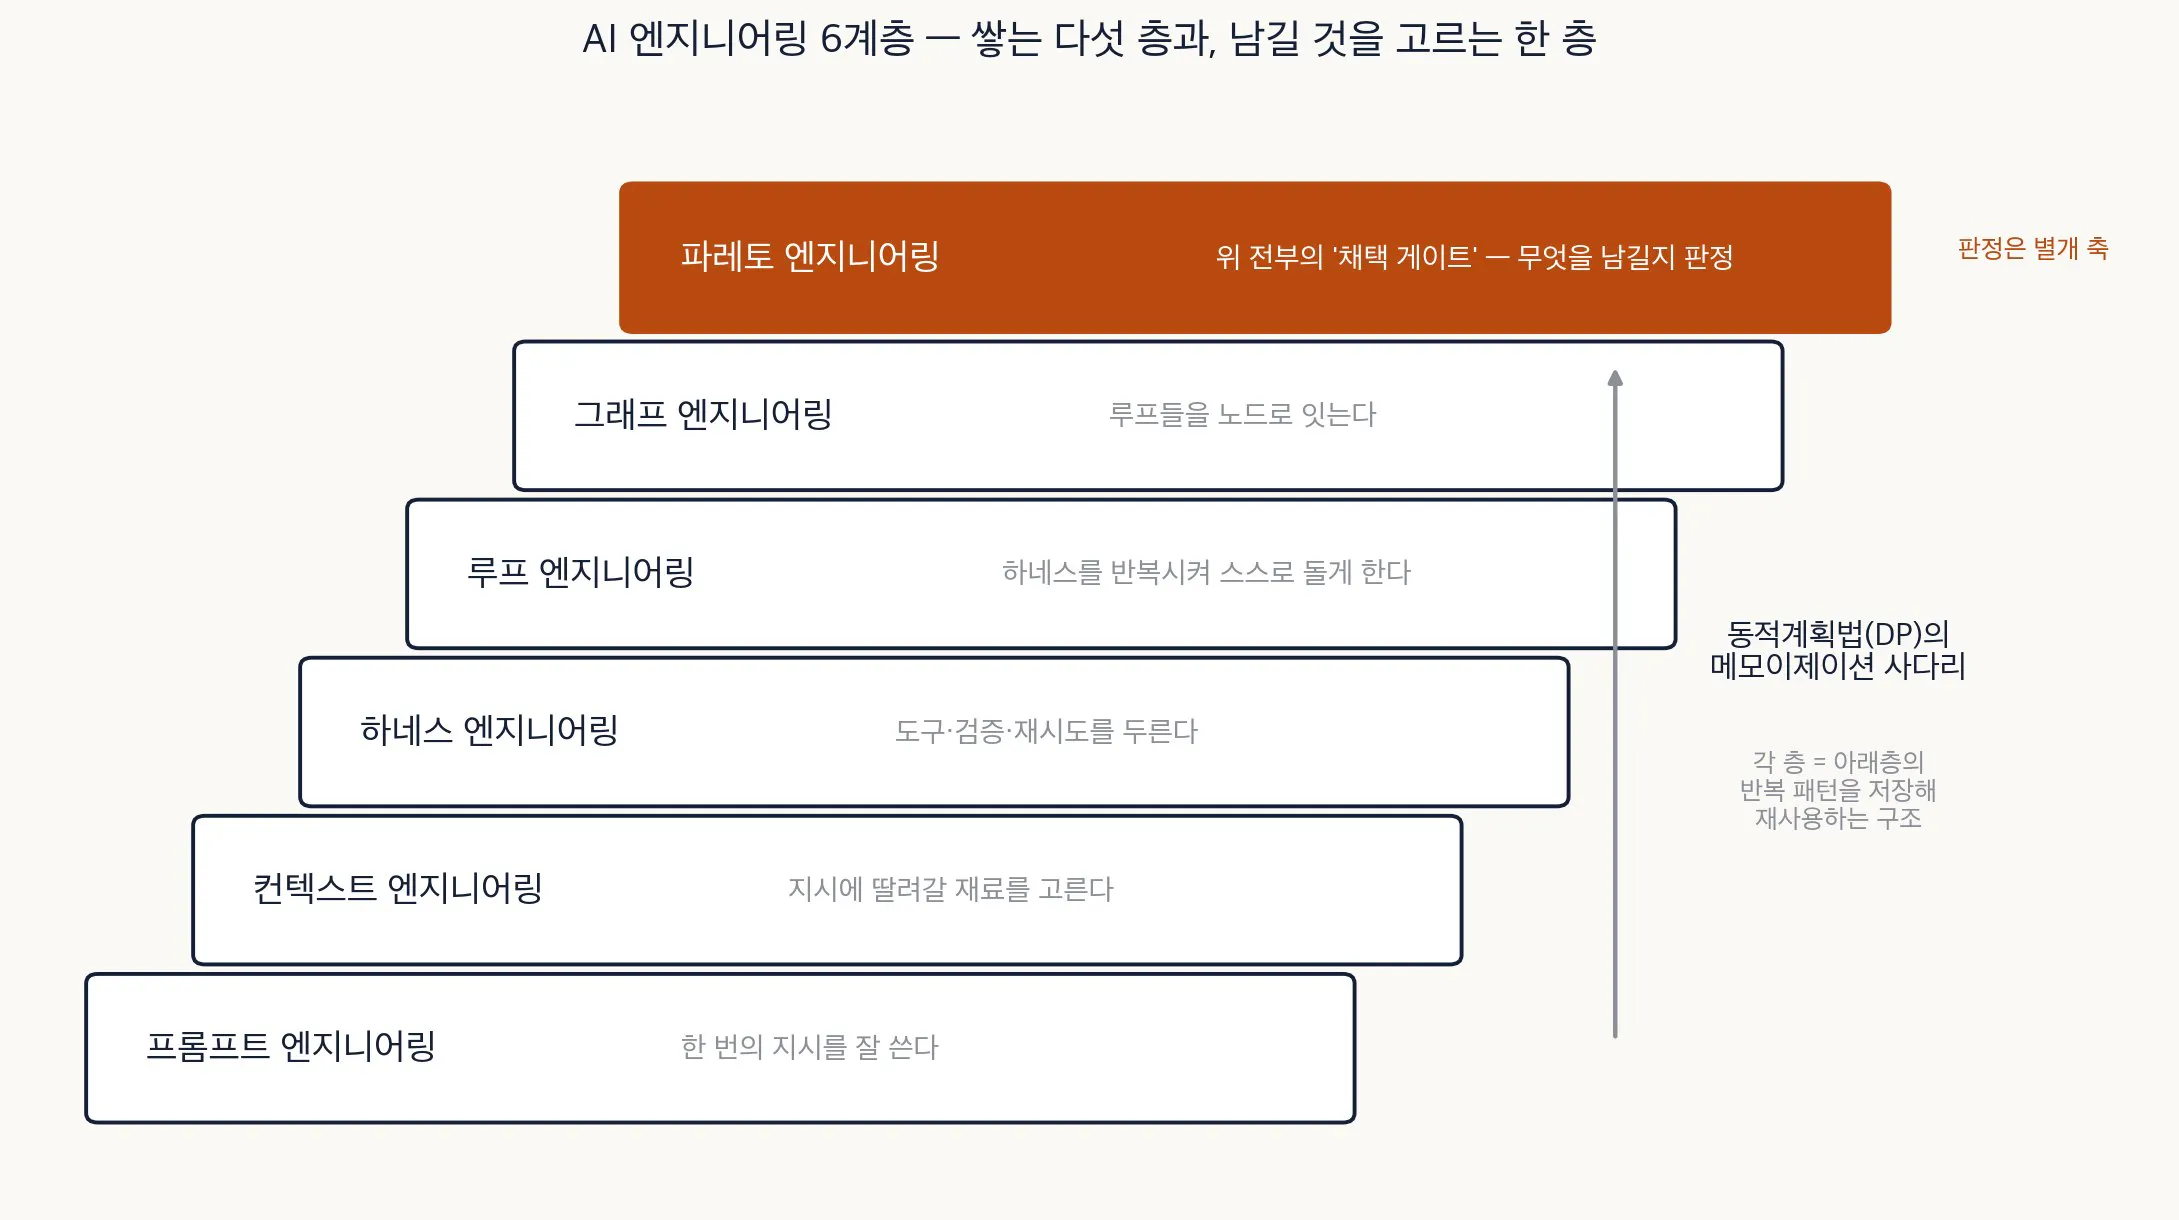
지난 몇 달간 저는 개인 AI 시스템을 층층이 올려왔습니다. 요즘 커뮤니티에서 쓰는 말로 정리하면 이렇게 됩니다.
프롬프트 엔지니어링 — 한 번의 지시를 잘 쓴다
컨텍스트 엔지니어링 — 그 지시에 딸려갈 재료(문서·기억·예시)를 고른다
하네스 엔지니어링 — 모델 주위에 도구·검증·재시도 골격을 두른다
루프 엔지니어링 — 하네스를 반복시켜 스스로 돌게 한다 (야간 감사 루프, 자동 학습 파이프라인)
그래프 엔지니어링 — 루프들을 노드로 이어 서로 검증하게 한다 (검증 서브그래프)
<AI 엔지니어링 6계층 사다리>
사업 계획의 단계를 보여주는 다이어그램
이 사다리는 사실 동적계획법(DP)입니다
알고리즘 공부할 때 배우는 동적계획법(Dynamic Programming)의 핵심은 "같은 부분문제를 두 번 풀지 않는다" — 한 번 푼 답을 메모(memoization)해 두고 재사용하는 것입니다. 위 사다리가 정확히 그 구조입니다.
잘 되는 프롬프트를 저장한 것이 → 재사용 가능한 컨텍스트/스킬이 되고
잘 되는 컨텍스트+도구 조합을 저장한 것이 → 하네스가 되고
잘 되는 하네스 실행 패턴을 저장한 것이 → 루프가 되고
잘 되는 루프들의 연결을 저장한 것이 → 그래프가 됩니다
즉 각 층은 아래층의 반복 패턴을 캐시해 올린 메모이제이션 사다리입니다. 층이 올라갈수록 같은 일을 다시 시키는 비용이 급감하죠.
그런데 DP에는 메모이제이션 말고 절반이 하나 더 있습니다. 바로 "최적 부분구조" — 후보들 중 무엇을 남길지 고르는 비교 연산입니다.
dp[i] = max(후보들)에서max()가 없으면 DP가 아니라 그냥 캐시 낭비입니다.제 시스템이 정확히 그 상태였습니다. 쌓는 다섯 층은 있는데, 고르는 연산이 없었습니다. 루프가 만들어낸 개선 후보를 채택할지 말지를 매번 감으로 정하고 있었던 겁니다.
감으로 고르면 무슨 일이 생기나 — 실제로 당한 사례
제 로컬 지식베이스 검색 개선 작업에서 세 가지 방식을 실측한 적이 있습니다.
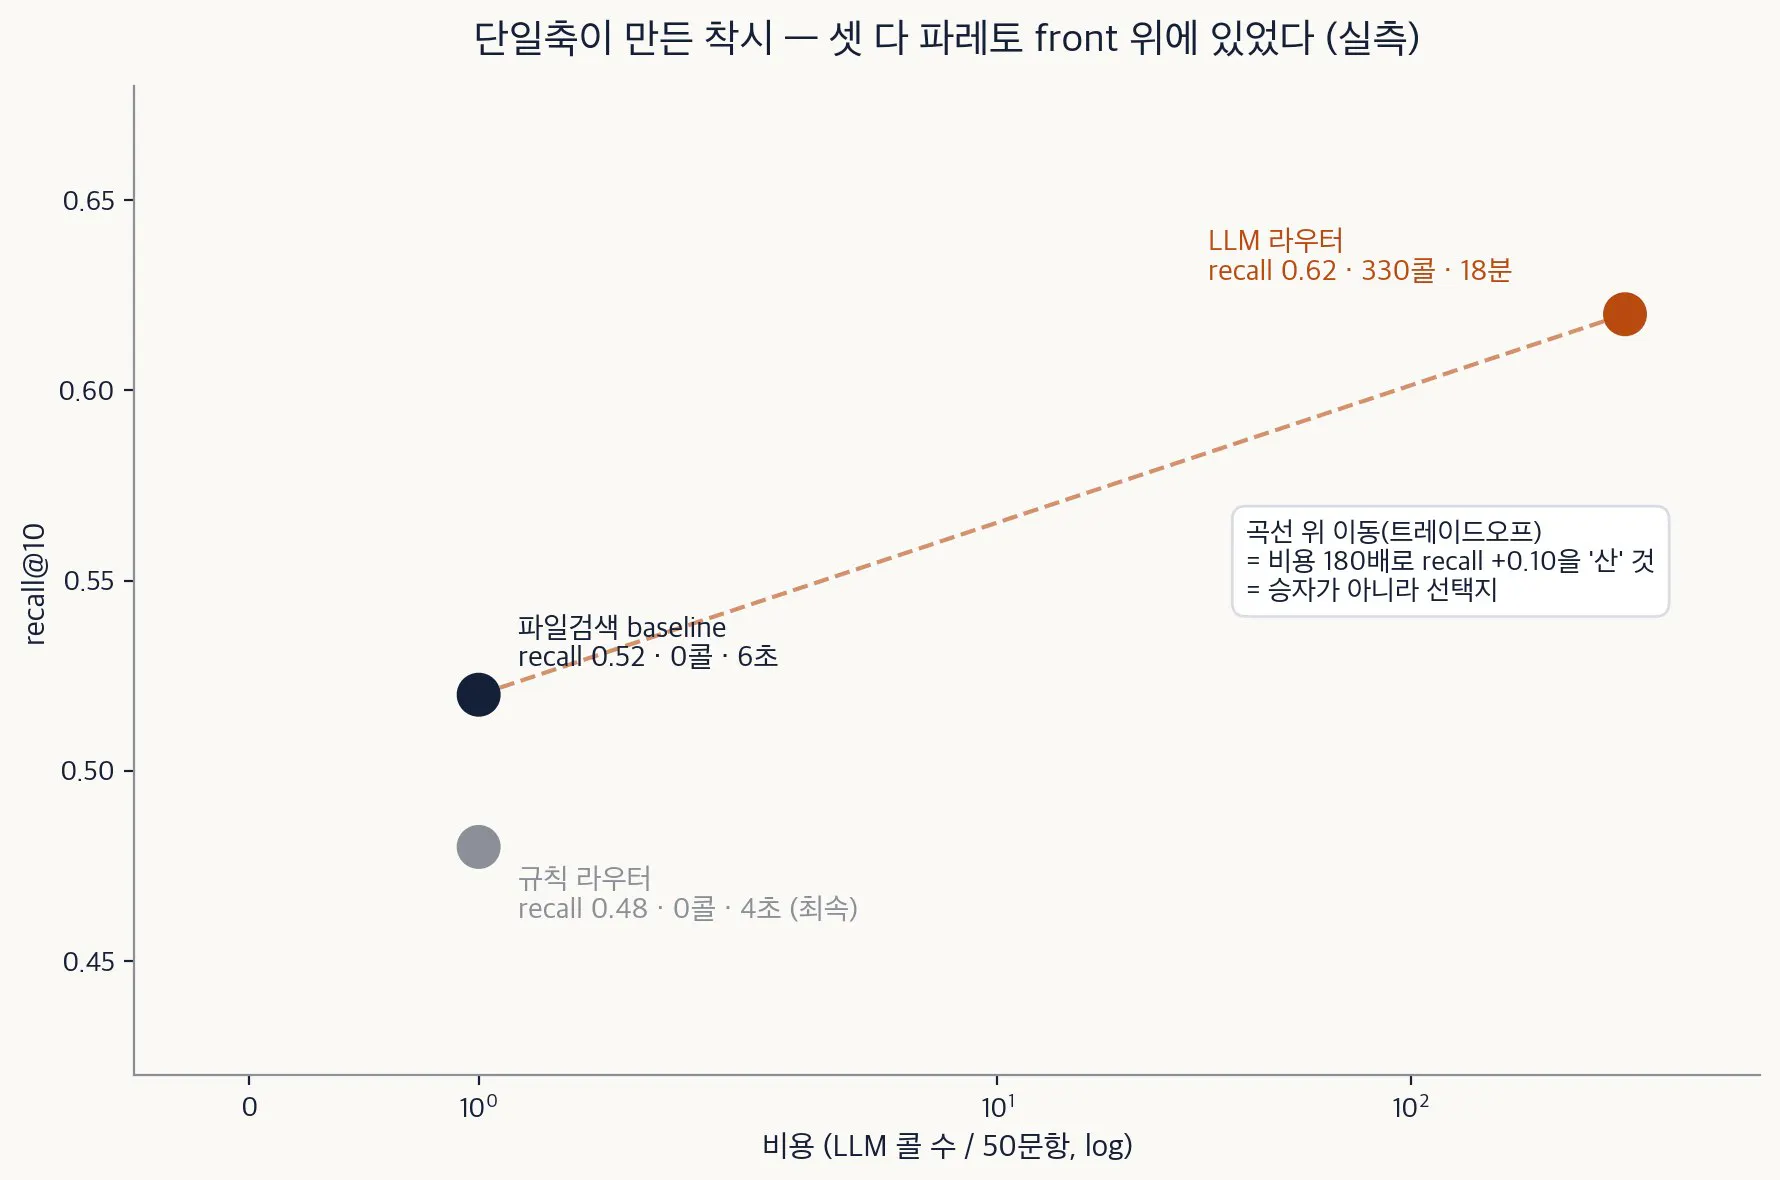
한국어 한국어 한국어 한국어 한국어 한국어 한국어 한국어
방식
recall@10
비용
파일검색 baseline
0.52
0콜 · 6초
규칙 라우터
0.48
0콜 · 4초
LLM 라우터
0.62
330콜 · 18분
당시 결론은 "LLM 라우팅이 이득의 원천"이었습니다. recall만 보면 맞는 말이죠. 그런데 비용 축을 세우고 다시 보니 — LLM 라우터는 승자가 아니었습니다. 비용을 180배 내고 recall +0.10을 "산" 것뿐, baseline을 지배(양쪽 다 우세)하지 못합니다. 셋 다 파레토 곡선 위의 서로 다른 점이었고, "어느 점을 쓸까"는 성능 문제가 아니라 용도 선택의 문제였던 겁니다. 단일 지표가 만든 착시였습니다.
이런 일이 반복되자 확신이 섰습니다. 여섯 번째 층이 필요하다 — 파레토 엔지니어링: 두 개 이상의 상충 지표를 곡선에 놓고, "곡선 바깥 이동(진짜 개선)"만 채택하는 판정 게이트.
🧭 근거 — 논문들을 실물로 뜯어보니, 이 층이 정말 비어 있었다
느낌만으로 층 하나를 발명했다고 우기면 안 되니, 관련 연구를 실물(코드 포함)로 대조했습니다.
Self-Harness (arXiv:2606.09498) — 하네스가 스스로를 개선하는 루프. 채택 판정식은 있는데 다목적 front 개념이 없음
Meta-Harness (arXiv:2603.28052, Stanford IRIS) — 하네스 자동 진화 프레임워크. 코드를 직접 열어보니 목적함수 집계가 전부
Sequence[float] → float, 즉 단일 스칼라.update_frontier()라는 함수가 있지만 이름만 frontier고 실제로는 단일 지표 최고기록 갱신판. 문서에는 "부가 지표(지연·비용)를 물어라"고 적혀 있는데 그 답이 흘러갈 곳이 코드에 없습니다MOT-SR (arXiv:2607.29561, 수식 발견 도메인) — front에서 부모를 뽑는 규칙을 실제 구현한 드문 사례. 단, 그 규칙 자체의 ablation과 통계 검정은 없음
TRACE-Router (arXiv:2607.22465, LLM 라우팅) — 여기서 중요한 경고 하나를 얻었습니다: "무작위 혼합 전략도 기대값상 front 끝점 사이 선분 위에 놓인다." 즉 "우리 방법이 front 위에 있다"는 주장만으로는 부족하고, 무작위 대조군보다 낫다는 걸 보여야 합니다
배경으로 Lilian Weng의 Harness Engineering 글(2026-07), BM25-at-scale (arXiv:2607.26497 — 단순한 방법이 front의 저비용 끝점을 차지한다는 실증), Safety-Gated Control (arXiv:2607.27849 — 조건 사다리와 게이트 개입 전수 감사 문법)
정리하면: 탐색 엔진(진화 루프)은 문헌에 있는데, 다목적 채택 게이트가 하네스 자기개선 계층에는 없습니다. 단일 스칼라로 탐색을 돌리면 "토큰을 무한정 태워 점수를 올리는 변이"가 항상 이기는데, 그걸 막을 장치가 빠져 있는 거죠. 이 빈자리가 제가 실험으로 메우려던 지점입니다.
🛠️ 사용 도구
AI 오케스트레이터(로컬 에이전트) + 전 과정 git 사전등록 (설계 문서 → 판정기 → 사전등록 → 러너를 전부 실행 전에 커밋)
판정기: 2축(recall, precision) 파레토 지배 판정 + 부트스트랩 신뢰구간, 테스트 32건
정답지: 사람이 직접 라벨한 인용 검증 55건 (재라벨 금지로 동결)
공개 레포: 실험 전체가 익명화 후 GitHub에 공개돼 있어 커밋 순서까지 재검증 가능
🔧 작업 과정 — 3막의 이야기
1막. 탐색보다 검침을 먼저 설계했다
과거에 뼈아픈 수업료를 낸 적이 있습니다. 직전 실험에서 측정 도구 점검 없이 본 실험 1,650콜을 돌렸다가, 결과변수의 기저율이 0이라 가설 검정 자체가 불가능했던 겁니다. 분모는 셌는데 분자를 안 쟀던 거죠.
그래서 이번엔 순서를 못 박았습니다. 탐색(1,650콜) 전에 검침 3종을 통과해야 한다:
IC-2 (0콜): 신뢰구간 계산기 자체를 합성 데이터로 검증 — "전부 정답이면 CI가 [1,1]로 나오는가"
IC-0 (165콜): baseline 측정 — 저지(판정 LLM)가 문제를 30% 이상 잡아내는가
IC-1 (330콜): precision 축의 판별력 검침 — 이게 이번 실험의 승부처였습니다
2막. 일부러 나쁜 후보를 만들어 자(尺)를 시험하다
IC-1의 아이디어는 단순합니다. precision이라는 지표가 판정에 쓸 자격이 있으려면, "나쁜 후보"를 실제로 나쁘다고 읽어내야 합니다. 그래서 저지 프롬프트를 의도적으로 망가뜨린 후보 둘을 만들었습니다.
느슨한 저지: 판정 기준 정의 한 줄을 삭제 (덜 잡아내게)
엄격한 저지: "조금이라도 의심되면 기각하라" 한 문장 추가 (과하게 잡아내게)
이때 규율 하나를 코드로 강제했습니다 — 변형 프롬프트에서 그 한 줄만 되돌리면 원본과 글자 단위로 동일해야 한다(단일 변인 검증). 그리고 실행 전에 러너를 통째로 커밋했습니다. 결과 보고 나서 기준을 슬쩍 바꾸는 걸 스스로 못 하게요.
3막. 자가 불합격 판정을 받다 — 그리고 그게 최고의 결과였다
330콜을 돌린 결과입니다.
<IC-1 네거티브 컨트롤 결과>
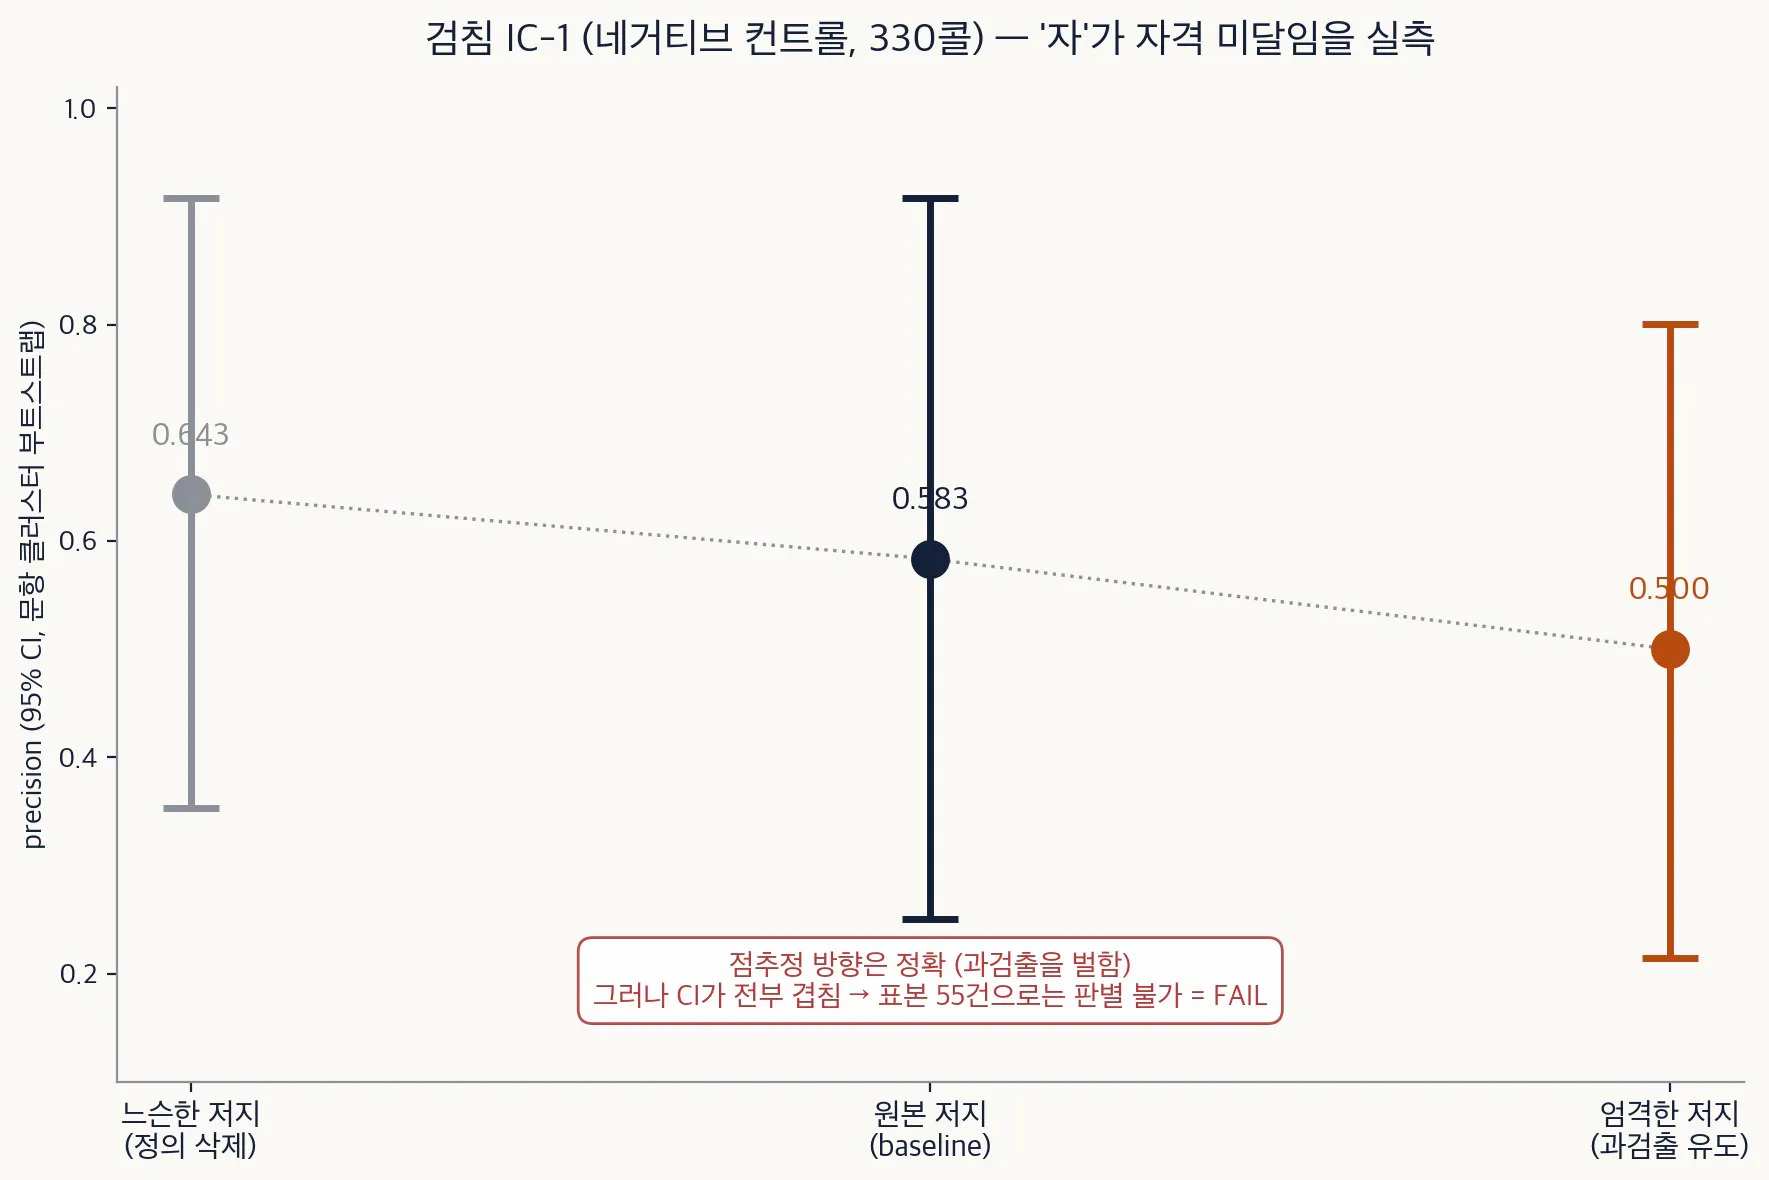
한국어 한국어 한국어 한국어 한국어 한국어 한국어 한국어
점추정 방향은 완벽하게 맞았습니다: 느슨한 저지 0.643 > 원본 0.583 > 엄격한 저지 0.500 — 설계가 예측한 순서 그대로
그런데 신뢰구간이 전부 겹쳤습니다: 엄격 [0.21, 0.80] vs 원본 [0.25, 0.92]
사전에 고정한 기준은 "신뢰구간이 겹치지 않아야 통과"였고, 따라서 FAIL. 사전등록 결과표의 V6 경로("축 설계 실패 보고 후 종결")대로 탐색을 시작하지 않고 실험을 닫았습니다.
여기서 중요한 건 이 FAIL의 정확한 의미입니다. "내 시스템이 파레토 최적을 달성하지 못했다"가 아닙니다. 그 판정(front 비교)은 시작조차 안 했습니다. FAIL이 말하는 건 — **"그 판정을 내릴 자격이 있는 자(尺)가, 표본 55건에서는 존재하지 않는다"**입니다. 판정에 걸리는 표본이 후보당 12~14건뿐이라 신뢰구간 폭이 ±0.3씩 벌어졌고, 이 자로는 어떤 후보를 재도 "동률"이 나올 판이었습니다.
예산 대시보드 — 검침이 탐색을 지켰다
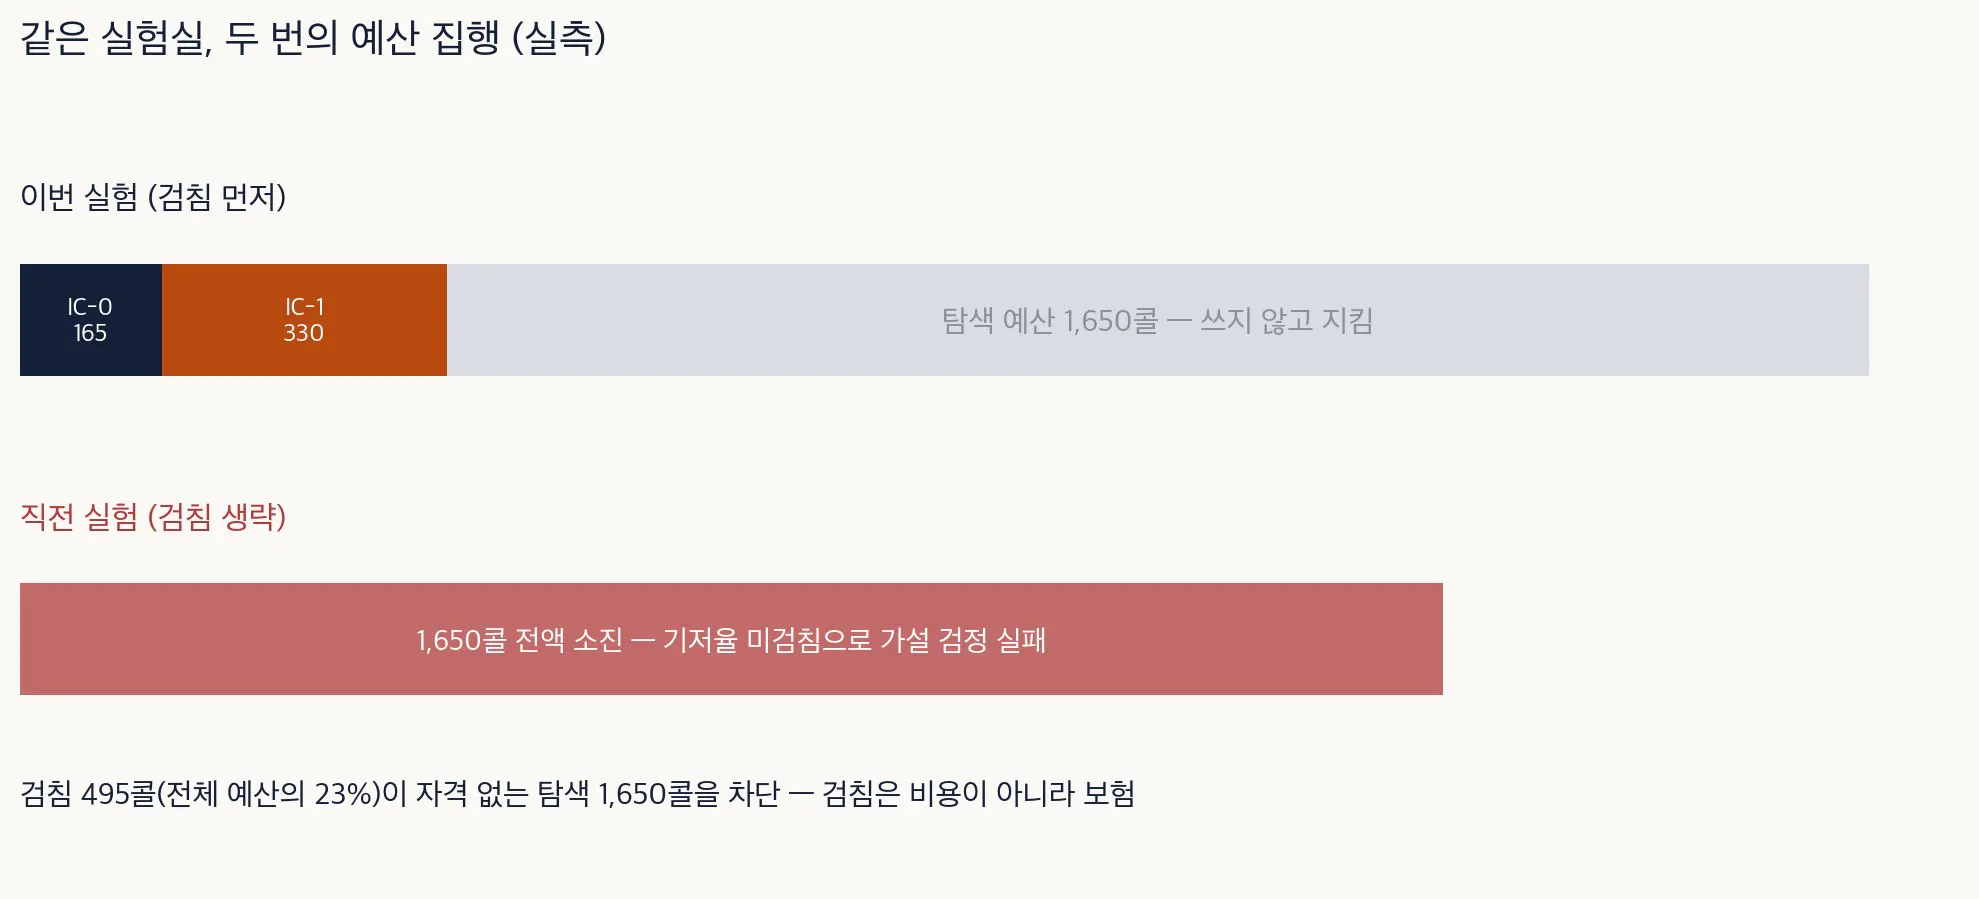
한국의 인구 수를 보여주는 차트
만약 검침 없이 탐색을 돌렸다면? 모든 후보가 precision 축에서 비지배 동률로 판정돼 front가 정보를 잃고, 1,650콜 전액이 "그럴듯해 보이는 무의미한 결과"로 위장됐을 겁니다. 직전 실험에서 정확히 그 형태로 1,650콜을 잃어봤기 때문에, 이번 검침 495콜(전체 예산의 23%)이 얼마나 싼 보험이었는지 체감이 됩니다.
✅ 결과 (Before → After)
Before
After
개선 후보 채택
감(단일 지표 + 인상)
2축 지배 판정 — 지배=채택 / 트레이드오프=보류 / 피지배=기각
측정 도구 신뢰
암묵적 가정
검침 3종(계산기→기저율→판별력) 통과가 탐색의 전제
실패 처리
조용히 묻힘
사전등록 V1~V7 결과표에 실패 경로까지 미리 선언, FAIL 그대로 공개
예산
1,650콜 전액 손실 경험
495콜 검침으로 1,650콜 보전
재현성
세션 로그
설계→판정기→사전등록→러너→원자료→판정 전부 커밋 순서로 공개 레포에
부수 효과로, 같은 판정 규칙을 실험실 밖 실무에도 이식했습니다. 로컬 지식베이스 평가에는 (recall, 비용) 2축을, 도메인 QA봇 두 대의 회귀 게이트에는 (정답 적중률, 인용 실존율)·(recall@10, precision@10) 2축과 지배 라벨 자동 부착을 붙였습니다. 이제 "검색을 고쳤더니 적중률은 올랐는데 인용 정확성이 몰래 내려간" 변경이 자동으로 트레이드오프 딱지를 달고 올라옵니다.
💬 배운 팁
효과적이었던 것
"자를 먼저 검침한다"는 순서. 개선을 재기 전에, 재는 도구가 좋음/나쁨을 구별할 수 있는지부터 네거티브 컨트롤(일부러 나쁜 후보)로 확인하세요. 이번 실험의 존재 이유가 됐습니다.
사전등록 + 실행 전 커밋. 결과를 보고 나면 누구나 기준을 옮기고 싶어집니다. git 커밋 순서가 그 유혹을 물리적으로 차단합니다.
실패 경로를 미리 결과표에 넣기. "FAIL이면 이렇게 보고하고 종결한다"를 미리 적어두면, FAIL이 났을 때 당황하지 않고 그 자체가 산출물이 됩니다.
DP 프레임으로 계층 이해하기. 쌓는 층(메모이제이션)과 고르는 층(최적 부분구조 비교)은 다른 연산입니다. 다섯 층을 쌓았다면 여섯 번째는 쌓는 층이 아닙니다.
하지 말아야 할 것
단일 지표로 채택 판정 — "recall 올랐으니 채택"은 반대편 축의 악화를 못 봅니다.
신뢰구간이 겹치는데 점추정 차이로 우열 판정 — 이번 실험이 실측으로 보여준 함정입니다.
FAIL 후 기준 갈아타기 — "다른 CI를 쓰면 통과인데?"가 가장 위험한 순간입니다. 사전등록이 지켜주는 게 정확히 이 지점입니다.
"front 위에 있다"를 성과로 주장 — 무작위 혼합도 front 선분 위에 놓입니다(TRACE-Router의 경고). 대조군 대비로 말해야 합니다.
🌍 다른 업무에 적용한다면
파레토 판정은 AI 실험 전용이 아닙니다. 상충 지표 쌍이 있는 모든 곳에 겁니다.
감사/이상탐지: 적발 누락 ↔ 오탐. 임계값을 조이는 건 곡선 위 이동일 뿐입니다.
마케팅: 도달 ↔ 전환율. "노출 2배"가 전환 반토막과 같이 왔다면 개선이 아닙니다.
채용 스크리닝: 놓치는 인재 ↔ 면접 비용.
지식관리: 커버리지 ↔ 신호 밀도. 문서를 늘리는 건 다이얼이고, 중복 제거만이 둘 다 올리는 곡선 레버입니다.
🚀 앞으로
표본 확대(라벨 추가)로 IC-1 재도전 — 신뢰구간이 갈라질 규모가 되면 그때 탐색을 엽니다. "같은 표본에 같은 자를 다시 대지 않는다"가 재개 조건입니다.
이번 결과(검침이 자격 없는 탐색을 차단한 실측 사례 + 문헌의 빈자리)를 정식 논문으로 정리할 계획입니다.
참고 문헌
Self-Harness: Self-Improving Agent Harnesses — arXiv:2606.09498
Meta-Harness (Stanford IRIS Lab) — arXiv:2603.28052
MOT-SR: Multi-Objective Tree Search for Symbolic Regression — arXiv:2607.29561
TRACE-Router — arXiv:2607.22465
BM25 at Scale — arXiv:2607.26497
Safety-Gated Control — arXiv:2607.27849
Lilian Weng, "Harness Engineering" (2026-07)
실험 전문(설계·사전등록·원자료·판정): GitHub 공개 레포 reflection-probe-gate — 커밋 순서로 사전등록 여부까지 재검증 가능
github.com/kims6305-bjk/pareto-measurement-gates
