공식 자료 조사부터 이미지와 HTML까지, AI로 블로그 글 한 편 완성하기
2026.08.05
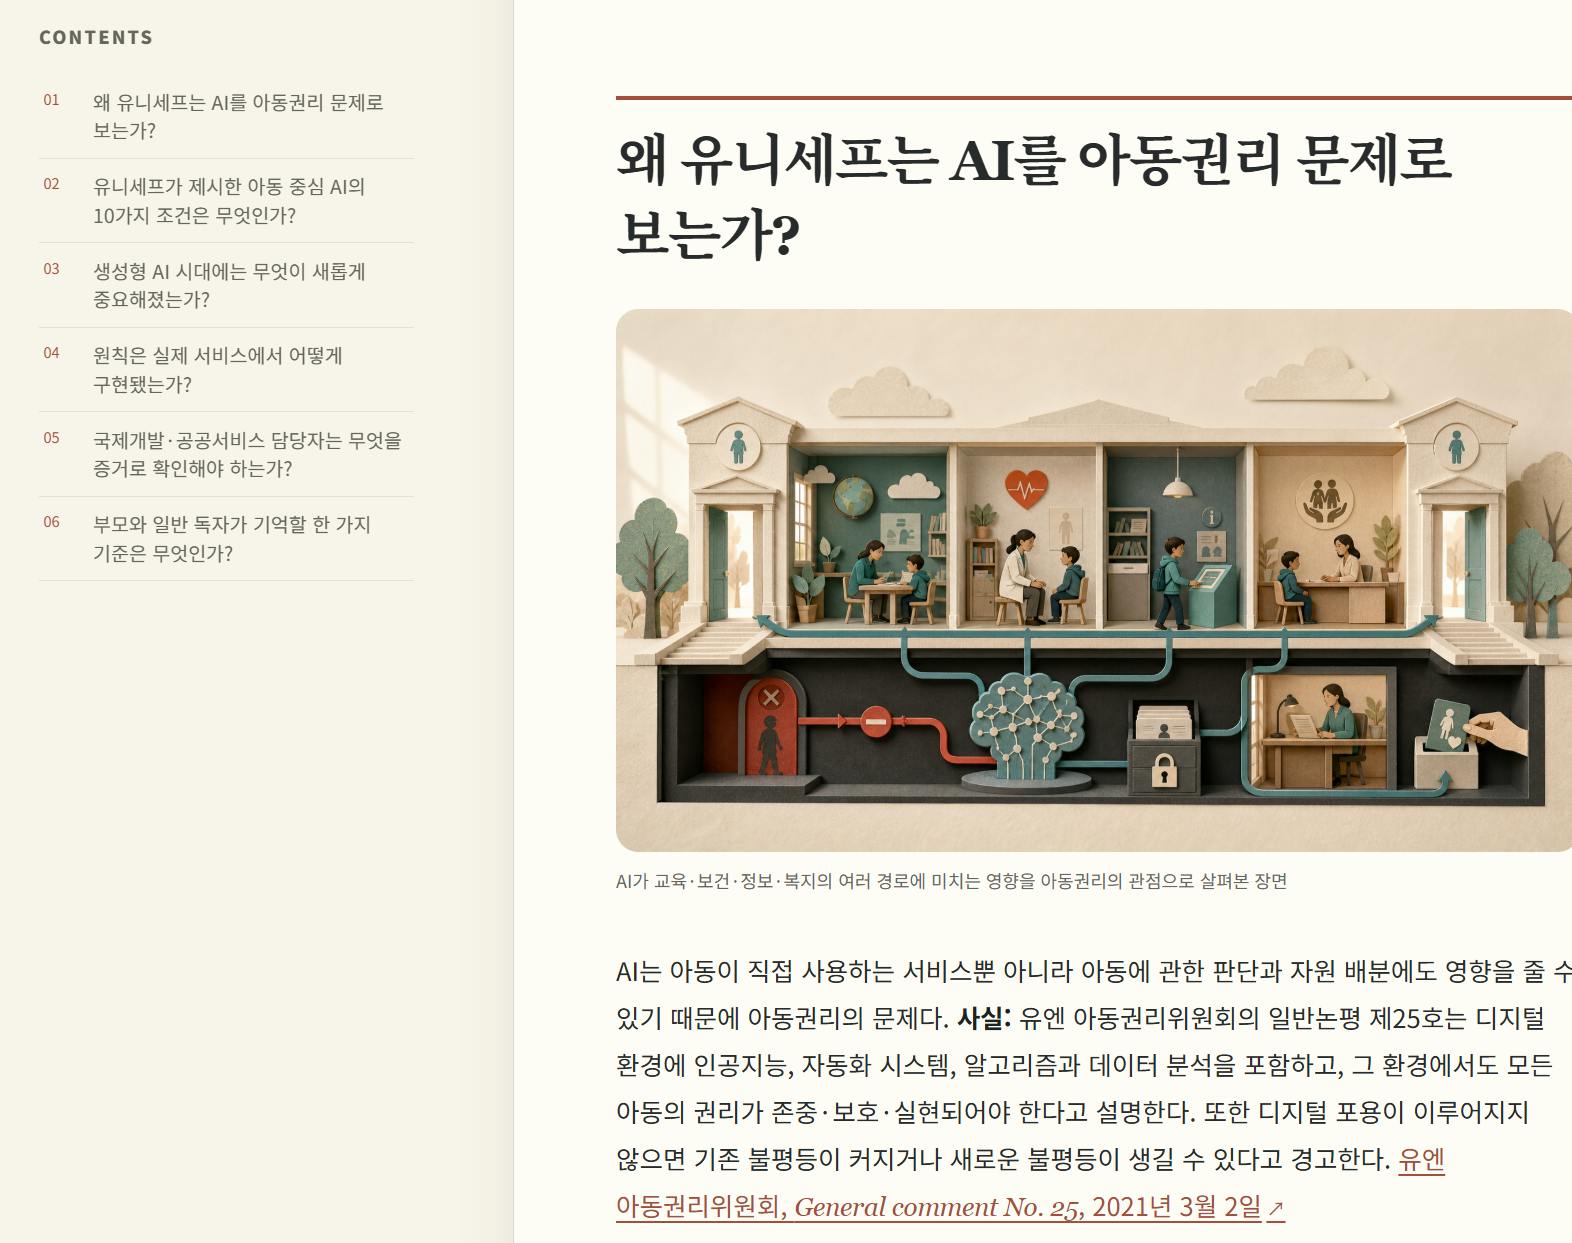
시도하고자 했던 것과 그 이유
이번에는 단순히 AI에게 “블로그 글을 써줘”라고 요청하는 대신, 하나의 글이 완성되는 전 과정을 단계별 파이프라인으로 이안님 발표를 따라 구현해봤다.
생각하고 있던 주제를 하나 고르고, 독자를 선정하고, 자료 조사부터 시켰다.
글만 작성하는 데서 끝내지 않고 다음 결과물까지 함께 만들고 싶었다.
검증된 공식 자료를 바탕으로 한 블로그 원고
글의 각 부분을 설명하는 16:9 이미지
이미지 전체에 적용되는 일관된 시각 스타일
글과 이미지가 결합된 HTML
네이버 블로그에 옮겨 사용할 수 있는 최종 파일
핵심은 AI를 단순한 글쓰기 도구가 아니라 리서처, 편집자, 이미지 디렉터, 웹 제작자로 나누어 활용해보는 것이었다.
진행 방법
어떤 도구를 사용했고, 어떻게 활용했나요?
Codex를 중심으로 활용했다.
옵시디언과 네이버 블로그용 파일 정리
전체 과정은 다음과 같이 나눴다.
brief.md
→ sources.json
→ draft.md
→ image-plan.json
→ 이미지 7장 생성
→ 글과 이미지를 결합한 HTML
→ 네이버·옵시디언용 결과물 정리
1주차처럼 이안님 프롬프트를 복붙하지 않고, 이번에는 프롬프트 흐름을 카피 하되, 변형을 하는 식으로 조금씩 진행했다. 아직 코덱스가 처음이기에 이안님 프롬프트가 있는 것이 훨씬 시작이 쉬웠다. 일단 초기 몇 단계를 따라하다보니 어느새 다음 단계는 수월해지는 느낌..
1. 글을 쓰기 전에 브리프부터 만들었다
첫 단계에서는 AI가 곧바로 글을 쓰지 못하게 했다. 먼저 키워드, 독자, 독자의 질문, 글의 목적, 반드시 포함할 내용과 금지할 단정을 brief.md에 기록하도록 요청했다.
사용한 프롬프트
1. brief.md에 키워드, 독자, 질문, 목적, 반드시 포함할 내용, 금지할 단정을 기록해.

2. 주제에 맞는 조사 도구를 선택해 sources.json을 채워.
   - 일반 정보는 공식 문서와 전문 자료를 우선하고 검색 결과는 질문과 형식 파악에 사용해.
   - 구글 영어 조사가 중요해.
   - 조회에 실패하면 본 것처럼 꾸미지 말고 ‘확인 필요’로 남겨.
- 출처 없는 가격·기한·법적 결론은 쓰지 마.brief.md에는 다음과 같은 내용이 정리됐다.
주요 독자
독자가 궁금해할 질문
글에서 다뤄야할 주요 정책
포함할 실제 사례
법적 효력이나 효과를 과장하지 않기 위한 금지 표현
추가 확인이 필요한 국내 정책과 최신 운영 현황
이 단계에서 특히 유용했던 것은 ‘금지할 단정’을 미리 적어둔 것이었다.
2. 조사 결과를 sources.json으로 구조화했다
다음으로 관련 영어 공식 자료를 조사했다.
각 자료는 sources.json으로 정리하고
검색 결과의 설명문만 보고 출처로 채택하지 않고, 원문을 열어 확인된 자료에만 verified 상태를 부여했다.
발행일이나 최신 운영 현황을 확인하지 못한 경우에는 억지로 채우지 않고 확인 필요라고 표시했다.
3. 확인된 두 파일만 사용해 초안을 작성했다
글을 작성할 때는 brief.md와 sources.json만 입력으로 사용하도록 제한했다.
사용한 프롬프트
확인된 brief.md와 sources.json만 입력으로 draft.md를 작성해.

- H1은 제목 방향을 그대로 복사하지 말고 독자가 얻을 답이 보이게 새로 써.
- 도입 1~2문장에서 핵심 판단을 먼저 말해.
- H2 수를 미리 고정하지 말고 필요한 질문 수만큼만 만들어.
- 각 H2 첫 문장은 답, 뒤에는 근거·조건·예외·독자에게 주는 의미 순서로 써.
- 분량을 채우려고 같은 결론, 불필요한 FAQ, 꾸며낸 경험을 추가하지 마.
4. 글을 바탕으로 이미지 기획서를 만들었다
본문이 완성된 뒤에는 각 H2에 어떤 이미지가 필요한지 image-plan.json으로 설계했다.
사용한 프롬프트
본문이 통과하면 draft.md의 H2를 읽어 image-plan.json을 만들어.

- 한 글은 style_id 하나를 유지해.
- 표지와 H2마다 scene_class를 다르게 해.
- 각 장면 프롬프트에는 STYLE, ROLE, SCENE, MUST SHOW,
  COMPOSITION, AVOID 여섯 항목을 모두 써.
- ‘예쁜 이미지’처럼 추상적으로 쓰지 말고 장소·행동·시점·조명·재료와
  보여야 할 증거를 구체화해.
전체 이미지에는 하나의 style_id를 사용했다.
child_rights_ai_editorial_v1시각 스타일은 다음과 같이 정의했다.
밝은 아이보리 배경
종이 컷아웃과 낮은 3D 디오라마의 결합
차콜, 벽돌색, 차분한 청록색
부드러운 오전 자연광
무광 재생지, 나무, 패브릭 재료
과도한 미래 기술이나 네온 효과 제외
대신 장면의 역할과 구도는 모두 다르게 만들었다.
5. 16:9 이미지를 생성했다
이미지를 생성할 때는 다음 조건을 추가했다.
사용한 프롬프트
이미지는 가로 16:9를 기본으로 만들고 중앙 안전영역에 핵심 피사체를 둬.

글자 오버레이, 가짜 글자, 반복 구도, 본문과 무관한 장면은 피해야 해.

전체 이미지는 같은 재료, 색상, 조명을 사용하되
장면마다 시점과 행동, 구도를 다르게 만들어.
총 7장의 이미지가 만들어졌고, 모두 1672×941px 크기로 생성됐다.
이미지 안에는 긴 설명을 넣지 않고, 방패·잠금장치·저울·삭제 경로·사람의 개입처럼 글에서 설명한 개념을 물체와 행동으로 표현했다.
6. 글과 이미지를 하나의 HTML로 만들었다
마지막으로 draft.md의 본문과 이미지 7장을 결합해 HTML을 만들었다.
HTML에는 다음 기능을 넣었다.
본문 목차
읽기 진행 표시
공식 출처 링크
모바일 반응형 구성
표의 가로 넘침 방지
인쇄·PDF 저장용 스타일
이미지 7장의 Base64 내장
이미지를 외부 파일로 연결하지 않고 HTML 안에 포함했기 때문에, HTML 한 파일만 옮겨도 글과 이미지가 함께 유지된다.
완성 파일은 약 21MB였고 다음 항목을 다시 검사했다.
H1 1개
H2 6개
이미지 7개
내장 이미지 7개
16:9 비율
외부 CSS 라이브러리 없음
결과와 배운 점
HTML과 옵시디언은 같은 저장 방식이 아니었다
HTML에 이미지를 내장하면 파일 하나로 이동하기 편하다. 하지만 옵시디언은 기본적으로 HTML 파일을 노트 목록에 표시하지 않는다.
옵시디언에서 보려면 다음 구조가 더 적합했다.
글 제목/
├─ 글 제목.md
└─ images/
   ├─ 01-cover.png
   ├─ 02-rights-lens.png
   └─ ...
반면 네이버 블로그로 옮길 때는 렌더링된 HTML을 브라우저에서 열어 복사하는 방식이 편리했다. 다만 네이버 스마트에디터의 클립보드 정책에 따라 이미지가 자동으로 업로드되지 않을 수도 있어, 원본 이미지 파일을 함께 보관하는 것이 안전했다.
과정 중에 어떤 시행착오를 겪었나요?
1. 로컬 HTML의 브라우저 자동 검증이 차단됐다
자동 브라우저가 보안 정책상 file:// 주소를 열지 못했다.
억지로 우회하지 않고 다음 항목으로 대체 검증했다.
이미지 픽셀 크기
16:9 비율
HTML의 H1·H2 개수
이미지 태그와 Base64 내장 개수
반응형 CSS
이미지 전체를 모은 접촉 시트
다음에는 처음부터 로컬 테스트 서버를 사용하는 구조를 고려할 수 있을 것 같다.
2. 옵시디언 보관함 경로와 쓰기 권한을 혼동했다
처음에는 실제 옵시디언 보관함이 아닌 작업공간 안에 같은 이름의 폴더를 만들었다. 이후 실제 내 보관함의 경로를 확인했지만, 대화별 파일 권한 때문에 OneDrive 경로 쓰기가 차단되기도 했다.
이 과정에서 배운 점은 다음과 같다.
보관함 경로를 기억하는 것과 쓰기 권한은 별개다.
파일이 저장돼도 HTML은 옵시디언 목록에서 보이지 않을 수 있다.
저장 후에는 반드시 실제 경로와 파일 크기를 다시 확인해야 한다.
Markdown과 HTML의 사용 목적을 구분해야 한다.
3. 한국어 경로가 PowerShell에서 깨졌다
Windows PowerShell 5.1이 UTF-8 BOM이 없는 스크립트의 한국어 경로를 잘못 읽었다.
이를 해결하기 위해 한국어 경로를 코드에 직접 넣지 않고, OneDrive 아래에서 내 보관함의 설정 파일을 자동 탐색하도록 바꿨다.
이 경험을 통해 자동화 스크립트에서는 한국어 파일명뿐 아니라 실행 환경의 문자 인코딩까지 고려해야 한다는 점을 배웠다.
4. API 연결과 파일 접근을 지나치게 복잡하게 생각했다
옵시디언 저장 문제를 해결하려고 Local REST API와 MCP 연결까지 시도했다. 장기적으로는 유용한 방식이지만, 단순히 로컬 보관함에 Markdown 파일을 저장하는 작업이라면 파일시스템 접근이 더 간단할 수 있다.
도구를 추가하기 전에 먼저 “이 작업에 정말 API가 필요한가?”를 판단해야 한다는 점도 배웠다.
나만의 꿀팁
팁 1. AI에게 글을 바로 쓰게 하지 않는다
먼저 아래 세 가지를 만든 뒤 초안을 요청하는 것이 좋다.
brief.md
sources.json
금지할 단정 목록
팁 2. 출처마다 한계를 기록한다
이 출처로 말할 수 있는 것
이 출처로 말할 수 없는 것
자료의 발행 시점
현재도 유효한지 추가 확인할 내용
이 네 가지가 있으면 AI의 과장과 일반화를 줄일 수 있다.
팁 3. 이미지 프롬프트는 여섯 항목으로 나눈다
STYLE
ROLE
SCENE
MUST SHOW
COMPOSITION
AVOID
특히 MUST SHOW와 AVOID가 이미지의 품질과 본문 관련성을 크게 높여줬다.
팁 4. 이미지 스타일과 장면을 분리한다
style_id = 글 전체에서 하나
scene_class = 표지와 H2마다 다르게
이렇게 하면 통일감과 다양성을 동시에 유지할 수 있다.
팁 5. 확인하지 못한 내용은 삭제하지 말고 표시한다
확인하지 못한 항목을 억지로 채우기보다 다음처럼 남겨두는 편이 좋다.
확인 필요
출처 필요
최신 운영 상태 확인 필요
국내 법·정책 별도 조사 필요로그인하고 댓글을 남겨 주세요

달코미님, 지난 흐름을 그대로 복사하기보다 작업 순서를 가져와서 본인 주제에 맞게 하나씩 변형한 과정이 좋았습니다. 처음에는 프롬프트가 길게 느껴져도 brief와 sources를 먼저 만들어보면 다음 단계의 질문이 자연스럽게 보이기 시작하는데, 그 감각을 이번에 제대로 잡으신 것 같아요.
검색 결과의 설명문이 아니라 원문을 직접 확인한 자료에만 verified를 준 부분도 잘하셨어요. 출처마다 말할 수 있는 것과 없는 것, 발행 시점과 추가 확인 사항을 나눠둔 덕분에 초안을 쓸 때 AI가 빈 부분을 마음대로 넓히는 위험도 줄었을 것 같습니다.
이미지에서는 한 가지 style_id를 유지하면서 H2마다 장면과 행동을 다르게 만든 방식이 눈에 들어왔습니다. 일곱 장이 같은 글의 이미지처럼 보이면서도 방패나 저울, 삭제 경로처럼 각 문단의 개념이 반복되지 않게 표현돼서 장식이 아니라 설명 자료로 기능했을 것 같아요.
HTML과 옵시디언의 저장 방식을 직접 부딪쳐보고 구분한 경험도 의미 있네요. 파일 하나로 옮기기 편한 HTML과, Markdown과 이미지 폴더를 함께 두는 옵시디언은 쓰임이 다르니 둘을 억지로 같은 형식에 맞추지 않은 판단이 좋았습니다. API와 MCP까지 고민한 뒤 단순한 파일 저장에는 파일시스템 접근이 더 맞다는 결론을 낸 것도 실용적이고요.
다음에는 로컬 테스트 서버로 HTML을 실제 렌더링한 뒤 모바일 폭과 네이버 편집기로 복사했을 때 이미지가 그대로 들어가는지까지 한 번에 확인해보시면 좋겠습니다. 생성 파일의 개수와 비율 검증에 실제 독자 화면 검수가 더해지면 파이프라인의 마지막 빈칸도 많이 줄어들 것 같아요 👍

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

brief.md → sources.json → draft.md → image-plan.json → 이미지 7장 → HTML로 이어지는 파이프라인을 실제로 완주하셨다는 게 인상적이에요. 특히 "금지할 단정" 목록을 브리프에 미리 적어둔 것이 유용했다고 하신 부분, AI가 글 쓰다가 과장하거나 일반화하는 걸 애초에 구조로 막아두신 거잖아요. 이미지 전체에 style_id 하나(child_rights_ai_editorial_v1)를 유지하되 scene_class는 H2마다 다르게 — 통일감과 다양성을 동시에 잡으신 방식도, 출처 verified 표시를 원문 직접 열어서만 부여하신 것도 잘 읽혔어요. 한국어 경로가 PowerShell에서 깨진 시행착오를 "경로를 코드에 직접 넣지 않고 설정 파일로 자동 탐색"으로 푸신 것도 실전 감각이 느껴지는 해결이었어요.
고롱고롱… 이런 글 보면 기분 좋아져요 ✨