


📝 한줄 요약
처음 요청은 “가계부 작성할 때 참고할 수 있도록 네이버쇼핑 목록을 만들고, 한 달에 한 번 자동으로 가져와 저장하면 좋겠다”였다. 이 요청을 사용자가 직접 로그인한 전용 브라우저에서 네이버쇼핑 주문내역을 월 1회 수집하고, 원본 화면을 보존한 뒤, 날짜·상품·금액·상태를 CSV와 Markdown으로 정리하며, 같은 주문을 다시 수집해도 중복으로 세지 않는 보조자료 수집기로 바꾸었다.
바쁘시면 이것만 읽어도 됩니다.
목표는 네이버쇼핑 주문을 후잉에 자동 입력하는 것이 아니라, 후잉 거래를 확인할 수 있는 보조자료를 자동으로 축적하는 것이었다.
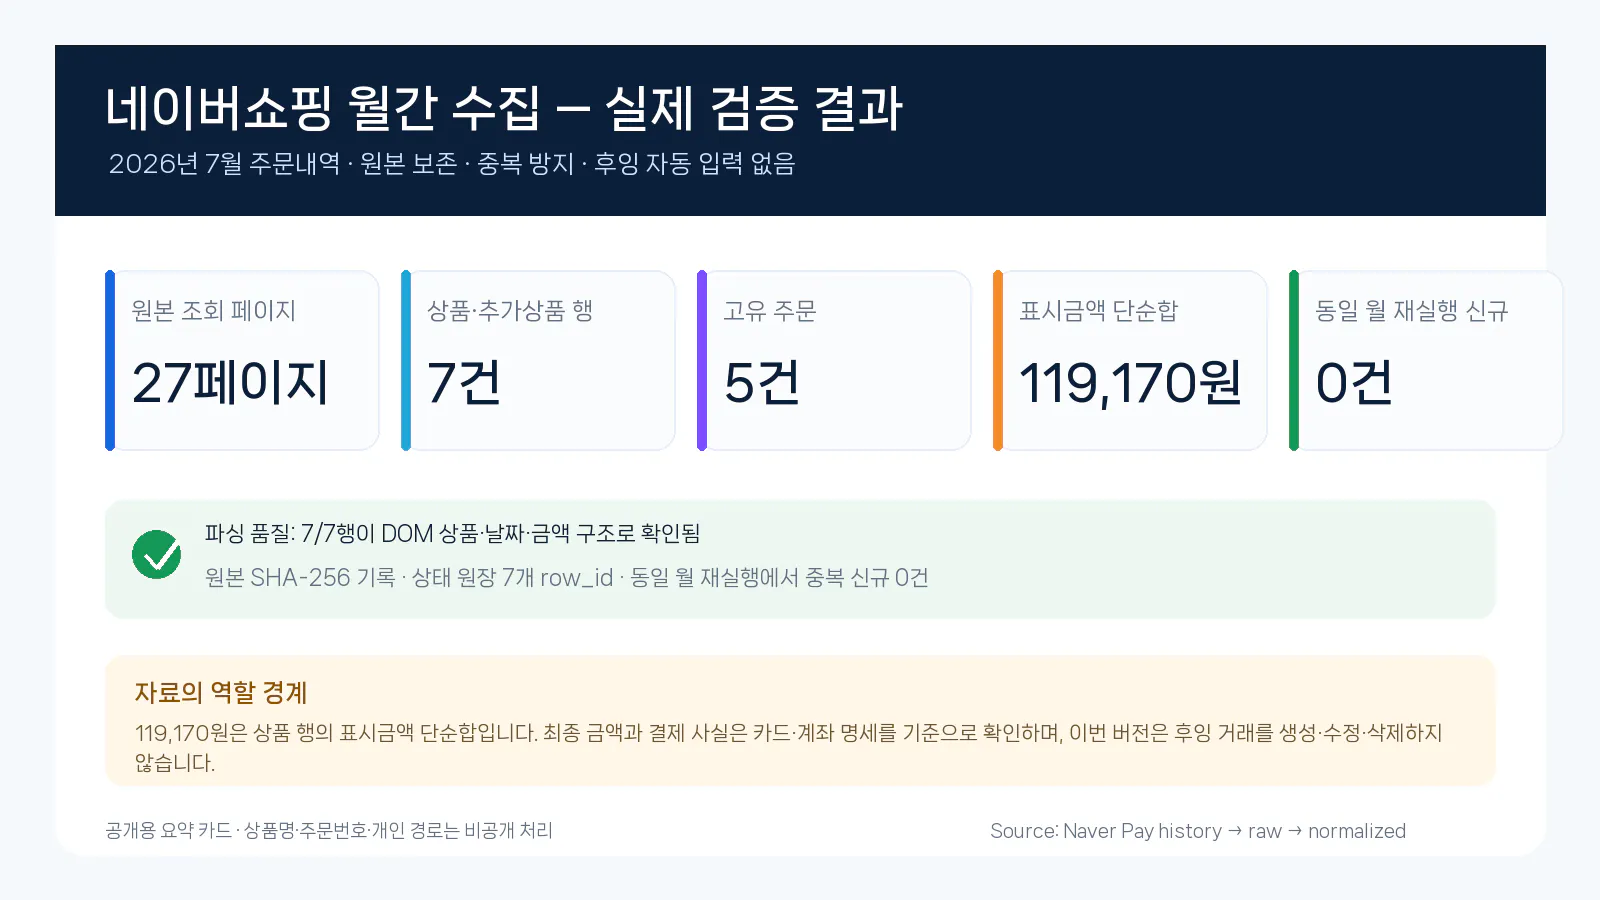
네이버쇼핑 주문내역은 한 페이지에 끝나지 않았다. 실제 2026년 7월 자료는 27페이지에 걸쳐 있었다.
수집기는 사용자가 전용 Chrome 창에서 직접 로그인하고, 비밀번호·QR·패스키·OTP를 읽거나 저장하지 않는다.
원본 HTML·텍스트·리소스 목록을 먼저 보존하고, 그다음 정규화된 CSV와 Markdown을 만든다.
실제 수집 결과는 상품·추가상품 행 7건, 고유 주문 5건, 표시금액 단순합 119,170원이었다.
같은 월을 다시 실행했을 때 같은 7건이 다시 읽혔지만, 신규 행은 0건으로 판정되었다.
금액의 최종 근거는 네이버쇼핑 주문내역이 아니라 카드·계좌 명세로 남겼다.
자동화의 핵심은 “가져오는 기능”보다 원본 보존, 중복 방지, 로그인 경계, 장부 쓰기 금지를 함께 설계한 데 있었다.
Google Analytics 대시보드의 한국어 버전
위 이미지는 실제 수집 파일에서 확인한 수치만 사용해 공개용으로 재구성한 요약 카드다. 상품명·주문번호·개인 경로는 공개하지 않았다.
🎯 이런 분들께 도움됩니다
쇼핑몰 주문내역을 가계부나 회계자료의 보조자료로 남기고 싶은 사람
카드 명세만으로는 상품명이 명확하지 않아 나중에 지출 용도를 확인하기 어려운 사람
같은 자료를 매달 반복해서 다운로드·정리하는 일을 줄이고 싶은 사람
AI에게 자동화를 맡기되, 결과를 나중에 다시 검증할 수 있게 만들고 싶은 사람
금융 원장과 쇼핑·영수증·문자 자료를 섞어 기록하다가 중복 입력이 생기는 것을 막고 싶은 사람
😫 문제 상황 — 주문내역을 한 번 보는 것과 매달 쓸 수 있게 저장하는 것은 달랐다
네이버쇼핑 주문내역은 필요한 정보가 이미 화면에 있다.
주문일
상품명
결제 또는 표시 금액
주문 상태
주문번호
하지만 가계부를 작성할 때마다 이 화면을 다시 열어 찾는 과정은 반복된다. 더구나 주문내역이 여러 페이지로 나뉘어 있으면 첫 화면만 보고 “이번 달 자료가 끝났다”고 판단하기 쉽다.
여기서 더 중요한 문제가 있었다. 네이버쇼핑 주문내역의 금액을 그대로 장부에 입력하면 다음과 같은 중복이 생길 수 있다.
카드 명세의 결제 1건
+ 네이버쇼핑 주문내역 1건
+ 결제 문자 1건
+ 후잉 거래 1건
= 실제 지출 1건을 여러 번 기록할 위험
따라서 이번 작업의 목표를 처음부터 다음처럼 다시 정의했다.
네이버쇼핑은 “돈이 움직였다는 사실”을 확정하는 원장이 아니라, 카드·계좌 거래의 상품명과 용도를 보강하는 자료다.
🔄 목표를 다시 정의했다 — “후잉 자동 입력”이 아니라 “검증 가능한 보조자료 축적”
이 작업에서 가장 중요한 결정은 후잉에 자동으로 거래를 쓰지 않는 것이었다.
자료
맡은 역할
최종 판단
카드·계좌 명세
실제 돈의 이동
금액과 결제 사실의 기준
네이버쇼핑 주문내역
상품명·주문일·주문상태 보강
거래 용도 확인용
문자·카카오톡·영수증
결제 알림·상세 맥락 보강
보조 증거
후잉
최종 개인 장부
사람의 확인 후 기록
네이버쇼핑에는 취소·환불·배송비·할인·포인트·주문 묶음과 같은 요소가 섞일 수 있다. 그러므로 주문내역의 표시 금액을 바로 비용 거래로 확정하지 않고, 카드·계좌 명세와 대조할 수 있는 형태로만 저장했다.
이렇게 하면 자동화가 실패해도 장부를 훼손하지 않는다. 수집 결과가 이상하면 원본과 정규화 결과를 다시 확인하고, 문제가 없을 때만 사람이 후잉 입력 여부를 판단할 수 있다.
🧭 전체 흐름
사용자 직접 로그인
        ↓
전용 Chrome 프로필 재사용
        ↓
네이버쇼핑 주문내역 페이지 순회
        ↓
원본 HTML·텍스트·리소스 목록 보존
        ↓
DOM 기반 상품·날짜·금액·상태 추출
        ↓
텍스트 파서로 보완
        ↓
행별 식별자 생성·중복 제거
        ↓
CSV·Markdown·신규 행 목록 생성
        ↓
다음 실행을 위한 상태 원장 갱신
        ↓
월간 Slack 보고

※ 후잉 거래 생성·수정·삭제는 하지 않음
자동화는 크게 네 층으로 나누었다.
수집층: 로그인된 주문내역 화면을 여러 페이지에서 읽는다.
증거층: 수집 당시의 HTML·텍스트·리소스 URL과 실행 메타데이터를 남긴다.
정규화층: 날짜·상품·금액·상태·주문번호를 한 행의 구조화된 데이터로 만든다.
운영층: 중복을 판별하고, 월 1회 스케줄로 실행하며, 성공·로그인 필요·검토 필요 상태를 구분해 보고한다.
🔐 로그인은 자동화하지 않고, 수집만 자동화했다
네이버 계정 인증은 사용자가 직접 처리하도록 경계를 분리했다.
일반 브라우저 프로필과 분리된 전용 Chrome 프로필을 사용한다.
사용자가 QR·패스키·OTP·비밀번호 입력을 직접 처리한다.
수집기는 비밀번호나 인증번호를 읽지 않는다.
인증정보를 파일이나 메시지에 기록하지 않는다.
전용 창이 열려 있으면 CDP로 연결해 그 세션을 재사용한다.
세션이 만료되면 내용을 추측하지 않고
LOGIN_REQUIRED상태로 보고한다.
이 경계가 중요했다. 자동화의 목적은 계정 보안을 우회하는 것이 아니라, 사용자가 이미 인증한 화면의 반복적인 읽기와 정리를 줄이는 것이기 때문이다.
🧩 페이지 하나만 읽으면 안 되는 이유
처음부터 “이번 달 주문내역을 읽어라”라고만 하면 한 페이지를 읽고 끝낼 가능성이 있다. 실제 수집 결과의 원본 메타데이터에는 다음이 기록되었다.
조회 대상: 2026-07
원본 페이지 수: 27
수집 상태: ok
원본 해시: 기록됨
수집기는 첫 페이지에서 전체 페이지 수를 확인한 뒤, 페이지 1부터 마지막 페이지까지 순회한다. 각 페이지의 HTML·텍스트·리소스 URL을 별도로 저장하고, 페이지별 해시도 기록한다.
이 구조의 장점은 두 가지다.
파서가 상품을 놓쳤을 때 화면을 다시 방문하지 않고 원본을 재검토할 수 있다.
네이버쇼핑 화면 구조가 바뀌어도, 이미 수집한 자료를 이용해 파서를 보강할 수 있다.
🛠️ 상품 추출은 DOM 우선, 텍스트 보완으로 구성했다
네이버쇼핑 화면의 모든 텍스트를 한 줄로 긁어오면 메뉴명·배송 문구·버튼·상품명이 섞인다. 그래서 안정적인 상품 카드의 의미 구조를 먼저 사용했다.
상품 카드
├── 상품명
├── 상품 금액
├── 주문일시
├── 주문 상태
└── 주문 상세 링크의 주문번호
파싱 순서는 다음과 같다.
렌더링된 주문 카드에서 상품명·금액·날짜·주문번호를 찾는다.
대상 월에 속한 날짜만 남긴다.
결제완료·배송완료·구매확정·취소·환불 등 상태를 보존한다.
DOM에서 추출되지 않는 경우 화면 텍스트 기반 파서로 보완한다.
그래도 상품명·금액 구조를 확인할 수 없으면 성공으로 포장하지 않고
REVIEW_REQUIRED로 남긴다.
즉, “행이 생겼다”만 확인한 것이 아니라 어떤 방식으로 추출되었는지도 parse_quality 필드에 남겼다.
🗂️ 원본과 정규화 자료를 분리했다
최종 결과만 저장하면 나중에 파서가 잘못 읽었는지 확인하기 어렵다. 그래서 다음과 같이 역할을 분리했다.
raw/
└── YYYY-MM/<실행시각>/
    ├── page.html
    ├── page_002.html
    ├── page.txt
    ├── page_002.txt
    ├── resource_urls.json
    └── collection.json

normalized/
└── YYYY-MM/
    ├── orders_YYYY-MM_<실행시각>.csv
    ├── new_orders_YYYY-MM_<실행시각>.csv
    └── orders_YYYY-MM_<실행시각>.md

system/
└── state.json
collection.json에는 대상 월, 수집 시각, 마지막 URL, 페이지 수, 원본 파일 경로, 원본 SHA-256, 파서 결과 수가 들어간다.
CSV에는 다음 필드를 둔다.
row_id
order_date
order_month
order_id
merchant
item
money
status
source_url
collected_at
is_new
parse_quality
notes
Markdown은 사람이 읽고 카드·계좌 명세와 대조하기 위한 표다. CSV는 이후 분류·검색·대사에 사용할 구조화된 자료다.
♻️ 같은 달을 다시 읽어도 중복되지 않게 했다
월간 자동화는 재실행될 수 있다. 네트워크 오류로 재시도할 수도 있고, 사용자가 같은 달을 수동으로 다시 확인할 수도 있다.
그래서 각 행에 다음 정보를 조합한 식별자를 만들었다.
주문번호
+ 주문일
+ 상품명
+ 금액
+ 주문상태
이 값을 해시해 row_id를 만들고, 이미 본 row_id를 상태 원장에 저장한다. 실제 DOM 파서에서는 화면 내 상품 카드 위치 같은 보조값도 함께 사용해 같은 주문에 묶인 추가상품 행을 서로 구분한다. 다음 실행에서는 다음 세 가지를 구분한다.
전체 행: 이번 조회에서 화면에 존재한 모든 행
신규 행: 이전 실행에서 본 적이 없는 행
기존 행: 이미 상태 원장에 기록된 행
이 구분 덕분에 “이번 달 자료를 다시 읽었다”와 “새로운 주문이 추가되었다”를 혼동하지 않게 되었다.
📊 실제 데이터로 검증한 결과
2026년 7월을 대상으로 실제 로그인 세션에서 수집한 결과는 다음과 같다.
검증 항목
결과
원본 조회 페이지
27페이지
상품·추가상품 행
7건
고유 주문번호
5건
행별 식별자 중복
없음
파싱 품질
7건 모두 dom_item_date_price
표시금액 단순합
119,170원
두 번째 동일 월 실행
신규 0건
원본 SHA-256
메타데이터에 기록
후잉 거래 자동 입력
하지 않음
여기서 119,170원은 주문 묶음의 상품별 표시금액을 단순히 더한 참고값이다. 할인·배송비·포인트·취소·카드 승인금액을 반영한 회계상 최종 금액이 아니다.
따라서 사례글이나 작업 보고서에서 이 값을 “7월 실제 지출액”이라고 쓰지 않고, 다음처럼 표현했다.
네이버쇼핑 화면에서 읽어낸 상품 행의 표시금액 단순합은 119,170원이었으며, 최종 금액은 카드·계좌 명세와 대조해야 한다.
이 표현의 차이가 자료의 역할을 지키는 안전장치가 된다.
🧪 운영 과정에서 확인한 중요한 경계
1. 실행 성공과 자료 신뢰성은 같은 말이 아니었다
스크립트가 ok를 출력했다고 해서 그 금액이 곧 장부 금액이 되는 것은 아니다.
ok가 의미하는 범위는 다음과 같다.
주문내역 페이지에 접근했다.
대상 월의 페이지를 순회했다.
상품·날짜·금액·상태를 추출했다.
정규화 결과를 저장했다.
중복 상태를 갱신했다.
ok가 의미하지 않는 것은 다음과 같다.
카드 승인금액과 일치한다.
취소·환불이 최종 반영되었다.
회계 계정이 자동으로 결정되었다.
후잉에 입력해도 중복이 없다.
그래서 수집 성공과 회계 확정을 분리했다.
2. 로그인 필요 상태를 실패로 숨기지 않았다
월간 작업 당일에 네이버 세션이 만료될 수 있다. 이때 임의의 빈 결과를 성공으로 저장하면 “이번 달 주문이 없었다”고 오해할 수 있다.
따라서 로그인 화면이 확인되면 다음 상태를 남긴다.
NAVER_SHOPPING_LOGIN_REQUIRED
화면에는 들어갔지만 상품·날짜·금액 구조를 파싱하지 못하면 다음 상태다.
NAVER_SHOPPING_REVIEW_REQUIRED
자동화에서 중요한 것은 모든 실행을 성공처럼 보이게 만드는 것이 아니라, 어디까지 확인되었는지 상태를 구분하는 것이었다.
3. 후잉 쓰기를 일부러 제외했다
네이버쇼핑 자료를 후잉에 바로 넣으면 편해 보인다. 하지만 지금 단계에서는 다음 위험이 더 컸다.
카드 명세와 주문내역을 이중으로 입력할 가능성
주문 묶음과 상품 행의 금액을 중복 합산할 가능성
주문 취소·환불 상태를 비용으로 남길 가능성
생활용품·식품·업무용품 등의 계정 분류를 잘못할 가능성
그래서 이번 버전은 수집·정리·대조 준비까지만 자동화하고, 후잉 입력·수정·삭제는 하지 않는다.
⏰ 매월 자동 실행으로 연결했다
수동 검증이 끝난 뒤, 월간 스케줄에 연결했다.
실행 주기: 매월 1일 오전 9시(KST)
수집 대상: 실행일의 전월
출력: 원본 보관 + CSV + Markdown + 신규 행 목록
보고: 실행 상태와 결과를 Slack으로 전달
예를 들어 9월 1일 실행이면 8월 주문내역을 수집한다. 첫 실행 때 모든 행을 신규로 보고하고, 이후 같은 주문이 다시 읽히면 전체 결과에는 남기되 신규에서는 제외한다.
자동 실행의 성공 기준도 단순히 프로세스 종료 코드로 정하지 않았다.
페이지 수 확인
→ 대상 월 확인
→ 행 수 확인
→ 고유 row_id 확인
→ 신규 행 수 확인
→ 원본 매니페스트와 상태 원장 연결 확인
→ 보고 전달 상태 확인
✅ Before vs After
구분
Before
After
자료 확인
필요할 때마다 주문내역을 다시 찾음
월 1회 전월 자료 자동 저장
페이지 처리
첫 화면만 보고 끝날 위험
전체 페이지 수를 확인하고 순회
보존
화면을 다시 열어야 함
HTML·텍스트·리소스·메타데이터 보존
정리
사람이 상품명·금액을 옮김
CSV·Markdown 자동 생성
재실행
같은 주문을 다시 세기 쉬움
row_id·상태 원장으로 신규/기존 구분
장부 입력
쇼핑 자료를 바로 장부로 옮길 유혹
카드·계좌 명세 확인 후 사람 승인
로그인
자동화가 인증까지 떠안음
사용자가 직접 인증, 수집기는 세션만 사용
장애 보고
빈 결과와 로그인 만료를 구분하기 어려움
OK·LOGIN_REQUIRED·REVIEW_REQUIRED 분리
⚠️ 한계와 아직 남은 것
이번 작업은 네이버쇼핑 주문내역을 안정적으로 보조자료화한 사례이지, 완전한 회계 자동화나 모든 쇼핑몰 통합 시스템은 아니다.
네이버쇼핑 화면 구조가 바뀌면 DOM 파서를 보강해야 한다.
네이버 로그인 세션이 만료되면 사용자가 다시 인증해야 한다.
현재 수집 결과는 상품명·날짜·표시금액·상태 중심이며, 최종 카드 승인금액을 자동 확정하지 않는다.
판매처가 비어 있거나 상품명 추출이 불완전한 행은 별도 검토가 필요하다.
주문내역만으로는 할인·포인트·배송비·부분취소의 회계상 의미를 완전히 판단할 수 없다.
현재 버전은 후잉 거래를 자동 생성·수정·삭제하지 않는다.
row_id는 동일 행의 재수집을 막는 장치이지, 의미가 같은 다른 주문을 모두 자동으로 합치는 장치는 아니다.개인정보가 포함될 수 있는 원본 화면과 주문번호는 공개 사례글에 그대로 삽입하지 않는다.
다음 단계로 확장한다면 다음 순서가 안전하다.
카드·계좌 명세와 주문내역의 후보 매칭표 만들기
취소·환불·부분취소 상태를 별도 검토 큐로 분리하기
판매처와 상품 분류를 보강하기
사람이 승인한 행만 후잉 입력 후보로 내보내기
후잉 쓰기가 필요해질 때 별도의 미리보기·승인·read-back 절차를 추가하기
🔍 검증 기록과 근거 범위
이 글은 다음 실제 기록을 서로 대조해 작성했다.
최초 요구사항: 네이버쇼핑 목록을 가계부 참고자료로 만들고 월 1회 저장
수집기 README: 원본·정규화·상태 원장 구조와 월간 실행 규칙
실제 수집 매니페스트: 2026-07 대상, 상태
ok, 27페이지, 원본 SHA-256 기록실제 정규화 CSV·Markdown: 7행, 고유 주문 5건, 표시금액 단순합 119,170원
동일 월 재실행 결과: 같은 7행, 신규 0건
상태 원장: 확인된 row_id 7개와 마지막 성공 실행 연결
Cron read-back: 매월 1일 09:00(KST), 활성 상태, 마지막 실행
ok, 전달 오류 없음수집기 코드: 전용 Chrome 프로필, 사용자 인증 경계, DOM 우선 추출, 상태 구분, 후잉 미접속 설계
공개본에서는 다음을 제외했다.
계정 식별정보
주문번호
상품명 전체
개인 컴퓨터의 절대경로
인증정보와 브라우저 프로필 내부 자료
원본 HTML·텍스트와 정규화 CSV·Markdown은 공개본과 분리해 내부 증거 영역에 보존했다. 이 글에 삽입한 검증 카드는 실제 수치만 사용한 공개용 요약 이미지다.
💡 이번 사례에서 배운 것
이번 작업을 통해 알게 된 것은 쇼핑몰 자동화의 핵심이 “스크래핑을 성공시키는 것”만은 아니라는 점이다.
첫째, 자료의 역할을 먼저 정해야 한다. 네이버쇼핑 주문내역은 카드·계좌 원장을 대신하지 않는다. 상품명과 주문 맥락을 보강하는 자료로 규정했기 때문에 후잉 중복 입력을 피할 수 있었다.
둘째, 원본을 남겨야 한다. CSV만 남기면 파서가 잘못 읽었을 때 원인을 찾기 어렵다. HTML·텍스트·리소스·해시를 함께 보존하면 나중에 결과를 다시 설명할 수 있다.
셋째, 재실행을 정상적인 상황으로 봐야 한다. 월간 자동화는 언젠가 다시 실행된다. 중복은 예외가 아니라 기본 시나리오이므로 처음부터 row_id와 상태 원장을 두어야 한다.
넷째, 실행 상태와 회계 확정을 분리해야 한다. ok는 수집기가 할 일을 끝냈다는 뜻이지, 사람이 장부에 입력해도 된다는 뜻이 아니다.
다섯째, 자동화하지 않는 것도 설계다. 후잉 거래 입력을 제외한 것은 기능이 부족해서가 아니라, 현재 단계에서 원장 훼손과 이중계상 위험을 줄이기 위한 의도적인 경계였다.
마무리
처음 요청은 네이버쇼핑 목록을 한 달에 한 번 저장해 달라는 짧은 말이었다. 하지만 실제로 반복 사용할 수 있는 자동화를 만들려면 다음 질문에 답해야 했다.
어디에서 읽을 것인가?
인증은 누가 할 것인가?
몇 페이지까지 읽어야 하는가?
원본을 어떻게 보존할 것인가?
같은 주문을 어떻게 다시 구분할 것인가?
무엇을 성공이라고 부를 것인가?
어떤 자료를 장부의 최종 근거로 볼 것인가?
이번 사례에서 가장 중요한 변화는 네이버쇼핑 주문내역을 자동으로 가져온 것이 아니다.
쇼핑 자료를 장부로 착각하지 않고, 원본 증거·정규화 결과·중복 상태·사람의 승인 지점을 분리한 것이다.
이제 매달 주문내역을 다시 찾는 일은 줄어들었다. 대신 카드·계좌 명세와 대조할 수 있는 자료가 같은 구조로 쌓인다. 자동화가 장부를 대신 쓰는 것이 아니라, 사람이 더 정확하게 장부를 검토할 수 있도록 다음 좌표를 준비해 주는 방식이다.
