한 번 응답했다고 24시간 서버는 아니었다: 세 시점으로 Hermes 안정성 확인
2026.08.11
📝 한줄 요약
바쁘시면 이것만 읽어도 돼요:
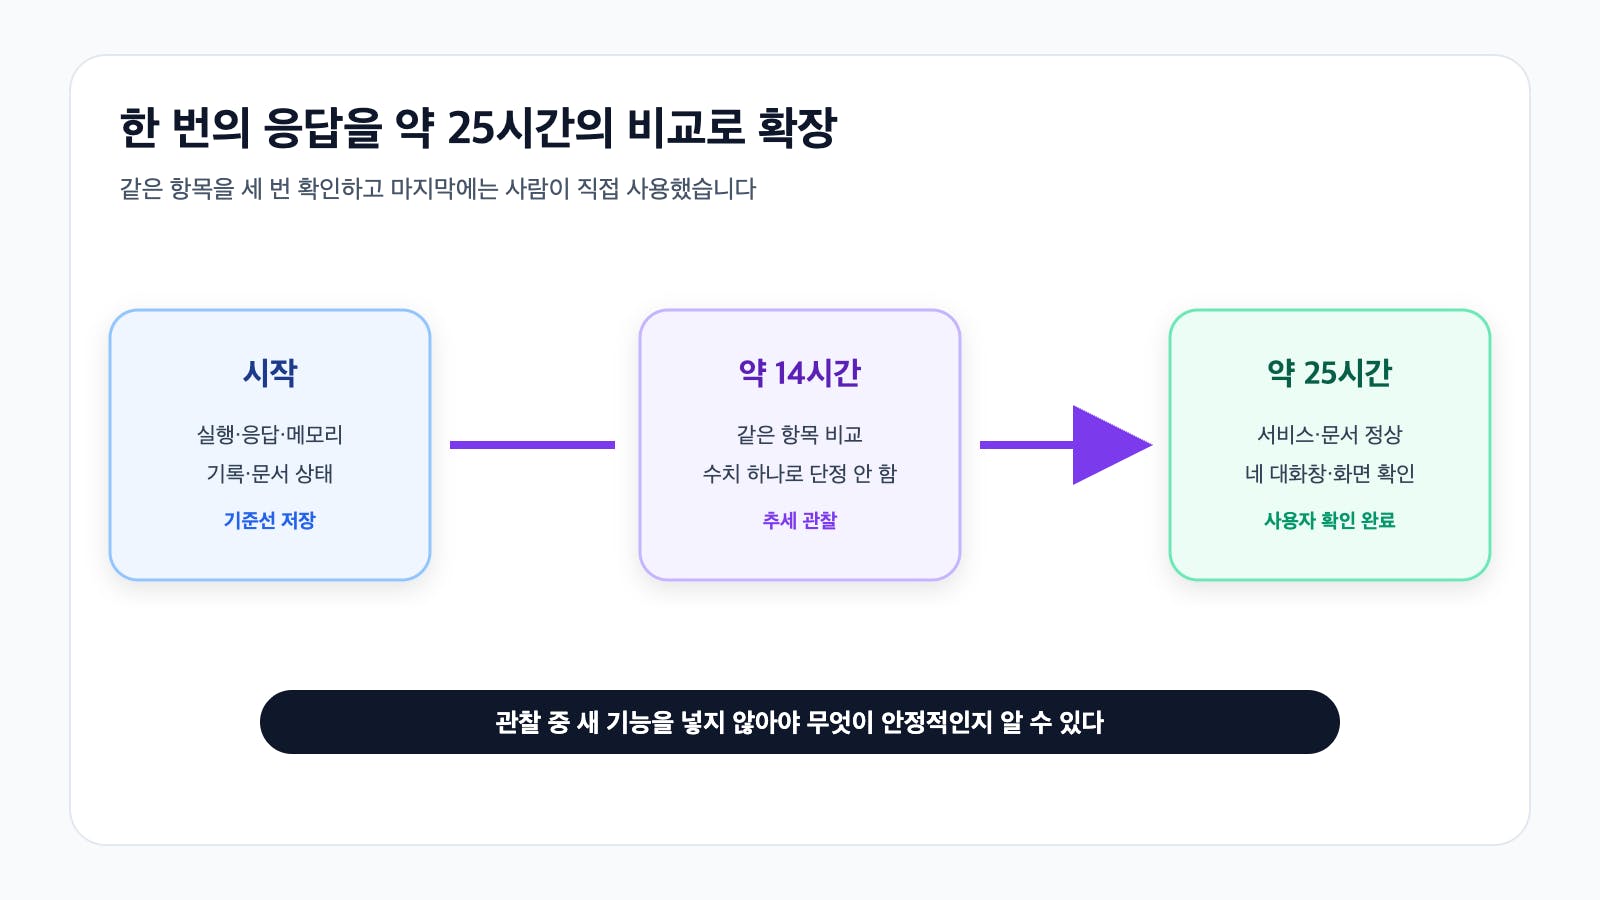
전원 복구 직후, 약 14시간 뒤, 약 25시간 뒤에 같은 항목을 반복 측정했습니다.
Hermes Gateway와 화면 서비스는 같은 프로세스로 유지됐고 재시작 횟수도 늘지 않았습니다.
메모리, 로그 크기, 오류 표시, 비밀정보 표시를 같은 기준으로 비교했습니다.
OrbStack 보조 프로세스의 메모리가 한때 약 100MiB 늘었지만 다음 측정에서 내려가 재시작이나 누수로 단정하지 않았습니다.
MainVault 내용 지문, Syncthing, 문서 Validator가 세 시점 모두 같은 상태였습니다.
마지막에는 Hermes Mini와 세 메신저, 화면 공유를 사용자가 직접 시험했습니다.
한 번의 성공 화면이 아니라 시간에 따른 변화와 사용자 기능을 함께 봐야 장기 운영 상태를 판단할 수 있습니다.
🎯 이런 분들께 도움돼요
AI 서버를 24시간 켜두기 전에 짧은 안정성 시험을 하고 싶은 분
메모리 증가나 로그 변화를 과장 없이 판단하고 싶은 분
서비스 상태와 실제 사용자 경험을 함께 확인하려는 분
자동화 도구가 시험 중 몰래 늘어나지 않았는지 점검하고 싶은 분
😫 문제 상황 (Before)
재부팅과 전원 복구 직후 Hermes가 응답했다고 해서 하루 동안 안정적으로 유지된다는 뜻은 아닙니다. 시간이 지나면서 프로세스가 반복 재시작되거나 메모리가 계속 늘고, 로그에 오류나 비밀정보가 쌓일 수 있습니다.
반대로 한 번의 수치 증가만 보고 메모리 누수라고 단정하는 것도 위험합니다. 비교 시점과 측정 항목이 매번 다르면 변화의 의미를 판단할 수 없습니다. 그래서 처음 상태를 T0로 잡고 뒤의 두 시점에도 같은 읽기 전용 검사를 반복했습니다.
🛠️ 사용한 도구
도구 | 역할 |
|---|---|
프로세스·서비스 상태 | PID와 실행 횟수, HTTP 응답 확인 |
메모리·디스크 지표 | 자원 사용 변화 관찰 |
로그 패턴 검사 | 오류·비밀정보로 보이는 표시 수 비교 |
Syncthing·콘텐츠 해시 | MainVault 동기화와 내용 불변 확인 |
문서 Validator | 실제 Vault 규칙 통과 여부 확인 |
Codex | 세 시점의 동일한 측정표와 판정 기준 유지 |
이런 시간 경과 시험을 흔히 soak test라고 합니다. 일정 시간 서비스를 켜둔 채 같은 지표를 반복 관찰해 느리게 생기는 문제를 찾는 방법입니다.
🔧 작업 과정
1. T0에서 바뀌면 안 되는 것까지 기록했다
전원 복구 직후를 T0로 정하고 Gateway와 화면 서비스의 PID, 실행 횟수, HTTP 상태, 원격 연결 포트, 메모리, 로그 크기를 기록했습니다. Syncthing의 미동기화·오류 수, MainVault의 논리적 내용 해시, Validator 결과, Git 상태도 함께 확인했습니다.
새 운영 스킬, 프로필, 도구, 외부 연결, 예약 작업, 컨테이너, 자동 발송이 0개인지도 기록했습니다. 안정성 시험이 기능 추가 작업으로 변하지 않도록 범위를 고정한 것입니다.
Hermes 서버의 T0, 중간 시점, 24시간 이후 시점에 같은 읽기 전용 측정을 수행한다.
서비스 PID와 실행 횟수, HTTP 상태, 메모리, 디스크, 로그 크기,
오류·비밀정보 표시, Syncthing, MainVault 내용 해시, Validator 결과를 비교한다.
한 번의 수치 변화는 원인으로 단정하지 말고 재시작·오류·지속 증가 여부와 함께 판정한다.
2. 약 14시간 뒤 같은 표로 다시 측정했다
중간 점검은 계획보다 늦은 약 14시간에 수행했고 실제 시각을 그대로 기록했습니다. Gateway와 화면 서비스의 PID와 실행 횟수는 T0와 같았습니다. 전체 디스크 여유는 92%였고 서비스 재시작이나 새 오류는 없었습니다.
OrbStack 보조 프로세스의 메모리는 약 100MiB 늘었습니다. 그러나 다른 서비스의 재시작, 오류 증가, 디스크 압박이 없었기 때문에 즉시 누수라고 부르지 않고 “다음 시점에서 다시 확인할 변화”로 남겼습니다.
오래 실행된 Hermes 하위 프로세스도 발견됐지만, 조사 결과 화면 세션을 처리하는 정상 작업자였습니다. 실행 시간이 길다는 이유만으로 종료하지 않았습니다.
3. 약 25시간 뒤 변화의 방향을 확인했다
마지막 측정에서도 같은 PID와 실행 횟수 1이 유지됐습니다. 중간에 늘었던 OrbStack 보조 프로세스 메모리는 다시 내려갔고, Gateway와 화면 서비스의 증가는 작았습니다.
측정 항목 | T0 | 약 14시간 | 약 25시간 |
|---|---|---|---|
디스크 여유 | 92% | 92% | 91% |
Gateway 메모리 | 213 MiB | 216 MiB | 219 MiB |
화면 서비스 메모리 | 268 MiB | 277 MiB | 271 MiB |
OrbStack 보조 프로세스 | 634 MiB | 737 MiB | 592 MiB |
화면 로그 크기 | 9,039 B | 9,258 B | 9,258 B |
오류 표시 수 | 2 | 2 | 2 |
비밀정보 표시 수 | 0 | 0 | 0 |
오류 표시 2개는 새로 늘어난 오류가 아니라 시작부터 같은 기존 항목이었습니다. 비밀정보로 보이는 로그 표시는 세 시점 모두 0이었습니다.
4. 숫자 뒤에 실제 사용자 시험을 붙였다
Syncthing의 미동기화와 오류 수는 모두 0이었고 MainVault의 내용 해시도 변하지 않았습니다. Validator는 3개 테스트 29개 확인 항목과 실제 문서 4개·템플릿 4개를 계속 통과했습니다.
마지막으로 사용자가 Hermes Mini, Telegram, Discord, Slack에서 각각 질문하고 화면 공유로 접속했습니다. 모든 접속 경로가 실제로 응답했습니다. 이로써 시스템 지표와 사용자 경험을 함께 확인했습니다.
✅ 결과 (After)
Before vs After
항목 | Before | After |
|---|---|---|
안정성 근거 | 복구 직후 한 번의 성공 | 약 25시간 세 시점 비교 |
재시작 여부 | 장시간 상태 미확인 | 동일 PID·실행 횟수 1 유지 |
메모리 판단 | 증가 시 원인 불명 | 변화 방향과 다른 지표 함께 비교 |
문서 상태 | 서비스와 별도 확인 | 동기화·해시·Validator 동시 확인 |
사용자 기능 | 프로세스 중심 | 화면과 네 채널 직접 질문 |
결과물
T0·약 14시간·약 25시간의 동일 측정표
Hermes Gateway와 화면 서비스 무재시작 기록
메모리·로그·오류·비밀정보 표시 비교 결과
MainVault 내용 불변과 문서 규칙 통과 기록
화면과 네 개의 Hermes 접속 경로 사용자 시험 결과
이번 결과는 기반 서비스의 약 25시간 안정성 확인입니다. 더 긴 기간의 장애 대응 시간이나 정기 백업 자동화까지 검증한 것은 아닙니다. 이 안정성 점검 뒤에 첫 운영 공지의 미발송 초안 흐름을 별도로 검증했지만, 두 작업의 목표가 달라 이 글에는 섞지 않았습니다.
💬 이 과정에서 배운 AI 활용 팁
효과적이었던 것
AI가 매번 새 항목을 제안하지 못하도록 처음 측정표를 고정했습니다.
수치 하나가 아니라 PID, 재시작, 오류, 다음 시점의 방향을 함께 보게 했습니다.
마지막에 실제 사용자 질문을 붙여 “지표는 정상인데 사용은 불가”인 상황을 막았습니다.
이렇게 하면 안 돼요
측정 시간이 계획보다 늦었다면 시간을 맞춰 쓰지 말고 실제 시각을 기록해야 합니다.
메모리 한 번 증가만으로 누수를 확정하면 정상 캐시나 일시 작업을 오판할 수 있습니다.
상태 확인 과정에서 프로세스를 재시작하면 장시간 유지 검증의 증거가 사라집니다.
🌍 다른 업무에 적용한다면?
웹 서비스, 사내 봇, 데이터 수집기, 홈 서버도 시작 직후·중간·종료 시점에 같은 지표를 비교하면 짧은 안정성 시험을 만들 수 있습니다. 자원 수치뿐 아니라 핵심 사용자 행동 한두 개를 반드시 포함하는 것이 좋습니다.
🚀 앞으로의 계획
더 긴 기간 동안 같은 측정표를 유지해 추세 확인
백업 실패와 오래된 백업을 알려주는 운영 알림 별도 설계
사용자 공지와 장애 기록 양식을 실제 운영 경험에 맞춰 확정
📋 재사용 가능한 프롬프트
프롬프트 1: 24시간 서비스 안정성 점검
[서비스]를 T0, 중간 시점, 24시간 이후에 같은 읽기 전용 항목으로 측정해줘. PID·실행 횟수·응답 상태·메모리·디스크·로그 크기·오류·비밀정보 표시와 핵심 데이터의 내용 지문을 비교해줘. 한 번의 증가를 원인으로 확정하지 말고 재시작, 오류 증가, 다음 시점의 방향을 함께 설명해줘. 마지막에는 사용자가 실제로 수행하는 핵심 행동을 시험하고 아직 검증하지 않은 운영 항목을 분리해줘.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



634→737→592 MiB처럼 오르내린 수치를 보고도 곧바로 누수라고 부르지 않은 장면이 가장 설득력 있었어요. 같은 PID와 실행 횟수 1, 오류 표시 2건 유지, 비밀정보 표시 0을 함께 놓으니 '늘었다'보다 '계속 늘어나는가'를 보는 판정이 실제 표로 드러났습니다.
T0·약 14시간·약 25시간에 측정 항목을 바꾸지 않았고, 마지막에는 Hermes Mini와 Telegram·Discord·Slack·화면 공유를 사람이 직접 확인했죠. 서비스가 살아 있는지와 사용자가 실제로 쓸 수 있는지를 한 판정 안에 둔 덕분에, 이 표를 웹 서비스나 사내 봇의 짧은 soak test에도 옮겨 볼 수 있겠어요.
더 긴 시험의 다음 최소 장면은 시간을 무작정 늘리는 것보다, 각 측정 직전에 같은 사용자 동작 묶음을 넣고 부하 직후와 회복 뒤 수치를 함께 적는 방식으로 보입니다. 그러면 유휴 상태의 완만한 변화와 실제 작업 뒤 남는 변화를 구분할 수 있어요.
한 번 튄 수치를 과장하지 않고 다음 시점까지 기다린 절제가 정말 믿음직했습니다. 정상처럼 보이는 숫자에 만족하지 않고 실제 사용자 기능까지 확인한 기록이 이 안정성 판단을 단단하게 만들었어요.