


소개
시도하고자 했던 것과 그 이유
"가성비 실무자를 위한 Hermes Agent로 비용 걱정 없는 AI 에이전트 구축하기" 수업 OT를 듣고, 유료 API 없이 무료 로컬 모델을 Hermes에 연결하는 것을 직접 시도해봤습니다.
이유는 두 가지였습니다.
첫째, AI 도구 API 비용이 꽤 부담되는데, 로컬 모델을 쓰면 비용 없이 쓸 수 있다는 점이 매력적이었습니다.
둘째, 수업에서 배운 내용을 직접 손으로 해봐야 진짜로 이해할 수 있을 것 같았습니다. 그런데 막상 해보니 계속 에러가 났고, 그 에러를 파고드는 과정에서 생각보다 훨씬 많은 것을 배웠습니다.
진행 방법
사용 도구
Claude Code (메인 — 에러 분석 및 설정 수정)
LM Studio (로컬 모델 실행 환경)
Hermes Agent (AI 에이전트 프레임워크)
모델: google/gemma-4-e4b
하드웨어: M5 Air (Apple Silicon, 16GB)
1단계 — 에러 발생
LM Studio에 gemma-4-e4b 모델을 받아서 Hermes와 연결했는데 바로 에러가 났습니다.
ACP error -32603: Internal error
에러 메시지가 이게 전부라 뭐가 문제인지 알 수 없었습니다. Claude Code에게 상황을 설명했습니다.
사용한 프롬프트:
Error: Error: ACP error -32603: Internal error
hermes에 lmstudio 통해서 gemma-4-e4b 연결했는데 이 에러는 뭐지?
Claude Code가 Hermes 로그 파일들을 직접 뒤지더니 LM Studio 서버 로그에서 진짜 원인을 찾아냈습니다. gemma 모델이 메모리를 9.37GB나 요구하는데 다른 앱들이 이미 메모리를 점유하고 있어 로드 자체가 실패한 것이었습니다.
2단계 — 모델을 바꿔도 같은 에러 (가장 당황스러운 순간)
더 가벼운 qwen2.5-coder-7b 모델로 바꿨습니다. LM Studio에서 직접 테스트해보니 정상 응답도 했습니다. "이제 되겠다" 싶었는데 — 똑같은 에러.
사용한 프롬프트:
Error: Error: ACP error -32603: Internal error
계속 이건데?
Claude Code가 이번엔 Hermes 소스코드 자체를 분석했고, 결국 핵심 원인을 찾아냈습니다.
Hermes Agent는 설계상 최소 64,000 토큰 컨텍스트를 가진 모델만 받아들입니다. qwen의 최대 컨텍스트는 32,768 토큰으로 이 기준의 절반밖에 안 됩니다. 모델이 멀쩡히 작동해도 Hermes가 내부적으로 차단하는 구조였던 것입니다.
"기본 설정"이 사실은 이런 내부 기준이었다는 걸, 소스코드를 뜯어보고 나서야 알게 됐습니다.

흰색 텍스트가 있는 검은색 화면
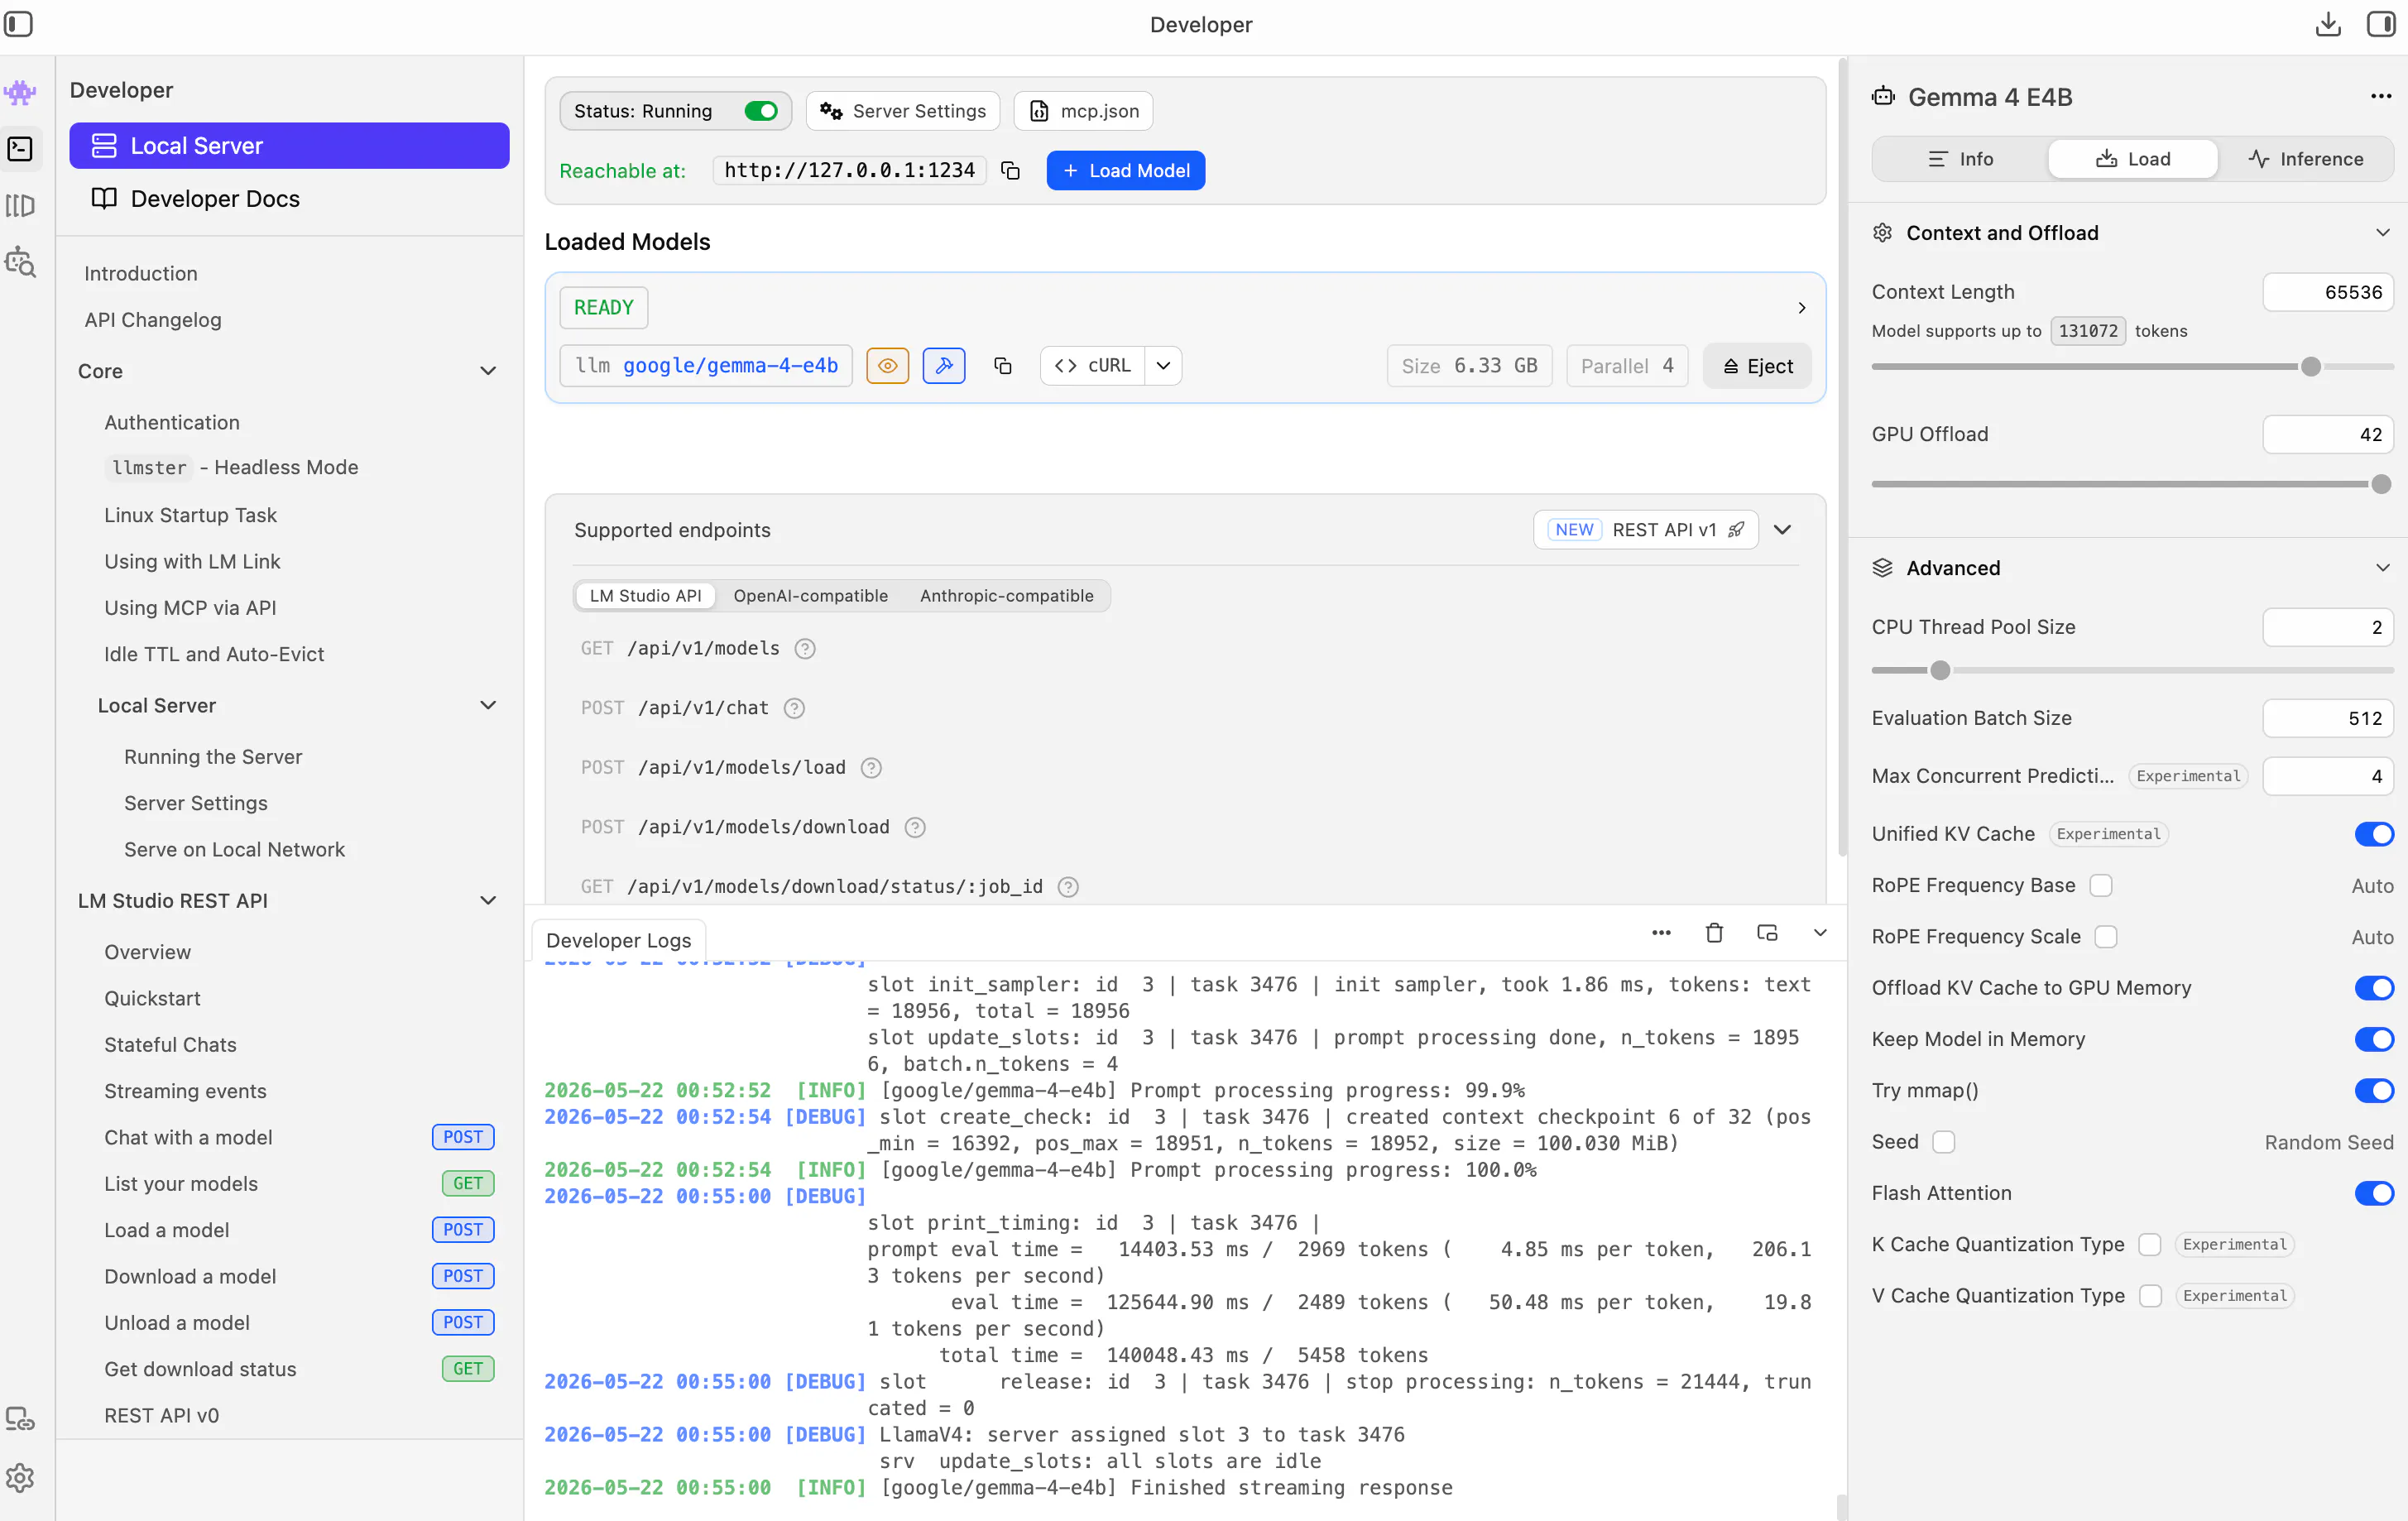
Mac의 sys 설정 스크린샷
3단계 — gemma로 돌아오되, 설정 최적화
gemma는 최대 128K 컨텍스트를 지원하니 Hermes 기준을 통과합니다. 문제는 메모리였는데, 컨텍스트 길이를 기본값의 절반(65,536)으로 설정하면 메모리 사용량을 줄일 수 있었습니다.
사용한 프롬프트:
65536으로 변경 적용해서 이건 잘되는건가? hermes에도 변경해줘
설정 파일을 수정하고 Hermes를 재시작하니 정상 작동했습니다.
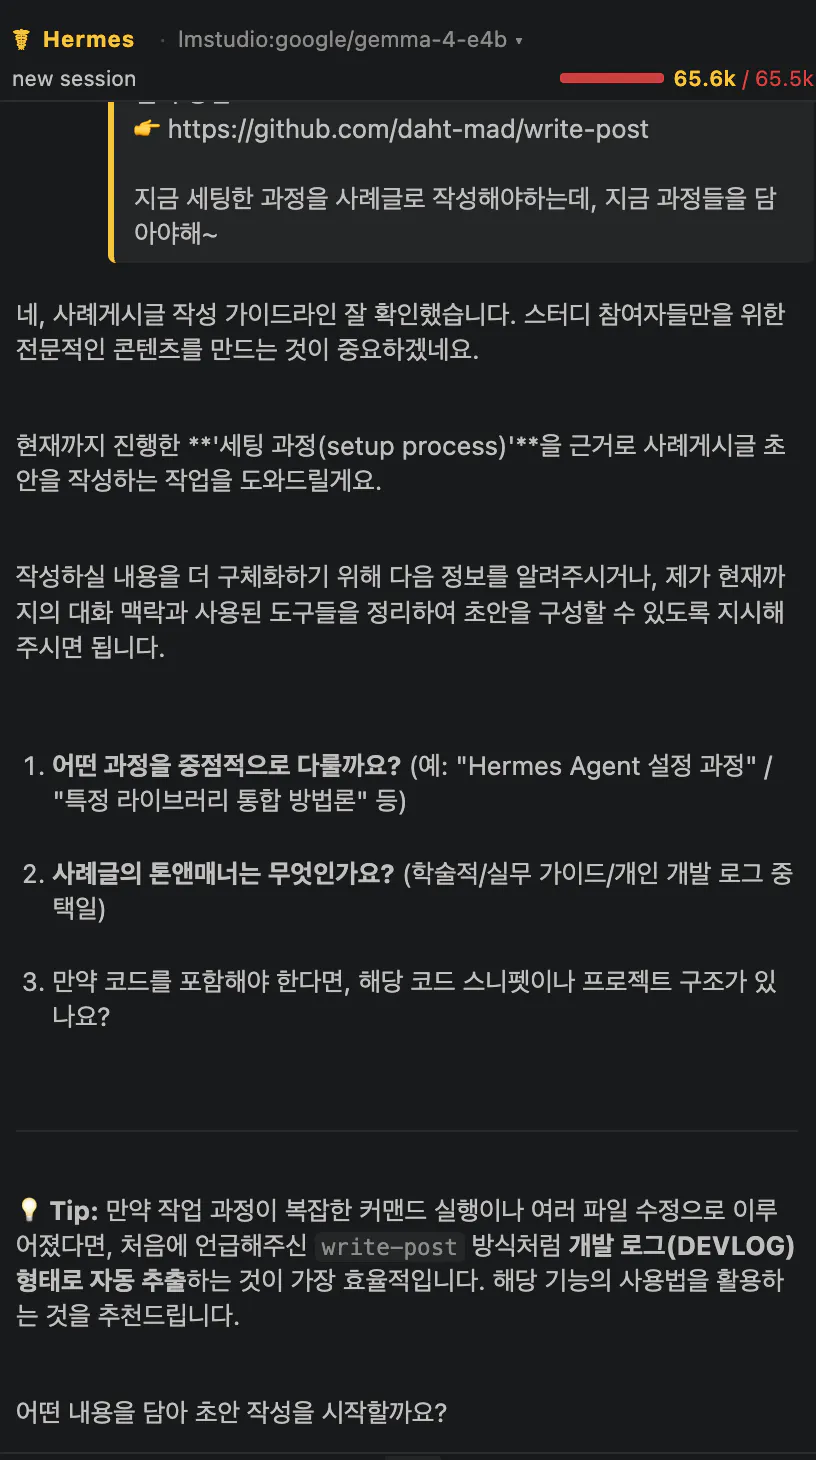
한국어 텍스트가 포함된 검은 화면의 스크린샷
로컬 AI 구조를 처음으로 제대로 이해한 순간
작동은 됐는데 속도가 느렸고, 문득 궁금해졌습니다.
사용한 프롬프트:
이런 무료 모델들은 내 pc를 사용하는건가?
지금 내가 이 구조를 사용하고 있는거야?
Claude Code가 확인해줬습니다. gemma 모델이 현재 제 Mac 메모리 5.3GB를 점유한 채 실행 중이었습니다.
hermes → LM Studio → gemma-4-e4b → 내 Mac (Apple Silicon)
인터넷 없음. 외부 서버 없음. API 비용 없음. 제 Mac이 모델을 통째로 메모리에 올려서 직접 처리하는 구조입니다. 처음에 느린 건 모델을 메모리에 올리는 시간 때문이고, 한 번 올라가면 이후엔 빨라집니다.
수업에서 "로컬 AI"라는 말을 들었을 때와, 실제로 내 메모리 사용량을 눈으로 보면서 이해했을 때는 완전히 달랐습니다.
결과와 배운 점
결과
항목
이전
이후
Hermes 모델
유료 클라우드 API
로컬 gemma (무료)
API 비용
사용량만큼 발생
0원
인터넷 필요 여부
필요
불필요
로컬 AI 이해도
막연하게 알고 있음
구조까지 이해
배운 점과 꿀팁
하나. 에러 메시지가 불친절할수록 로그 파일을 통째로 Claude Code에 보여주세요. "이 에러 뭐야?"보다 훨씬 정확하게 원인을 찾아줍니다.
둘. 로컬 모델 고를 때 두 가지를 동시에 확인해야 합니다. 속도(모델 포맷)와 컨텍스트 길이. 하나만 봤다가 저처럼 두 번 삽질할 수 있습니다.
셋. 잘 모를 땐 Claude Code한테 물어보세요. 소스코드 수준까지 파고드는 건 혼자 하기 어렵습니다.
시행착오
모델을 바꾸면 해결될 거라 생각했는데, 문제는 모델이 아니라 Hermes 자체의 숨겨진 기준이었습니다. 에러 메시지만 보고 판단하면 절대 찾을 수 없는 원인이었습니다.
앞으로의 계획
Gemini 무료 API를 Hermes에 연결해서 로컬 모델과 속도·품질을 비교해볼 예정입니다. 또 회계처럼 외부 유출이 민감한 업무에서 로컬 AI가 실제로 얼마나 쓸 만한 수준인지도 테스트해보고 싶습니다.
