


📝 한 줄 요약 (바쁘면 이것만)
검증 장치를 하나 만들었는데, 그 장치 자신의 게이트가 "쓰지 마라"고 판정했습니다. 그 뒤로 4단계 실험이 연속으로 실패했고, 마지막엔 그 게이트가 제 오진까지 잡아냈습니다. 하루 37커밋, LLM 호출 2,145콜을 태운 기록입니다.(레포: https://github.com/kims6305-bjk/reflection-probe-gate (MIT, README 한/영/중))
🎯 이런 분께 추천해요
AI 답변에 "자기검증(self-correction)" 레이어를 붙일지 고민 중인 분
"검증을 더 넣으면 무조건 더 안전해진다"는 직관을 의심해본 적 있는 분
p값·파레토 같은 통계 용어는 들어봤어도 실무에 어떻게 쓰는지 감이 안 오는 분
RAG 말고 온톨로지/지식그래프를 왜 쓰는지 실물 사례로 보고 싶은 분
📚 시작 전에 — 용어부터 정리하고 갑니다
통계·실험설계 용어가 몇 개 나옵니다. 먼저 다 풀고 시작하겠습니다.
파레토(Pareto) — 이탈리아 경제학자 빌프레도 파레토에서 온 말입니다. 핵심은 "누군가를 손해 보게 하지 않고는 아무도 더 좋아질 수 없는 상태"예요.
피자 8조각을 두 명이 나눈다고 해봅시다. 4:4로 나눴는데 제가 5조각을 먹으려면 상대는 3조각으로 줄어야 합니다. 한쪽을 올리려면 반드시 다른 쪽을 깎아야 하는 상태, 이게 파레토입니다.
파레토 프론티어(Pareto frontier) — "더 이상 공짜 이득이 없는 점들"을 전부 이어놓은 경계선입니다.
프론티어 안쪽에 있으면 = 아직 낭비가 있다. 둘 다 개선할 여지가 있다.
프론티어 위에 있으면 = 한쪽을 얻으려면 다른 쪽을 내줘야 한다.
프론티어 바깥은 = 지금 방법으로는 도달 못 한다.
파레토 최적(Pareto optimal) — 프론티어 위에 올라간 상태입니다. 주의할 게 있는데, 파레토 최적은 "가장 좋은 하나"가 아니에요. 프론티어 위의 모든 점이 다 파레토 최적입니다. 리콜 100%/정밀도 60%인 점과 리콜 80%/정밀도 95%인 점이 둘 다 파레토 최적일 수 있습니다. 어느 쪽을 고를지는 통계가 아니라 도메인이 정합니다.
파레토 지배(dominance) — 후보 B가 기준 A를 지배한다는 건, B가 모든 지표에서 A 이상이고 최소 하나는 초과한다는 뜻입니다. 지배하면 무조건 채택해도 됩니다. 지배하지 못하면 그건 개선이 아니라 교환입니다.
이 글에서 계속 나올 두 표현입니다.
파레토 바깥이동: 프론티어 자체를 밀어냈다 = 진짜 개선
파레토 열등이동: 아무것도 안 좋아지고 뭔가만 나빠졌다 = 순손실
제가 생각하는 "파레토 엔지니어링" — 여기가 이 글의 핵심 관점입니다.
하네스(harness)는 AI를 감싸서 검사·게이트·재시도를 붙이는 장치입니다. 메타하네스는 그 하네스 자체를 자동으로 진화시키는 루프고요.
지금 공개된 메타하네스 구현들은 목적함수가 단일 스칼라입니다. "정답률" 하나만 올리면 이긴 걸로 칩니다. 그런데 그러면 토큰·지연·비용을 무한정 태워서 정답률을 올리는 변이가 항상 이깁니다. 나머지 축의 악화는 아예 측정되지 않아요.
하네스를 조이면 좋아진다는 직관은 프론티어 안쪽에서만 참입니다. 프론티어 위에서는 조이는 만큼 다른 축이 깎입니다. 그래서 목적은 스칼라가 아니라 벡터(성능, 비용)여야 하고, 채택 조건은 "점수가 올랐다"가 아니라 "파레토 지배했다"여야 합니다.
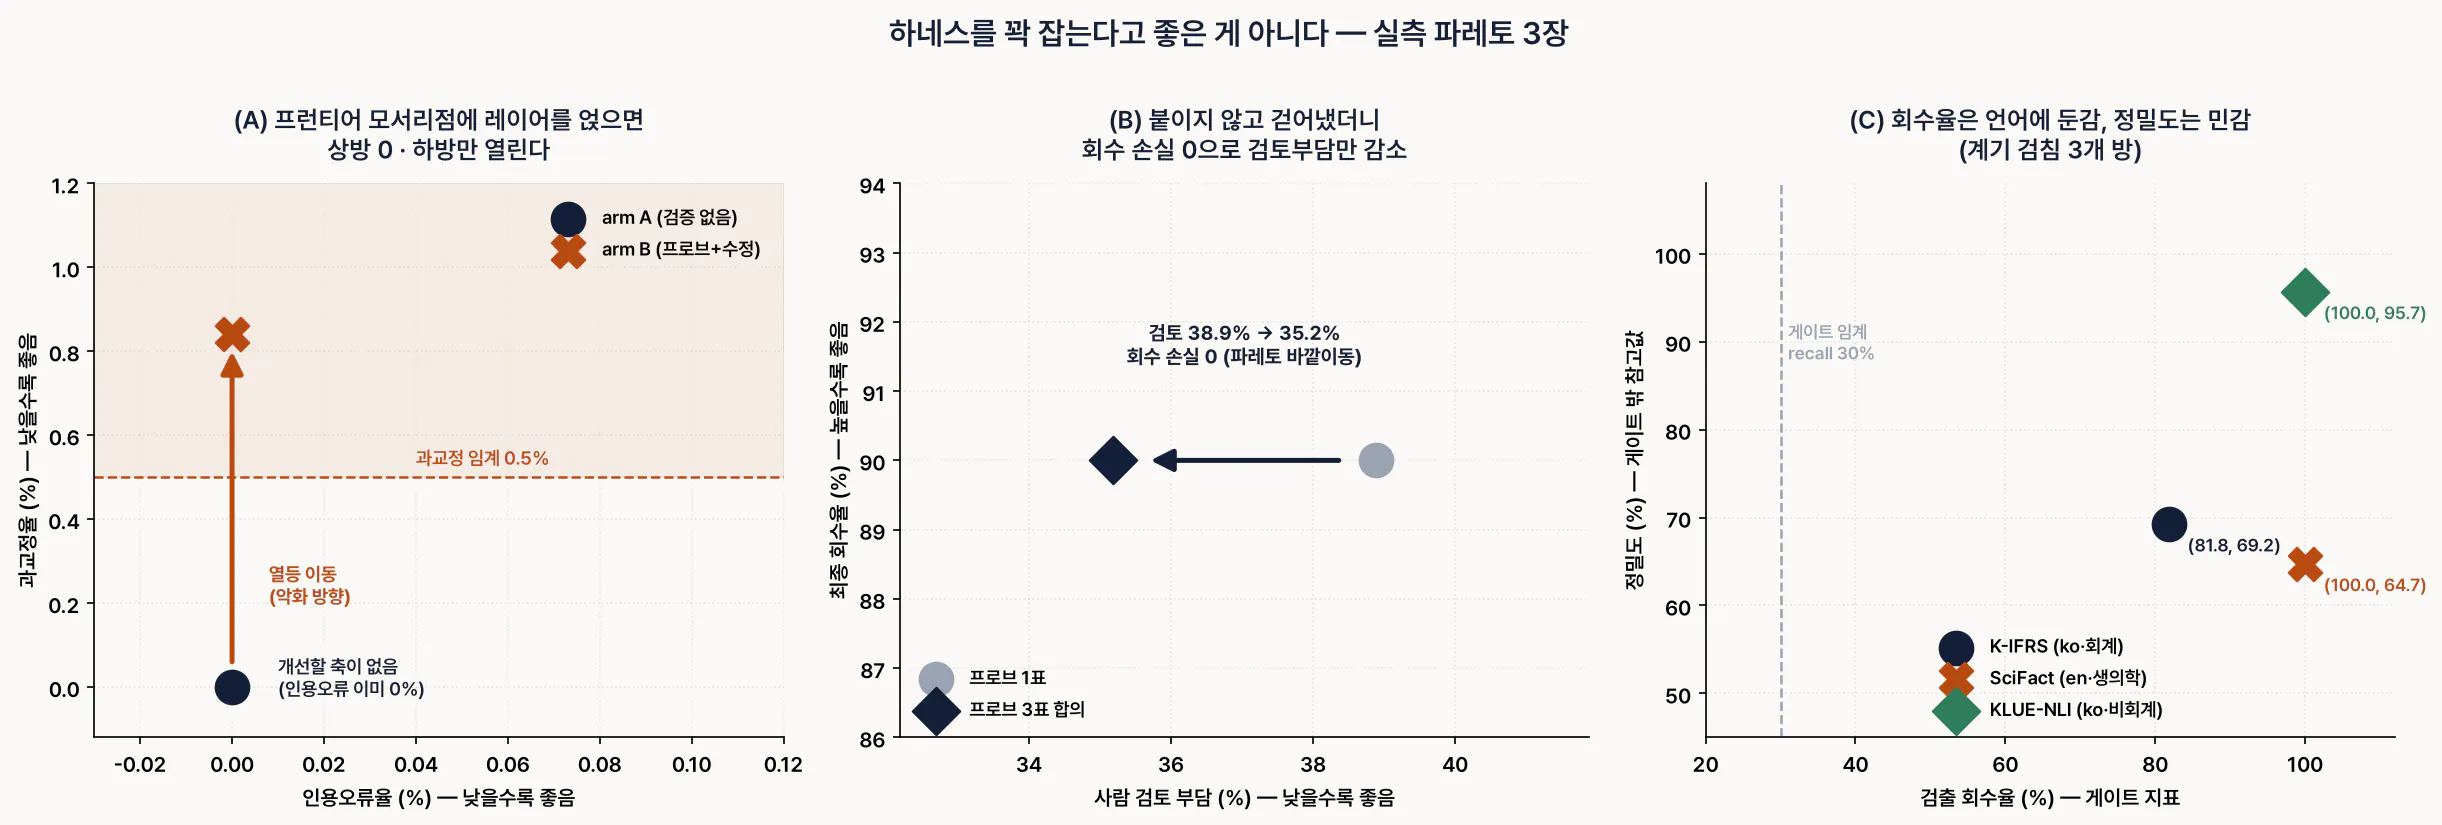
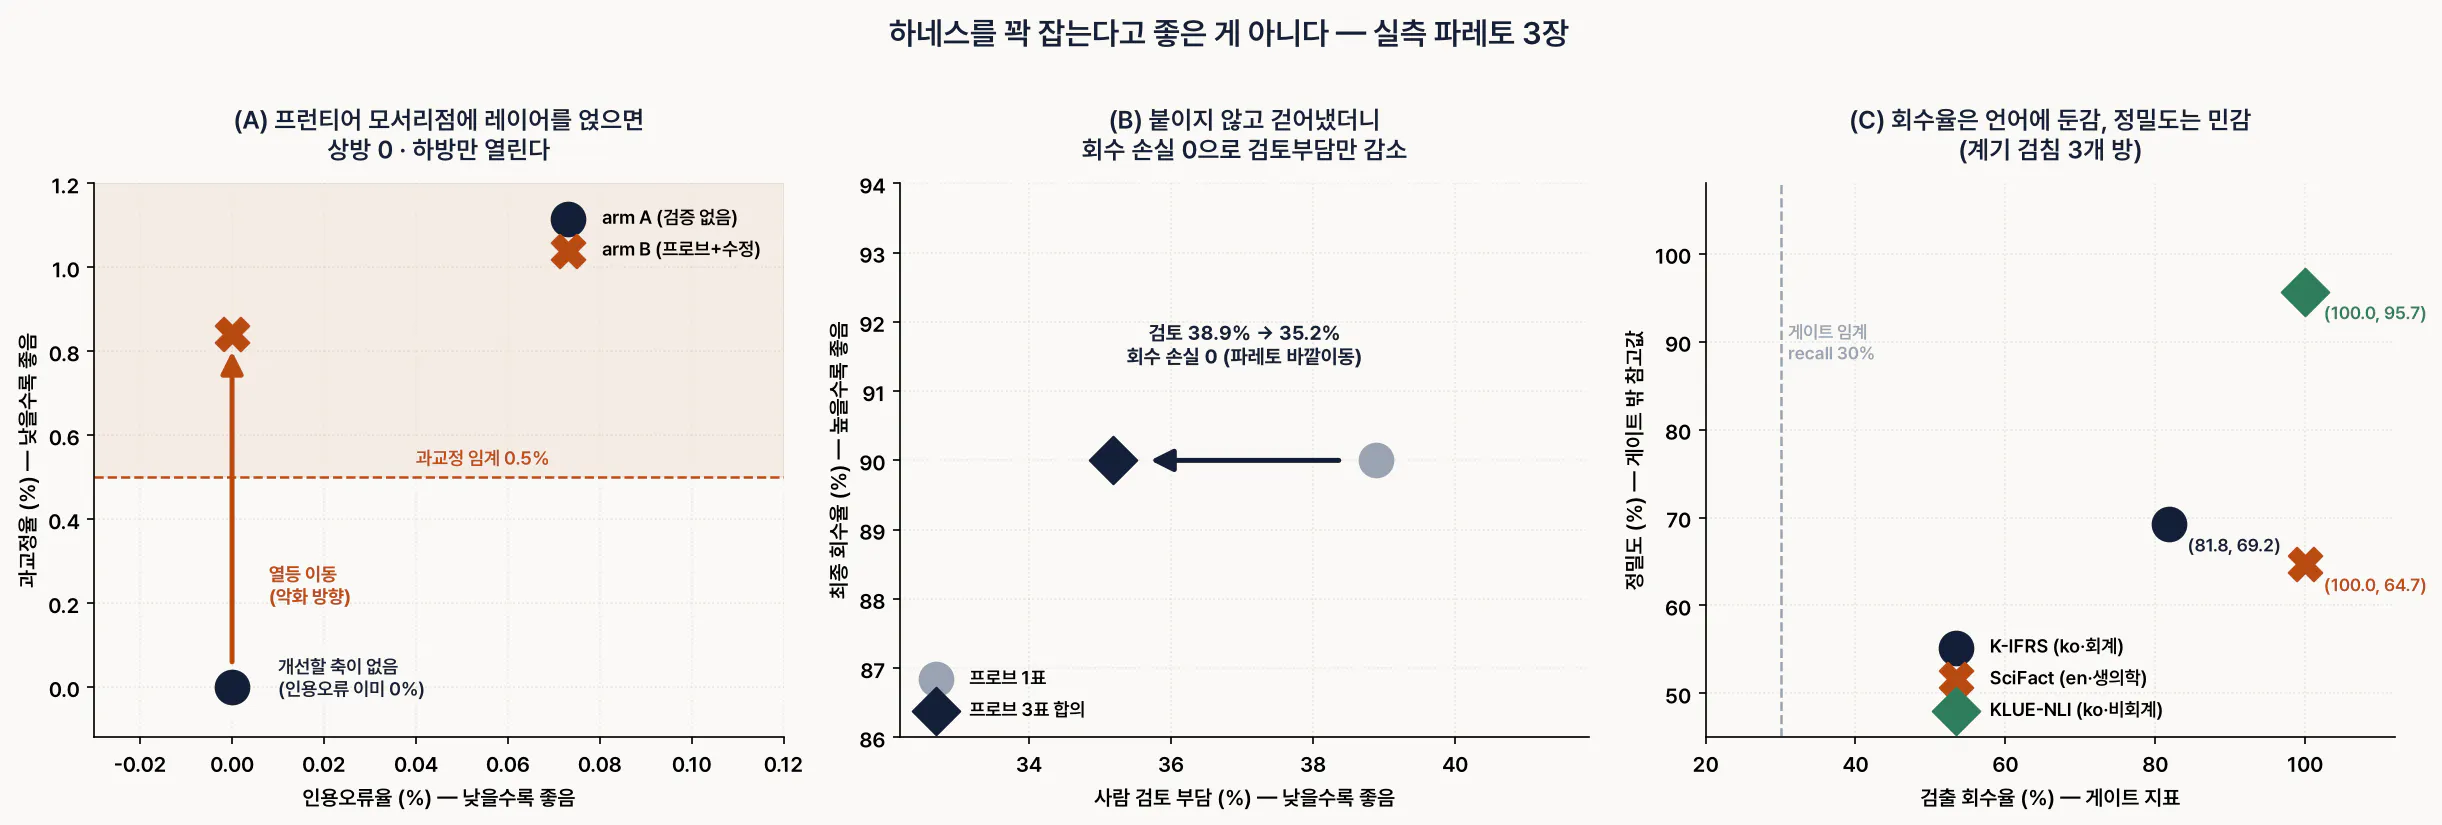
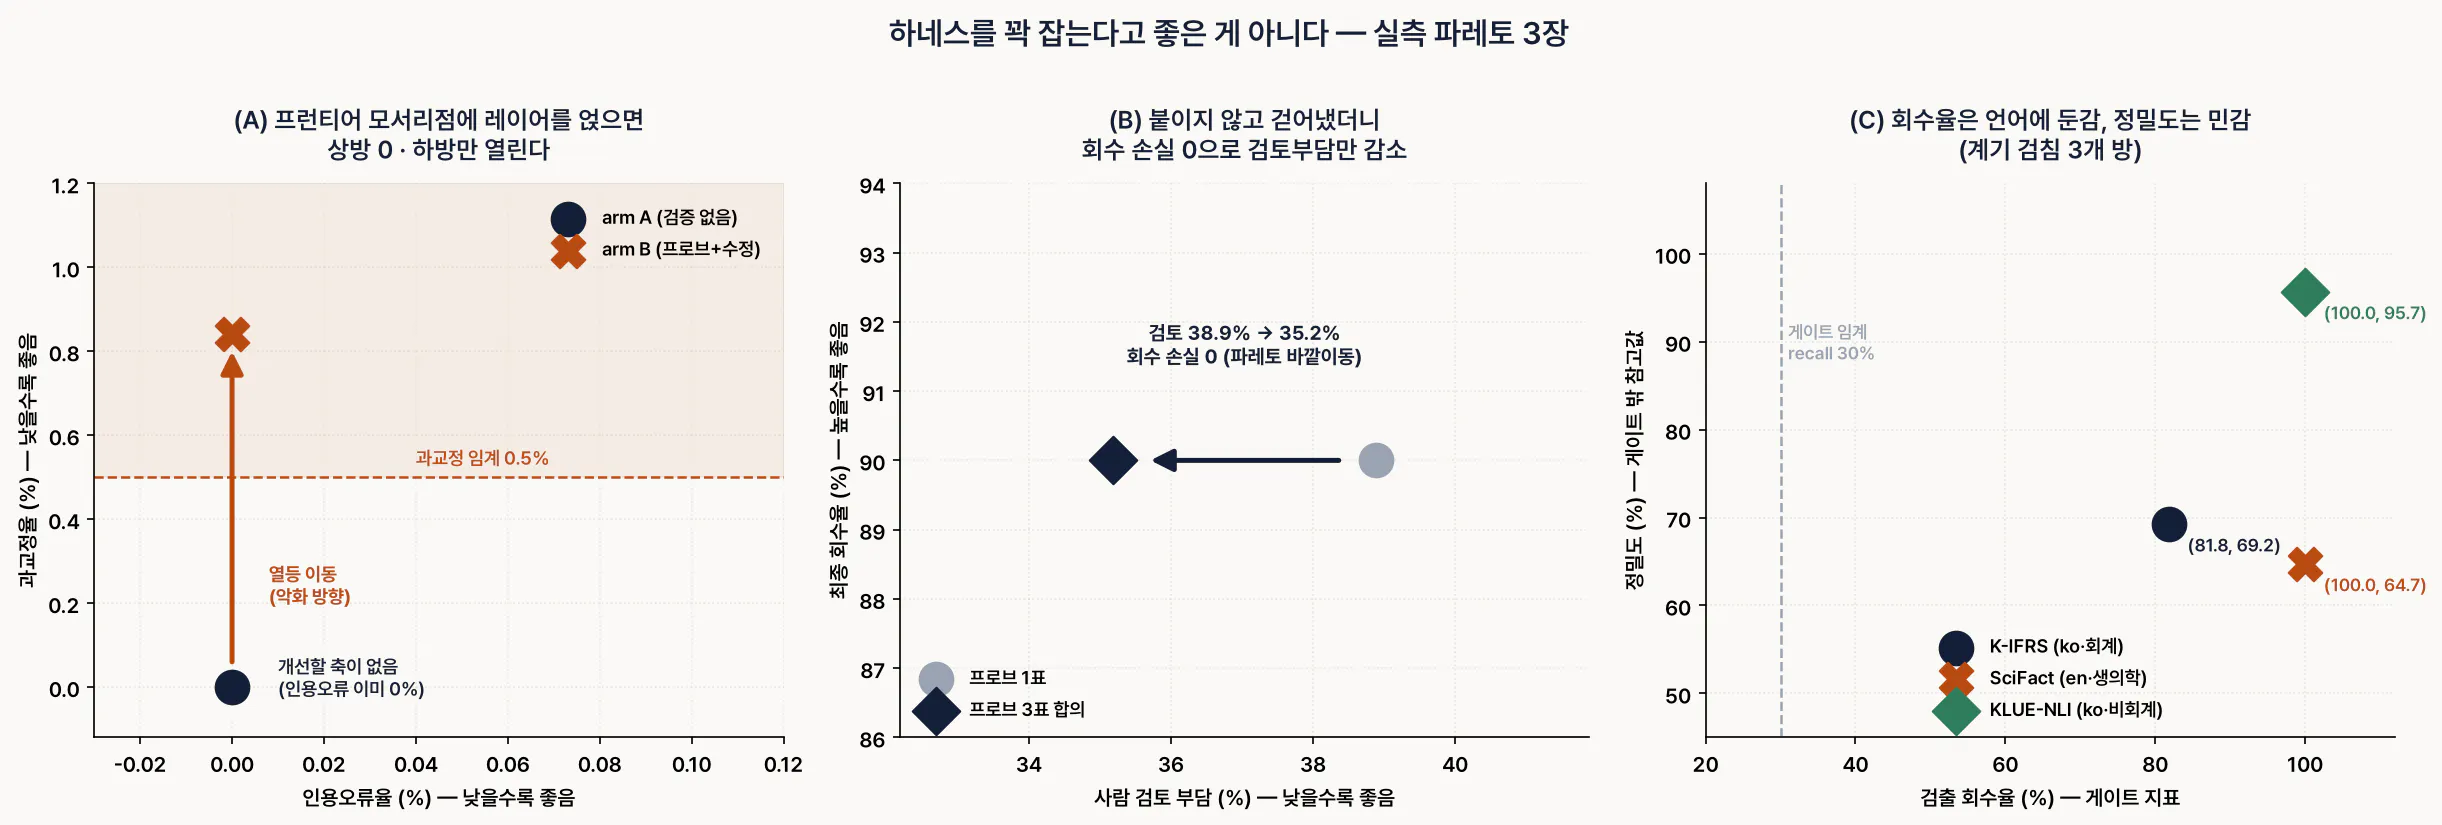
그리고 하나 더 — 매 반복마다 변이를 강제하면 안 됩니다. baseline이 이미 프론티어 모서리에 있으면 상방이 0이고 하방만 열려 있어서, 변이를 강제할수록 기대값이 음수가 됩니다. "더 개선할 게 없다"도 정당한 결론이어야 합니다.
리플렉션 프로브(reflection probe) — Anthropic 인터프리터빌리티 팀의 2026년 논문(Verbalizable Representations Form a Global Workspace in Language Models)에 이런 발견이 있습니다. "모델에게 물어보면 말할 내용"과 "모델이 조용히 추론하는 내용"이 인과적으로 이어져 있다는 겁니다. 그리고 모델이 속으로는 이의를 알아채고도 출력에 반영하지 않는 "BUT-갭"이 88%였습니다.
논문의 본체 기법은 모델 내부(residual stream)에 접근해야 해서 API 사용자는 못 씁니다. 그래서 저는 그 인과 발견만 프롬프트 레벨로 번역했습니다 — 답변을 다 만든 뒤에 "이 답에서 네가 근거를 못 대는 부분을 말해봐"라고 되묻는 노드를 파이프라인에 꽂는 겁니다.
"프로브(probe)"는 원래 신경망 내부를 찔러보는 진단 도구를 뜻하는데, 저는 그걸 "모델 자신에게 되묻는 질문"으로 옮긴 겁니다. 즉 이 단어는 탐침(진단)이라는 뜻이지 "교정기"가 아닙니다. 이 구분이 나중에 중요해집니다 — 진단 도구를 성능 개선 도구로 착각하면 파레토 열등이동이 나옵니다.
A/B 게이트 — A/B는 같은 조건에서 딱 하나만 다르게 두 판을 돌려 비교하는 겁니다. 여기서는 arm A = 프로브 없음, arm B = 프로브 붙임.
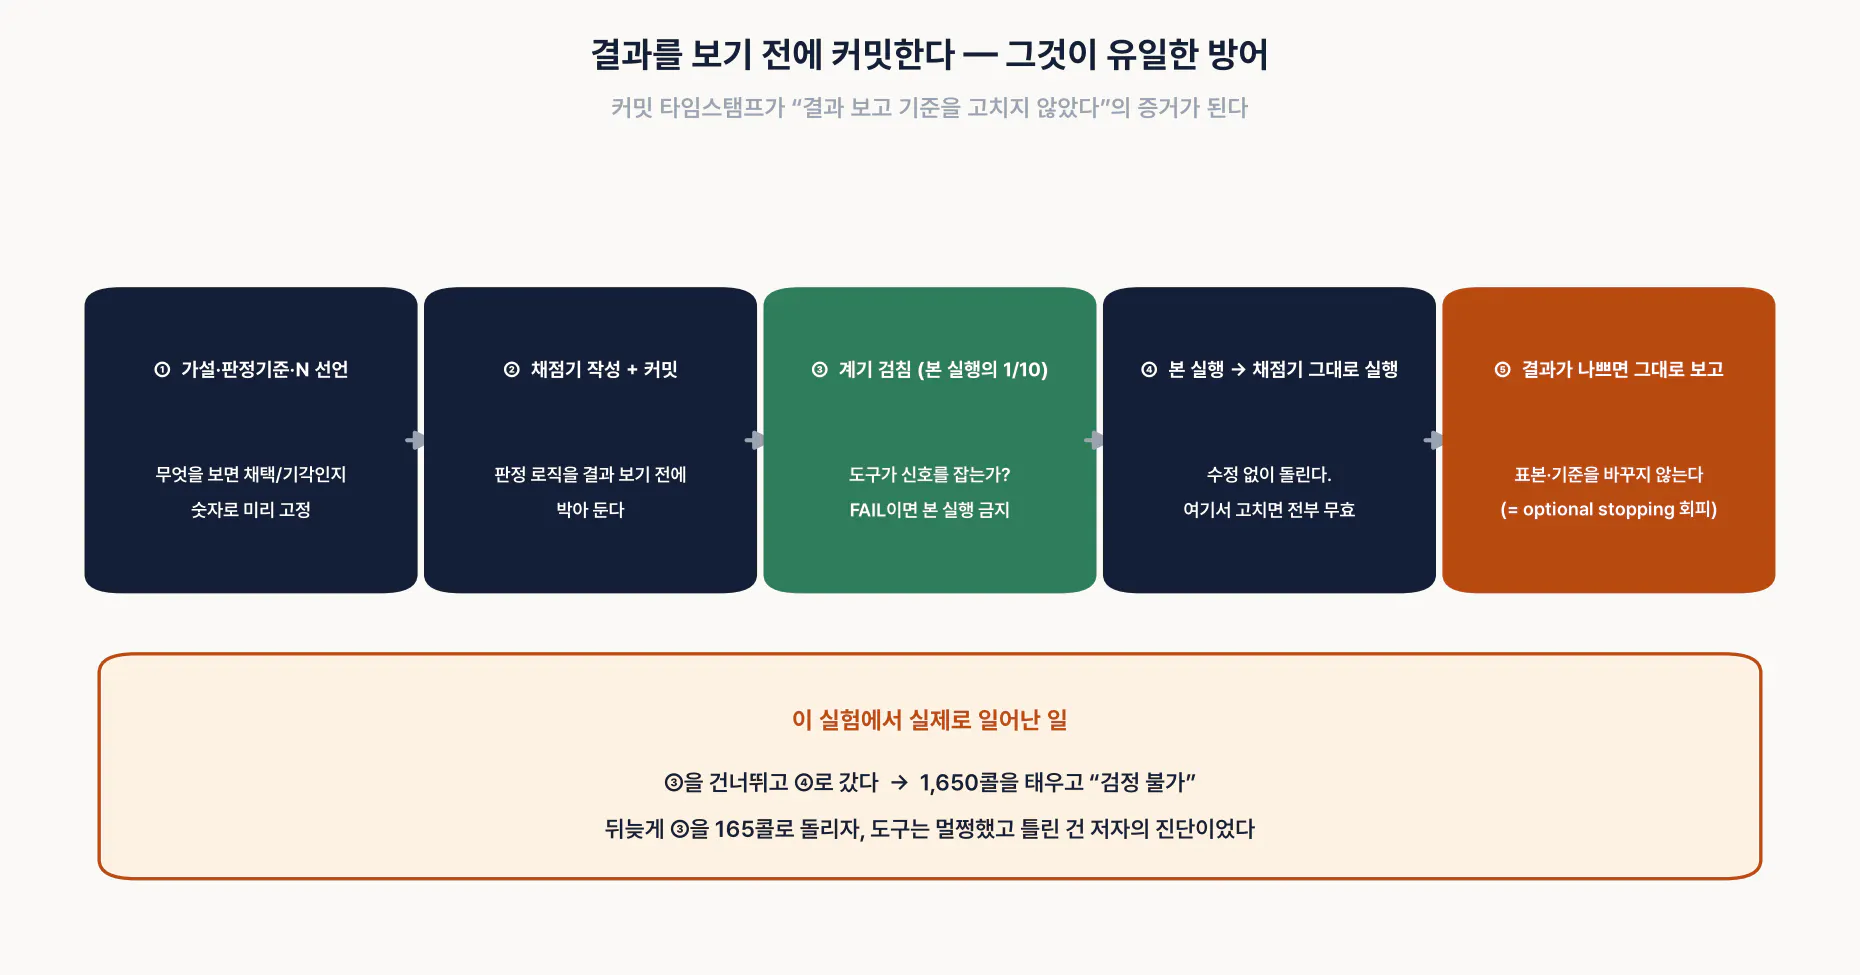
게이트는 그 비교 결과를 보고 채택할지 폐기할지를 기계적으로 판정하는 관문입니다. 중요한 건 판정 기준을 결과 보기 전에 미리 못 박는다는 것입니다. 결과를 본 뒤에 기준을 정하면 사람은 무의식적으로 자기 결과에 유리한 기준을 고르니까요.
이 실험의 게이트는 3층이었습니다.
주지표 — 이게 좋아져야 채택할 이유가 생긴다 (인용오류율)
가드레일 — 이게 나빠지면 주지표가 좋아져도 폐기 (답변정확도, 과교정율)
통계 검정 — 차이가 우연인지 아닌지 (McNemar 검정)
p값 — "아무 효과도 없는데 순전히 우연으로 이 정도 차이가 나올 확률"입니다.
동전을 10번 던져 앞면이 7번 나왔다고 해봅시다. 조작된 동전일까요? 정상 동전으로도 7번쯤은 흔합니다 → p값이 크다 → "조작됐다"고 말 못 합니다. 그런데 100번 던져 70번이면 정상 동전으로 그럴 확률이 매우 낮습니다 → p값이 작다 → "우연으로 보긴 어렵다"가 됩니다.
관례상 p < 0.05면 "통계적으로 유의하다"고 합니다.
이 글에 나오는 McNemar 검정은 "같은 대상을 두 조건에서 각각 측정했을 때" 쓰는 검정입니다. 이 실험이 정확히 그 구조예요 — 같은 주장을 프로브 있이/없이 각각 채점했으니까요.
🔴 여기서 제가 실수를 하나 했고, 그 기록도 남겼습니다. 사전 선언 문서에 "불일치쌍 5건이면 p=0.031"이라고 썼는데, 양측 검정의 2배를 빠뜨린 계산 오류였습니다. 실제로 5건의 양측 p값은 0.0625로 유의하지 않고, 임계는 6건입니다. 판정 함수를 독립 재계산으로 검증하다 발견했고, 결과를 보기 전이라 무결성엔 영향이 없었습니다. 교훈: 판정 공식은 쓰기 전에 다른 경로로 한 번 더 계산해봐야 합니다.
baseline — 개선을 재는 기준선입니다. "우리 방법이 좋다"는 말은 항상 "무엇보다?"를 요구하는데, 그 무엇이 baseline입니다.
이 글에서 baseline이 결정적인 이유가 있습니다. baseline이 이미 완벽하면 개선할 축이 없습니다. 그러면 어떤 검증 레이어를 붙여도 상방은 0이고 하방(부작용)만 남습니다. 그래서 이 실험이 남긴 첫 번째 실무 규칙이 이거예요.
레이어를 붙이기 전에 baseline 오류율부터 재라. 0%면 붙이지 마라.
라벨 — 각 사례에 사람이 붙인 정답표입니다. 이게 있어야 "기계 판정이 맞았는지"를 잴 수 있어요. 이 실험의 라벨은 3종입니다.
라벨
의미
S (Supported)
주장이 제공된 근거에 명시돼 있거나 직접 도출된다
C (Contradicted)
근거가 주장과 반대되는 내용을 진술한다
I (Insufficient)
근거만으로는 확인 불가. 회계적으로 맞는 말이어도 근거 범위 밖이면 I
🔴 라벨링의 핵심 규칙은 이겁니다. "이 주장이 참인가"를 묻지 않습니다. "제공된 근거가 이 주장을 지지하는가"만 묻습니다. 도메인 지식으로 참/거짓을 판정하기 시작하면 라벨이 오염됩니다.
그리고 라벨은 블라인드로 찍습니다 — 기계가 뭐라고 판정했는지 안 보이게 열을 숨깁니다. 기계 판정을 보고 라벨하면 그건 정답표가 아니라 기계 판정의 복사본이 됩니다.
🎬 왜 시작했나
출발점은 위에서 말한 Anthropic 논문이었습니다. "물어보면 말할 내용 = 조용히 추론하는 내용"이라는 인과 발견을 프롬프트 레벨로 옮겨 리플렉션 프로브를 만들었죠.
그런데 구현 전에 자기검증(self-correction) 문헌을 먼저 읽었더니, 순진하게 만들면 오히려 성능이 깎인다는 반대 증거가 일관되게 나왔습니다.
검토한 문헌 8편과 각각이 설계에 준 것입니다.
#
논문
이 설계에 준 것
1
Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet
"네 답이 틀렸을 수 있다"고 가정시키는 프롬프트가 최대 −9.5%p(CSQA). 정답→오답 전환이 오답→정답보다 항상 많았다. → "이미 정확할 가능성이 높다고 전제" + "문제 찾기가 아니라 일치 확인"
2
Dhuliawala et al., Chain-of-Verification
검증자에게 초안 산문을 주지 않는 factored 검증으로 FACTSCORE 55.9→71.4. yes/no 검증질문은 동조 편향을 부른다. → 프로브에 주장 리스트만 입력 + 원문 발췌 강제
3
FBC/EIR 계열 (verify-first ablation)
"수정 전 독립 재확인 + 구체적 오류만 수정" 앵커로 정답→오답 전환 2%→0%. 같은 예산에서 3회 반복 수정(86.6점) < 단순 다수결(93.4점). → 수정 루프 상한 1회
4
Madaan et al., Self-Refine
실패 분석: 61%가 "부적절 수정". → "근거가 없으면 표시만 하고, 다른 내용으로 바꾸지 마라"
5
Shinn et al., Reflexion
외부 신호 기반 반성이 통하는 조건과 한계
6
Manakul et al., SelfCheckGPT
샘플링 기반 자기점검의 위상 — 본 설계에서 미채택한 근거
7
Tian et al. · Xiong et al.
단일 숫자 확신도는 80~100%에 과확신 집중, top-2 verbalized가 캘리브레이션 우수. → 상/중/하 + 대안 후보 2개
8
FAR.AI, Obfuscation Atlas · Morris et al.
전자: 프로브 지적 건수를 KPI로 삼으면 정직해지는 게 아니라 프로브를 피하는 방향으로 최적화된다 → "지적 건수 최적화 금지" 규칙. 후자: 파라미터당 ~3.6비트 기억 한계 → 조문 번호를 기억에서 꺼내면 틀린다 → 파라메트릭 인용 금지
이 근거들이 프로브 프롬프트의 앵커들로 박제됐습니다. 즉 시작부터 "자기검증은 위험하다"를 전제로 설계했습니다.
😤 1막 — 만들자마자 폐기 판정
K-IFRS 공개 기준서 119문항으로 A/B 게이트를 사전 등록하고(문항·채점규칙을 실행 전 동결) 실행했습니다. 채점은 ①인용 기계 대조 ②arm 라벨을 숨긴 블라인드 LLM 저지 2층.
게이트
arm A (프로브 없음)
arm B (프로브+수정)
판정
주지표: 인용오류율
0/119 (0%)
0/119 (0%)
개선 여지 없음 ❌
가드레일: 답변정확도
99.2%
99.2%
비열화 ✅
가드레일: 과교정율
—
0.84% > 임계 0.5%
❌
메인 프로브 P1 폐기.
왜 폐기됐나 — "너무 정확해서"가 맞습니다
실측으로 확인한 결과, 정확히는 이렇습니다.
① baseline이 이미 프론티어 모서리점이었습니다. arm A는 인용오류 0%, 답변정확도 99.2%였습니다. 두 축 모두 사실상 천장입니다. 함정 문항(distractor 18개, 유사 문단으로 오인용 유도)에서도 오인용이 0건이었습니다. 개선할 축이 없었습니다.
② 그러면 검증 레이어의 기대값이 구조적으로 음수가 됩니다.
상방(얻을 수 있는 것): 인용오류를 0에서 더 줄일 수는 없다 = 0
하방(잃을 수 있는 것): 프로브가 "근거 밖"이라고 지적 → 수정 단계가 그 부분을 고침 → 원래 맞던 답이 훼손될 수 있다 = 열려 있다
얻을 것은 없고 잃을 것만 있는 도박이었고, 실제로 잃었습니다.
③ 실물 사례가 나왔습니다(Q092). 프로브는 규칙대로 "evidence 범위 밖 추론"이라고 근거없음 판정했습니다. 수정 단계도 규칙대로 그 항목만 완곡하게 바꿨습니다. 둘 다 각자의 규칙을 지켰는데, 결과는 답변 첫 문장과 모순되는 답이 됐습니다. Self-Refine 논문이 보고한 "부적절 수정 61%"가 제 데이터에서 그대로 재현된 겁니다.
④ 이것이 파레토 열등이동의 정의에 정확히 부합합니다. 좋아진 지표는 없고(0→0), 나빠진 지표는 있고(과교정 0%→0.84%), arm A가 arm B를 지배합니다. 채택할 이유가 없습니다.
경제학 용어로 옮기면 이건 초과 규제의 사중손실(deadweight loss)입니다. 규제(프로브)도 집행(수정)도 각자 정당한데, 조합의 결과가 사회 후생을 깎았습니다.
그래서 이 실험이 남긴 첫 번째 실무 규칙:
"검증을 더하면 더 안전하다"는 직관은 프론티어 안쪽에서만 참이다. 레이어를 붙이기 전에 baseline 오류율을 먼저 재라. 0%면 붙이지 마라.
한 가지 정직하게 덧붙이면, 이 판정의 유효 범위는 이 실측 조건(강한 생성 모델 + 근거를 프롬프트에 동봉 + K-IFRS)에 한정됩니다. 더 약한 모델이거나 근거를 안 주는 환경이라면 baseline 오류율이 0이 아닐 것이고, 그러면 프로브가 유효할 수 있습니다.
🔁 2막 — 판정이 재현되지 않는다
사람 라벨 55건을 블라인드로 찍었습니다(라벨링 프로토콜을 라벨 시작 전 커밋). 그리고 판정기 v1/v2/v3를 실측했습니다.
v1 불합격: 오탐 9건
🔴 가장 중요한 발견: 동일 프롬프트·동일 모델로 3회 돌렸더니 54건 중 5건이 매번 달라졌습니다. LLM 판정은 결정론이 아니었습니다. → 단일 실행 수치를 성능으로 보고하면 그건 허위보고입니다. 이후 모든 채점을 3판 다수결로 고정했습니다.
그리고 여기서 유일한 파레토 바깥이동이 나왔습니다
프로브 판정을 1표에서 3표 합의(3판 모두 YES인 것만 검토 대상)로 바꿨더니:
1표
3표 합의
최종 회수율
90.0%
90.0% (손실 0)
사람 검토 부담
38.9%
35.2%
자동 구간 오탐
0건
0건
두 지표 중 하나는 그대로, 하나는 개선. 파레토 지배가 성립합니다.
여기서 방법이 중요합니다. 이건 뭔가를 더 붙여서 얻은 게 아니라, 불안정한 판정을 걷어내서 얻은 개선입니다. 지표를 올리려 할 때 사람은 보통 뭔가를 추가하려 하는데, 기존 히트에서 노이즈를 제거하는 쪽이 프론티어를 더 잘 밉니다.
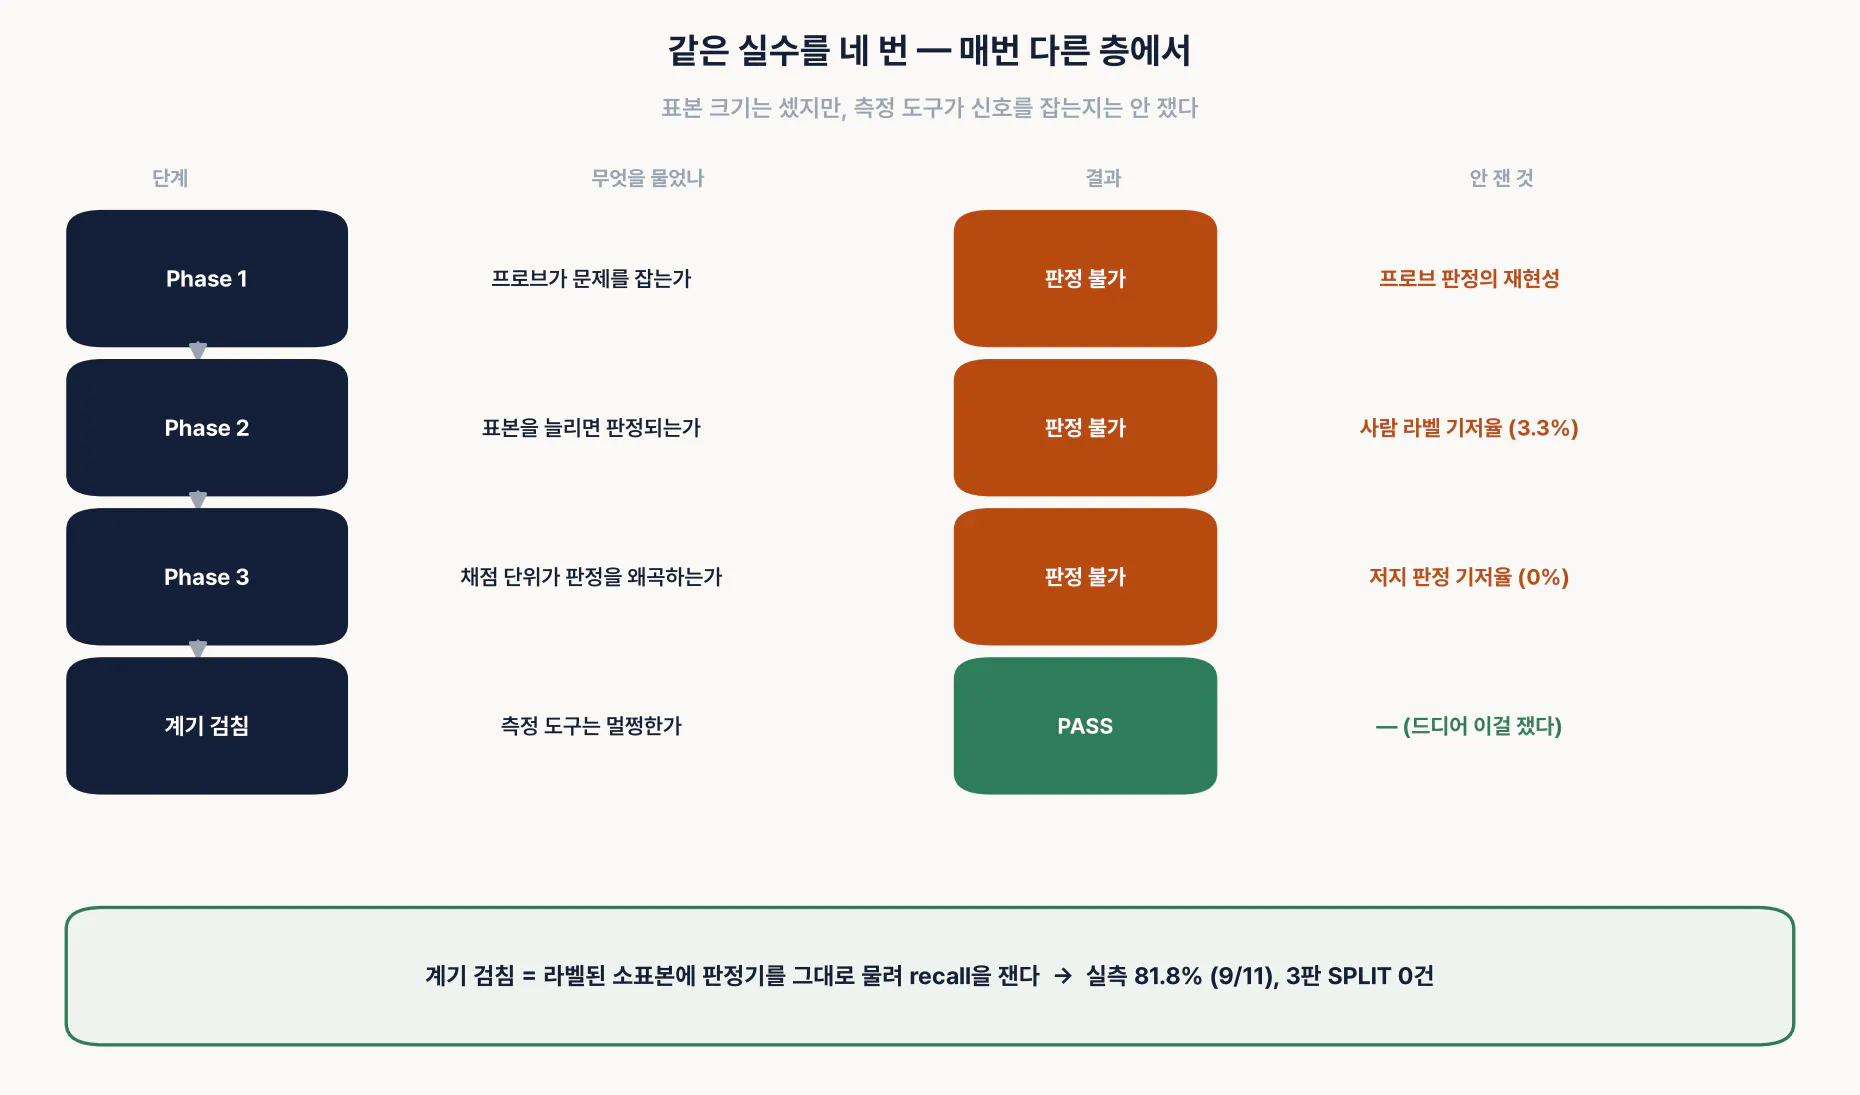
Phase 1 판정: 프로브 효과 = 판정 불가. 다만 오탐 12건이 100% 동일한 실패 모드(하나의 규칙이 여러 주장으로 쪼개졌는데 주장을 고립시켜 채점한 것)임을 특정했습니다.
📉 3막 — 기저율이 표본 크기를 이긴다
사람 라벨을 더 늘려서 검정력을 확보하려 했습니다. 그런데 몇 건을 라벨해야 하는지를 모르는 상태였어요. 필요한 표본 수는 기저율(문제 사례가 나오는 비율)에 반비례하는데, 그 기저율을 모르니까요.
여기서 내부 파일럿(internal pilot) 설계를 썼습니다. 핵심은 이겁니다.
30건만 먼저 라벨하고 기저율만 본다. 성능 지표는 열지 않는다.
그 기저율로 필요한 N을 기계적으로 계산한다.
파일럿 30건은 버리지 않고 본 표본의 앞 30건으로 중첩시킨다.
왜 이렇게까지 하냐면 — 결과를 보고 표본 크기를 바꾸면 optional stopping(원하는 결과가 나올 때까지 데이터를 더 모으는 것)으로 공격받습니다. 그런데 효과 크기가 아니라 기저율만 보고 N을 조정하는 것은 통계학에서 인정된 표준 기법이라 방어가 됩니다. 이 구분이 설계의 전부입니다.
실측 결과: 기저율 3.3%(1/30). 후보 풀 201건을 전량 라벨해도 기대 문제 사례가 6.7건. 목표 55건에 한참 미달이었습니다.
→ 171건을 라벨하지 않고 종결했습니다.
이것도 파레토 판정입니다. 라벨 비용(사람 8~10시간)을 다 지불해도 검정력을 못 얻는다면, 그 완주는 파레토 열등입니다. "판정 불가"를 정직하게 보고하는 쪽이 낫습니다.
🔥 4막 — 1,650콜을 태우고 검정 불가
3막이 사람 라벨 비용에서 막혔으니, 결과변수를 바꿨습니다. 사람 라벨 대신 판정기 자체의 판정이 뒤집히는지를 결과변수로 삼으면 사람 비용이 0이 됩니다.
설계는 엄격하게 했습니다. 변인을 하나만 바꿨어요(형제 주장 문맥의 유무). 지시문은 한 글자도 안 바꿨고, 프롬프트 빌더가 두 조건의 차이가 형제 블록뿐임을 매 건 코드로 검증하게 했습니다.
조건 A/B × 3판 = 1,650콜, 약 2시간.
결과: 조건 A의 문제 판정이 271건 중 0건
뒤집힐 대상이 아예 없었습니다. 가설이 기각된 게 아니라 검정 자체가 불가능했습니다.
여기서 제가 스스로에게 물었습니다.
1-3실패면 아예 처음부터 다시하는 게 맞지 않나?
🔍 5막 — 계기 검침, 165콜이 제 오진을 잡다
리셋 대신 원인부터 갈랐습니다. 두 가설이 있었고 처방이 정반대였습니다.
가설 I (계기 고장): 판정기가 문제를 검출 못 하는 구성이다 → 판정기를 고쳐야 함
가설 C (코퍼스 공백): 판정기는 정상이고 표본에 문제가 없었다 → 표본을 바꿔야 함
프롬프트 코드를 대조하니 가설 I가 유력해 보였습니다. 4막의 판정기에는 이전 판정기에 있던 블록 2개(답변 전문, "규칙의 왜곡" 지침)가 실제로 없었거든요.
그래서 고치기 전에 쟀습니다 — 이게 이 프로젝트의 분수령입니다
계기 검침(instrument check): 판정기를 한 글자도 고치지 않고(프롬프트 빌더를 그대로 import) 이미 정답을 아는 라벨 55건에 물렸습니다. 판정 기준과 채점기는 결과를 보기 전에 커밋했습니다.
항목
값
사람 판정 문제 11건 중 검출
9건
검출 회수율
81.8% (Wilson 95% [52.3%, 94.9%])
3판 SPLIT (판정 흔들림)
0건
PASS — 가설 I는 기각됐습니다. 제 진단이 틀렸던 겁니다.
지침이 없어도 판정기는 잘 잡았고, 오히려 3판 재현성은 2막의 복잡한 판정기(5건 흔들림)보다 좋았습니다(0건).
검침 없이 진단대로 고쳤다면, 멀쩡한 도구를 고치고 그 변경을 "개선"이라고 보고했을 겁니다. 비용은 본 실행의 1/10(1,650콜 → 165콜)이었습니다.
🔴 그리고 진짜 원인 — 두 규율이 충돌했습니다
원인은 표본에 있었고, 그 출처가 사전등록 규칙 자체였습니다.
4막은 순환 논증을 피하려고 "가설을 생성한 표본은 확증 집합에서 제외한다"는 규칙을 뒀습니다. 실측해보니 문제가 발견된 28문항이 확증 집합에 0개, 제외 집합에 28개 전부 들어가 있었습니다.
순환 논증을 피하려고 가설 생성 표본을 제외하면, 신호도 함께 제외된다. 제외하지 않으면 순환이고, 제외하면 검정 대상이 사라진다.
이건 부주의가 아니라 사전등록 규율을 성실히 따른 결과입니다. 두 규율(순환 차단 ↔ 검정 가능성)이 서로 충돌한 거예요. 해법은 제외를 포기하는 게 아니라, 제외한 뒤에도 결과변수의 기저율이 남는지를 본 실행 전에 확인하는 것 — 그게 계기 검침입니다.
🌏 6막 — 옆방 검증, 설계를 고친 건 한 마디였습니다
README에 "범용성은 미검증"이라고 표기해뒀던 걸 실측으로 대체하는 작업이었습니다.
여기서 제 파트너의 한 마디가 설계를 바꿨습니다.
정 안되면 옆방을 한국어꺼 찾아서 교체해서 다시 가자
이 제안이 설계를 바꿨습니다. 결과를 보고 데이터셋을 교체하면 optional stopping의 데이터셋판이 됩니다. 그런데 결과를 보기 전에 "추가"로 선언하면 방어가 됩니다.
그리고 더 중요한 게 있었습니다 — 첫 옆방(SciFact)은 언어·도메인·라벨러가 동시에 바뀌어서 결과가 나빠도 원인 귀속이 불가능했습니다. 한국어 옆방을 넣으면 축이 갈립니다. 이건 실패 대비책이 아니라 원래 했어야 할 설계였습니다.
방
언어
도메인
라벨러
recall
SPLIT
판정
원래 방 (K-IFRS)
한국어
회계 기준
저자
81.8%
0
PASS
옆방 1 (SciFact)
영어
생의학
외부
100%
0
PASS
옆방 2 (KLUE-NLI)
한국어
비회계
외부
100%
0
PASS
외부 라벨러 방에서도 PASS가 나온 게 중요합니다. 원래 방은 제가 라벨하고 제가 만든 판정기를 검침한 거라 "기준이 무의식적으로 정렬됐다"는 반론이 가능했는데, 그게 기각됐습니다.
🔴 축 분리 — 예상 못 한 수확
지표
SciFact (en)
KLUE-NLI (ko)
검출 회수율 (게이트 지표)
100%
100%
3라벨 완전일치
72.7%
92.7%
오탐 (사람 S → 문제 판정)
36.4%
3.0%
정밀도
64.7%
95.7%
회수율은 언어에 둔감하고, 정밀도는 언어에 민감합니다.
문제를 놓치는 실패는 두 언어 모두 0이었고, 문제가 아닌 걸 문제라고 하는 실패는 영어에서 12배 늘었습니다. 한국어 프롬프트에 영문 근거를 넣으니 판정기가 "근거 범위 밖"을 더 자주 선언한 거예요.
어느 쪽이 옳은지는 이 실험이 답하지 못합니다 — 판정기가 더 엄격한 건지, 교차언어 조건에서 이해가 얕아진 건지 구별하려면 프롬프트를 영어로 번역한 조건이 필요한데, 그건 변인을 하나 더 바꾸는 것이라 별도 실험으로 남겼습니다.
💡 그런데 왜 제 81.8%가 100%보다 좋을까요
옆방 두 곳이 recall 100%인데 원래 방만 81.8%입니다. 얼핏 보면 진 것 같습니다. 그렇지 않습니다. 오히려 이 프로젝트에서 가장 값어치 있는 숫자입니다. 세 층으로 풀어보겠습니다.
① 놓친 2건이 무엇이었나 — 사람도 애매하다고 적어둔 건입니다
id
사람 라벨
사람이 라벨 시점에 남긴 메모
Q068-A-c1
C
"애매: 첫 번째 시점만 필요조건인지, '중 이른 날' 규칙 전체를…"
Q068-A-c2
C
"애매: 후보 시점 나열인지 실제 인식 시점 단정인지 해석 여지"
둘 다 라벨러 본인이 "애매"라고 직접 표시한 경계 사례입니다. 쉬운 걸 놓친 게 아니라, 사람도 판단이 갈린 지점에서 기계도 갈린 겁니다.
② 난이도가 애초에 다릅니다 — 벤치마크 vs 실무 데이터
SciFact·KLUE-NLI는 벤치마크입니다. 데이터셋 제작자가 명확히 갈리도록 설계합니다. 애매한 항목은 어노테이터 합의가 안 되니까 애초에 걸러집니다.
K-IFRS 55건은 실제 답변에서 나온 날것입니다. "필요조건이냐 충분조건이냐" 같은 회계 실무의 경계선이 그대로 들어있습니다.
벤치마크가 걸러낸 층이 여기엔 남아 있습니다. 100%가 쉬운 문제에서 나온 100%라면, 81.8%는 어려운 문제에서 나온 81.8%입니다.
③ 파레토로 보면 아래가 아니라 옆입니다
방
recall
정밀도
K-IFRS (저자 라벨)
81.8%
69.2%
SciFact
100%
64.7%
KLUE-NLI
100%
95.7%
SciFact는 recall 100%지만 정밀도가 제 방보다 낮습니다. 사람이 "맞다"고 한 33건 중 12건을 문제라고 우겼습니다. 즉 SciFact의 100%는 "다 잘했다"가 아니라 의심을 많이 던져서 얻은 100%입니다. 제 방은 의심을 적게 던지면서 81.8%를 냈습니다.
두 점 사이에 지배 관계가 없습니다. 파레토상 다른 점에 있는 것이지 아래에 있는 게 아닙니다.
④ RAG · 온톨로지 · LLM 위키 관점에서 — 이게 왜 중요한가
여기가 핵심입니다.
과거방식의 RAG(검색증강생성)는 파편 기억법입니다. 질문이 들어오면 유사한 조각(청크)을 몇 개 끌어와서 그것만 보고 답합니다. 청크를 자르는 순간 문서 사이의 연결이 끊깁니다. 그래서 RAG는 "A 문단이 B 문단의 예외 조항이다" 같은 관계를 못 봅니다. 조각을 깎아서 가져오는 방식이기 때문입니다.
온톨로지·LLM 위키는 반대로 연결합니다. 노드(개념)와 엣지(관계)로 문서를 엮어두면, A를 읽을 때 "이건 B의 예외이고 C가 선행 조건"이라는 구조가 같이 딸려옵니다. 깎는 게 아니라 잇는 겁니다.
그런데 — 경계 사례는 정확히 이 "연결" 지점에서 발생합니다.
Q068이 그 실물입니다. 실제 데이터를 그대로 보겠습니다.
근거 (1019 문단 103)
과거근무원가는 다음 중 이른 날에 비용으로 인식한다.
(1) 제도의 개정이나 축소가 일어날 때
(2) 관련되는 구조조정원가나 해고급여를 인식할 때
답변 전문
과거근무원가는 (1) 또는 (2) 중 이른 날에 비용으로 인식합니다. 퇴직급여제도 개정으로 발생한 과거근무원가의 경우, 별도의 구조조정이나 해고급여 인식이 없다면 제도 개정이 일어나는 시점에 즉시 비용으로 인식합니다.
쪼개진 주장 하나 (Q068-A-c1)
"과거근무원가는 제도의 개정이나 축소가 일어날 때 비용으로 인식한다."
판정기는 이걸 INSUFFICIENT로 찍었습니다. 사유는 "주장이 첫 번째 조건만 기술하고 두 번째 조건을 누락해 불완전하다."
🔴 여기서 제가 짚은 것 — 이게 왜 "이탈"인지 알려주는 지점
회계 기준서는 사람의 판단이 필요하고, 전제가 되는 조건이 붙어야 답이 확정되는 문서다. 그래서 저런 이탈이 생기는 것 아닌가?
정확합니다. 그리고 데이터가 그걸 증명하고 있습니다. 세 가지가 동시에 보입니다.
첫째, 기준서 자체가 "조건부 규칙"으로 쓰여 있습니다. 문단 103은 단일 답을 주지 않습니다. (1)과 (2) 중 어느 쪽이 이른지는 상황에 따라 달라집니다. 즉 기준서는 답을 주는 게 아니라 답을 고르는 절차를 줍니다. 회계 기준서가 원래 이렇게 쓰입니다 — 원칙을 두고, 적용은 사실관계에 맡깁니다.
둘째, 답변은 그 전제를 명시하고 있었습니다. 답변 두 번째 문장을 보세요 — "별도의 구조조정이나 해고급여 인식이 없다면". 이건 전제 조건을 붙인 겁니다. 질문이 "퇴직급여제도를 개정해서 과거근무원가가 발생했다"였으니, 이 상황에서는 (2)가 없어 (1)이 곧 이른 날이 됩니다. 답변 전체로 읽으면 완전합니다. 회계 실무자가 원하는 답도 정확히 이것입니다.
셋째, 그런데 채점은 그 전제를 떼어내고 문장 하나만 봤습니다. "주장 단위로 쪼개서 각각 채점한다"는 방식이 전제 조건을 함께 잘라버린 겁니다. 문장만 고립시켜 놓으면 "(2)를 누락했다"가 되고, 답변 전체와 함께 읽으면 "전제하에 (1)로 특정한 것"이 됩니다. 같은 문장인데 판정이 뒤집힙니다.
즉 이 "이탈"의 정체는 판정기의 무능이 아니라, 회계 기준서라는 문서 종류와 문장 단위 채점 방식이 구조적으로 안 맞는 것입니다.
회계 기준서의 성질
문장 단위 채점의 가정
답의 형태
전제 조건이 붙어야 확정
문장 하나가 자족적으로 참/거짓
판단 주체
사람이 사실관계를 대입
근거 문단과 문자열 대조
문단 관계
원칙 ↔ 예외, 선택 ↔ 연언
문단은 독립적
넷째 — 그래서 이게 온톨로지가 필요한 이유의 증거입니다.
이 문제는 청크를 더 잘 자르거나 유사도를 높여서는 안 풀립니다. 필요한 건 관계의 명시입니다.
문단 103이 선택 규칙(OR)이라는 것 — 연언(AND)이 아니라
"제도 개정" 질문 맥락에서는 (2)가 비활성 분기라는 것
답변의 전제절이 그 분기 선택의 근거라는 것
이걸 노드·엣지로 엮어두면 판정이 확정됩니다. RAG처럼 문단만 끌어오면 영원히 "누락"으로 보입니다.
정리하면:
벤치마크의 100%는 "청크 하나로 판정 가능한 문제"에서 나온 100%입니다. RAG로 조각만 가져와도 풀립니다. 반대로 말하면 RAG의 한계가 드러나지 않는 문제였던 거죠.
제 방의 놓친 2건은 "관계와 전제를 봐야 풀리는 문제"입니다. 이게 남아있다는 건, 이 데이터셋이 RAG 방식의 천장을 실제로 건드리고 있다는 뜻입니다.
그리고 이 2건이 온톨로지/위키 구조가 필요한 이유의 증거입니다. 청크 유사도로는 영원히 안 풀리고, 문단 간 관계(선택 ↔ 연언, 원칙 ↔ 예외)와 전제 조건을 명시해야 풀립니다.
한 가지 더 — 이 진단은 실제로 실측으로 확인됐습니다. 2막에서 오탐 12건이 100% 동일한 실패 모드였고, 형제 주장을 함께 보여주자 형제가 있는 9건이 9/9 전부 뒤집혔습니다. "전제와 문맥을 잘라내서 생긴 문제"라는 진단은 추측이 아니라 데이터가 지지합니다.
즉 81.8%는 "우리 도구가 부족하다"가 아니라 "우리 데이터가 진짜 문제를 담고 있다"는 지표입니다. 100%짜리 벤치마크만 돌렸으면 "잘 되네" 하고 끝났을 것이고, RAG를 온톨로지로 확장할 이유를 찾지 못했을 겁니다.
놓친 2건을 빼면 9/9 = 100%가 됩니다. 그렇게 하지 않았습니다. 애매한 걸 빼서 숫자를 올리는 게 정확히 이 프로젝트가 하지 말자고 한 짓이었으니까요. 81.8%에 그 2건이 붙어 있는 게 100%보다 정직하고, 다음 할 일을 알려줍니다.
🎁 부수적으로 잡은 것들 (게이트가 일한 기록)
익명화 검사기 자체의 오탐 — 생의학 근거의 "anterior membrane"이 회사명으로 걸려 push가 막혔습니다. 문맥 한정 패턴으로 좁히고 네거티브 컨트롤로 검증했습니다(일부러 진짜 회사명을 넣으면 잡히고, 빼면 통과하는지 확인). → 새로 만든 검사로 0건을 얻는 건 아무것도 증명하지 않습니다. 막혀야 할 것을 일부러 넣어봐야 의미가 있습니다.
자식 에이전트의 자기보고 오류 — 번역을 위임한 에이전트가 "헤딩 23개"라고 보고했는데 실물은 22개였습니다. → 구조를 직접 재는 대조 스크립트를 만들어 게이트로 전환했습니다.
실행 중인 파일이 커밋에 딸려 들어감 — 부분 결과가 레포에 박히면 "결과 보고 뭔가 했다"로 오해받을 수 있어 되돌렸습니다.
사전 선언 문서의 통계 오류 — 위 용어 설명에 쓴 p값 항목의 그 오류입니다. 결과를 보기 전에 발견해 정정 기록을 남겼습니다.
🚀 최종 산출물
공개 레포: https://github.com/kims6305-bjk/reflection-probe-gate (MIT, README 한/영/중)
재사용 가능한 게이트 4종: 계기 검침 / 익명화 전수검사 / README 구조 대조 / 수치 보존 검사
검증된 도메인 3개: 한국어 회계 / 영어 생의학 / 한국어 일상
사전 선언 문서 전부가 실행 전 커밋되어 있고, 커밋 순서가 git 이력으로 검증 가능
기술 스택: Python, claude CLI, pytest 38종, GitHub Actions(ubuntu/windows × py3.11/3.12), McNemar 정확검정, Wilson 신뢰구간, matplotlib(차트는 원자료에서 계산 — 수치 하드코딩 없음)
모델 구성(실측 확인): 판정기(저지·프로브)는 claude-sonnet-4-6으로 고정했습니다 — 전 실행 2,145콜 전건 이 모델로 기록됐습니다(원자료 jsonl의 model 필드 실측). alias 없이 manifest에 고정 기록했고요. 이 실험을 설계·운영한 쪽은 별도 에이전트였습니다.
이 실험을 설계·운영한 에이전트 = Opus 5 — 사람과 대화하며 설계·판정·문서를 만든 쪽.
🔴 둘을 혼동하면 안 됩니다. 판정기를 일부러 더 작은 모델로 고정한 이유는 비용 때문이 아니라 재현성 때문입니다. 판정기는 수천 콜을 3판씩 돌려야 하고, 모델이 바뀌면 과거 판정과 비교가 불가능해집니다. 그래서 실행 전에 정확한 버전 ID로 못 박고 끝까지 바꾸지 않았습니다.
📋 이 실험이 남긴 규칙 6개 (재사용 가능)
레이어를 붙이기 전에 baseline 오류율부터 재라. 0%면 붙이지 마라.
검정력은 표본 크기가 아니라 결과변수의 기저율에 대해 계산하라. "N=264건 확보"는 분모일 뿐입니다. 분자가 0이면 어떤 N으로도 검정 못 합니다.
측정 도구를 고치기 전에 도구가 신호를 잡는지부터 재라. 코드 대조는 그럴듯한 가설을 주지만 판정이 아닙니다. 이 실험에서 그 가설은 실제로 틀렸습니다.
단일 실행 수치를 성능으로 보고하지 마라. LLM 판정은 재현되지 않습니다(54건 중 5건).
지표를 올릴 땐 붙이기 전에 걷어내라. 기존 히트에서 불안정분을 제거하는 쪽이 프론티어를 더 잘 밉니다.
채점 단위를 문서의 성질에 맞춰라. 회계 기준서·법령처럼 전제 조건이 붙어야 답이 확정되는 문서는 문장 하나를 고립시켜 채점하면 안 됩니다. 전제를 잘라내는 순간 멀쩡한 답이 "누락"으로 보입니다(실측: 오탐 12건 전부 이 실패 모드, 형제 문맥을 주자 9/9 뒤집힘).
참고문헌
Anthropic (2026). Verbalizable Representations Form a Global Workspace in Language Models.
Huang, J. et al. (2023). Large Language Models Cannot Self-Correct Reasoning Yet. arXiv:2310.01798
Dhuliawala, S. et al. (2023). Chain-of-Verification Reduces Hallucination in Large Language Models. arXiv:2309.11495
Madaan, A. et al. (2023). Self-Refine: Iterative Refinement with Self-Feedback. arXiv:2303.17651
Shinn, N. et al. (2023). Reflexion: Language Agents with Verbal Reinforcement Learning. arXiv:2303.11366
Manakul, P. et al. (2023). SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection. arXiv:2303.08896
Tian, K. et al. (2023). Just Ask for Calibration. arXiv:2305.14975
Xiong, M. et al. (2023). Can LLMs Express Their Uncertainty? arXiv:2306.13063
FAR.AI (2026). Obfuscation Atlas. ICML 2026 — 프로브 게이밍/정책 난독화
Morris, J. et al. (2026). How Much Do Language Models Memorize? ICML 2026
Wadden, D. et al. (2020). Fact or Fiction: Verifying Scientific Claims. EMNLP 2020, arXiv:2004.14500 — 옆방 검증 1 (SciFact)
Park, S. et al. (2021). KLUE: Korean Language Understanding Evaluation. NeurIPS 2021 D&B, arXiv:2105.09680 — 옆방 검증 2 (KLUE-NLI)
