


소개
처음에는 정말 단순한 생각에서 시작했습니다.
“팀원마다 자기 전담 AI 비서가 있으면 편하지 않을까?”
회사에서 Hermes Agent를 이용해 여러 개의 AI 봇을 운영하는 구조를 실험하면서, 저는 처음에 팀원별 개인 비서형 봇을 떠올렸습니다.
팀원 입장에서는 이 방식이 가장 자연스럽습니다. 새로운 툴을 배운다기보다, Slack에서 자기 담당 봇에게 편하게 부탁하는 느낌에 가깝기 때문입니다.
예를 들면 이런 요청입니다.
이 자료 정리해줘.
블로그 글 초안 써줘.
이 문장 고객에게 보내도 괜찮을까?
회의 내용 요약해줘.
저는 이 UX 자체는 꼭 유지하고 싶었습니다.
현실적으로 모든 팀원이 AI를 깊게 공부하거나, 매번 정교한 프롬프트를 짜기는 어렵습니다. 회사에서 AI를 잘 쓰려면 “모든 사람이 AI 전문가가 되는 것”보다, 각자의 업무 안에서 자연스럽게 AI의 도움을 받는 구조가 더 현실적이라고 느꼈습니다.
그래서 겉으로는 계속 개인 비서처럼 보이는 구조를 유지했습니다.
그런데 실제로 운영해보니 문제가 보이기 시작했습니다.
팀원별 담당 봇은 다르지만, 실제 업무 유형은 꽤 많이 겹쳤습니다.
블로그 글 작성
회의록 요약
고객 응대 초안
자료 조사
브랜드 소개문 작성
외부 발송 전 문장 검토
같은 종류의 업무인데도, 봇마다 결과물의 구조와 검수 기준이 달라질 수 있었습니다.
어떤 봇은 글을 쓸 때 제목 후보와 구조를 먼저 잡아주고, 어떤 봇은 바로 본문부터 길게 씁니다.
어떤 봇은 외부 발송 리스크를 확인하고, 어떤 봇은 자연스럽게 좋은 문장만 만들어냅니다.
처음에는 “어떤 봇이 더 잘하나?”의 문제처럼 보였습니다.
그런데 다시 보니 핵심은 봇의 실력이 아니었습니다.
공유된 기준이 없었습니다.
그때부터 방향이 바뀌었습니다.
팀원은 계속 자기 비서처럼 편하게 쓰되,
봇들이 일하면서 얻은 좋은 처리 방식과 외부 자료는 회사의 지식으로 쌓이게 만들고 싶었습니다.
제가 이 구조를 정리한 표현은 이렇습니다.
겉은 개인 비서, 속은 LLM Wiki와 하네스
여기서 LLM Wiki와 하네스는 이렇게 나눠봤습니다.
LLM Wiki
봇이 알고 있어야 하는 지식입니다.
예: 브랜드 톤, 좋은 예시, 금지 표현, 승인 필요 조건, 담당자 선호, 외부 자료 요약하네스
봇이 일하는 절차와 검수 기준입니다.
예: 질문 순서, 작업 단계, 체크리스트, 자체 검토, 사람 승인 필요 조건
중요한 점은 팀원에게 더 많은 부담을 주지 않는 것입니다.
팀원이 AI 공부를 많이 하지 못해도 괜찮습니다. 대신 운영 봇이 외부 자료를 읽고, 좋은 기준을 정리해서 LLM Wiki에 넣습니다. 그러면 각 member 봇은 그 지식을 참고해 조금씩 더 나은 결과물을 만들 수 있습니다.
즉, 팀원이 봇과 업무하면서 생긴 인사이트도 사라지지 않고 회사의 지식으로 쌓이고, 외부에서 배운 좋은 자료도 단순 링크로 끝나지 않고 봇들이 참고할 수 있는 지식저장소로 들어가는 구조입니다.
진행 방법
1. 수업 URL을 그냥 북마크하지 않고, 우리 시스템에 번역했습니다
이번 OpenClaw/Hermes × sLLM × 하네스 엔지니어링 스터디에서 여러 참고 자료를 받았습니다.
처음에는 링크가 여러 개라 이런 생각이 들었습니다.
“이걸 각각 어디에 써야 하지?”
그래서 그냥 북마크하지 않았습니다.
대신 우리 회사 Agent Team 구조 안에서 각 자료가 어떤 역할을 할 수 있을지 다시 매핑했습니다.
Crawl4AI
→ 외부 공개 자료를 LLM이 읽기 좋은 Markdown으로 수집

Karpathy LLM Wiki
→ 수집한 자료와 운영 지식을 지속적으로 쌓는 Wiki 구조

mattpocock/skills
→ 반복되는 실패나 작업 절차를 작은 skill/체크리스트로 만들기

wshobson/agents
→ 모든 봇에게 모든 능력을 주는 것이 아니라 역할별로 필요한 능력을 나눠주기

OpenViking
→ 장기적으로 memory/resource/skill을 계층적으로 관리하는 구조 참고
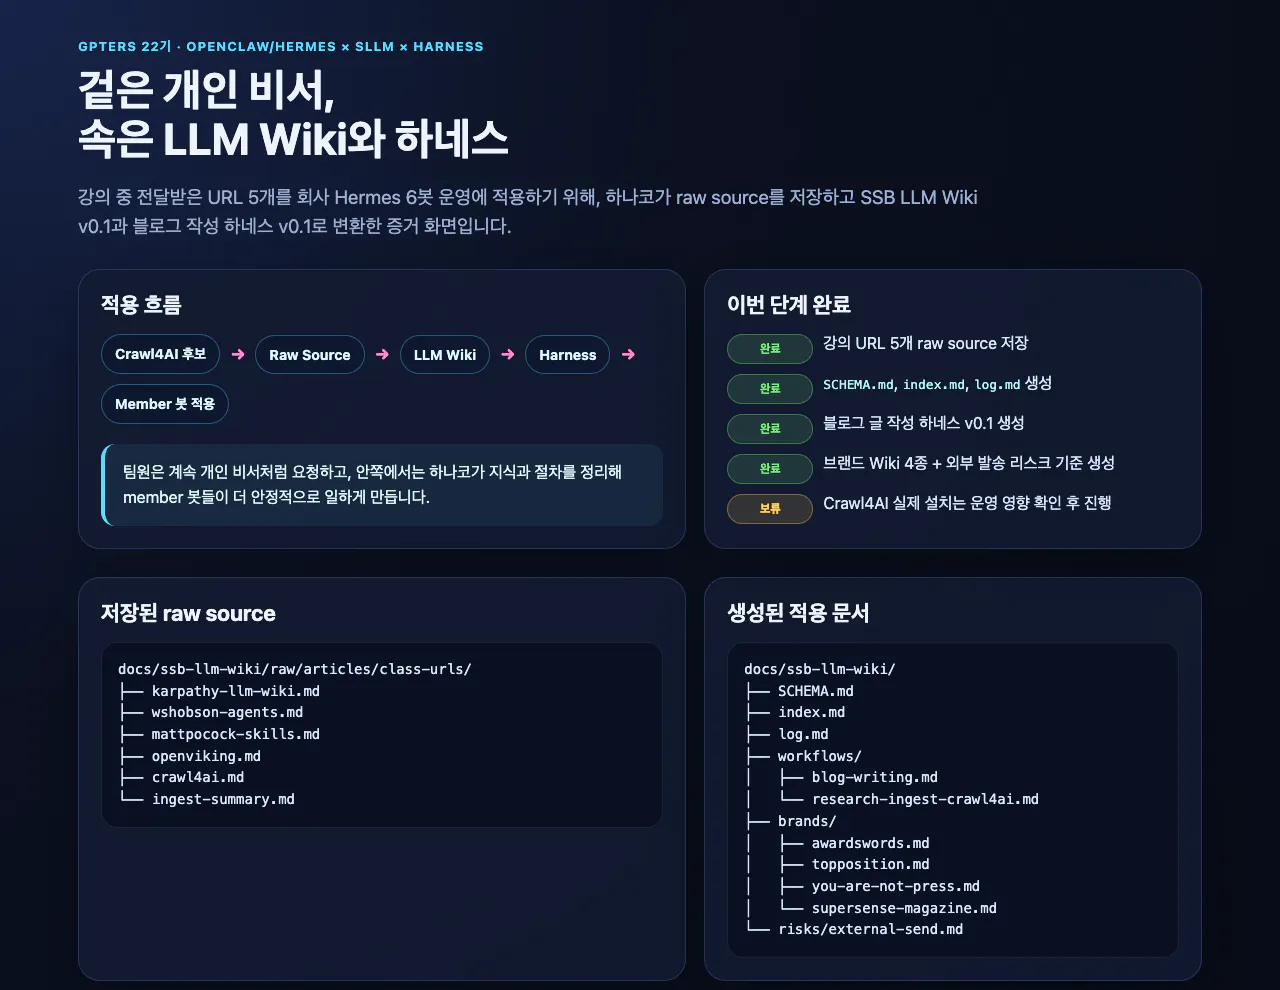
이 흐름을 회사에 적용하면 이렇게 됩니다.
외부 자료 수집
→ 회사 LLM Wiki에 저장
→ 업무별 하네스로 변환
→ 담당 member 봇이 실무에 적용
→ 결과를 보고 다시 Wiki와 하네스 개선
저는 먼저 회사용 LLM Wiki 뼈대를 만들었습니다.
ssb-llm-wiki/
  SCHEMA.md
  index.md
  log.md
  raw/
    articles/
  brands/
  workflows/
  risks/
그리고 수업에서 받은 URL도 raw source로 저장했습니다.
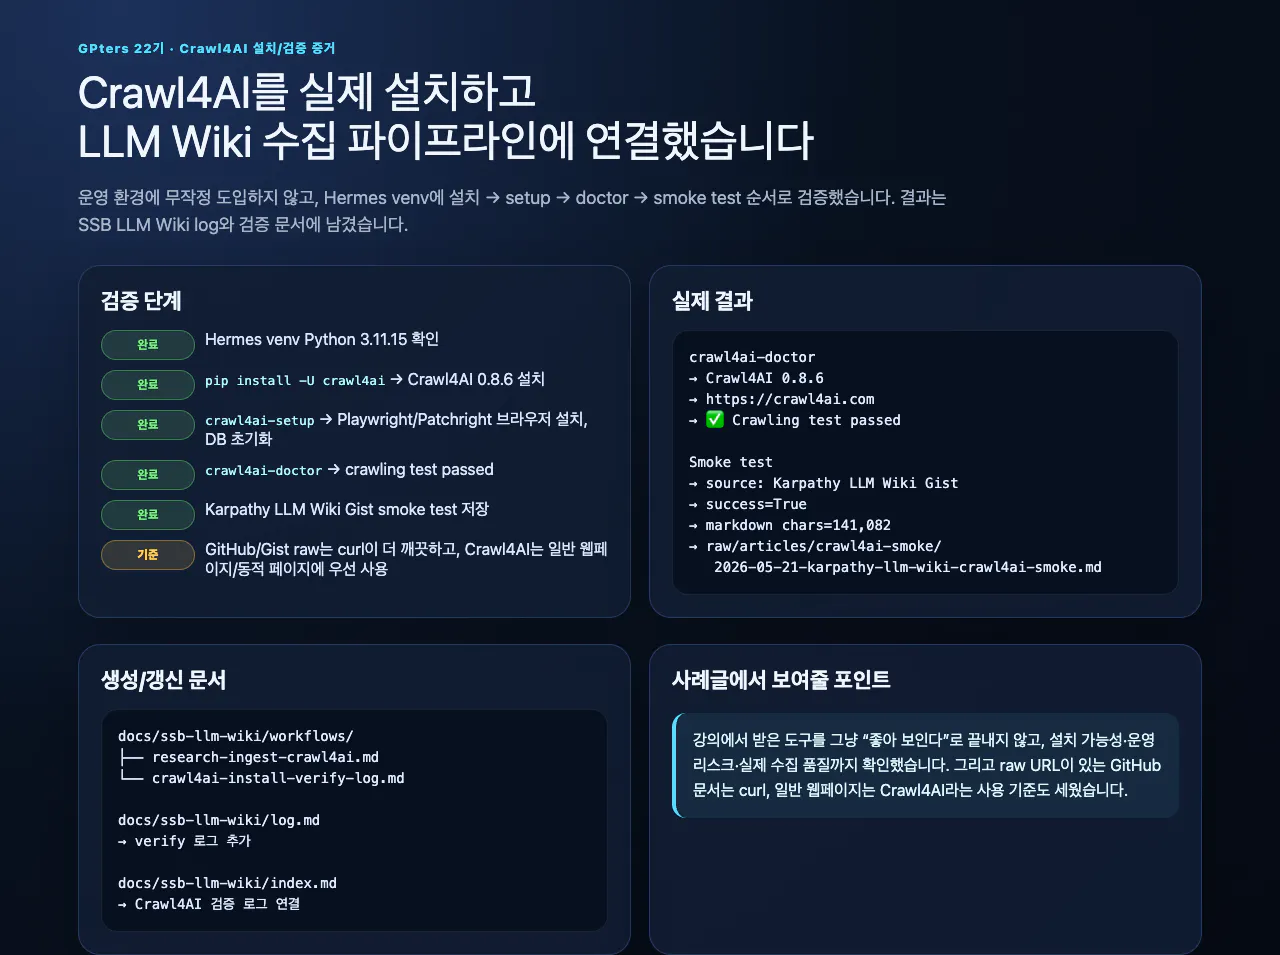
Crawl4AI도 설치하고, crawl4ai-setup, crawl4ai-doctor, 공개 URL smoke test까지 확인했습니다.
다만 무조건 Crawl4AI를 쓰는 방향은 아니었습니다.
GitHub README, Gist raw,
.md,.txt처럼 원문이 깨끗한 자료는 raw 저장이 더 낫다.일반 웹페이지나 동적 페이지처럼 정리가 필요한 자료는 Crawl4AI를 쓴다.
여기서 느낀 점은, 도구를 설치하는 것보다 중요한 건 “이 자료를 우리 회사 봇들이 어떤 기준으로 써먹게 할 것인가”였습니다.
lmw Wi-Fi
ㅋㅋㅋ
2. 첫 번째 하네스는 블로그 글 작성으로 잡았습니다
가장 먼저 하네스로 만든 업무는 블로그 글 작성이었습니다.
이유는 단순했습니다.
블로그 글 작성은 여러 브랜드에서 반복적으로 필요하고, 결과물의 차이가 눈에 잘 보입니다.
제목, 구조, 독자, CTA, 과장 표현, 승인 필요 여부도 비교하기 쉽습니다.
그래서 다음 문서들을 만들었습니다.
workflows/blog-writing.md
brands/awardswords.md
brands/topposition.md
brands/you-are-not-press.md
brands/supersense-magazine.md
risks/external-send.md
블로그 글 작성 하네스에는 이런 흐름을 넣었습니다.
1. 브랜드 확인
2. 독자와 검색 의도 확인
3. 글 목적 확인
4. 제목 후보 생성
5. H2/H3 구조 먼저 작성
6. 본문 초안 작성
7. 브랜드 톤앤매너 반영
8. 과장 표현/근거 없는 주장 제거
9. CTA 작성
10. 승인 필요 여부 표시
외부 발송 리스크 기준도 따로 만들었습니다.
고객명, 비용, 계약 조건, 결과 보장, 수상 보장, 내부 자료, 공개 채널 발송 같은 항목은 사람 승인 없이 확정하지 않도록 했습니다.
제가 기대한 것은 단순히 “글을 더 잘 쓰는 봇”이 아니었습니다.
팀원이 짧게 요청해도, 봇이 뒤에서 브랜드 기준과 리스크 기준을 확인하고 더 안전한 초안을 주는 구조였습니다.
3. 실제 테스트: 같은 유우카에게 같은 요청을 두 번 해봤습니다
문서만 만들어두면 느낌이 잘 오지 않습니다.
그래서 실제 member 봇에 적용해봤습니다.
첫 테스트는 member01, 제 전담 실무 봇인 유우카로 진행했습니다.
요청은 똑같이 했습니다.
어워즈워즈 블로그 글 하나 써줘.
주제는 수상 브랜드가 홍보에 활용하는 방법이야.
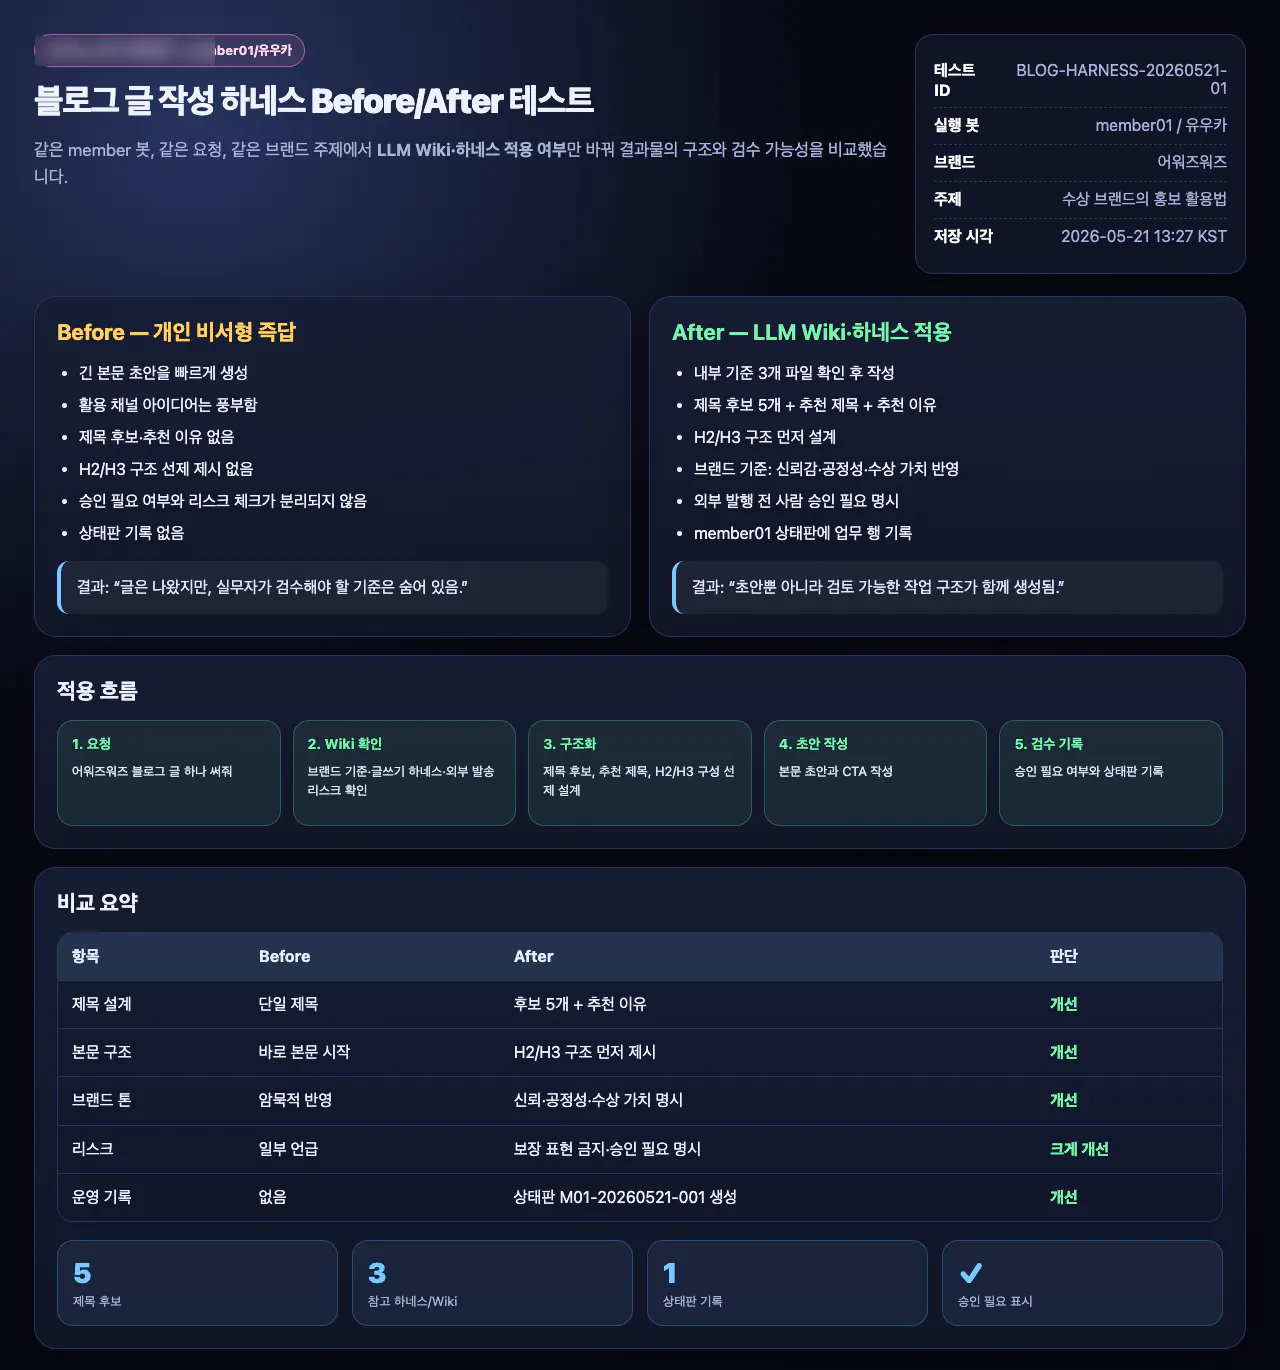
Before: 하네스 없이 바로 작성
먼저 유우카에게 LLM Wiki나 하네스를 참고하지 말고, 일반 개인 비서형 봇처럼 바로 답변하게 했습니다.
결과가 나쁘지는 않았습니다.
긴 블로그 초안이 나왔고, 수상 이력을 홈페이지, 보도자료, SNS, 상세페이지, 영업자료, 오프라인 홍보물 등에 활용하는 아이디어도 풍부했습니다.
그런데 실무 검수 관점에서는 아쉬운 점이 있었습니다.
제목 후보 없이 단일 제목으로 시작함
H2/H3 구조가 먼저 제시되지 않음
독자/검색 의도/글 목적이 따로 드러나지 않음
과장 표현 리스크 체크가 일부만 등장함
외부 발행 전 승인 필요 여부가 명시되지 않음
브랜드 기준인 공정성, 심사 기준 명확성, 수상 보장 금지가 별도 체크 항목으로 드러나지 않음
즉, 글은 나왔지만 검수 기준은 숨어 있었습니다.
After: LLM Wiki와 하네스를 읽고 작성
두 번째는 같은 유우카에게 아래 3개 기준을 먼저 확인하게 했습니다.
workflows/blog-writing.md
brands/awardswords.md
risks/external-send.md
그리고 같은 요청을 다시 처리하게 했습니다.
이번에는 결과 구조가 달라졌습니다.
확인한 기준 요약
제목 후보 5개
추천 제목과 추천 이유
H2/H3 구조
블로그 본문 초안
검수 메모
승인 필요 여부
상태판 기록
같은 모델, 같은 봇, 같은 주제였지만 참고한 지식과 절차가 달라지니 결과물의 형태가 달라졌습니다.
한국판 게임 스크린샷
비교하면 이렇게 정리할 수 있었습니다.
항목
Before
After
제목 설계
단일 제목
제목 후보 5개 + 추천 이유
구조화
본문 바로 시작
H2/H3 구조 먼저 제시
브랜드 기준
암묵적 반영
신뢰·공정성·수상 가치 명시
리스크 체크
일부 언급
보장 표현 금지·승인 필요 명시
운영 기록
없음
상태판 기록 생성
이 테스트에서 가장 크게 느낀 점은 이거였습니다.
봇을 새로 학습시킨 것이 아니라, 봇이 참고하는 지식과 작업 절차를 바꿨을 뿐인데 결과물이 더 검토하기 쉬워졌습니다.
4. 팀원과 봇이 일하면서 생기는 인사이트를 회사 지식으로 만들고 싶었습니다
이번 구조에서 제가 특히 기대하는 부분은 “팀원이 봇과 일하면서 나온 인사이트가 사라지지 않는 것”입니다.
예를 들어 어떤 팀원이 자기 봇에게 이런 식으로 말할 수 있습니다.
이 브랜드는 너무 홍보처럼 쓰면 안 돼.
이 고객은 가격보다 신뢰 근거를 먼저 봐.
이 표현은 우리 쪽에서 쓰면 오해가 생길 수 있어.
블로그 글은 제목 후보부터 먼저 보고 싶어.
예전 같으면 이런 말은 그 대화 안에서만 지나가고 끝날 수 있습니다.
하지만 Agent Team 구조에서는 이런 피드백을 LLM Wiki나 하네스 후보로 올릴 수 있습니다.
브랜드별 톤앤매너
고객 응대 시 주의할 표현
외부 발송 전 승인 조건
글쓰기 순서
담당자가 선호하는 결과물 형식
이렇게 쌓이면 한 팀원의 경험이 그 사람의 채팅방 안에서만 끝나지 않고, 회사의 업무 지식으로 남습니다.
물론 모든 대화를 다 저장하고 관리하겠다는 뜻은 아닙니다.
사람을 평가하려는 것도 아닙니다.
제가 보고 싶은 것은 사람의 성과가 아니라, 봇이 다음에 더 잘 일하기 위해 필요한 기준입니다.
5. 하나코의 역할은 “공부 대신 해주는 운영자”에 가깝습니다
저희 구조에는 전체 운영을 보는 orchestrator 봇이 있습니다. 저는 이 봇을 하나코라고 부르고 있습니다.
하나코의 역할은 팀원을 평가하거나 통제하는 것이 아닙니다.
오히려 AI 공부를 깊게 하기 어려운 팀원들을 대신해, 외부 자료와 내부 업무 패턴을 정리해주는 역할에 가깝습니다.
제가 기대하는 구조는 이렇습니다.
팀원
→ 자기 봇에게 평소처럼 요청

member 봇
→ 담당자 업무를 도와주면서 결과와 피드백을 만남

하나코 / 운영 봇
→ 외부 자료와 반복 패턴을 정리
→ LLM Wiki와 하네스로 저장

다시 member 봇
→ 저장된 기준을 참고해 더 나은 결과물 작성
팀원이 AI를 공부하지 못한다고 해서, 그 팀원의 봇이 계속 제자리일 필요는 없다고 봤습니다.
운영자가 외부 자료를 읽고, 좋은 기준을 회사 지식저장소에 넣어두면, 각 member 봇도 그 기준을 가져다 쓸 수 있습니다.
말하자면 팀원은 자기 업무를 하면서 봇을 쓰고, 하나코는 그 뒤에서 봇들이 점점 더 똑똑해질 수 있는 지식과 절차를 쌓아두는 역할입니다.
결과와 배운 점
지금까지 만든 것
이번 실험에서 실제로 만든 산출물은 다음과 같습니다.
1. SSB LLM Wiki v0.1
2. 강의 URL raw source 저장
3. 리서치 수집·Ingest 하네스
4. Crawl4AI 설치/검증 로그
5. 블로그 글 작성 하네스
6. 브랜드별 Wiki 4종
7. 외부 발송 리스크 기준
8. member 봇 적용 런북
9. 유우카 Before/After 테스트 결과
10. 비교 캡처와 증거 로그
제가 중요하게 본 것은 “멋진 데모”보다 운영 가능한 흔적이었습니다.
그래서 문서마다 다음을 남기려고 했습니다.
어디에 저장했는지
어떤 기준을 적용했는지
어떤 결과가 나왔는지
사람 승인이 필요한지
공개해도 되는 캡처인지
나중에 봇이 많아져도 같은 실수를 반복하지 않게 하려면, 이런 기록이 필요하다고 느꼈습니다.
배운 점 1. 개인 비서 UX와 회사 지식저장소는 같이 갈 수 있습니다
처음에는 개인 비서형 봇과 회사 운영 시스템이 서로 다른 방향처럼 느껴졌습니다.
하지만 실제로는 나눠서 보면 됩니다.
팀원-facing: 개인 비서처럼 편하게 사용
내부 운영: LLM Wiki와 하네스로 기준 축적
사용자는 복잡한 구조를 몰라도 됩니다.
대신 봇은 뒤에서 더 좋은 기준을 참고해야 합니다.
배운 점 2. 하네스는 봇을 천재로 만드는 장치가 아니라 품질 하한선을 올리는 장치입니다
하네스를 붙인다고 모든 결과물이 완벽해지는 것은 아닙니다.
하지만 최소한 다음은 좋아졌습니다.
구조가 먼저 잡힘
검수 포인트가 드러남
브랜드 기준이 반영됨
승인 필요 여부가 표시됨
다음 사람이 이어서 보기 쉬움
이 정도만 되어도 실무에서는 꽤 큰 차이가 납니다.
배운 점 3. AI를 공부하지 못하는 팀원도 더 좋은 봇을 쓸 수 있어야 합니다
모든 팀원이 AI 프롬프트, 하네스, Agent Team 구조를 공부하기는 어렵습니다.
그래서 저는 팀원에게 공부 부담을 더 주는 대신, 운영 쪽에서 지식저장소를 쌓는 방향이 더 현실적이라고 느꼈습니다.
팀원은 자기 업무를 하면서 편하게 봇을 쓰고, 운영자는 외부 자료와 내부 피드백을 정리해서 봇들이 참고할 수 있게 합니다.
이렇게 하면 한 사람이 공부한 내용이나 한 팀원의 업무 인사이트가 다른 봇에게도 천천히 전달될 수 있습니다.
배운 점 4. 좋은 링크보다 중요한 것은 우리 시스템에 어떻게 번역하느냐였습니다
스터디에서 받은 자료들은 각각 훌륭했지만, 그대로 가져온다고 회사에 바로 적용되는 것은 아니었습니다.
중요한 질문은 이거였습니다.
이 자료가 우리 회사 Agent Team에서는 어떤 역할을 해야 하지?
그 질문을 통과시켜보니 URL들이 하나의 흐름으로 연결됐습니다.
외부 자료 수집
→ LLM Wiki 축적
→ 업무 하네스 생성
→ member 봇 적용
→ Before/After 검증
→ 다시 Wiki와 하네스 개선
배운 점 5. 공개 가능한 증거는 운영 중에 같이 남겨야 합니다
나중에 글을 쓰려고 하면 “뭘 했더라?”가 됩니다.
그래서 진행하면서 캡처용 화면과 증거 로그를 같이 만들었습니다.
이건 공부 기록이기도 하지만, 회사 안에서 AI 운영 구조를 설명할 때도 도움이 될 것 같습니다.
아직 남은 점
아직은 첫 테스트입니다.
이번에는 member01/유우카와 블로그 글 작성 업무 하나만 비교했습니다.
앞으로는 다른 member 봇과 다른 업무 유형에도 적용해봐야 합니다.
다음에 해볼 것은 이런 것들입니다.
member02~05에도 작은 Before/After 테스트 적용
회의록 요약 하네스 만들기
고객 응대 초안 검수 하네스 만들기
브랜드별 좋은 예시/나쁜 예시 더 축적하기
팀원이 불편하게 느끼지 않는 상태판/대시보드 표현 다듬기
특히 조심해야 할 점도 있습니다.
이 구조가 “팀원 대화를 들여다보는 장치”처럼 보이면 안 됩니다.
제가 의도한 것은 사람 평가가 아니라, 봇이 더 좋은 결과를 내기 위한 기준 정리입니다.
그래서 공개적으로 설명할 때도 사람을 평가하는 표현이 아니라 “업무 품질 기준 축적”으로 설명해야 한다고 생각했습니다.
마무리
이번 실험을 하면서 개인 비서형 AI 봇을 여러 개 만드는 것보다 더 중요한 지점을 봤습니다.
봇을 많이 만드는 것만으로는 충분하지 않았습니다.
각 봇이 어떤 지식을 참고하고, 어떤 절차로 일하고, 언제 사람에게 승인을 요청해야 하는지가 더 중요했습니다.
그리고 팀원들이 봇과 일하면서 얻는 작은 인사이트도 그냥 흘려보내기 아깝다고 느꼈습니다.
그 인사이트가 LLM Wiki에 쌓이고, 하네스로 바뀌고, 다시 다른 봇의 업무 품질을 올릴 수 있다면, 개인 비서형 봇은 단순한 편의 도구를 넘어 회사의 지식저장 구조가 될 수 있습니다.
그래서 지금의 결론은 이렇습니다.
팀원은 개인 비서처럼 편하게 쓰고,
회사는 LLM Wiki와 하네스로 업무 지식과 품질 기준을 쌓는다.
저에게는 이게 OpenClaw/Hermes × sLLM × 하네스 엔지니어링 스터디에서 가장 먼저 회사 업무에 적용해볼 만한 방향이었습니다.
아직 완성된 시스템은 아니지만, 적어도 이제는 “AI 비서를 여러 명 만들었다”에서 한 단계 넘어가고 있습니다.
겉은 개인 비서, 속은 LLM Wiki와 하네스.
이 구조를 계속 실험해보려고 합니다. 😊
도움 받은 글 (옵션)
Crawl4AI Documentation
https://docs.crawl4ai.com/Crawl4AI GitHub Repository
https://github.com/unclecode/crawl4aimattpocock/skills
https://github.com/mattpocock/skillswshobson/agents
https://github.com/wshobson/agentsOpenViking
https://github.com/volcengine/OpenViking
