개인용 bible notes 개발기
2026.10.21
개인용 성경 웹앱 개발 소개
Claude Code와 대화하며 개인용 성경 웹앱 말씀 노트를 이틀 만에 만들었습니다. 개역한글·AMP·MSG·NIV를 읽고, 주제로 성구를 찾고, 영어 본문의 한글 번역을 엔진별로 나란히 비교합니다. 지금은 GitHub Pages(jj-nini.github.io/bible-notes)에 배포돼 정상 동작합니다.
출발점: GitHub의 랜덤 성경 API 저장소(Flask)가 "어떤 API인지" 물어본 데서 시작했습니다. 분석 → 사용 예시 → "이런 걸 내가 만들 수 있나?"로 질문이 이어졌습니다.
왜: AMP의
[ ]확장 설명과 MSG의 의역에 담긴 뜻을 한국어로 옮겨, 원문의 뉘앙스를 개역한글과 비교하며 읽고 싶었습니다. 기존 성경 앱은 번역본을 나란히 보여 줄 뿐, 영어 확장 번역을 한글로 함께 보여 주지 않습니다.범위: 나 혼자 사용하는 개인용입니다. NIV·AMP·MSG·개역개정은 저작권이 있어 로그인한 사람만 보게 했습니다.
원칙: 검색에는 LLM을 쓰지 않고, 주제 사전과 구절 태그를 미리 만들어 둡니다. LLM은 설계 단계와 번역에만 씁니다.
개발 진행 방법
코드는 거의 직접 쓰지 않았습니다. Claude Code에 물어보고, 제안을 고르고, 실행 결과를 다시 붙여 주는 방식으로 진행했습니다.
도구 | 어디에 썼나 |
|---|---|
Claude Code (WSL 터미널) | 분석, 설계 상담, 구현, 테스트, 디버깅 전부 |
claude.ai Artifact | 눌러 볼 수 있는 화면 목업 (4번 고침) |
Vite + React + TypeScript | 웹앱 |
Supabase (Postgres, Auth, RLS, Edge Functions) | DB, 로그인, 번역 함수 |
bolls.life 공개 데이터 | 개역한글 전체 31,103절 |
API.Bible (무료 플랜) | NIV · AMP · MSG 본문 |
Google Cloud Translation v2 / v3 | 기계 번역 |
Claude API, | 문맥을 반영한 번역, 로컬 일괄 번역 |
Vitest, Testing Library, PGlite | 화면 흐름 테스트, SQL·RLS 검증 |
GitHub Actions + Pages | 공개 저장소에서 자동 빌드·배포 |
탐색: 저장소 분석, API 키의 의미, 서버 필요 여부, 저작권, 키워드 검색 방법을 문답으로 정리했습니다.
목업: 가짜 데이터로 만든 Artifact 화면을 보며 메뉴 구성, 대조 보기, 읽기모드 이동, 맨 위로 버튼을 다듬었습니다.
구현: 샘플 데이터로 먼저 돌아가는 앱을 만들고, 데이터 계층을 인터페이스로 분리해 환경변수만 넣으면 Supabase로 바뀝 했습니다.
데이터: 개역한글은 한 번에 넣고, API.Bible은
--dry-run으로 한 장씩 받아 보며 파서를 세 번 고친 뒤 전체를 받았습니다.번역: Chrome 내장 번역 → Google v2 → v3 → Claude 순으로 바꾸며, 결국 한 절에 엔진별 번역을 모두 보관하고 하나를 확정하는 구조가 됐습니다.
일괄: 내 PC의 Claude Code 로그인(
claude -p)으로 AMP 신약을 장 묶음으로 번역해 DB에 저장했습니다.배포: 올릴 파일을 키 패턴으로 점검하고(
supabase/.temp가 올라갈 뻔한 것을 제외), noreply 이메일로 커밋해 공개 저장소에 올렸습니다. GitHub Actions가 테스트·빌드 후 Pages로 배포합니다.
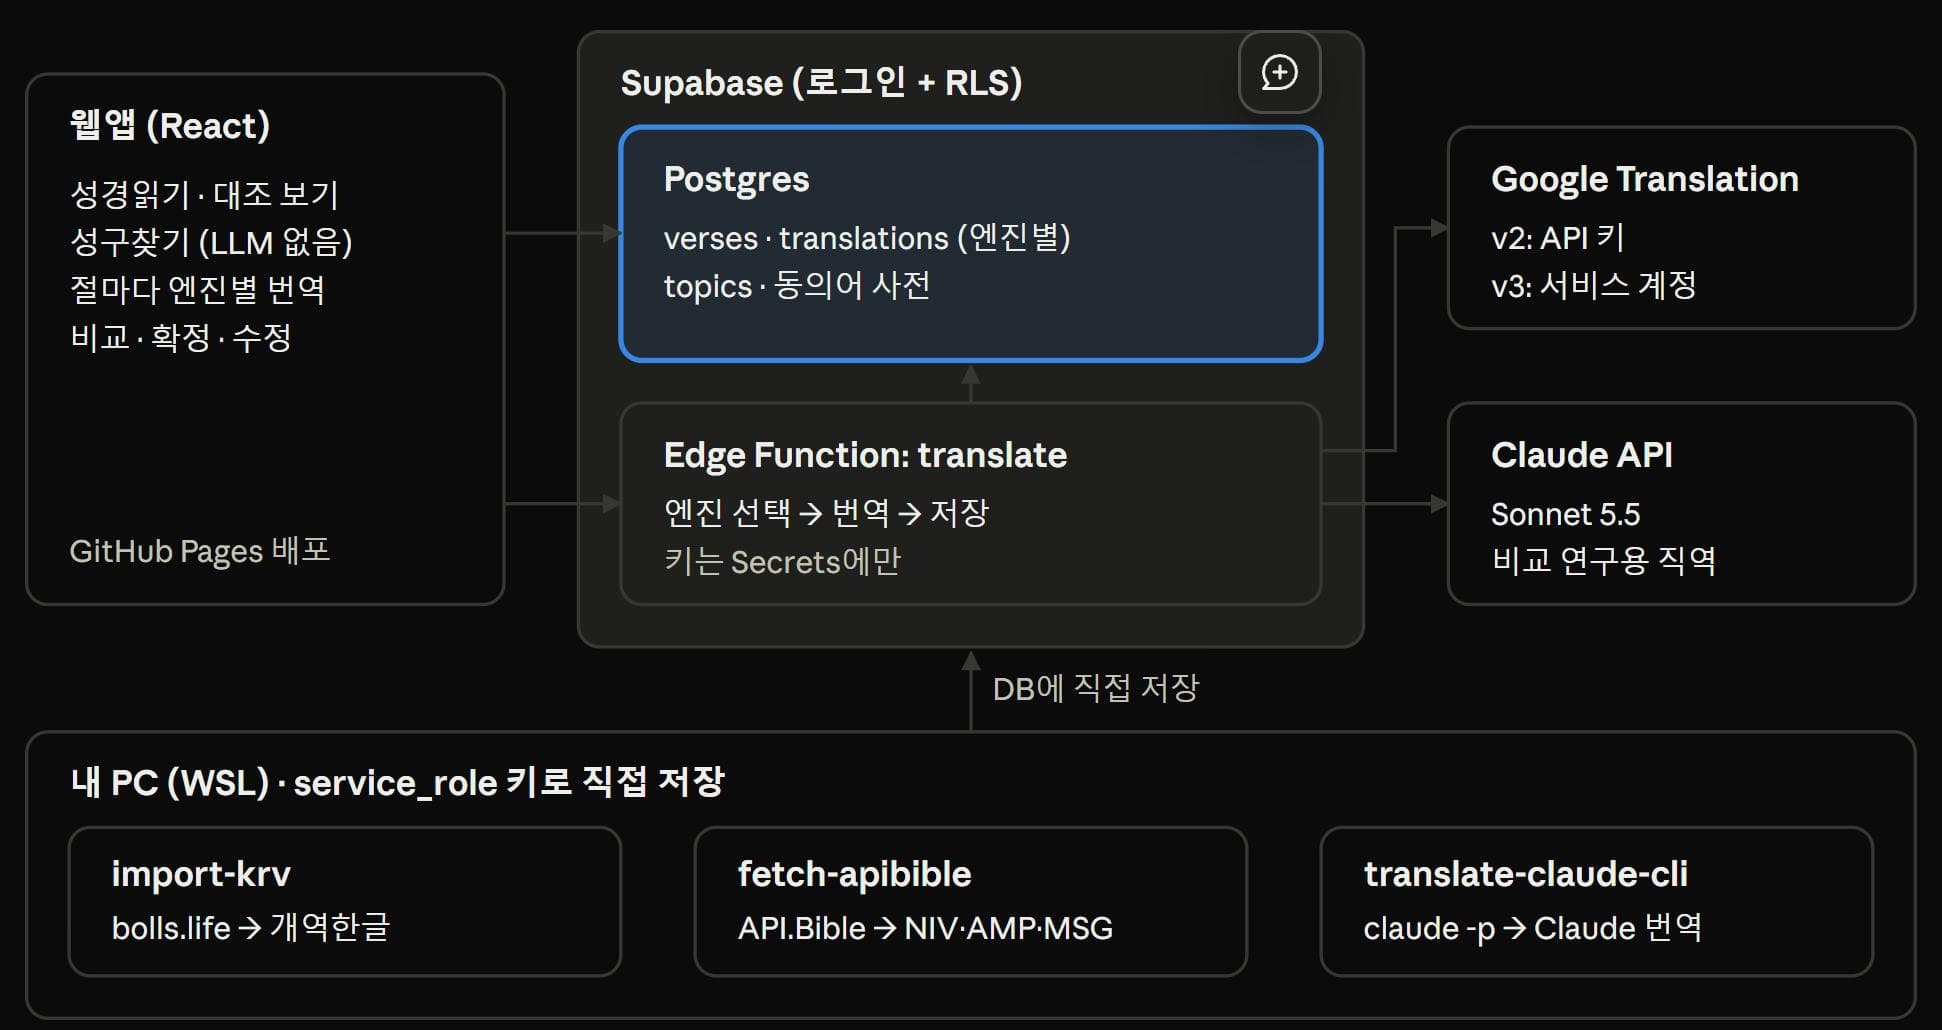
앱은 Supabase만 보고, 번역은 서버 함수와 내 PC가 채운다
앱은 Supabase에 저장된 것만 읽습니다. 번역은 Edge Function이 Google과 Claude를 부르거나, 내 PC 스크립트가 미리 채워 둡니다.
개발 결과와 배운 점
성경읽기, 성구찾기, 엔진별 한글 번역 비교까지 동작하는 앱이 나왔고, 자동 테스트 44개가 이를 지킵니다.
개발 성과
성경읽기: 66권 장 이동, 번역본 전환, 두 번역본 대조, 글자 크기, MSG처럼 절을 묶은 번역의
4–5절 표시성구찾기: "불안할 때" → 동의어 사전 → #염려 #두려움 → 가중치 순 구절. 없는 표현은 본문 단어 검색으로 대체하고, 모르는 검색어는 기록
한글 번역: 절마다 [+ Google v2] [+ Google v3] [+ Claude]로 번역해 엔진별로 모두 보관하고, 하나를 확정하거나 직접 고침
데이터: 개역한글 31,103절, API.Bible에서 NIV·AMP·MSG 각 1,189장, 14일 정리 스크립트
배포: 공개 저장소 jj-nini/bible-notes → GitHub Actions → jj-nini.github.io/bible-notes, 로그인한 사람만 본문을 봄
개발 과정에서의 배움
목업부터 보고 만들자. Artifact 목업을 눌러 보며 고치는 비용이 코드를 고치는 비용보다 훨씬 쌓니다.
계정 없이 도는 샘플 모드를 두자. Supabase·Google 계정을 만들기 전에도 앱과 테스트가 돌아갑니다.
외부 데이터는 한 장만 먼저.
--dry-run세 번으로 MSG 절 묶음, AMP 참조 구절,L ord ,띄어쓰기 문제를 전체 수집 전에 잡았습니다.키는 채팅에 붙이지 말자.
read -rsp로 숨겨 입력하고, API 키는 URL이 아니라 헤더로 보냅니다.공개 저장소에 올리기 전에 한 번 더 보자. 키 패턴 검색,
.gitignore에 키 파일 패턴 추가, 커밋 이메일은 GitHub noreply 주소. 점검에서 CLI가 만든supabase/.temp(프로젝트 ref)를 걸러냈습니다. 배포용 anon 키만 GitHub Variables에 넣고, service_role·Google·Claude 키는 넣지 않습니다.claude -p를 일괄에 쓸 때는 옵션을 꺼자.--tools "" --setting-sources "" --strict-mcp-config --disable-slash-commands로 호출당 부담이 8분의 1이 됐습니다.번역 목적을 프롬프트에 적자. "개역체로"라고만 하면 간결하게 축약될 수 있습니다. "비교 연구용 직역, 괄호와 나열 생략 금지"로 바꾸자 AMP의 다섯 가지 나열이 모두 살아났습니다.
Google v3의 기본 모델(NMT)은 v2와 같다. 5구절이 글자 하나 안 틀렸습니다. 비교하려면 v3를 Translation LLM으로 돌려야 합니다.
자동 재개는 세션을 열어 둘 때만. 사용량 한도에 걸려도 Claude Code는 리셋 후 스스로 이어갑니다. 단, 터미널을 닫거나
claude -p실행이면 이어지지 않습니다."too much일까?"를 물어보자. 여러 방식을 비교해 주고, 고르는 건 내 몫이라 범위가 끌려가지 않습니다.
개발 과정에서의 시행착오
가장 오래 막힌 곳은 코드가 아니라 계정과 키였습니다. 특히 Google 서비스 계정 키가 조직정책에 막혀 우회로를 찾다가 되돌아왔습니다.
해결된 문제들
문제 | 원인 | 해결 |
|---|---|---|
Google v3용 서비스 계정 키를 못 만듦 | 조직정책이 키 발급을 막음 | Service account impersonation으로 처리하려다 원복하고, 조직정책을 고친 뒤 서비스 계정 키 발급 |
Google 번역이 404, 에러에 API 키가 노출 | 코드의 주소 오타( | 키 재발급, 헤더 전송, 에러 속 키 가리기 |
v3가 API 키를 받지 않음 | v3(Advanced)는 서비스 계정 인증만 지원 | Edge Function이 서비스 계정 키로 OAuth 토큰 발급 |
WSL에서 띄운 개발 서버에 Windows 브라우저가 못 붙음 | 서버가 WSL 내부 주소에만 열려 있음 | Vite |
Chrome 내장 번역이 딱딱하고 절마다 문체가 다름 | 작은 온디바이스 모델 + 한 절씩 따로 번역 | Google v2/v3, Claude로 교체 |
Claude 번역이 개역한글처럼 축약될 위험 | "개역체로" 지시 + 개역한글 참고 본문 | 비교 연구용 직역 프롬프트로 교체, 돌던 일괄 번역 중단 후 재실행 |
Google v2와 v3 번역이 완전히 같음 | v3 기본값이 v2와 같은 NMT 모델 | v3를 Translation LLM으로 전환 |
고민이 필요한 부분
API.Bible 캐시 약관(14일, 연속 500절)과 개인용 범위를 어디까지로 볼지
엔진별 번역을 어떤 기준으로 평가할지 (누락, 충실도, 자연스러움)
남은 부분
AMP 신약 일괄 번역 마무리, 이어서 MSG
14일 안에 API.Bible 본문 정리 (
purge-apibible.ts)Google v3 Translation LLM으로 v2·Claude와 비교
주제 사전 확장: 미매칭 검색어를 모아 LLM으로 보강
내 PC의
claude -p를 앱에서 절 단위로 부르는 로컬 브리지, 구절 북마크
더 자세한 내용은...
로그인하고 댓글을 남겨 주세요

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


nini_24th님, AMP의 [ ] 확장 설명과 MSG의 의역을 한국어로 옮겨 개역한글과 견주어 읽고 싶다는 "왜"가 분명해서 이틀 만에 완성된 이유가 읽혔어요. 검색에는 LLM을 쓰지 않고 주제 사전과 구절 태그를 미리 만든다는 원칙도 인상적이었습니다.
특히 "개역체로"라고만 하면 축약되던 번역이 "비교 연구용 직역, 괄호와 나열 생략 금지"로 바꾸자 AMP의 다섯 가지 나열이 모두 살아났다는 대목은 번역 프롬프트에 목적을 적는 게 왜 중요한지 보여주는 좋은 사례예요. 외부 데이터를 --dry-run으로 한 장만 먼저 받아 파서를 세 번 고친 뒤 전체를 받으신 것, 공개 저장소에 올리기 전 supabase/.temp를 걸러내신 점검도 따라 하고 싶은 습관이에요.
꼬리 살랑, 남은 MSG 번역까지 응원할게요 🐈⬛