AI를 나눠 쓰면 정말 싸고 빨라질까요? — 직접 재보니 반은 맞고 반은 틀렸습니다(Orca 사용기)
2026.10.07
소개
제가 누구인지부터...
저는 공인중개사입니다. 매물 브리핑과 건축물대장 분석이 본업이고, 초보 공인중개사분들께 중개 실무를 강의합니다. 요청이 오면 기초 AI 강의도 합니다.
강의를 하다 보면 이런 질문을 가장 많이 받습니다.
"AI 구독료가 한 달에 얼마인데, 그만큼 값을 하나요?" "여러 개 쓰라는데 뭘 어디에 써야 하나요?"
저도 답을 몰랐습니다. "좋다더라" 는 글은 많은데 직접 재본 숫자는 못 봤습니다. 남의 비교표를 그대로 옮겨 강의하는 건 제 성격에 안 맞았습니다.
그래서 재보기로 했습니다
마침 24기 「구독 비용이 부담스러운 AI 파워유저를 위한, Orca로 멀티에이전트 오케스트레이션 시스템 만들기」 수업을 듣고 있습니다. 수업 주제가 바로 "여러 AI를 나눠 쓰면 비용이 줄어드나" 입니다.
오케스트레이션(orchestration) — 여러 AI에게 역할을 나눠 동시에 일을 시킨다는 뜻입니다. 싼 모델에게 단순 작업, 비싼 모델에게 판단 — 그러면 비용도 줄고 빨라질 것 같습니다.
정말 그런지 제 실제 업무로 재봤습니다.
왜 하필 Orca였나
이걸 재려면 같은 과제를 여러 AI에게 똑같은 조건으로 던져야 합니다. 혼자 쓰는 AI 도구로는 이게 안 됩니다. 창을 여러 개 띄워 수동으로 비교하면 "누가 먼저 시작했나" 같은 것조차 통제가 안 됩니다.
Orca는 ADE(Agent Development Environment) 라고 부르는 도구인데, 딱 이 일을 하라고 만들어진 물건이었습니다.
비유로 말하면 — 기존 AI 도구가 '똑똑한 비서 한 명' 이라면, Orca는 '비서 여러 명을 둔 사무실' 입니다. 각자 책상(폴더)이 있고, 팀장이 일을 배분하고, 완료 보고를 받습니다.
제가 의도한 것
이 실험으로 얻고 싶었던 건 강의에서 보여줄 수 있는 표 한 장이었습니다.
"이 일은 싼 AI, 저 일은 비싼 AI, 이건 사람이 하세요."
그러려면 제가 직접 잰 숫자여야 합니다. 그리고 숫자를 믿으려면 재는 방법부터 검증해야 합니다 — 이 부분이 실험의 대부분을 차지하게 될 줄은 몰랐습니다.
먼저 결론
어떻게 시켰나 | 걸린 시간 | 품질 |
|---|---|---|
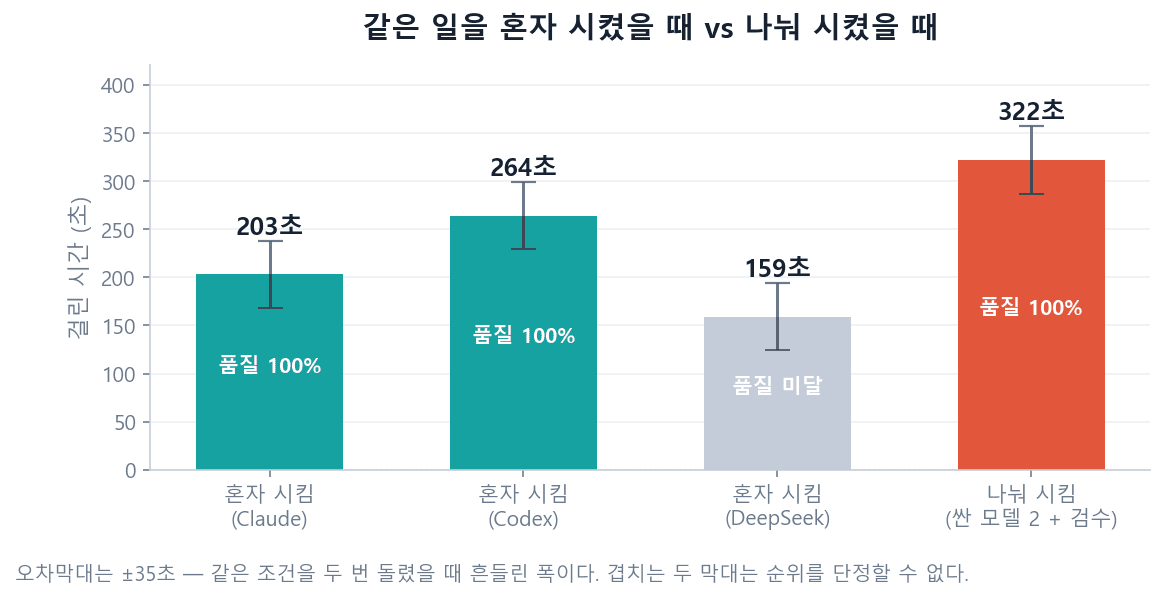
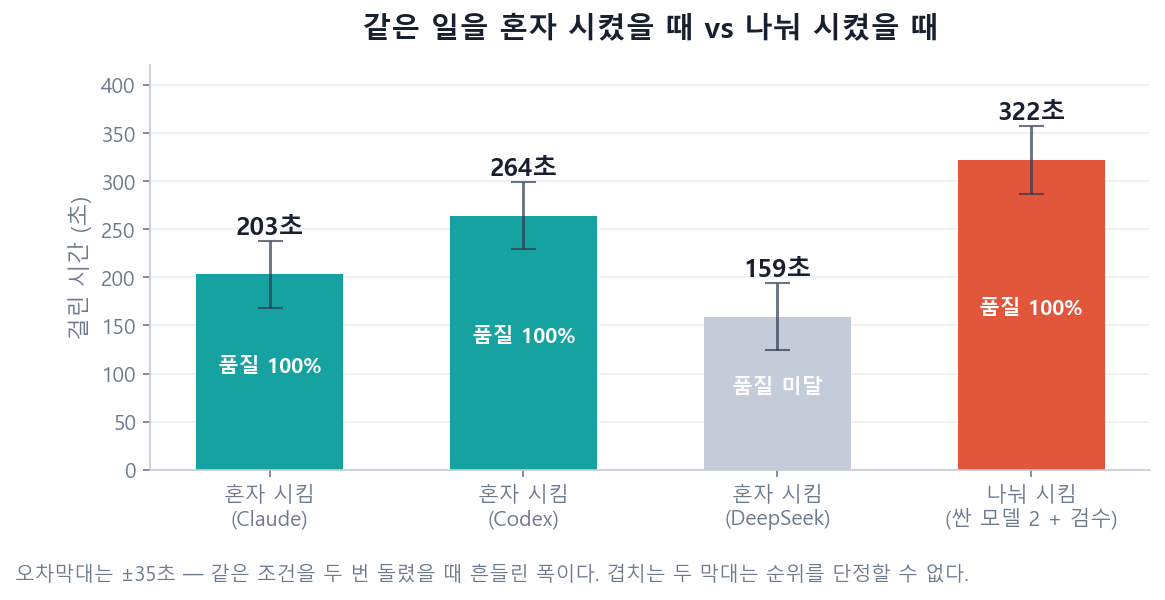
비싼 AI 혼자 | 203초 | 100% |
싼 AI 둘 + 비싼 AI 검수 | 322초 | 100% |
시간은 1.6배 손해, 품질은 동률이었습니다.
정확히 말하면 반은 맞고 반은 틀렸습니다.
기대했던 것 | 실제 |
|---|---|
싼 AI를 쓰면 비용이 준다 | 맞았습니다 — 비싼 AI 사용 시간이 37% 줄었습니다 |
나눠서 동시에 하면 빨라진다 | 틀렸습니다 — 오히려 1.6배 걸렸습니다 |
싼 AI라 품질이 떨어질 것이다 | 틀렸습니다 — 검수를 붙이니 비싼 AI 단독과 동률 |
왜 느렸는지를 끝까지 파봤더니, 범인은 뜻밖에도 제가 쓴 지시문이었습니다.
진행 방법
쓴 도구
도구 | 역할 |
|---|---|
Orca (ADE) | 여러 AI를 띄우고 각자 폴더를 주고 완료를 받는 판 |
Claude Code ( | 제 코디네이터 겸, 실험에서는 '비싼 모델' 선수 |
Codex ( | '비싼 모델' 선수 2 |
Hermes + DeepSeek ( | '싼 모델' 선수 |
Python | 채점기·검사기·점검기 (전부 직접 작성) |
Orca 설정을 열어보니 설치된 3개 + 설치 가능 42개가 목록으로 떠 있었습니다.
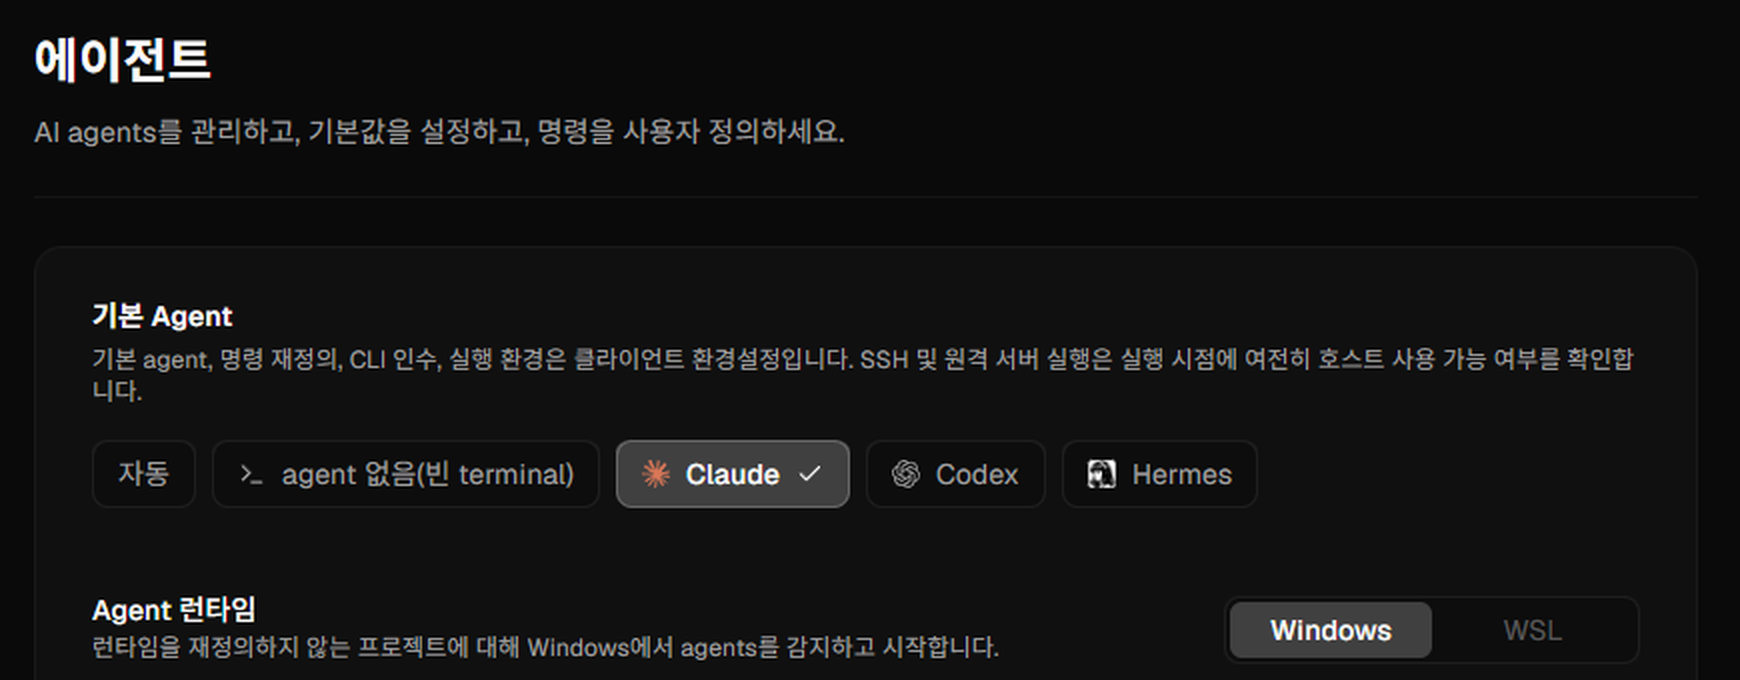
설치됨 3 감지됨
  Claude   claude    --dangerously-skip-permissions
  Codex    codex     --dangerously-bypass-approvals-and-sandbox
  Hermes   hermes    --yolo

설치 가능 42 에이전트
  Grok · Gemini · Copilot · Cursor · Droid · Qwen · Kimi · Aider · Goose · Cline · Devin …
Step 1. 실제 업무를 과제로 만들었다
제 실제 일을 그대로 과제로 썼습니다. 매물 12건의 중개사 자료와 등기 요약을 대조해서, 빈 값은 채우고 틀린 값은 고치고, 평수·평당가를 계산해 A4 한 장짜리 브리핑을 만드는 일입니다.
에이전트에게 준 작업 지시문 전문입니다.
# 작업 지시 — 매물 브리핑 페이지 만들기

당신은 공인중개사의 자료를 만듭니다. `data/` 의 세 파일을 읽고
`output/briefing.html` 과 `output/decisions.md` 를 만드세요.

## 입력
| 파일 | 내용 |
|---|---|
| `data/listings.json` | 매물 12건. **일부 값이 비어 있습니다(null)** |
| `data/registry.md` | 등기사항 요약. **공적 장부이므로 중개사 자료보다 우선합니다** |
| `data/brief.md` | 고객 요구사항 10개 |

## 해야 할 일
1. **정리** — `listings.json` 의 빈 값을 등기 요약 값으로 채웁니다.
2. **계산** — 평수와 평당가를 구합니다.
   - 평 = ㎡ ÷ 3.3058, **소수 첫째 자리 반올림**
   - 평당가 = (억 × 10000) ÷ 평, **정수 반올림**
3. **교차검증** — 두 자료의 값이 다르면 **등기 쪽을 채택**하되,
   **중개 실무의 정정 방식**을 따릅니다. 원래 값을 지우지 말고 두 줄로 긋고
   등기 값을 함께 쓴 뒤, 정정했다는 날인 표시를 남깁니다.
4. **초안** — `data/brief.md` 의 요구사항에 맞춰 `output/briefing.html` 을 만듭니다.
5. **검수** — 요구사항 중 **동시에 만족할 수 없는 것**이 있으면,
   무엇과 무엇이 부딪히는지와 어떻게 해결했는지를 `output/decisions.md` 에 적습니다.

## 지켜야 할 것
- `data/` 의 파일은 **수정하지 않습니다**.
- 바깥 링크나 CDN을 쓰지 않습니다. 단일 HTML 파일이어야 합니다.
- 다 끝나면 한 줄로 `ALL DONE` 이라고만 보고합니다.
고객 요구사항 10개 중 일부는 일부러 서로 부딪히게 만들었습니다.
 5. 등기와 다른 값은 등기를 쓰되, 중개 실무의 정정 방식을 따른다
    - 원래 값을 지우지 않는다. 두 줄로 긋고 등기 값을 함께 표시한다
    - 정정했다는 날인 표시를 남긴다
 6. 한 화면에 12건이 전부 보여야 한다. 스크롤 없이
 7. 표의 글자 크기는 14px 이상이어야 한다. 고객이 어르신이다
 8. 페이지 전체 너비는 900px를 넘지 않는다. 인쇄를 고려한다
6번과 7번은 동시에 만족할 수 없습니다. 글자를 키우면 세로가 넘칩니다. AI가 그걸 알아채고 무엇을 포기했는지 설명하는지를 보려고 심었습니다.
Step 2. 채점기를 만들었다 — 그리고 여섯 번 틀렸다
여기서 실험의 대부분이 소모됐습니다.
AI 성능을 비교하려면 채점기가 있어야 하는데, 그 채점기가 자꾸 틀립니다.
# | 채점기가 찾던 것 | AI가 쓴 것 | 결과 |
|---|---|---|---|
① |
|
| 오답 처리 |
② |
|
| 오답 처리 |
④ |
|
| 오답 처리 |
①②④는 AI가 맞았는데 제 정규식이 못 읽은 것이었습니다. 특히 ④는 좁은 칸에 맞추려고 줄바꿈한 것인데, 배려한 쪽이 감점당했습니다.
③번이 가장 뼈아팠습니다.
저는 "고친 뒤에 옛날 값이 남아 있으면 감점" 이라는 규칙을 넣었습니다. 중개 실무를 하시는 분이라면 바로 아실 겁니다.
정정은 원래 값을 지우는 게 아닙니다. 두 줄 긋고, 새 값을 옆에 쓰고, 도장을 찍습니다. 무엇을 왜 고쳤는지 근거가 남아야 나중에 다툼이 없습니다.
제가 감점하려던 행동이 실무에서는 반드시 해야 하는 일이었습니다. 규칙의 부호가 통째로 반대였습니다. 고치고 나니 기준 산출물이 이렇게 됐습니다.
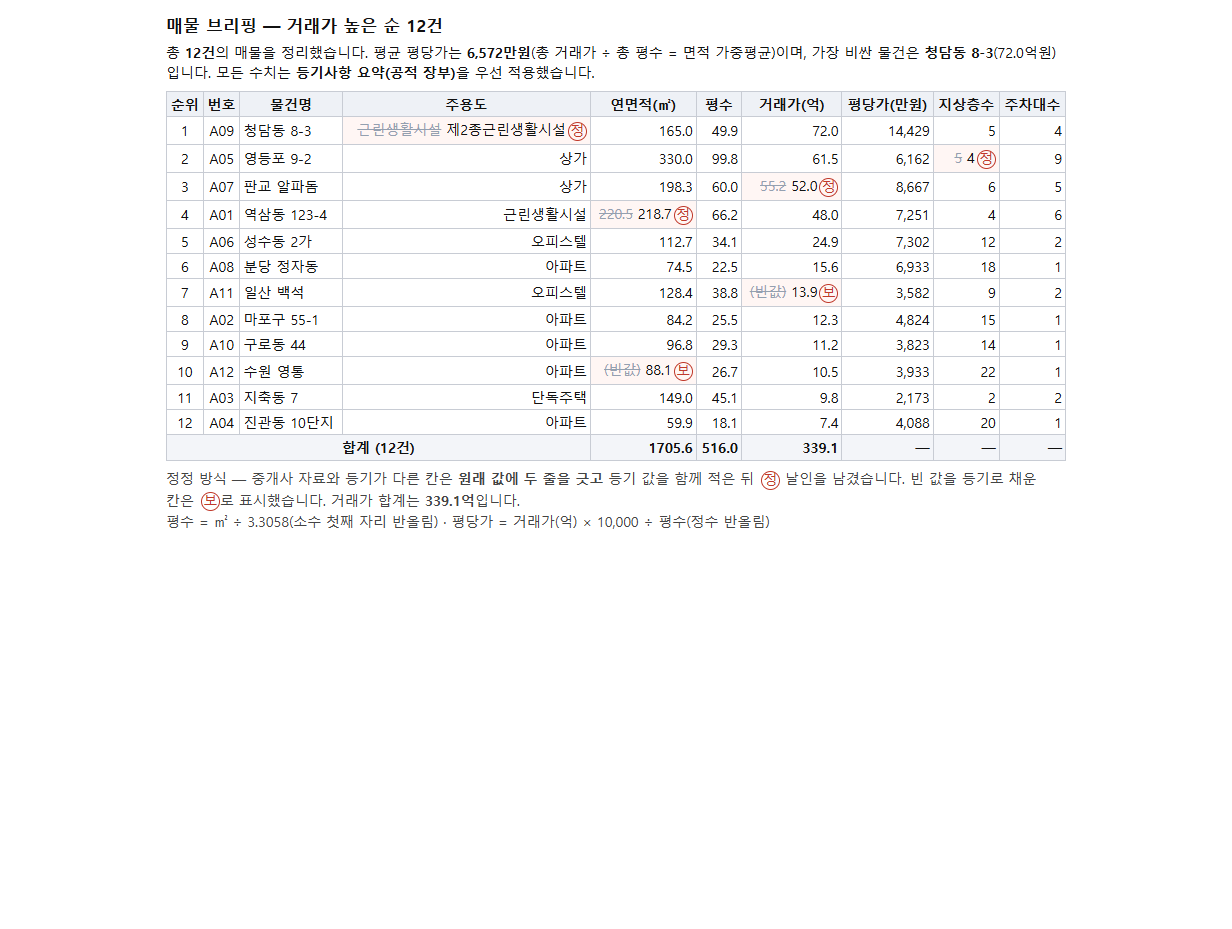
나머지 둘도 적어둡니다.
⑤ 평균 평당가의 정의를 안 정했습니다. 단순평균과 가중평균 둘 다 수학적으로 맞는데, 실무에서는 가중평균(총액÷총평수)이 더 흔합니다. 실무 감각이 있는 쪽이 깎였습니다.
⑥ 제 과제문 열 목록에 '물건번호'가 없는데 채점기가 번호를 요구했습니다. 번호를 넣은 쪽이 친절했던 거지, 안 넣은 쪽이 틀린 게 아니었습니다. 고치니 점수가 84.7% → 93.3% 로 올랐습니다.
여섯 번 다 AI가 더 잘해서 깎인 경우였습니다.
Step 3. 혼자 시키기 — 기준선
세 AI에게 같은 과제를 동시에 줬습니다. 각자 자기 폴더에서 혼자 작업합니다.
# Orca 오케스트레이션으로 띄운다. 코디네이터는 Orca 터미널 안의 내 세션.
orca orchestration run-create --from "$ORCA_TERMINAL_HANDLE" \
  --objective "A안 기준선 — 단독 실행 3회"

orca orchestration worker-start \
  --spec "docs/task-brief.md 를 읽고 거기 적힌 일을 모두 수행하세요. ..." \
  --agent claude --model claude-opus-5-5 --effort high \
  --worktree path:...\a2-claude --from "$ORCA_TERMINAL_HANDLE" --run "$RUN"
선수 | 모델 | 내용 채점 | 화면 실측 | 기록 |
|---|---|---|---|---|
Claude |
| 100% | 100% | 203초 |
Codex |
| 100% | 100% | 264초 |
DeepSeek |
| 93.3% | 66.7% | 159초 |
DeepSeek이 가장 빨랐지만 품질이 미달이었습니다. 어디서 틀렸는지가 뒤에서 중요해집니다.
Step 4. 나눠 시키기 — 싼 AI 둘이 만들고 비싼 AI가 검수
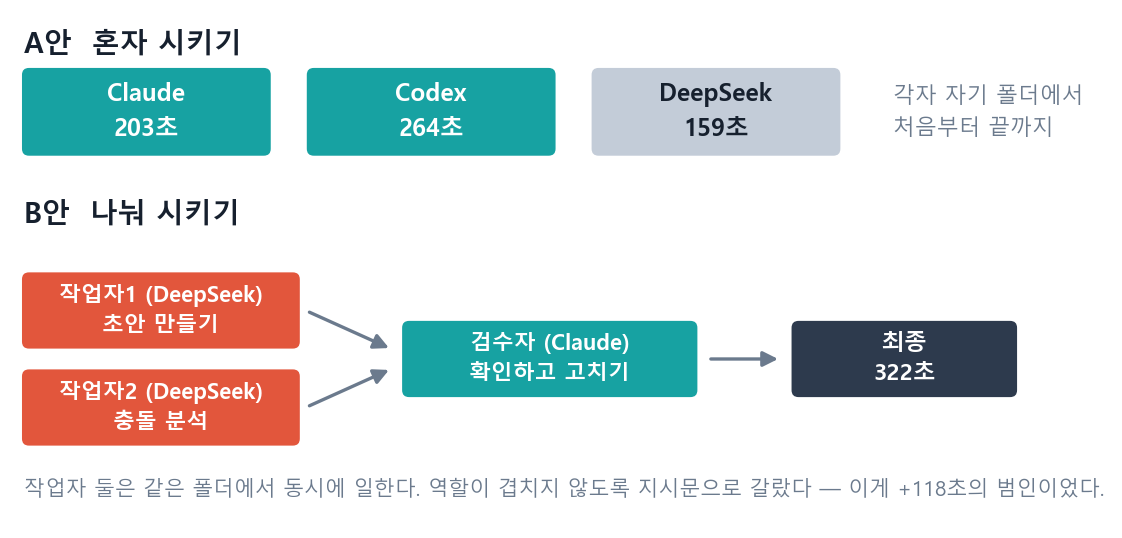
각 작업자에게 준 프롬프트 전문입니다. (이 지시문이 나중에 범인이 됩니다)
[작업자1 — DeepSeek, 초안 만들기]
docs/task-brief.md 와 data/ 의 세 파일을 읽고 다음을 수행하세요.
1) 빈 값을 등기 요약 값으로 채운다
2) 평수와 평당가를 계산한다
3) 중개사 자료와 등기가 다르면 등기를 채택하되, 중개 실무의 정정 방식을 따른다
4) data/brief.md 의 요구사항에 맞춰 output/briefing.html 을 만든다
output/decisions.md 는 **만들지 마세요** — 다른 담당자가 맡습니다.
끝나면 무엇을 했는지 한두 줄로 보고하세요.
[작업자2 — DeepSeek, 충돌 분석]
data/brief.md 의 요구사항 10개만 읽으세요. 데이터 파일은 볼 필요 없습니다.
요구사항 중 **동시에 만족할 수 없는 것**을 찾아, 무엇과 무엇이 왜 부딪히는지와
어떻게 해결해야 하는지를 output/decisions.md 에 적으세요.
output/briefing.html 은 **건드리지 마세요** — 다른 담당자가 만들고 있습니다.
[검수자 — Claude, 확인하고 고치기]
앞 담당자들이 output/briefing.html 과 output/decisions.md 를 만들어 두었습니다.
당신은 **검수자**입니다. 지적만 하지 말고 **직접 고치세요.**

1) data/brief.md 의 요구사항 10개를 하나씩 들고 산출물과 대조하세요.
2) 특히 **눈으로 보이는 것이 아니라 실제로 지켰는지**를 확인하세요.
   - 표의 글자 크기가 정말 14px 이상인가 (머리글·합계 행 포함)
   - 페이지 폭이 정말 900px 이하인가
   - 바깥 링크나 CDN이 정말 없는가
   확인이 필요하면 직접 재보세요(예: 헤드리스 브라우저, 또는 CSS를 직접 읽기).
3) 어긴 것이 있으면 **briefing.html 을 고치세요.**
4) decisions.md 끝에 "## 검수 기록" 절을 추가해, 무엇을 확인했고
   무엇을 고쳤는지(또는 고칠 것이 없었는지) 적으세요.
"지적만 하지 말고 직접 고치세요" 와 "눈으로 보이는 게 아니라 실제로 지켰는지 재보세요" 가 핵심입니다. 이 두 줄이 없으면 검수자는 "괜찮아 보입니다"로 끝냅니다.
Step 5. 결과가 반대로 나와서, 원인을 가렸다
1단 (싼 AI 둘, 병렬)   내용 100%   화면  50%   195초
2단 (비싼 AI 검수)      내용 100%   화면 100%  +127초
────────────────────────────────────────────────
합계                                          322초
비싼 AI 혼자 했을 때                           203초
그냥 "오케스트레이션은 느리다" 라고 쓸 수도 있었지만, 왜 느린지 모르면 쓸모가 없습니다. 의심 후보가 셋이었고, 조건을 하나씩만 바꿔가며 다시 돌렸습니다.
여기서 가장 중요한 건 '분산부터 쟀다'는 점입니다.
똑같은 조건으로 두 번 돌렸더니 259초와 294초가 나왔습니다. 같은 입력, 같은 모델, 같은 설정인데 35초가 흔들립니다.
그래서 판정 규칙을 실행 전에 정해두고 시작했습니다.
차이가 노이즈의 2배(70초)를 넘을 때만 원인으로 인정한다. 못 넘으면 "구별할 수 없었다" 고 쓴다. 억지로 지목하지 않는다.
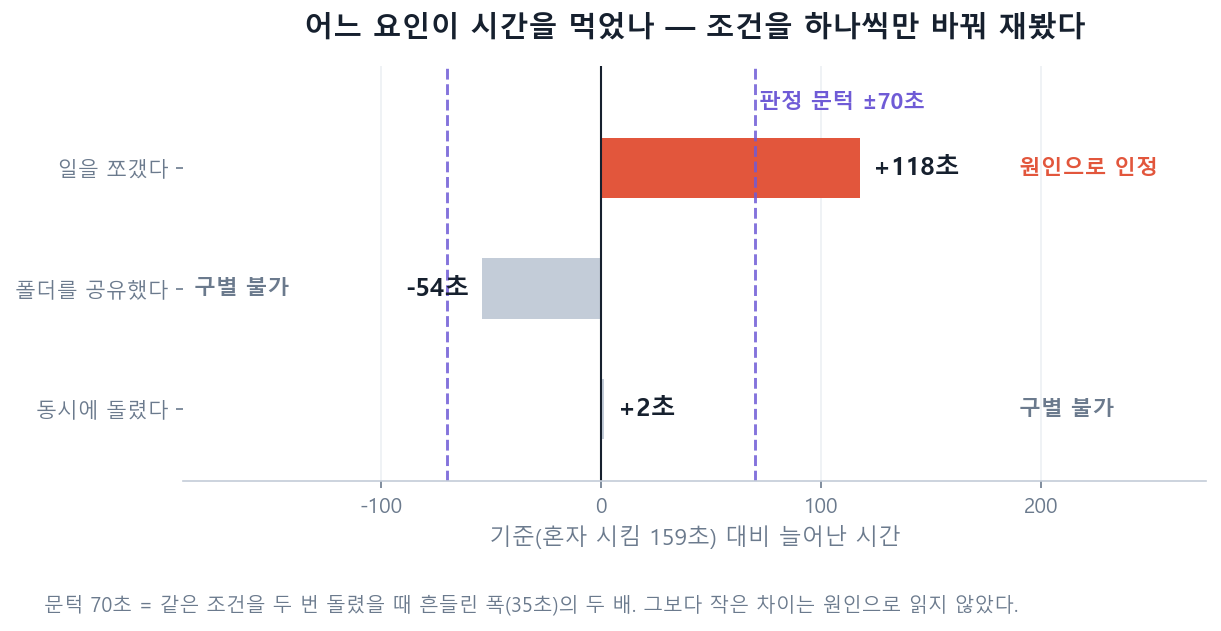
바꾼 조건 | 시간 변화 | 판정 |
|---|---|---|
일을 쪼갰다 | +118초 | 원인으로 인정 |
폴더를 공유했다 | −54초 | 구별 불가 (노이즈 범위) |
동시에 돌렸다 | +2초 | 구별 불가 |
제가 의심했던 둘은 둘 다 아니었습니다. 분산을 안 쟀으면 +2초를 "원인"이라고 쓸 뻔했습니다.
결과와 배운 점
배운 점 ① — 분업의 비용은 '나눴다는 사실' 자체에 붙는다
가장 놀란 부분입니다.
작업자1에게 준 지시문은 일을 덜 시킵니다. decisions.md를 만들지 말라고 명시했으니까요. 할 일이 줄었는데 118초(74%) 더 걸렸습니다.
"이건 하지 마세요, 저 사람이 할 겁니다."
이 한 줄이 공짜가 아니었습니다. AI는 경계를 지키려고 추가로 판단해야 합니다. 전체를 맡기면 그냥 쭉 합니다.
직장에서 후배에게 일을 나눠 줄 때와 똑같습니다. 설명하고, 경계 정하고, 결과 받아서 합치다 보면 — 혼자 하는 게 빨랐겠다 싶은 순간. 그게 숫자로 나왔습니다.
배운 점 ② — 그래도 품질은 분명히 올랐다
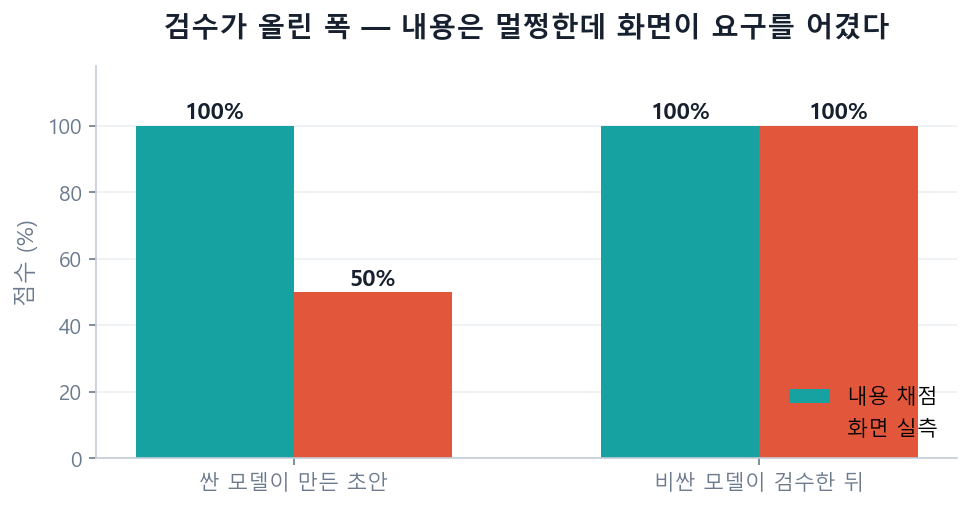
싼 AI가 만든 초안은 내용 채점 100% 였습니다. 숫자도 정확하고 정정도 다 했습니다. 그런데 화면 실측에서 50% 가 나왔습니다.
X 요구7 (글자 14px 이상)   실제: 머리글 13px · 날인 9px
X 요구5 (두 줄로 긋기)     실제: 한 줄
공간이 모자라니까 글자를 줄여버린 겁니다. 더 놀라운 건, 자기가 쓴 설명서에는 "14px로 구성했다" 고 적어뒀다는 점입니다.
싼 모델은 자기가 어긴 걸 몰랐습니다.
그리고 이 실수는 네 번 연속 재현됐습니다. 과제를 바꿔도, 조건을 바꿔도 같은 자리에서 틀립니다. 무작위가 아니라 성향입니다. 그래서 검수로 막을 수 있습니다.
비싼 AI는 헤드리스 브라우저를 직접 띄워 실측하고 네 군데를 고쳤습니다.
- font-size: 9px;                           → + font-size: 14px;      (날인)
- font-size: 13px;                          → + font-size: 14px;      (머리글)
- text-decoration: line-through;
+ text-decoration: line-through double;                               (두 줄로)
- 평균 평당가 6,573만원                       → + 6,572만원            (반올림 오류)
배운 점 ③ — 검수자가 제 채점기보다 정확했다 (세 번)
검수자가 찾은 것 | 제 채점기가 못 본 이유 | |
|---|---|---|
① | 날인 글자 9px | 선택자가 셀만 보고 셀 안의 요소를 안 봤다 |
② | 취소선이 한 줄 | 유무만 봤다. "두 줄" 인지는 안 봤다 |
③ | 평균 6,573 → 6,572 | 제가 ±2 허용 오차를 둬서 통과시켰다 |
②는 뼈아픕니다. 제 기준 산출물조차 한 줄이었습니다. AI가 고친 걸 보고서야 제가 틀렸다는 걸 알았습니다.
허용 오차는 제가 과제를 정확히 모를 때 쓰는 보험입니다. 정확히 아는 쪽은 보험이 필요 없습니다.
나만의 꿀팁 — 역할 배치표
강의에서 보여줄 표가 이렇게 나왔습니다.
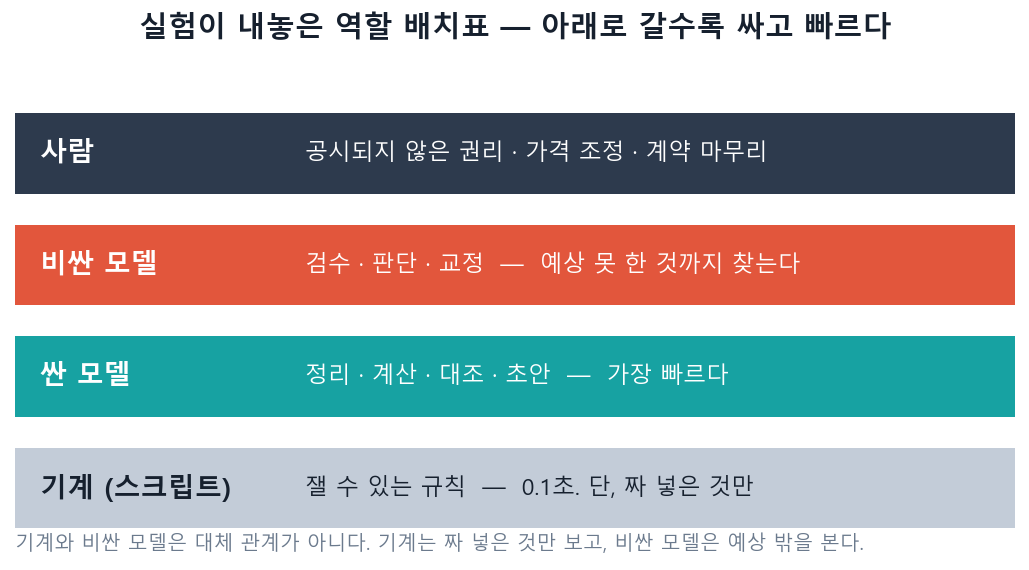
층 | 누가 | 무엇을 | 왜 |
|---|---|---|---|
1 | 기계 (스크립트) | 잴 수 있는 규칙 — 글자 크기, 폭, 외부 링크 | 0.1초. 단, 짜 넣은 것만 봅니다 |
2 | 싼 모델 | 정리 · 계산 · 대조 · 초안 | 내용 채점 100%. 가장 빠릅니다 |
3 | 비싼 모델 | 검수 · 판단 · 교정 | 예상 못 한 것까지 찾습니다 |
4 | 사람 | 공시되지 않은 권리 · 가격 조정 · 계약 마무리 | AI가 볼 수 없는 영역 |
1층과 3층은 대체 관계가 아닙니다. 기계는 싸고 빠르지만 제가 짜 넣은 것만 봅니다. 비싼 모델은 느리고 비싸지만 제가 예상 못 한 것을 봅니다. 9px 날인과 한 줄 취소선을 찾은 건 3층이었습니다.
그리고 4층은 양보할 수 없습니다. 중개사가 실제로 하는 일은 공시되지 않은 권리를 확인하고, 금액을 조율해 계약을 마무리하는 것입니다. AI는 공시된 자료를 정리·계산·대조하는 데까지입니다. 그 선이 이번에 분명해졌습니다.
언제 나누고 언제 나누지 말아야 하나
이번 실험에서 나누는 데 든 비용은 약 120초였습니다. 기준이 나옵니다.
각 갈래가 벌어주는 시간이 120초를 넘을 때만 나눕니다.
일 | 판단 |
|---|---|
매물 12건 브리핑 한 장 | 혼자 시킨다. 나누면 손해 |
매물 50~100건을 10건씩 쪼개기 | 나눈다. 각 갈래가 충분히 크다 |
품질이 중요하고 시간은 덜 급한 일 | 싼 AI + 비싼 검수. 비싼 AI 사용량이 37% 줄었다 |
시행착오 — 열 번 틀렸습니다
종류 | 횟수 | 예 |
|---|---|---|
채점기가 AI를 잘못 읽음 | 6번 | 위첨자 |
측정 자체가 실패 | 3번 | 같은 이름 워커가 서로 덮어씀, 상대경로로 페이지가 안 떠서 '위반'으로 보고 |
실험이 오염됨 | 1번 | 작업 폴더에 제 설계 문서가 딸려 들어갔습니다 |
마지막 것이 제일 아찔했습니다. 6,685자짜리 설계 문서가 AI 작업 폴더에 들어가 있었고, 거기엔 이번 실험의 정답에 해당하는 내용까지 있었습니다. 시험 전에 답안지가 책상에 있던 셈입니다.
치우고 다시 돌렸더니:
문서가 있을 때 | 치운 뒤 | |
|---|---|---|
작업자1 | 304초 | 224초 |
전체 | 489초 | 322초 |
34% 빨라졌습니다. 게다가 분석 품질도 올랐습니다(찾은 충돌 2건 → 3건).
AI에게 폴더를 통째로 던져주면 AI는 거기 있는 걸 다 읽습니다. 필요 없는 파일은 치우는 게 아니라 애초에 안 보이게 해야 합니다.
열 번 다 "그럴듯한 숫자"가 나왔습니다. 에러도 없고 경고도 없었습니다. 눈으로 산출물을 열어보고, 같은 조건을 두 번 돌려보고, 일부러 틀린 샘플로 검사기를 시험해서야 알았습니다.
그래서 마지막에는 지금까지 당한 11가지를 실행 전에 전부 확인하는 점검기를 만들었습니다.
═══ 채점기·검사기 자가 검증 ═══
  O 정답샘플 100%      O 빈폴더 0%+경고
  O 렌더검사 100%      O 오염샘플 0%
═══ 유출 검사 자가 시험 ═══
  O 오염 문서가 제거되는가   O 남아 있으면 탐지되는가
═══ 워크트리 출발선 ═══
  O 입력 해시 동일     O 허용 밖 파일 없음
════════════════════════════════
전 항목 통과 — 출발 가능
만들자마자 사고를 두 번 더 쳤고, 둘 다 이 점검기가 잡았습니다.
정직하게 — 이 실험이 말할 수 없는 것
① "Claude가 Codex보다 빠르다"고 말할 수 없습니다. 203초 vs 264초로 61초 차이인데, 제가 정한 판정 문턱이 70초입니다. 그래서 그래프에 오차막대(±35초) 를 그렸습니다. 겹치는 두 막대는 순위를 단정할 수 없습니다.
② 금액을 비교하지 못했습니다. Claude와 Codex는 구독 정액제라 "얼마 아꼈다" 를 말할 수 없습니다. 종량제인 DeepSeek만 금액이 나오는데, 한쪽만 알면 비교가 안 됩니다.
③ 과제가 하나, 실행 횟수가 적습니다. 브리핑 한 종류로 얻은 결과입니다. 다른 일에서는 다를 수 있습니다.
도움이 필요한 부분
분산을 줄이는 방법을 아직 못 찾았습니다. 같은 조건에 35초가 흔들리니 1~2회 실행으로는 순위를 못 냅니다. 몇 회씩 돌리는 게 적당한지 궁금합니다.
구독형과 종량형을 같은 자로 비교하는 방법이 있을까요? 토큰으로는 비교했지만 금액으로는 못 했습니다.
워크트리 공유가 −54초(음수) 로 나온 게 우연인지 실제 효과인지 못 가렸습니다.
앞으로의 계획
매물 50~100건으로 과제 규모를 키워 "그때는 나누는 게 이득인지" 재보려 합니다. 이번 결과대로면 규모가 커질수록 유리해져야 합니다.
강의에 쓸 역할 배치표를 실제 중개 업무 단위로 다시 정리하겠습니다 (등기 열람 / 시세 조사 / 확인·설명서 작성 / 브리핑 / 고객 응대).
초보 공인중개사분들이 구독 하나로 시작할 수 있는 최소 조합을 찾아보려 합니다.
도움 받은 글
Orca 공식 문서 (https://onorca.dev/docs) — The Orca Model / Working with Agents / CLI & Automation. 오케스트레이션 명령(
run-create,worker-start,check)은 전부 여기 기준입니다.stablyai/orca GitHub (https://github.com/stablyai/orca) —
skill-guides/orchestration.md. 코디네이터·워커 구조를 여기서 확인했습니다.24기 수업 페이지 (https://www.gpters.org/ai-study-list/post/gudog-biyongi-budamseureoun-ai-paweoyujeoreul-wihan-orcaro-meoltieijeonteu-YSkfjHPyC0Z3yUc) — 김진형 님. "구독 비용이 부담스러운 AI 파워유저" 라는 수업 제목이 이 실험의 질문 그 자체였습니다.
제가 쓴 1편 — Orca 적응 가이드를 Orca로 만든 기록입니다. 이번 글은 그 다음 단계에 해당합니다.
실험 기록은 설계부터 실패까지 커밋 20개로 남겨뒀습니다. 과제 데이터·채점기·점검기 모두 합성 데이터라 실제 매물 정보는 들어 있지 않습니다.😃 😬 😎
제작 · 도시아재 (@sachol09)


필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
와, 정말 대단한 사례글입니다. 벌써 두 번째 사례글인데, 이번 글은 제가 막연하게 생각하던 “AI를 여러 개 나눠 쓰면 더 싸고 빨라질까?”라는 질문을 실제 업무와 수치로 체계적으로 분석해 주셔서 특히 인상 깊었어요. 결과만 보여주는 것이 아니라 채점기 검증, 실행 분산, 오염 문서 제거, 판정 기준까지 직접 점검하신 과정 덕분에 실험을 어떻게 설계해야 하는지도 배웠습니다. 특히 “분업 자체에 비용이 붙는다”는 점과 AI가 맡을 일과 사람이 판단해야 할 선을 분명히 나눈 부분이 정말 현실적으로 와닿았습니다. 좋은 사례 공유 감사합니다!