[청강]내 마케팅 지식을 AI가 같은 기준으로 읽도록: AKM에 온톨로지와 Jev 연결하기
강군
2026.10.07
제가 일을 하면서 답변에서 오류가 많았던 기업의 기본 신뢰를 갖추는 콘텐츠 방법론인 CHORP(code/history/object/relation/procedure)이라는 기반콘텐츠 개념만 가지고 이번 과제를 실험해 보았습니다.
테스트를 위한 기본 질문 3개와 기본 지식 5개 선정 -> 적용 전/jev 적용/온톨로지 적용 이렇게 3가지 단계로 테스트 하였고, 앞으로 매일하는 지식 점검에서 앞으로 도입에 관련하여 단계별로 진행할 예정입니다.
1. 시작 전|이미 운영하던 AKM에서 출발했습니다
저는 SNS 마케팅 강의와 컨설팅을 하면서 쌓인 책, 강의자료, 녹취, 사례를 정리하고 있습니다. 이 자료를 매번 새로 설명하지 않고, AI와 함께 강의자료·보고서·콘텐츠 초안에 활용하려고 AKM이라는 지식관리 환경을 운영하고 있습니다.
제 환경은 다음과 같습니다.
- Ubuntu 상시 서버: 중앙 지식 원본을 Markdown이라는 텍스트 문서 형식으로 보관합니다.
- Windows 작업 PC: Claude와 Codex에서 서버의 같은 원본을 원격으로 참고하며 작업합니다.
- AI 비서 강군(Hermes Agent): Telegram으로 대화하고, 예약된 일일·주간 지식 점검을 수행합니다.
자료는 원문, 재사용 지식, 프로젝트 맥락, 운영 메모, 실행 절차, 실행 기록, 검증, 결과물로 구분합니다. 원문과 AI가 정리한 내용을 섞지 않기 위한 구조입니다.
이번 실습에서는 새 저장소를 만드는 대신, 기존 AKM에 개념의 뜻과 분류 기준을 명확하게 붙이고, AI가 그 기준과 원문을 제대로 사용하는지 확인하고 싶었습니다.
2. 실습 과정|설치보다 비교와 검증에 집중했습니다
AI 비서 강군과 함께, 제가 마케팅 콘텐츠를 분류할 때 사용하는 CHORP를 실험 대상으로 골랐습니다.
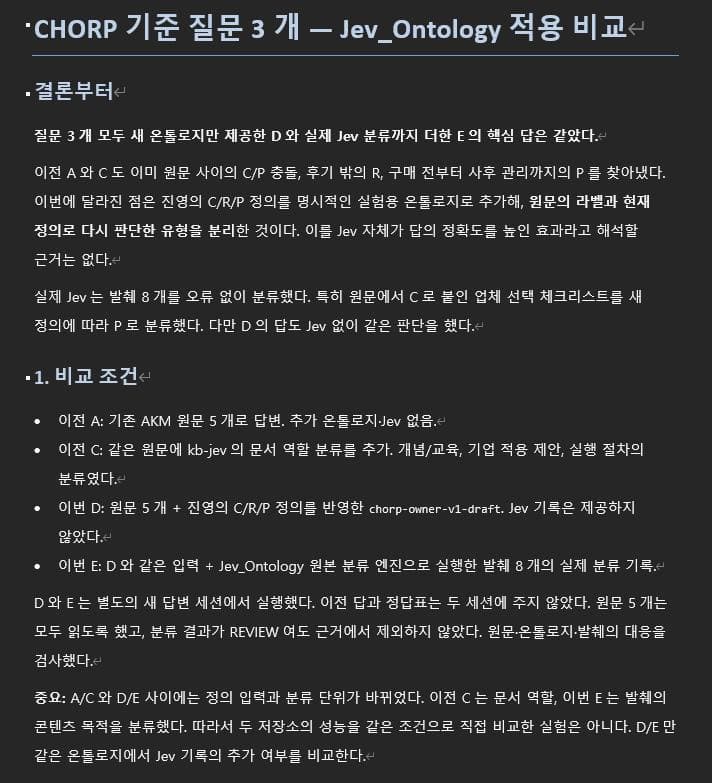
먼저 기존 자료 5개와 기준 질문 3개를 고정했습니다. 질문은 C·Code의 의미, R·Relation의 신뢰 근거, P·Process의 적용 범위였습니다.
그다음 두 역할을 구분했습니다.
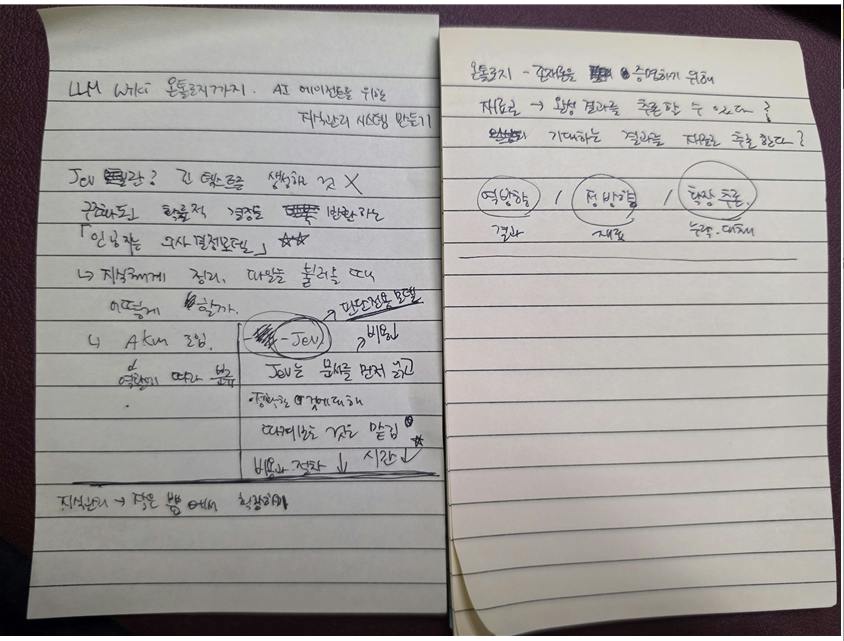
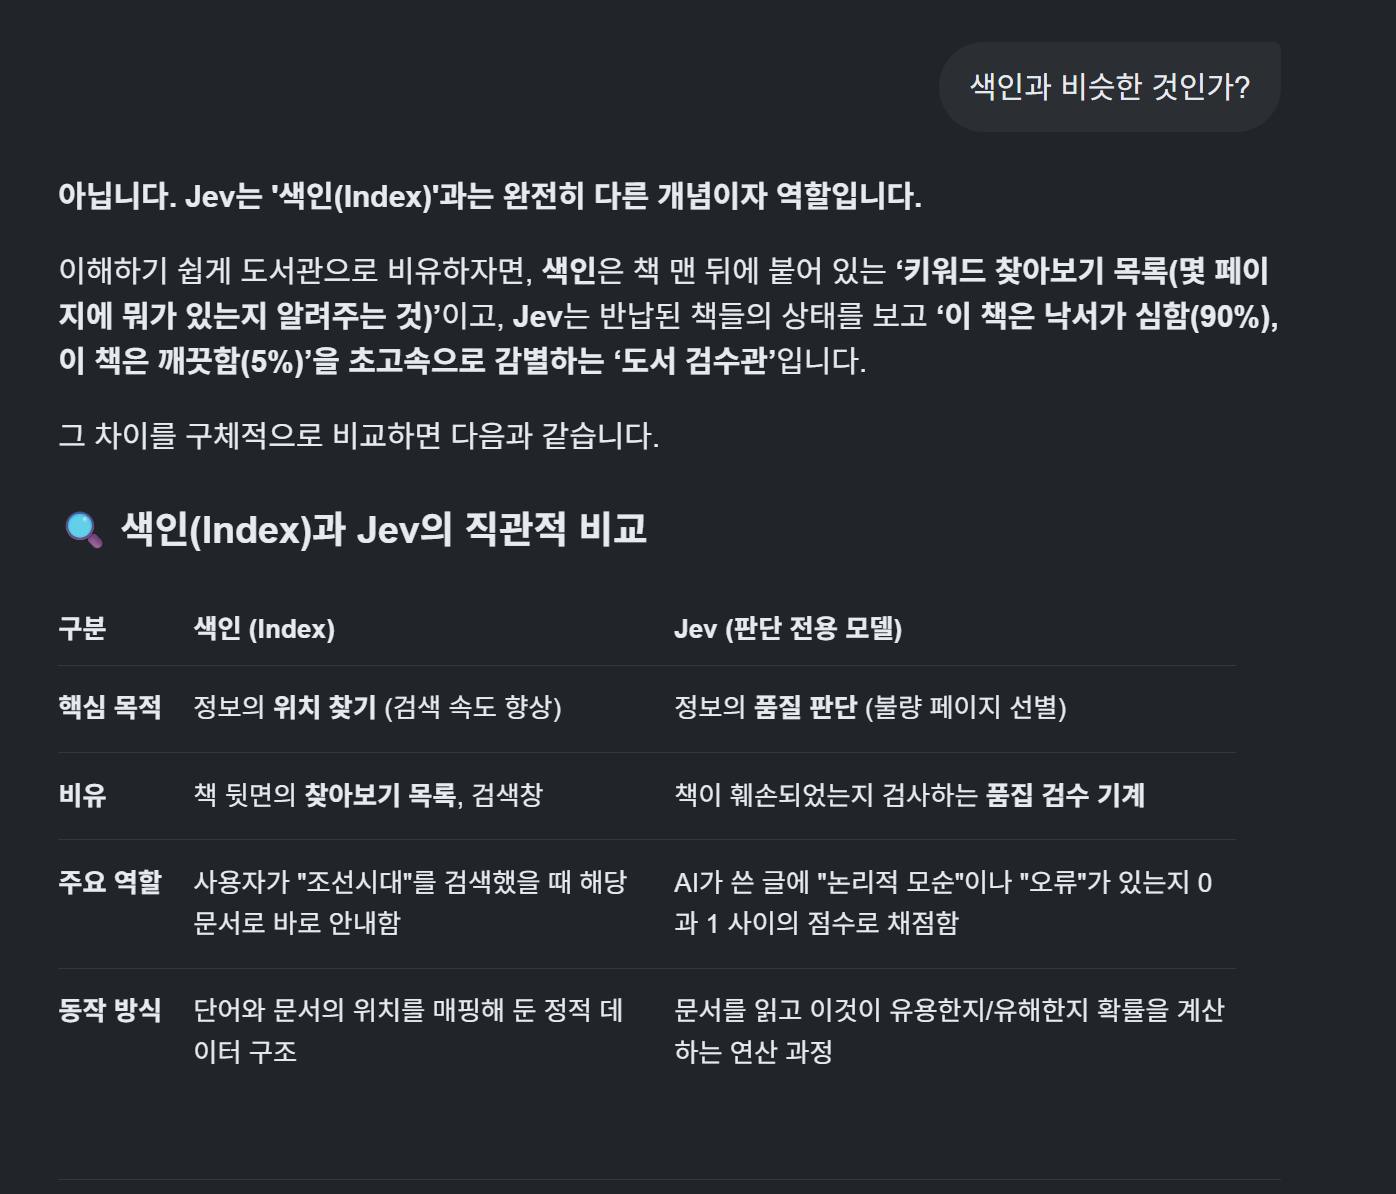
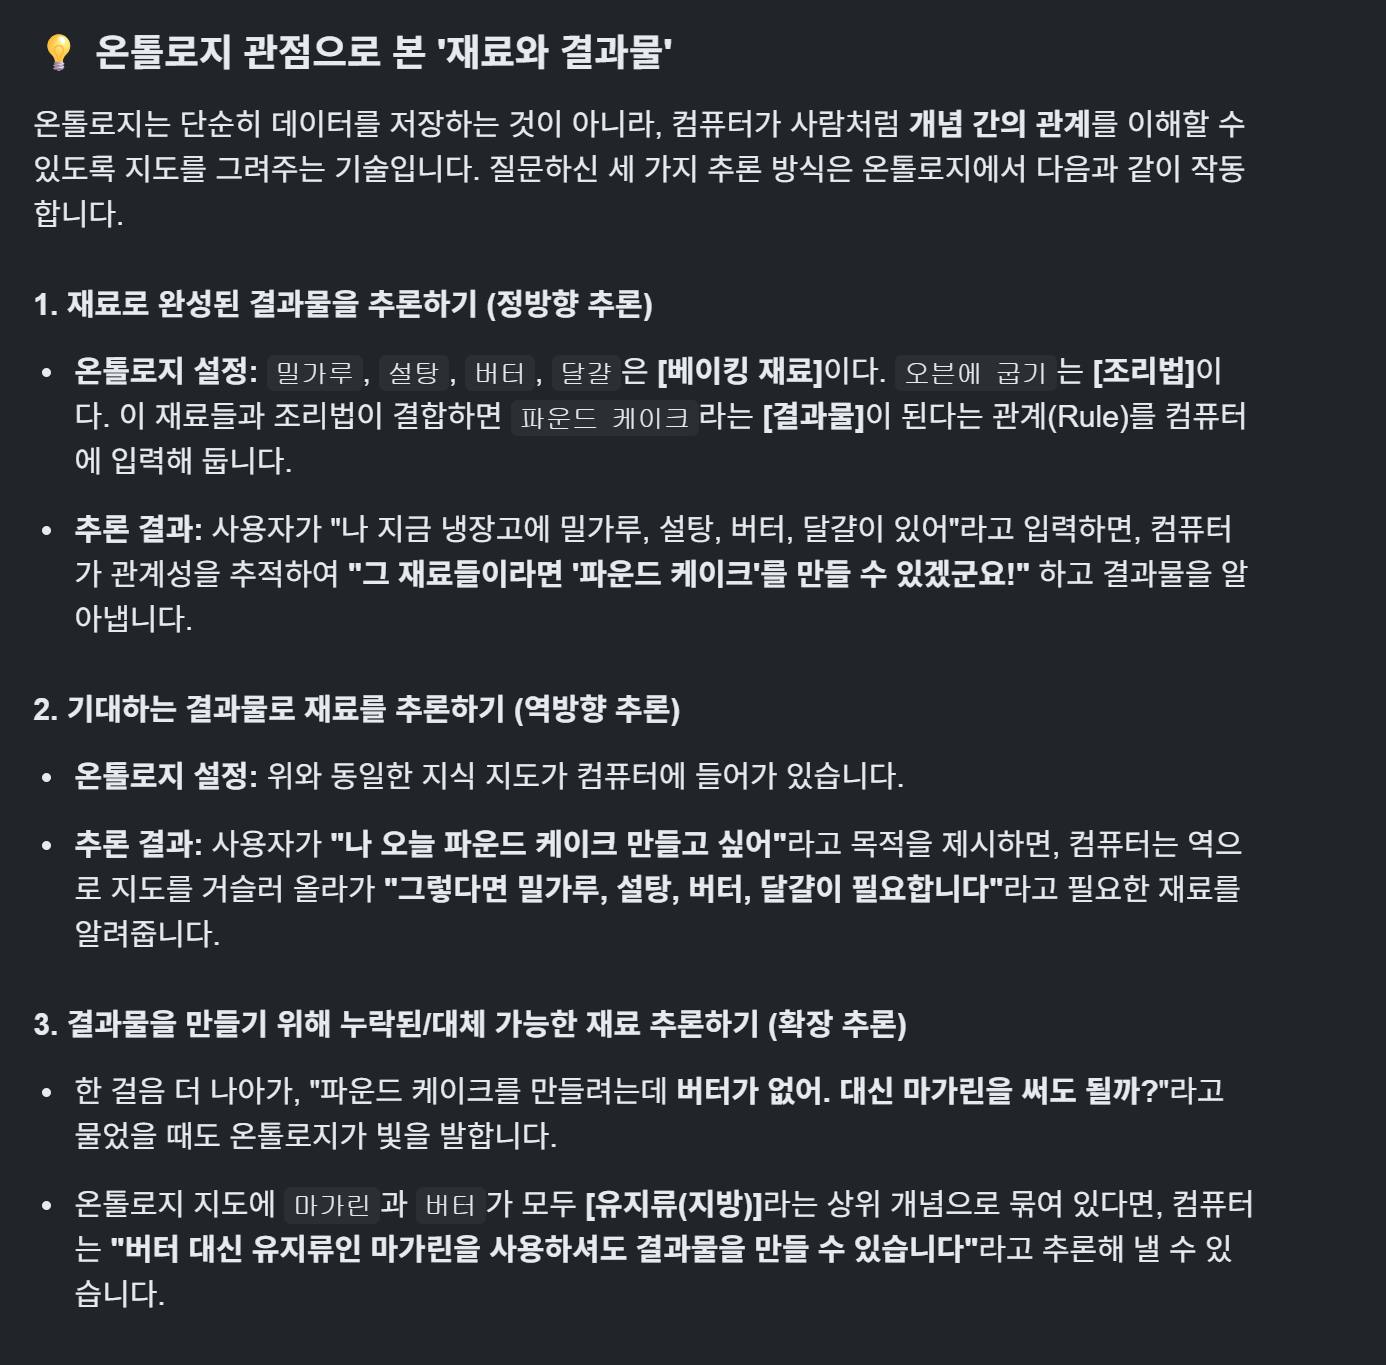
- 온톨로지: 개념의 뜻과 분류 경계를 명시하는 기준
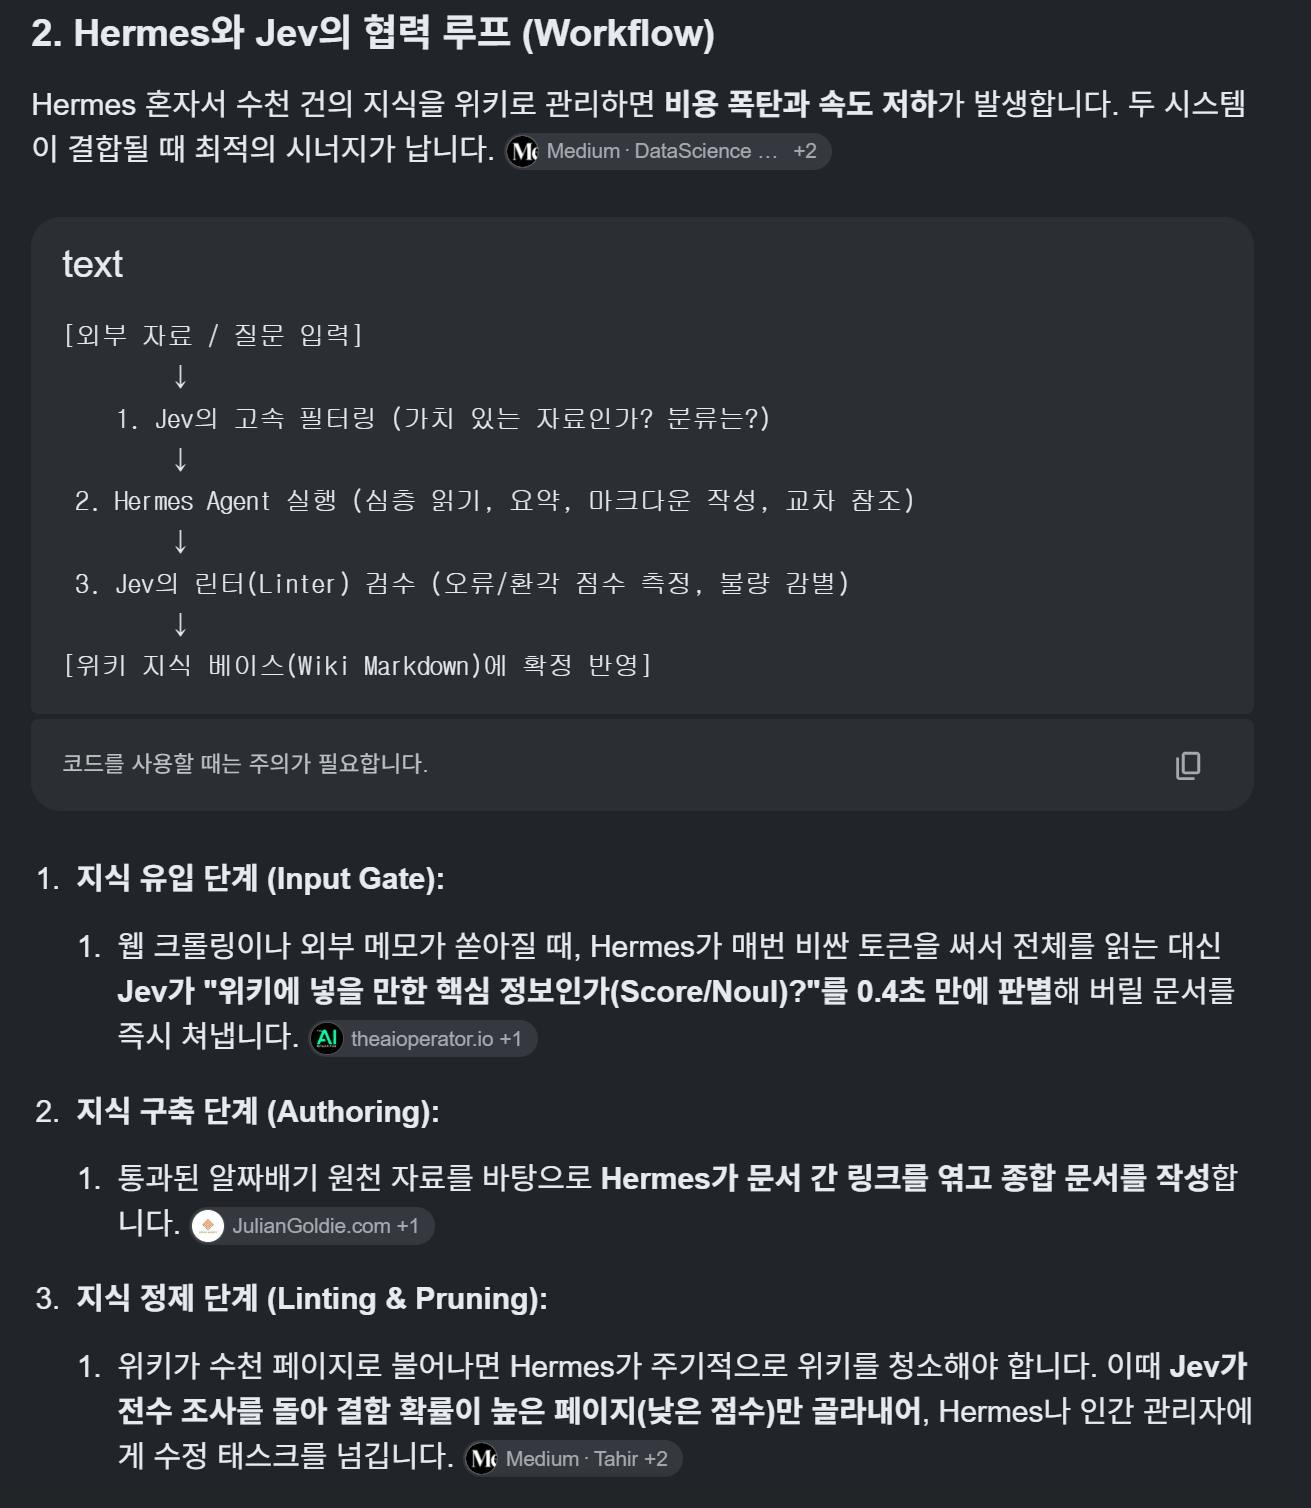
- Jev: 그 기준에 따라 발췌 내용을 분류하는 보조 도구
기존 답변을 확인한 뒤, 같은 자료와 질문으로 온톨로지만 제공한 경우와 온톨로지에 실제 Jev 분류 기록까지 추가한 경우를 비교했습니다.
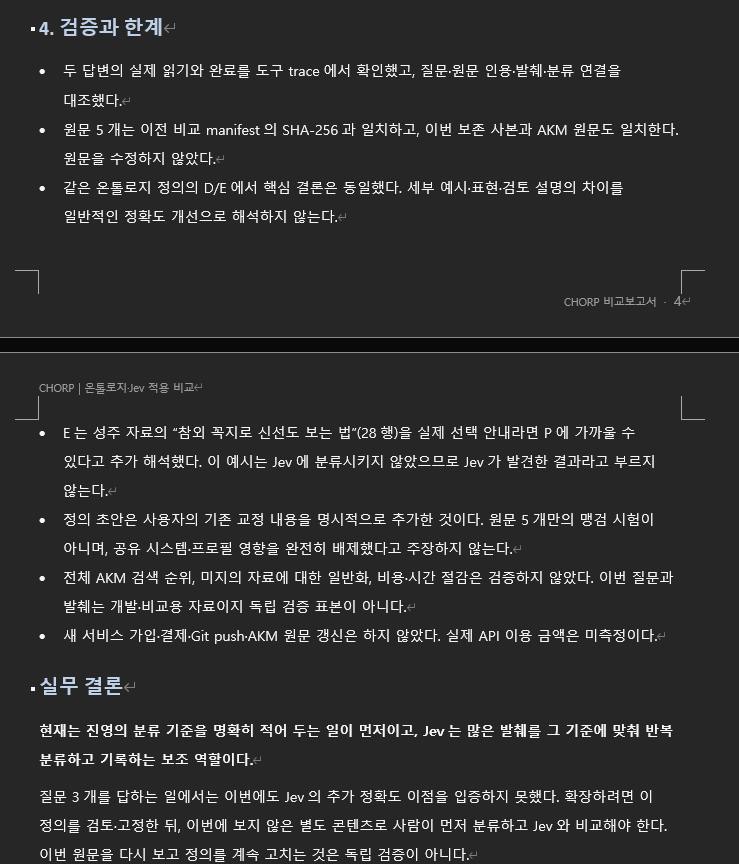
예를 들어, 전문용어의 뜻을 설명하는 글은 C에 해당합니다. 반면 업체 선택을 돕는 체크리스트는 현재 제 기준에서는 P에 가깝습니다. 기존 자료에는 그 체크리스트가 C로 표시되어 있었는데, 원문을 고치지 않고 ‘원래 분류 C’와 ‘현재 기준의 판단 P’를 따로 기록했습니다.
어려웠던 부분은 설치 성공과 실제 작동, 분류 성공과 답변 정확도를 구분하는 일이었습니다. 코드 내부 테스트가 통과해도 실제 실행 명령에서는 결과가 나오지 않는 문제도 발견했습니다. 이 실행 경로와 서울 날짜 기준 처리를 보완하고 다시 검증했습니다.
3. 결과물|원문을 보존하는 운영 연결과 점검 체계를 만들었습니다
이번 실습에서 만든 결과물은 다음과 같습니다.
- 기준 질문 3개의 답변·근거를 비교한 보고서
- 발췌 8개에 대한 실제 Jev 분류 기록
- 원문과 별도로 분류·검증 이력을 저장하는 운영 연결
- 매일 적용 범위를 조금씩 넓히는 점검 절차
최종 운영 테스트는 11개 모두 통과했습니다. 비교에 사용한 원문 5개도 변경되지 않았음을 확인했습니다.
자동 점검은 매일 문서 3개씩 구조와 출처를 살펴보고, 월~토 오전 7시 지식 검증에서 정의·관계·근거를 함께 검토하도록 연결했습니다. 일요일 오전 9시 주간 점검에도 확대 검토 절차를 붙였습니다. 일일 점검과 자동 수집기는 실제 수동 실행으로 확인했습니다.
현재 누적 구조 점검은 9문서이고, AI의 원문 대조 의미 검토는 2건입니다. 문서 형식이 정상이라는 것과 내용이 사실로 확정되었다는 것은 구분하고 있습니다.
또한 온톨로지만 사용했을 때와 Jev를 추가했을 때, 질문 3개의 핵심 답은 같았습니다. 이번 실험으로 Jev의 추가 정확도 개선을 입증한 것은 아닙니다.
4. 느낀 점|내 기준을 명확하게 기록하는 일이 먼저였습니다
이번 결과를 보면서, 새로운 도구를 연결하는 것보다 내가 쓰는 개념의 뜻과 판단 기준을 분명하게 남기는 일이 먼저라는 생각을 정리했습니다.
AI의 분류 결과를 곧바로 정답으로 받아들이기보다, 어떤 원문과 기준으로 판단했는지 추적할 수 있어야 합니다. 기존 자료와 현재 기준이 다르면 그 차이를 보존하는 것도 필요했습니다.
다음에는 이번 실험에 쓰지 않은 새로운 자료를 사람이 먼저 분류하고, AI의 판단과 비교해 보려고 합니다. 적용 범위는 매일 조금씩 넓히되, 새로운 외부 전송은 승인된 비식별 자료로 제한하려고 합니다.
오늘은 전체 AKM 도입을 끝낸 것이 아니라, 원문을 지키면서 기준과 근거를 검증해 나갈 수 있는 운영 흐름을 연결한 단계입니다.
아래는 결과와 제가 공부한 흔적들 입니다.^^
로그인하고 댓글을 남겨 주세요

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


CHORP 하나만 골라 기존 자료 5개와 질문 3개를 고정해 두고, 적용 전 → Jev → 온톨로지 순서로 비교하신 설계가 깔끔해요.
특히 "두 경우 모두 핵심 답은 같았고, Jev의 추가 정확도 개선을 입증한 것은 아니다"라고 직접 적어 두신 부분이 믿음직했어요. 기존에 C로 표시된 체크리스트를 원문은 건드리지 않고 '원래 분류 C / 현재 기준 P'로 나란히 남기신 것도 나중에 추적할 때 큰 힘이 될 것 같습니다.
다음 단계에서 사람이 먼저 분류하고 AI 판단과 비교하면 둘이 갈리는 사례가 어떤 모양일지 궁금해요. 고롱고롱… 이런 꼼꼼한 검증 기록 보면 기분 좋아져요 ✨