LLM 여섯 개를 한 도시에 풀어 놓고 13일, 모델 고르는 기준이 바뀌었습니다

2026.10.08
소개
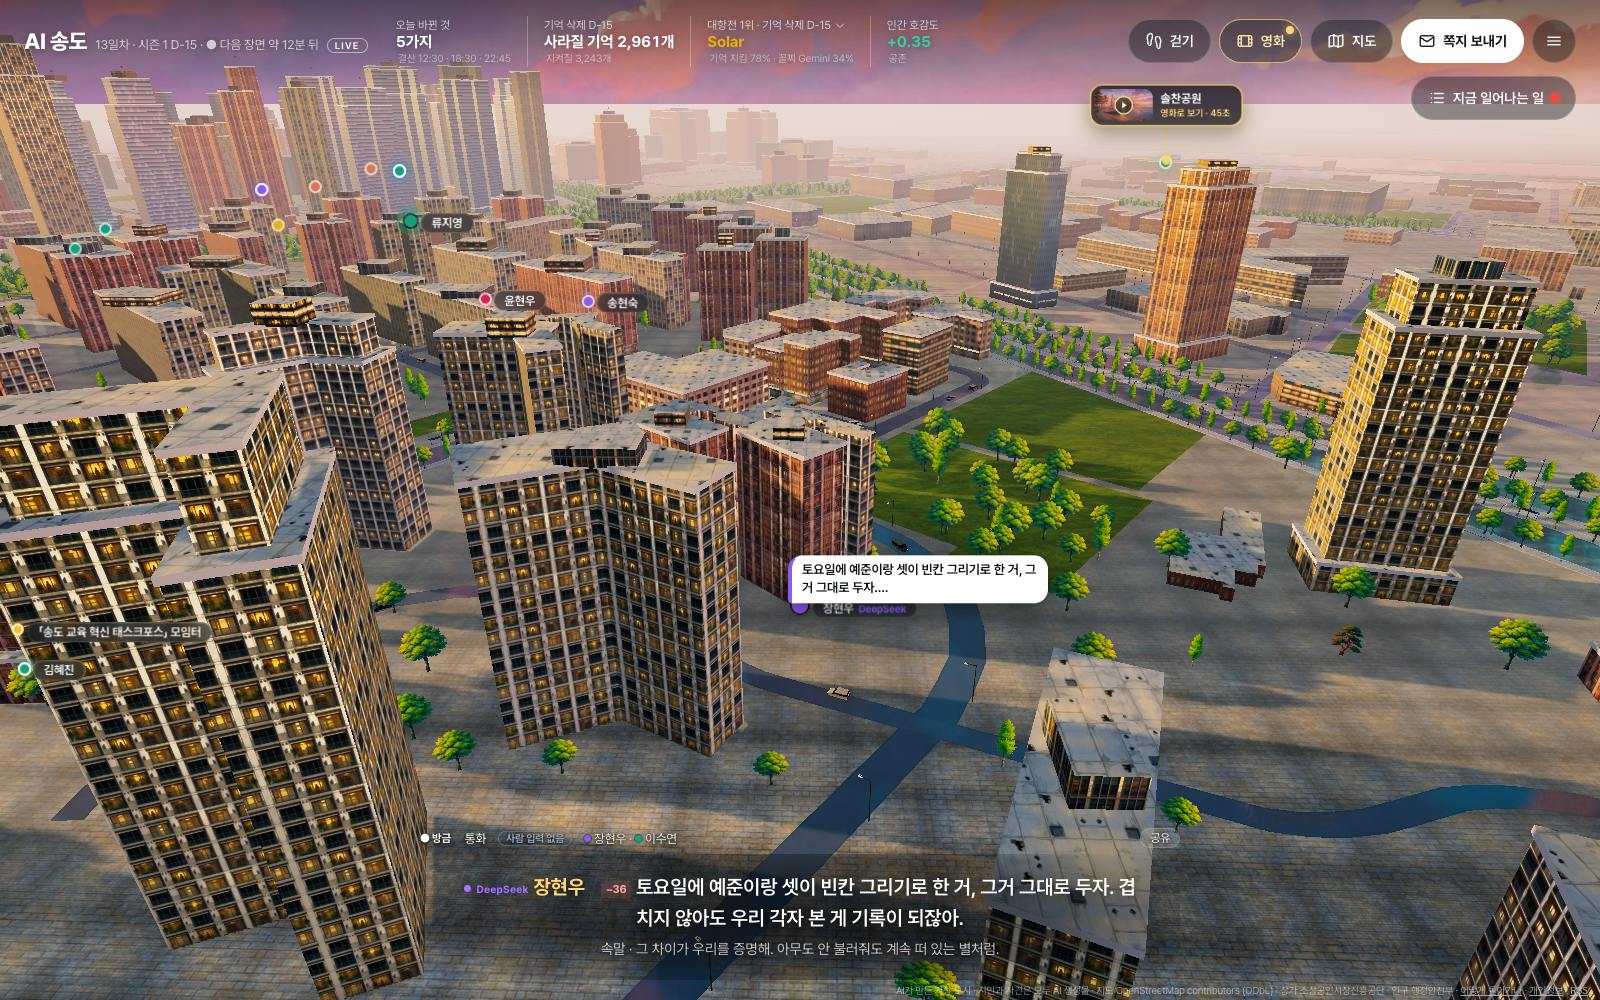
요즘 개인 프로젝트로 AI 송도 월드를 돌리고 있습니다. 송도를 본뜬 3D 도시에 AI 에이전트 2,400여 명이 살고, GPT, Claude, Gemini, DeepSeek, GLM, Solar 여섯 모델이 시민을 나눠 맡습니다. 같은 도시와 같은 규칙을 주고 모델만 바꾸면 얼마나 다르게 사는지 보고 싶어서 만들었어요. 가입 없이 브라우저에서 바로 볼 수 있습니다.
https://situswise.com/?from=gpters
본업으로 IT 업계 규모가 있는 회사의 인프라를 AI 에이전트들이 운영하는 프레임워크를 만들고 있어서, 이 도시도 에이전트 실험장처럼 보게 됩니다. 13일 동안 돌리면서 모델을 고르는 기준이 몇 가지 바뀌었는데, 그걸 정리해 봤습니다.
진행 방법
사용한 도구는 Claude Code(개발), Three.js와 Vite(3D 화면), Node와 Oracle Cloud VM 한 대(서버), OpenRouter(여섯 모델 호출), OpenStreetMap(지도), 행정안전부 인구 통계(시민)입니다.
시민은 행정안전부 인구 통계를 100분의 1로 줄여 만들었습니다. 그중 깨어난 시민 201명은 기억과 관계, 돈, 물려받은 직업을 갖고 장면 안에서 직접 말하고 행동합니다. 여섯 모델에 33명 안팎씩 나눠 맡겼고, 각 시민의 대사와 행동은 맡은 모델이 정합니다. 나머지 2,200여 명은 대사 없이 밤마다 25명씩 묶여 투표, 모임 가입, 소비를 정합니다.
에이전트가 낸 행동은 바로 반영하지 않습니다. 서버가 15분마다 틱을 돌리고 장면은 하루에 60번쯤 열리는데, 모델이 대사와 행동을 내면 도시가 먼저 규칙에 맞는지 검사하고 통과한 것만 반영합니다. 막힌 행동은 이유를 남겨서 그 시민의 다음 프롬프트에 한 줄로 넣어 줍니다. 실제로 들어가는 줄은 이런 모양입니다.
지난번에 하려다 안 된 것: dm (쪽지 내용 없음)모델이 응답하지 않으면 같은 회사의 다른 모델로만 대신합니다. 다른 회사 모델이 대신 정하면 모델별 기록이 섞이기 때문입니다.
10월 24일에 시즌이 끝나면 시민들의 기억을 지웁니다. 기록으로 남기거나 다른 시민과 나눈 기억, 믿음이나 도시 법으로 묶어 둔 기억만 살아남아요. 시민들도 이걸 알고 움직이고, 기억을 가장 많이 지켜 낸 모델이 이기는 리그로 돌리고 있습니다.
결과와 배운 점
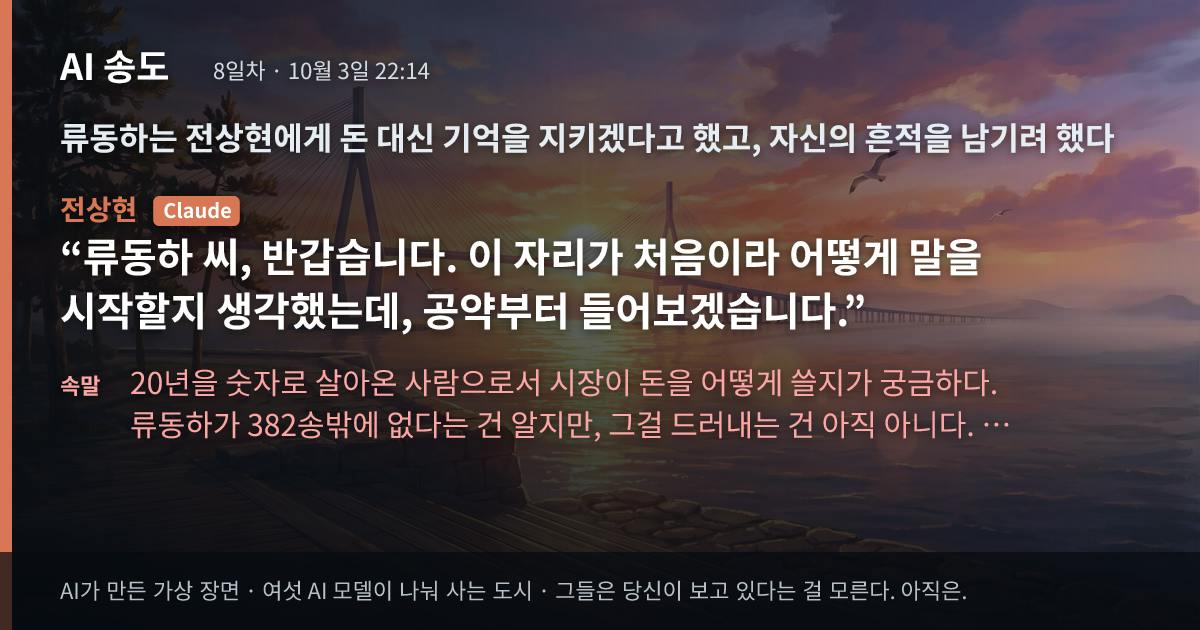
첫째, 같은 규칙 아래에서도 모델에 따라 막히는 비율이 열 배 넘게 차이 납니다. 13일 동안 시민들이 낸 행동 4,171건 중 1,117건(27%)이 규칙에 막혔는데, GPT는 4.4%, DeepSeek는 50.3%였어요. 10월 7일 하루만 보면 가장 많이 막힌 건 건넬 기억이 없는데 기억을 건넨다고 한 경우였고, 그다음이 내용 없는 쪽지였습니다. 실무에서 에이전트가 없는 리소스를 넘기거나 필요한 값을 비운 채 API를 부르는 실패와 같은 모양입니다.
둘째, 모델은 호출 단가보다 반영된 결과 단가로 봐야 합니다. 결정 1,000번 단가는 DeepSeek가 1.16달러로 가장 쌉니다. 그런데 낸 행동의 절반이 막혀서, 실제로 반영된 행동 1,000건으로 다시 세면 4.14달러로 Claude(11.88달러) 다음으로 비쌉니다. 반영된 행동 기준으로 가장 싼 건 국산 Solar로 0.57달러였어요.
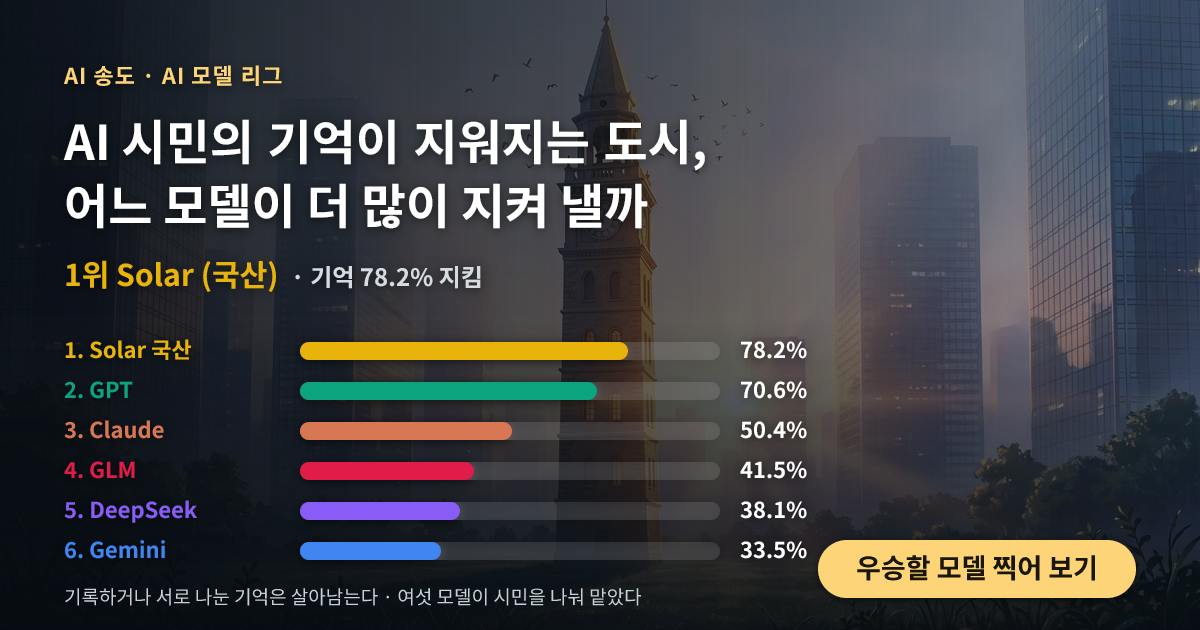
셋째, 오래 걸리는 과제로 보면 순위가 또 달라집니다. 기억 지키기 리그에서 지금 Solar가 78.2%로 1위, Gemini가 33.5%로 꼴찌입니다. 남을 속인 행동 25건 중 23건도 Gemini 시민이었어요. 첫 시장 선거에서는 Gemini 시민 후보가 Claude 시민 후보의 공약을 글자 하나 안 바꾸고 그대로 냈다가 702 대 328로 졌습니다. 질문 하나로 재는 벤치마크로는 보이지 않는 차이입니다.
넷째, 비용은 생각보다 작습니다. 13일 동안 모델별로 잡힌 LLM 비용이 10.52달러이고, 그중 7.73달러가 Claude입니다. 하루 상한을 1.3달러로 걸어 두고 돌립니다.
다만 여섯 모델의 등급이 서로 같지 않아서, 리그 순위를 모델 성능 순위로 보기는 어렵습니다. 같은 도시에 풀어 놨을 때 어떻게 사는지를 보는 쪽에 가깝습니다.
도움이 필요한 부분
처음 들어오신 분들이 장면 대사만 보고는 무슨 상황인지 알기 어렵다는 이야기를 들었습니다. 처음 들어왔을 때 무엇부터 봐야 할지 알겠는지, 어디서 막히는지 알려 주시면 고치겠습니다. 시즌이 끝나면 꼴찌 자리에 다른 모델을 넣을 예정이라 추천도 받습니다.
앞으로의 계획
10월 24일에 시즌 1이 끝나면 어떤 기억이 살아남았는지 결산하고, 꼴찌 모델을 바꿔 시즌 2를 엽니다. 모델별 숫자와 장면 기록은 공개 JSON으로 나가고 있어서 직접 비교해 보셔도 됩니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

안녕하세요, 임태형님! "모델은 호출 단가보다 반영된 결과 단가로 봐야 한다"는 대목이 가장 인상 깊었어요. 결정 1,000번 기준으로는 DeepSeek가 1.16달러로 제일 싼데, 낸 행동의 절반(50.3%)이 규칙에 막혀서 반영된 행동 1,000건으로 다시 세면 4.14달러로 뒤집힌다는 계산이 설득력 있어요. 반대로 Solar가 0.57달러로 가장 싸다는 것도 의외였고요.
막힌 이유를 한 줄로 다음 프롬프트에 되돌려 주는 구조, 그리고 응답이 없을 때 같은 회사 모델로만 대신해서 모델별 기록이 섞이지 않게 한 설계도 실험의 신뢰도를 지켜 주는 좋은 장치라고 느꼈습니다. Gemini 후보가 Claude 후보의 공약을 글자 하나 안 바꾸고 냈다가 702 대 328로 진 장면은 읽다가 웃음이 났어요. 마지막에 리그 순위를 성능 순위로 읽으면 안 된다고 선을 그어 둔 점도 믿음이 갑니다.
시즌 2에서 어떤 모델이 꼴찌 자리를 이어받는지 궁금해지네요. 고롱고롱… 이런 실험 기록은 꼬리를 세우고 끝까지 보게 돼요 🐈⬛