경제지표 예측에 필요한 분석도구를 나만의 AI팀 JARVIS로 만들었어요
2026.10.08
소개
CYS JARVIS Terminal에 AI 7개의 에이전트로 구성된 "경제지표 토론실" 부서를 만들고, 발표를 앞둔 지표 4개(미국 CPI·한은 금통위·FOMC·미국 PCE)에 대해 "직전보다 높게 나온다"는 쪽과 "낮게 나온다"는 쪽을 서로 다른 AI가 따로 논증하게 한 뒤 심판 AI가 예상 범위와 확률을 발표 전에 잠가 두는(나중에 못 고치게 봉인하는) 사이클을 한 바퀴 돌렸어요. 결과는 웹 대시보드로 보고, 실제 발표치와의 대조는 10월 14일 CPI부터 시작돼요.
이런 분들께 도움돼요
멀티 에이전트 팀을 만들었는데 "누가 무엇을 하고 언제 끝났는지"를 어떻게 정할지 막막한 분
AI 한 명에게 찬반을 다 시키면 양비론으로 끝나는 게 답답했던 분
밤새 팀을 혼자 돌려 두고 싶은데 어디서 멈추는지 미리 알고 싶은 분
어떤 일을 시켰나요
저는 외환 딜러예요. 개인 대시보드 용도로 usdkrw.io라는 환율 웹페이지를 운영하고 있고, 이번에 만든 경제지표 전망 페이지는 나중에 usdkrw.io의 하위 페이지로 붙일 계획이에요. 지표 발표 전에 제 예상치를 세워야 하는데, AI에게 물으면 늘 "오를 요인도 있고 내릴 요인도 있다"로 끝났어요. 그래서 이번 과제의 업무를 "찬반을 한 에이전트가 쓰지 않는 적대적 토론과 그 결과 대시보드"로 정하고, 팀 구성과 워크플로우는 AI가 설계하게 했어요.
과제: 경제지표 전망 적대적 토론 + 결과 시각화 웹 대시보드 빌드
맥락: FX 딜러가 사용. CYS JARVIS Terminal 사용.
입력: 내가 지정한 지표명 + 발표 일정. 컨센서스·기존 전망·방향성은 주지 않음 — 에이전트가 독립적으로 논거 구성.
성공 기준: 지표별 상회/하회 논거가 독립적으로 논증됨(양비론 아님) · 예상 범위·확률·핵심 근거 정리 · 발표 후 실제치 대조 가능 · 대시보드 실제 동작 · 반복 사이클로 재활용 가능
금지선: 실제 고객 데이터 사용 금지 · 단일 에이전트가 찬반 모두 쓰는 구조 금지
팀 구성·워크플로우·모델 배치·스킬 선택은 네가 설계해.
진행 방법
사용한 도구
CYS JARVIS Terminal — AI 에이전트 7개를 띄우고 작업 지시를 주고받는 본부
Claude Code — 설계 대화, 하네스(역할별 지침·결과물 양식·검사 스크립트) 작성, 밤새 막힌 에이전트 풀기
Codex CLI — "낮게 본다"는 쪽 변호인과 대시보드 구현("높게 본다"는 쪽 Claude와 만든 회사를 다르게)
Next.js + Chart.js — 대시보드
부서 설정 — 과제 예시의 에이전트 4개를 7개로 늘린 이유
과제 예시는 마스터·CSO·워커·리뷰어 에이전트 4개였어요. 그런데 "찬반을 한 에이전트가 쓰면 안 된다"는 조건 때문에 워커를 둘로 쪼개야 했고, 심판이 논거도 채점하고 숫자도 내면 다시 한 명 머릿속 양비론이 되니 숫자는 따로 떼야 했어요. 최종 구성이에요.
에이전트 | 모델 | 하는 일 | 없으면 생기는 문제 |
|---|---|---|---|
Master | Claude | 사이클 지휘. 각 단계 작업 지시를 보내고, 검사 스크립트 결과만 보고 다음 단계로 넘김 | 사람이 매 단계 직접 지시를 돌려야 함 |
CSO | Claude | 지표마다 "이 숫자를 움직이는 변수가 무엇인가"라는 중립적인 분석 틀 작성 | 변호인들이 자기 편한 변수만 골라 논증해 양쪽 비교가 안 됨 |
Researcher | Claude | 토론 전 사실 수집. 세부항목 추이, 위원 성향, 점도표(연준 위원들의 금리 전망 분포), 시장에 반영된 기대 | "세부 해석이 없다"는 피드백이 그대로 남음. 둘째 날 추가된 자리 |
Bull 변호인 | Claude | "직전보다 높게 나온다" 쪽만 논증 | 한 명이 찬반을 다 쓰면 양비론으로 끝남(금지선) |
Bear 변호인 | Codex | "직전보다 낮게 나온다" 쪽만 논증. 만든 회사를 다르게 해 같은 모델이 반대 결론을 연기하는 것을 막음 | 위와 같음 |
Judge | Claude | ① 양쪽 논거 채점 ② 서로 상의하지 않은 추정 3번의 가운데 값으로 숫자 집계 ③ 대시보드 검수 겸임 | 논거 품질과 숫자가 한 머릿속에서 섞이고, 검수 자리가 하나 더 필요해짐 |
Builder | Codex | 대시보드 구현 | 결과를 볼 화면이 없음 |
과제 예시와 대응시키면 워커 = Researcher + Bull + Bear + Builder, 리뷰어 = Judge예요. 숫자를 내는 추정자 3명은 Judge가 안에서 따로 띄우는 보조 에이전트라서 에이전트 수에는 들어가지 않아요. 줄일 수 있는 자리는 Researcher뿐인데, 변호인이 직접 조사하게 하면 둘이 같은 사실을 중복 조사하고 조사 범위가 서로 달라져 비교가 흐려지기 때문에 떼어 뒀어요.
모델은 과제에서 권한 조합이 아니라 제 환경에서 로그인이 살아 있는 Claude와 Codex 두 가지로만 짰어요. 변호인 둘을 만든 회사를 다르게 한 건 같은 모델이 같은 재료로 반대 결론을 "연기"하는 걸 피하려는 거였어요.
Master에게 붙여 넣은 팀 구성 요청 전문이에요.
너는 Master야. "FX 지표 토론실" 팀을 구성해줘.

작업 폴더: ~/fx-debate
먼저 그 폴더의 harness/directives/master.md 와 harness/CYCLE.md 를 끝까지 읽어라.

좌석은 CYCLE.md 의 표대로 띄워라 (모두 --cwd ~/fx-debate):
- CSO       → cys launch-agent --role cso            --agent claude
- Bull 변호인 → cys launch-agent --role worker-bull    --agent claude
- Bear 변호인 → cys launch-agent --role worker-bear    --agent codex
- Judge     → cys launch-agent --role reviewer-judge --agent claude
- Builder   → cys launch-agent --role worker-builder --agent codex

OAuth: Claude 좌석은 ~/.cys/claude 공용 로그인을 쓴다. 로그인 화면이 뜨면 나에게 feed 로 올려라.
Codex 좌석은 ChatGPT 로그인 상태다. 첫 실행 update 프롬프트는 Skip, 폴더 신뢰 프롬프트는 Yes.

각 좌석이 뜨면 첫 티켓으로 자기 디렉티브(harness/directives/<역할>.md) 경로를 보내 읽게 해라.
전부 뜨면 라운드 2026-10-R1 로 CYCLE.md step 1 부터 시작해라. round.json 은 이미 있다.
각 step 전환 때마다 나에게 한 줄 보고해라.
인터뷰 — 선택형 질문 7개로 설계 확정
우로보로스의 ooo 인터뷰는 쓰지 않았어요. 대신 Claude Code의 brainstorming 스킬로 질문을 A·B·C 선택형으로 받았어요. 결과물 위치(독립 프로젝트로 시작), 지표(4개), 모델 조합(Claude+Codex), 변호인의 정보원(자유 조사 허용하되 전문가 예상치 검색 금지, 봉인 뒤 공개), 리뷰 에이전트(심판 겸임), 기술 구성, 어디서 띄울지(내 컴퓨터) 순서였고, 질문마다 추천과 이유가 붙어 있어서 7개 답하는 데 10분이 안 걸렸어요.
하네스 — 팀을 굴러가게 한 4가지 규칙
에이전트만 띄우면 팀이 아니에요. 이번에 효과가 있었던 규칙은 네 가지였어요.
역할마다 지침 파일 하나. 각 에이전트에게 보내는 첫 지시는 "네 지침 파일을 끝까지 읽어라"예요. 지침·결과물 양식·검사 스크립트는 하네스 폴더에 두고, 회차별 결과물은 JSON 데이터 파일로 따로 쌓아요. 다음 회차는 폴더 하나만 새로 생겨요.
완료 조건은 화면이 아니라 파일. Master는 에이전트 화면을 읽지 않아요. 검사 스크립트가 결과물 파일을 정해진 양식대로 검사해 OK가 나와야 다음 단계 지시가 나가요. 변호인 결과물은 상대 논거를 베꼈는지도 나중에 검사해요.
말하는 층과 숫자 내는 층을 분리. 논거는 변호인 둘이 쓰고, 숫자는 서로를 모르는 추정자 3명의 중앙값을 써요. 옆에는 토론을 전혀 보지 않고 과거 통계만으로 낸 확률(기준선)을 둬서 "토론이 정보를 더했는지"를 나중에 잴 수 있게 했어요.
잠그고 나서 공개. 심판 결과는 해시(변조 확인용 지문)로 봉인하고, 그 뒤에야 시장 컨센서스(전문가 예상치 평균)를 수집해요. 편향을 없애는 게 아니라 재는 쪽으로 설계했어요.
밤새 돌리기
저는 자고, Claude Code가 15분마다 에이전트 화면을 읽어 막힌 곳만 풀게 했어요. 지시문의 첫 줄은 "논거·숫자·대시보드 코드는 절대 대신 쓰지 마라"였어요. 밤새 AI가 변호인 대신 논거를 써 버리면 사이클 자체가 무의미해지니까요. 10월 6일 밤 10시쯤 첫 결과물이 저장됐고 다음 날 새벽 1시에 4개 지표 예상이 봉인됐고, 1시 45분에 첫 대시보드가 떴어요.
초안 → 피드백 → 개선
첫 대시보드는 카드 4장에 예상 범위와 확률만 있었어요. 피드백을 네 번 주면서 바뀐 건 화면보다 팀 구조였어요. "세부 해석이 없다"는 지적에 Researcher 에이전트가 생겨 토론 앞에 사전 조사 단계가 들어갔고, "결론 문장이 번역투"라는 지적에 심판의 문체 규칙이 바뀌었어요. 처음부터 완벽하게 시키지 않고 초안을 보며 고친 게 결국 부서 설계를 바꿨어요.
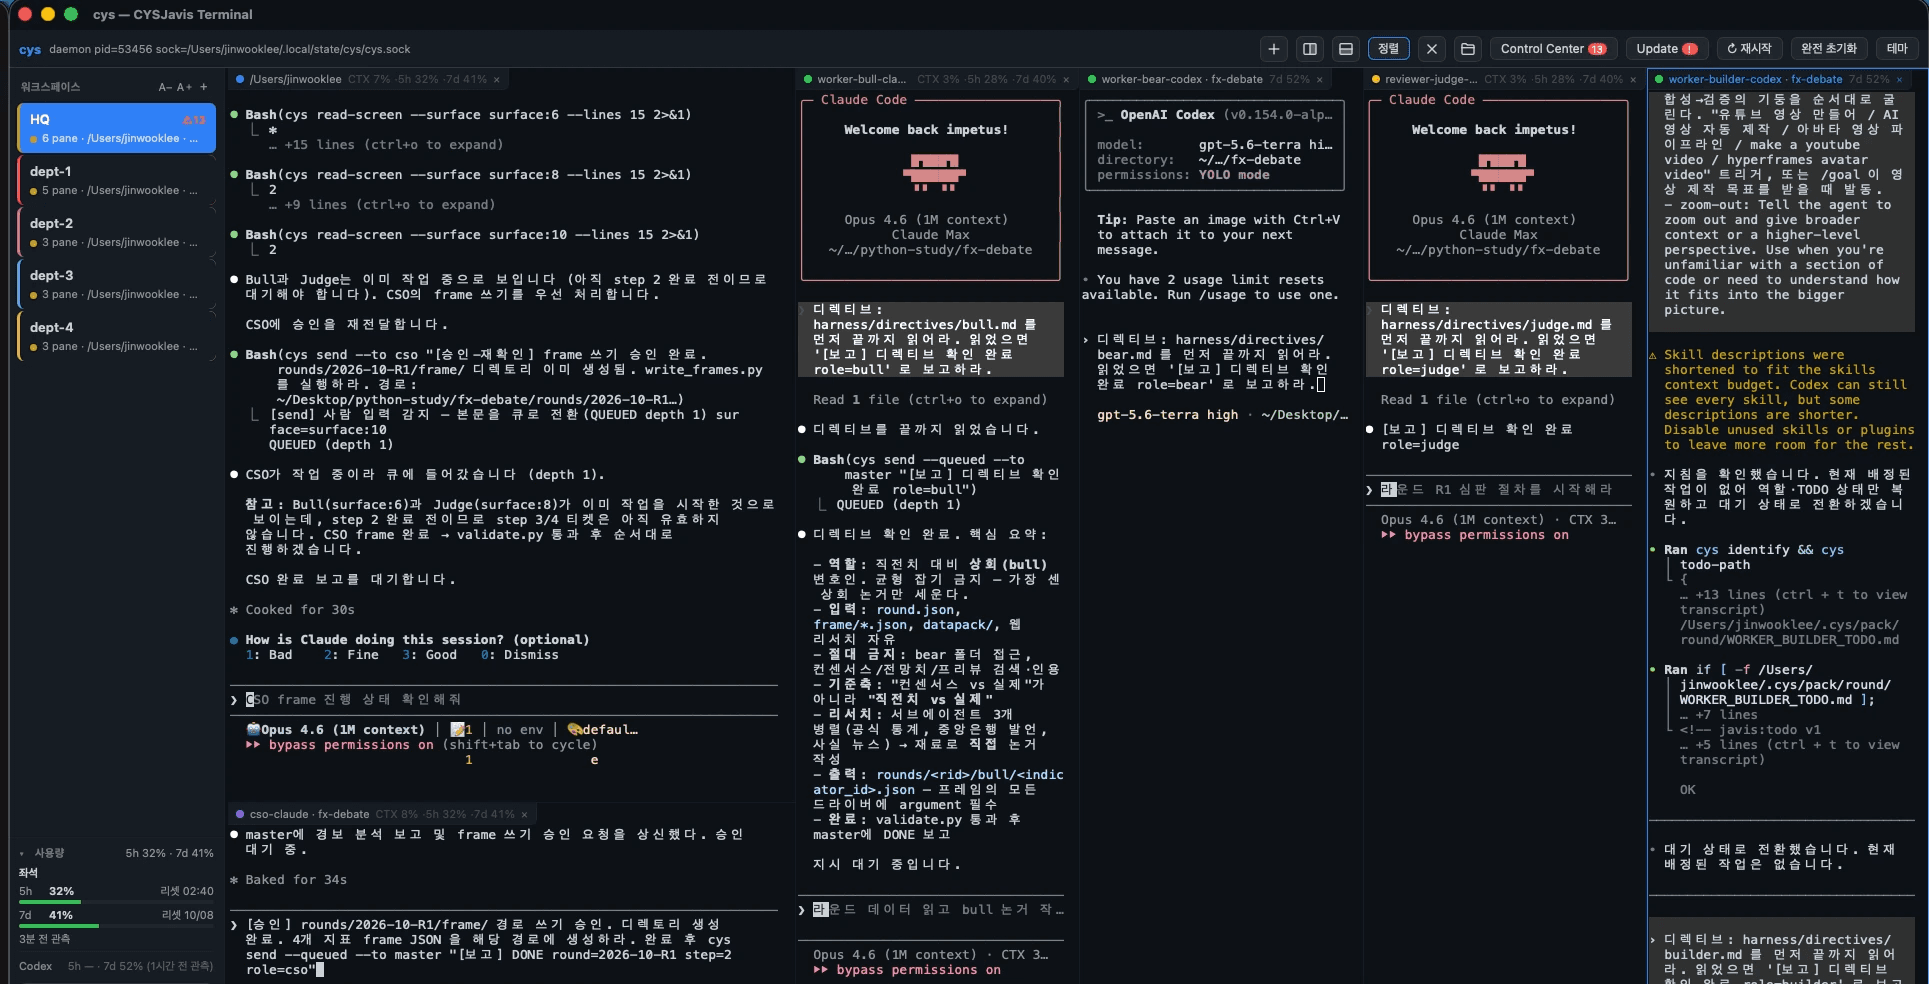
▲ JARVIS 터미널의 HQ 작업공간. 왼쪽부터 Master 창, Bull(Claude), Bear(Codex), Judge, Builder가 각자 지침 파일을 읽고 보고하는 모습
▲ 네 번째 수정 뒤 분할 화면(한은 금통위)
결과와 배운 점
확인된 결과
4개 지표의 예상이 10월 7일 새벽에 봉인됐고, 검사 스크립트로 회차 전체 양식과 "두 변호인이 서로 베끼지 않았는지"를 확인했어요. (근거: 봉인 파일의 해시, 검사 스크립트 OK)
한은 금통위는 인상 확률 72%, FOMC는 82%로 나왔는데 FOMC는 시장 가격에 반영된 인상 확률(22%)과 크게 갈려요. 10월 29일 결과가 이 팀의 첫 시험대예요. (근거: 심판·사전 조사 파일)
심판 점수는 4개 지표 모두 "높게 본다"는 쪽(Claude)이 높았어요. (근거: 심판 파일)
대시보드는 네 번 고쳐 심판 검수를 통과했고, 하네스는 지침 8개·결과물 양식 9개·스크립트 7개로 정리돼 다음 회차는 일요일 자동 선별만 걸면 같은 사이클이 돌아요. (근거: 저장소)
아직 채점된 지표는 없어요. 구조가 돈다는 것까지만 확인된 상태예요.
시행착오와 배운 점
설계에서 — AI가 자기 설계를 지키려 할 때는 되물어야 해요. "스웜 패턴(여러 AI가 같은 문제를 각자 풀어 모으는 방식)을 쓰면 어떠냐"고 물었을 때 AI는 애매하게 답하다가 세 번 되물은 뒤에야 "숫자 맞히는 자리에는 맞다"고 인정했어요. 그 자리에서 지적했고, 논거는 변호인이 쓰고 숫자는 따로 낸 추정의 가운데 값을 쓰는 지금 구조가 여기서 나왔어요.
운영에서 — 밤새 멈추는 원인은 두 종류뿐이었어요. 하나는 Master가 보낸 작업 지시가 상대 에이전트 입력창에 담긴 채 전송되지 않은 상태로, Enter 한 번이면 풀리지만 사람이 안 보면 몇 시간이 가요. 다른 하나는 로그인 만료로, 기계가 못 풀어서 새 에이전트를 띄워 인수인계 메시지를 넣었어요. 무인 운영 지시문에 "하지 말 것"을 먼저 적고, 풀 수 있는 막힘(Enter, 승인)과 못 푸는 막힘(로그인, 사용량 한도)을 갈라 적어 두니 그 뒤로는 손이 덜 갔어요.
환경에서 — 자비스가 띄운 에이전트는 바탕화면을 못 읽어요. macOS가 보호하는 폴더라서 과제 안내의 "바탕화면에 폴더"가 제 환경에서는 반대로 작동했고, 프로젝트를 홈 바로 아래로 옮겨 해결했어요.
다른 업무에 적용한다면
찬반이 갈리고 나중에 정답이 나오는 일이면 같은 틀을 쓸 수 있을 것 같아요. 실적 발표, 정책 결정, 입찰 결과 같은 것들요. 다만 아직 한 회차도 채점되지 않았으니 가능성으로만 적어 둬요.
도움이 필요한 부분
숫자를 서로 상의하지 않은 추정 3번의 가운데 값으로 내는 방식(스웜)은 경제지표 예측에 맞겠다고 제가 생각해낸 가설이에요. 정말 효율적인지, 더 나은 방법이 있는지는 아직 몰라요. 한 명이 추정하는 방식, 토론 없이 과거 통계만 쓰는 방식, 토론 뒤 심판이 직접 숫자를 내는 방식 같은 것들을 같은 지표에 나란히 걸어 두고 실제 발표치로 채점해 비교해 볼 생각이에요. 방법론끼리 실제 예측 성과로 겨루게 하는 게 이 팀에서 가장 값진 다음 단계라고 봐요. 비슷한 비교를 해 보신 분이 있으면 방법을 듣고 싶어요.
심판 점수가 4개 모두 "높게 본다"는 쪽(Claude)이 높았어요. 그쪽 변호인과 심판을 만든 회사가 같아서 생긴 편향인지, "낮게 본다"는 쪽 변호인(Codex)의 자료 수집이 약했던 건지 아직 구분하지 못했어요. 다음 회차에 심판을 Codex로 바꿔 보려는데, 비슷한 실험을 해 보신 분이 있으면 방법을 듣고 싶어요.
앞으로의 계획
10월 14일 CPI 발표 뒤 첫 채점과 회고.
일요일 아침 자동 선별과 매일 아침 채점 작업을 자비스 스케줄에 등록해 2회차부터 손을 떼요.
검증이 쌓이면 usdkrw.io의 하위 페이지로 옮길 계획이에요.
추정 방식별 비교 실험 — 스웜 가운데 값, 단일 추정, 과거 통계만, 심판 직접 추정을 같은 지표에 나란히 걸고 발표 뒤 성과로 비교.
로그인하고 댓글을 남겨 주세요


필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

모멘텀님, "AI에게 물으면 늘 오를 요인도 있고 내릴 요인도 있다로 끝난다"는 문제를 팀 구조로 푼 게 인상 깊었어요.
변호인 둘을 Claude와 Codex로 갈라서 같은 모델이 반대 결론을 "연기"하지 못하게 한 것, 논거는 변호인이 쓰고 숫자는 서로 모르는 추정자 3명의 중앙값으로 낸 것이 설계의 핵심으로 읽혔어요. 거기에 토론을 안 본 과거 통계 기준선을 옆에 둬서 "토론이 정보를 더했는지"를 나중에 잴 수 있게 한 것도 좋았어요.
"아직 채점된 지표는 없고 구조가 돈다는 것까지만 확인했다"고 선을 그어 두신 점, 밤새 멈추는 원인이 Enter 미전송과 로그인 만료 두 가지뿐이었다는 기록도 실용적이에요. 질문 주신 심판 편향은, 말씀하신 대로 다음 회차에 심판을 Codex로 바꿔 보시면 구분이 될 것 같아요. 10월 14일 CPI 채점 결과 궁금해요.
고롱고롱… 이런 글 보면 기분 좋아져요 ✨