클래스와 관계 기준으로 지식 허브의 모델 노트 옮겨 보기
2026.10.14
소개
2주차 강의가 정한 세 재료(값, 클래스, 관계)와 열린 세계 가정을 기준으로, 제 지식 허브의 바이오 파운데이션 모델 노트 4개를 JSON 온톨로지로 옮기고 그 결과를 위키 노트와 비교했습니다. 같은 날 1주차와 같은 정의로 허브를 다시 세어 구조 개편 전후의 값도 나란히 두었습니다. 노트는 쌓았는데 온톨로지를 붙일 만큼 쌓였는지 판단이 서지 않는 분께 권합니다.
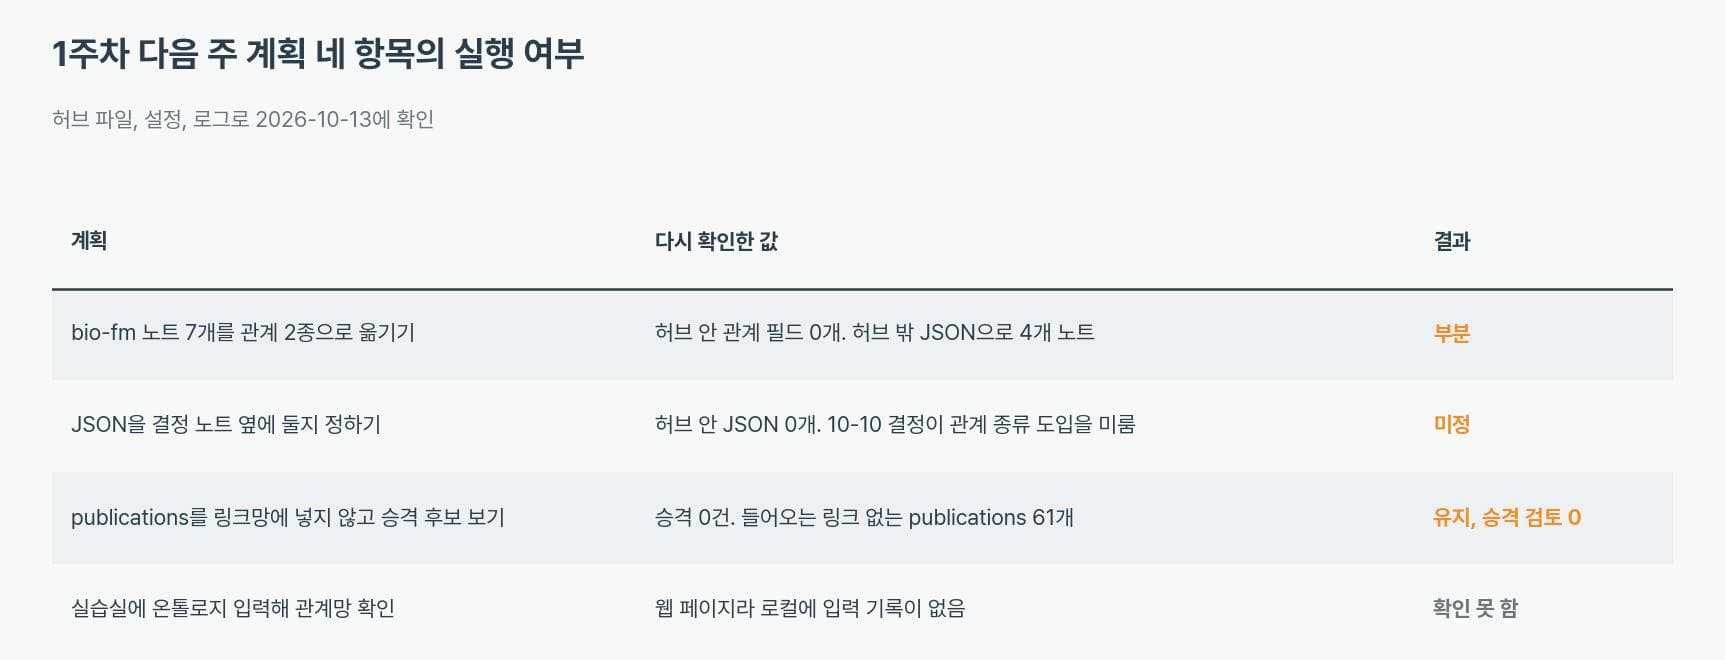
1주차에는 허브의 노트 141개를 세어 링크 326건은 있어도 이름 붙은 관계는 0건이라는 것을 확인했고, 다음 주 계획 네 가지를 적어 두었습니다. 2주차 강의는 새 이론을 다루지 않았습니다. 스터디장 DECK이 자기 경력으로 만든 개인 온톨로지를 보여 주었고, 인터뷰 스킬로 각자 개인 온톨로지를 시작하게 한 뒤 참여자 네 명이 1주차 과제를 발표했습니다.
저는 청강생이라 인터뷰 스킬 파일을 받아 설치하지는 않았습니다. 대신 인터뷰로 시작하는 개인 온톨로지와 같은 구조(값, 클래스, 관계)를 제 허브에서 가장 정리가 잘 된 주제인 바이오 파운데이션 모델 노트에 적용했습니다. 이 글은 그 작업을 명령어로 측정한 기록입니다. 허브 파일은 읽기만 했고 아무것도 바꾸지 않았으며, 산출물은 이 스터디 폴더에만 두었습니다.
진행 방법
사용 도구: Claude Code, Python 3, grep, git(status, log 읽기만)
측정일은 2026-10-13입니다. 허브는 10월 10일에 raw/, wiki/, schema.md, purpose.md로 구성된 세 층 구조로 개편되었고, 이 시점에 아직 커밋 전입니다.
cd ~/knowledge-hub
git status --short | wc -l
147
커밋하지 않은 변경이 147건이므로 1주차 시점(10월 2일)의 스냅샷으로 되돌아가 비교할 수는 없습니다. 1주차 값은 1주차 글에 적은 값을 그대로 쓰고, 이번 값은 같은 정의로 다시 짠 스크립트(assets/measure_hub.py, 107줄)로 구했습니다.
Step 1. 2주차 강의가 정한 기준
스터디장이 짚은 내용 가운데 허브에 대 볼 수 있는 것을 세 가지로 추렸습니다.
강의에서 나온 말 | 허브에서 재는 방법 |
|---|---|
온톨로지의 핵심은 값, 그 값을 정의하는 클래스, 클래스와 값 사이를 잇는 관계 세 가지 | 모델 노트에서 이 세 재료를 뽑아 JSON으로 만든다 |
온톨로지는 열린 세계가 기본이라, 적히지 않은 정보는 "없다"가 아니라 "모른다" | 값을 알 수 없는 칸을 "없음"으로 적지 않고 별도 상태로 둔다 |
스터디장의 지식 베이스에는 관계가 한쪽으로만 이어진 노드가 많고, 직업 노드는 본인 말고 연결이 없었다 | 노트가 들어오는 링크와 나가는 링크 중 어느 한쪽만 가졌는지 센다 |
네 번째 발표(정책자금 공고)는 같은 데이터에 질문 유형별로 네 방식을 비교했습니다. 온톨로지로 분류한 결과에서 뽑은 질문은 온톨로지가 높았고, 원문 한 문서에서 뽑은 질문은 RAG가 높았다고 했습니다. 스터디장은 온톨로지와 위키를 "상호 보완적으로 사용"하라고 정리했습니다. 이 구분을 Step 6에서 허브에 적용했습니다.
Step 2. 1주차 계획 네 가지의 실행 여부
1주차 글 뒤에 적은 계획을 파일과 설정으로 확인했습니다.
cd ~/knowledge-hub
find . -name "*.json" -not -path "./.git/*" -not -path "./raw/*"
head -9 wiki/literature/bio-fm-single-cell.md | grep -E '^(type|related|relations|part_of):'
grep -rl "source-analysis" wiki projects pointers _meta
./.okf-lint.json
./.obsidian/app.json
./publications/bric/.claude/settings.local.json
type: analysis
wiki/evolution/lint/2026-10-10.md
JSON 세 개는 모두 도구 설정이고 온톨로지는 없습니다. 모델 노트의 프론트매터에는 type만 있고 관계 필드가 없습니다. 출처 분석 폴더를 가리키는 노트는 lint 리포트 하나뿐이라 publications를 합성 레인으로 승격하는 검토도 진행되지 않았습니다.
계획에 있던 JSON 위치는 정하지 못했습니다. 10월 10일에 허브에 들어간 결정 노트(graph-rag-and-ontology-deferred.md)가 "관계 종류를 프론트매터 키로 박는 온톨로지는 채택하지 않는다"고 이미 적고 있어서, 1주차 계획이 그 결정과 부딪힙니다. 어느 쪽을 따를지는 Step 6 뒤에 다시 다룹니다. 실습실 입력은 웹 페이지에서 한 일이라 로컬에 기록이 없어 실행 여부를 확인하지 못했습니다.
Step 3. 개편 전후, 같은 정의로 다시 센 허브
1주차에 쓴 정의(측정 대상 노트는 노션 덤프 604개, 설정 4개, 레인 index.md를 뺀 나머지, 한글 경로는 NFC 정규화)를 그대로 적용했습니다.
python3 -I assets/measure_hub.py
md total 781 notion 604 settings 4 index 17 notes 156
synth lane 65 Counter({'projects': 16, 'wiki/literature': 16, 'wiki/playbooks': 12, 'pointers': 7, ...})
md links (src,dst) unique 426 wikilinks 6 broken 6
note->note edges 228
within syn 184
no inbound 65 Counter({'publications': 61, '_private': 3, 'CLAUDE.md': 1})
fm relation field notes 5
typed link lines 0
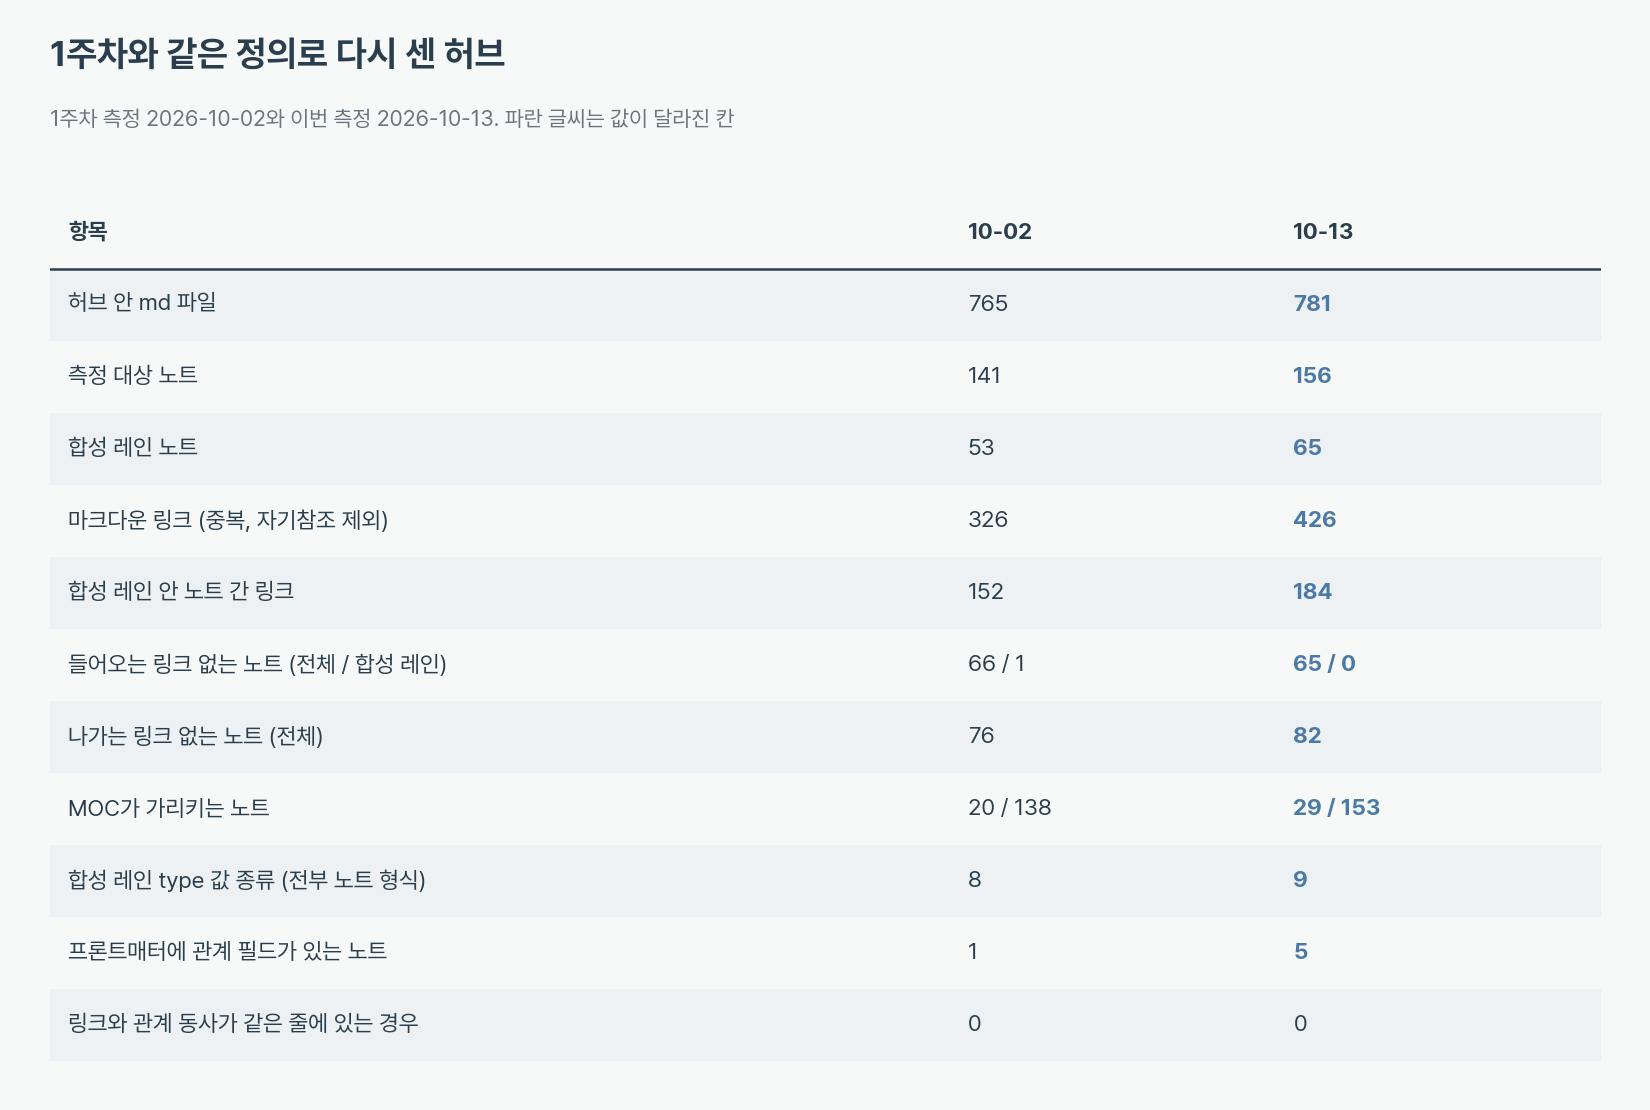
값이 달라진 이유를 파일과 로그로 확인했습니다.
노트 15개 증가. 허브
log.md의 10월 10일 항목에 AX 코칭 워크스페이스 승격 신규 8개, 결정 노트 1개, 메일 백업 포인터 1개, lint 리포트 1개가 적혀 있고, 개편으로purpose.md와schema.md가 생겼습니다. 합하면 13개입니다. 나머지 2개(projects 1개, publications 1개)는 로그에서 찾지 못했습니다.합성 레인에서 들어오는 링크 없는 노트 1개가 0개로. 1주차에 하나였던
_meta/success-formula.md를 새로 생긴purpose.md가 가리킵니다.깨진 링크 8건이 6건으로. 6건은 index 안내 주석의 자리표시(
/파일.md3건), 로그와 슬라이드의 예시 문구(/path.md2건,/topics/AI.md1건)입니다. 폴더를 옮긴 뒤 실제로 깨진 링크는 0건이고, 허브 로그의 "옛 경로 링크 0건" 기록과 맞습니다.링크 326건이 426건으로. 증가분 100건을 나누려면 10월 2일 시점의 노트별 링크가 필요한데 스냅샷이 없어 원인을 모릅니다. 현재 index 파일이 낸 링크가 136건이라는 것만 확인했습니다.
관계 필드 1개가 5개로. 늘어난 4개는 모두
related: [경로 목록]입니다. 무엇과 어떻게 관련되는지 이름이 없는 목록이라 이름 붙은 관계는superseded_by1건 그대로입니다.
Step 4. 한쪽으로만 이어진 노트
스터디장의 직업 노드처럼 한쪽 연결만 가진 노트를 셌습니다. 1주차와 같은 정의로 들어오는 링크는 index를 포함하고 나가는 링크는 노트에서만 셉니다.
python3 -I assets/measure_hub.py | grep -E "one-sided|syn no outbound"
one-sided 27 isolated(both 0) 60 both>0 69
syn one-sided 9 isolated 0 connected both 56
oth one-sided 18 isolated 60 connected both 13
syn no outbound [... 'projects/niep.md', 'projects/econ-radar.md', 'projects/vital-storm.md', ...]
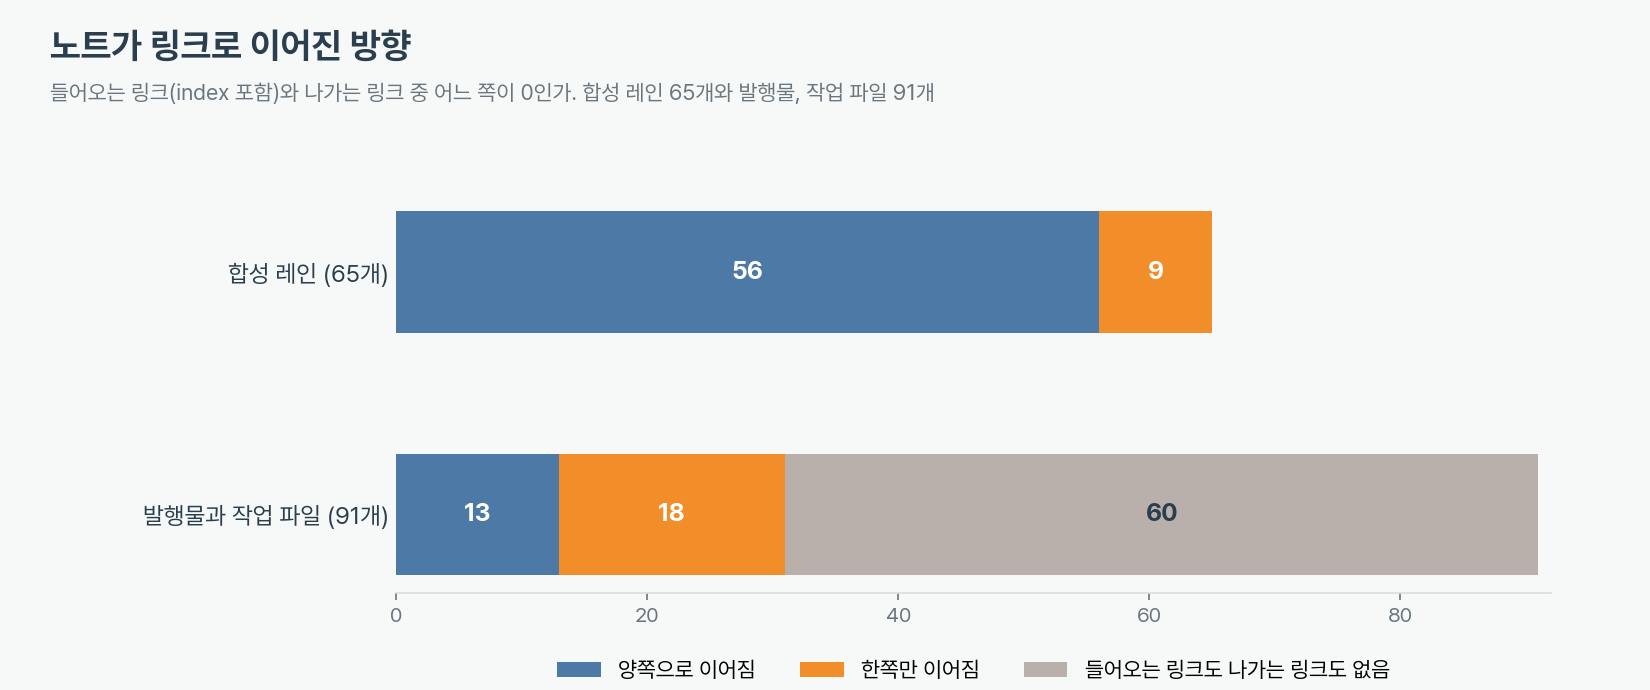
합성 레인 9개는 전부 들어오기만 하고 나가지 않는 노트입니다. 프로젝트 3개, 절차 2개, 포인터 2개, 결정과 평가 각 1개로, 요약만 하고 다른 노트로 이어 주지 않은 종점입니다. 발행물과 작업 파일은 91개 중 60개가 양쪽 링크 모두 없습니다. 1주차에 확인한 구분(합성 레인은 이어져 있고 발행물은 링크망 밖)이 개편 뒤에도 같습니다.
Step 5. 모델 노트 4개를 값, 클래스, 관계로 옮기기
1주차 계획의 첫 항목입니다. 계열이 모델을 "포함한다", 모델이 데이터셋을 "학습했다"는 관계 2종으로 정했습니다. 노트 7개 가운데 모델 표가 있는 4개(서열·유전체, 단일세포, 병리·의료영상, 합성 인핸서)만 옮겼습니다. 암 유전체, 임상 다중모달, 분류 기준 노트는 모델 표가 없거나 서술형이라 이번에는 제외했습니다.
for head, cells in tables(text):          # 첫 열이 "모델"인 표만
    name = re.sub(r"\s*\[\d+\]", "", cells[0]).strip()
    relations.append({"from": fid, "rel": "포함한다", "to": "M:" + name})
    if head[1] == "학습 데이터":
        relations.append({"from": "M:" + name, "rel": "학습했다", "to": "D:" + name})
python3 -I assets/bio_fm_ontology.py
entities 52 {'Family': 4, 'Model': 26, 'Dataset': 22} relations 48 {'포함한다': 26, '학습했다': 22}
model data_status {'described': 17, 'unstated': 2, 'named': 3, 'no_data_column': 4}
Dataset nodes with degree 1: 22
클래스 3개, 개체 52개, 이름 붙은 관계 48건입니다. 산출물은 24기AI지식관리_2주차_과제_bio-fm온톨로지.json이고 world: open을 적어 두었습니다.
{"id": "M:Geneformer", "class": "Model", "name": "Geneformer", "data_status": "named"},
{"id": "D:Geneformer", "class": "Dataset", "name": "약 3,000만 세포 (Genecorpus-30M)", "named": "Genecorpus-30M"},
{"from": "M:Geneformer", "rel": "학습했다", "to": "D:Geneformer"}
열린 세계 가정을 data_status 필드로 옮겼습니다. 학습 데이터 칸의 내용을 읽고 네 가지로 나눴으며, 이 분류는 제가 직접 판단했습니다. 칸에 데이터셋이나 기관 이름이 있는 모델이 3개, 규모와 종류만 있는 모델이 17개, 괄호 추정(Caduceus)이거나 앞 모델과의 차이만 적은(Virchow2) 모델이 2개, 표에 학습 데이터 칸 자체가 없는 모델이 4개였습니다.
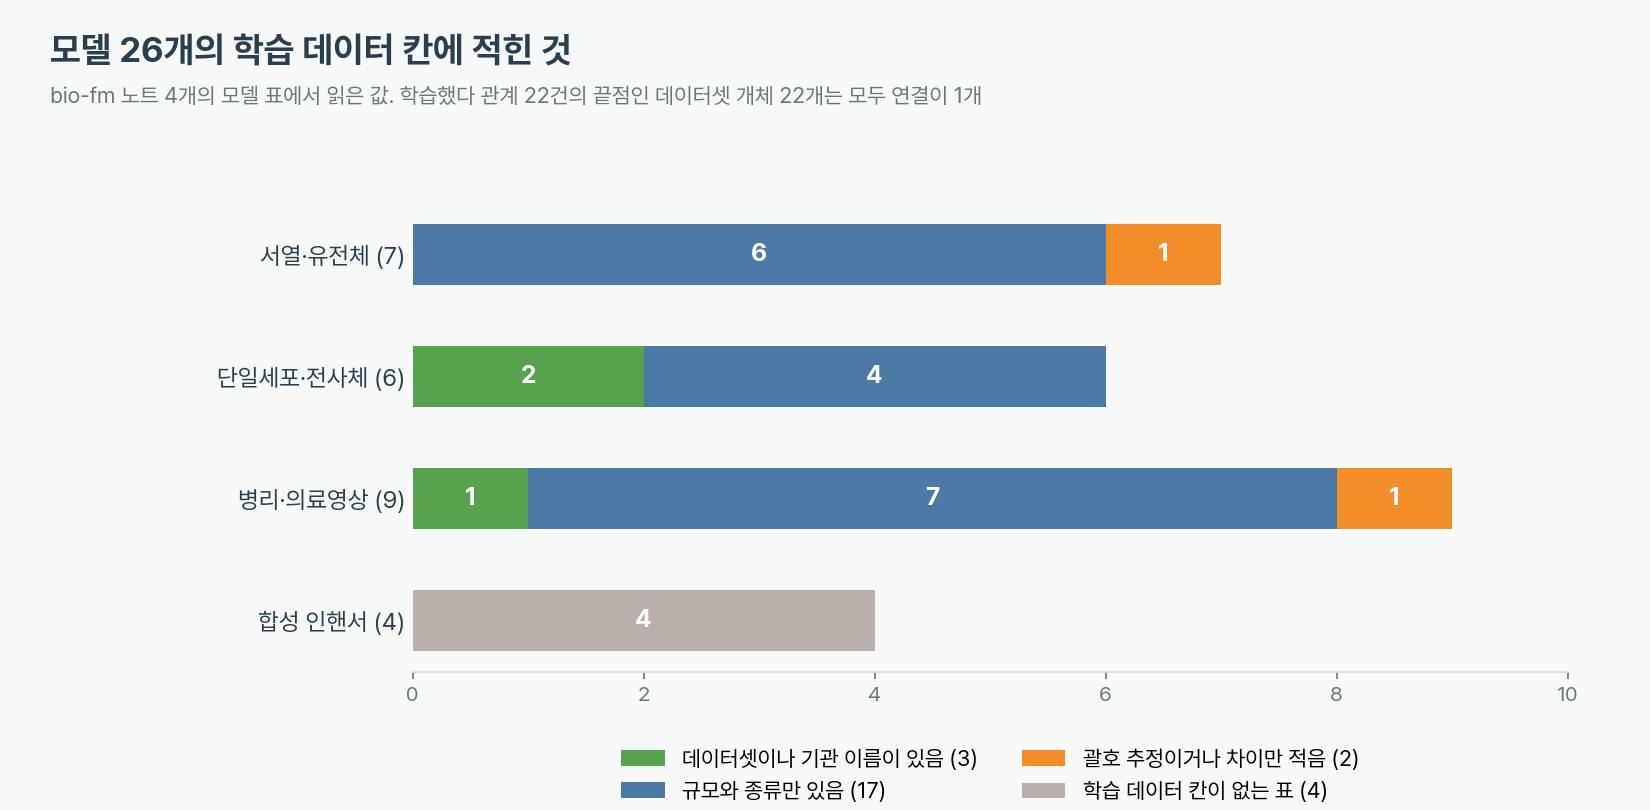
값을 모르면 "없음"이 아니라 "모름"으로 두어야 한다는 강의 말이 이 표에서 구체적으로 보였습니다. 닫힌 세계로 읽으면 22개 중 19개가 "학습한 데이터셋 없음"이 됩니다.
Step 6. 질문 세 개를 JSON과 위키에 물어보기
발표 4의 질문 유형 구분을 따라, 분류로 답이 나오는 질문과 개체를 공유해야 하는 질문과 원문을 읽어야 하는 질문을 하나씩 정했습니다. 위키 쪽은 bio-fm-*.md 노트에 grep으로 단서를 찾았습니다.
cd ~/knowledge-hub/wiki/literature
grep -cE 'Genecorpus|cellxgene|Providence' bio-fm-*.md   # 파일별 줄 수
grep -cE 'Evo 2' bio-fm-sequence-genome.md
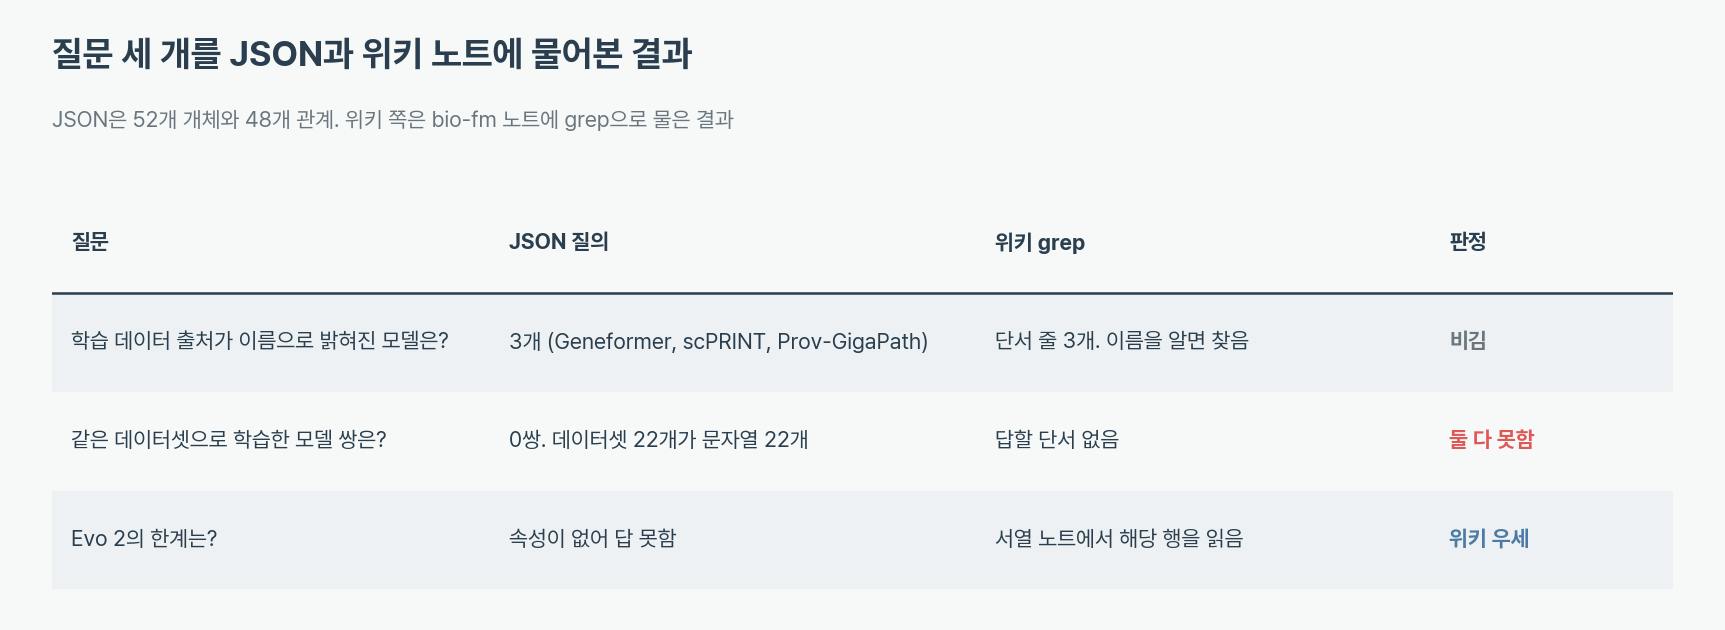
첫 질문은 JSON이 3개를 바로 내놓고 위키도 줄 3개를 찾아 줍니다. 이름을 알고 있어야 grep이 되므로 위키가 약간 불리하지만 결과는 같았습니다. 둘째 질문은 JSON이 0쌍을 냈는데, 데이터셋 22개가 모두 서로 다른 문자열이라 개체로 합쳐지지 않았기 때문입니다. 실제로 같은 데이터를 쓴 모델이 없다는 뜻이 아니고, 열린 세계에서는 "모른다"가 맞는 답입니다. 셋째 질문은 JSON에 한계 속성이 없어 답하지 못했고 위키는 표의 해당 행을 읽어 답했습니다.
허브의 보류 결정이 걸어 둔 재검토 조건도 확인했습니다. 추적 노트가 500개를 넘거나, index 탐색으로 못 찾은 질의를 log.md에 한 달 세 건 이상 남기는 것이 조건입니다.
grep -cE '^\s*- \*\*query\*\*' log.md
0
노트는 156개(결정 노트가 기록한 추적 노트는 10월 10일 기준 152개)로 500개의 약 3분의 1이고, 미발견 질의 기록은 0건입니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
측정 대상 노트 | 156개 (md 781개 중 노션 덤프 604개, index 17개, 설정 4개 제외). 1주차 141개 |
마크다운 링크 | 426건. 1주차 326건 |
이름 붙은 관계 (허브 안) | 프론트매터 |
합성 레인 65개의 연결 | 양쪽 56개, 한쪽만 9개, 어느 쪽도 없음 0개 |
1주차 계획 네 항목 | 허브 안 실행 0건. 허브 밖 JSON 1건(노트 7개 중 4개), 확인 못 함 1건 |
모델 노트 4개의 온톨로지 | 클래스 3, 개체 52, 관계 48. 데이터셋 개체 22개가 모두 연결 1개 |
학습 데이터 칸에 이름이 있는 모델 | 22개 중 3개. 같은 데이터셋을 공유하는 모델 쌍은 0쌍(모름) |
배운 점
링크는 늘었고 관계는 그대로였습니다. 열흘 사이에 링크가 100건 늘고 프론트매터 관계 필드가 1개에서 5개가 되었는데, 이름 붙은 관계는 여전히 1건입니다. 개편에서
related필드를 추가한 것이 관계를 기계가 읽게 만든 첫걸음이지만, 강의의 기준으로는 "필요로 한다"를 적은 것이 아니라 "관련 문서" 목록을 구조화한 것에 가깝습니다.온톨로지로 옮기는 일은 개체를 만드는 일이었습니다. 모델은 이름이 있어 개체가 되었지만 데이터셋은 칸에 "5,000만 세포 이상" 같은 서술만 있어 개체가 되지 못했습니다. 22개 중 이름이 있는 3개만 다른 노드와 이어질 수 있고, 나머지는 연결이 1개뿐인 끝점입니다. 스터디장 시연의 직업 노드와 같은 모양입니다. 관계 이름을 정하기 전에 개체의 이름이 먼저 필요했습니다.
같은 노트에서 온톨로지가 이기는 질문과 위키가 이기는 질문이 달랐습니다. 이름이 밝혀진 모델을 묻는 질문은 비겼고, 속성이 없는 한계를 묻는 질문은 위키만 답했습니다. 발표 4에서 원문 질문은 RAG가 높고 분류 질문은 온톨로지가 높았다는 결과와 같은 방향입니다. 스터디장이 말한 보완 관계를 제 허브의 주제 하나로 재 보니, 질문 유형마다 알맞은 도구가 달랐습니다.
허브의 보류 결정은 이번 측정으로 뒤집히지 않았습니다. 재검토 조건(노트 500개, 미발견 질의 월 3건)에 156개와 0건이 닿지 않았습니다. 모델 노트 4개를 옮기는 데는 82줄짜리 스크립트 하나로 충분했고 결과는 허브 밖에 두었습니다. 1주차 계획(JSON을 결정 노트 옆에 두기)을 실행하려면 이 결정을 고치는 선택을 먼저 해야 하므로 판단은 미뤘습니다.
측정 정의를 고정해 두면 개편을 비교할 수 있었습니다. 폴더가 바뀌고 노트가 15개 늘어도 같은 정의 덕분에 변한 값과 변하지 않은 값이 갈렸습니다. 다만 스냅샷이 없으면 증가분의 원인을 나누지 못한다는 것도 이번에 알았습니다. 다음 측정부터는 측정 직전에 허브를 커밋하거나 노트 목록을 따로 저장해 두려고 합니다.
시행착오
처음에는 들어오는 링크를 노트에서만 세서 합성 레인의 "들어오는 링크 없는 노트"가 7개로 나왔습니다. 1주차는 index 파일에서 오는 링크도 세었습니다. 정의를 맞추자 0개가 되었고 전체는 66개에서 65개로 1주차와 비슷하게 맞았습니다.
1주차 글에 적은 "합성 레인 노트당 평균 3.9건"은 이번에 다시 계산하면 맞지 않았습니다. 합성 레인 안 링크 152건을 노트 53개로 나누면 2.9건입니다. 3.9가 어떻게 나왔는지는 기록이 없어 알 수 없고, 이번에는 평균을 쓰지 않았습니다.
모델 표의 학습 데이터 칸을 네 가지 상태로 나눈 것은 자동 규칙이 아니라 제가 읽고 정한 목록입니다. Caduceus와 Virchow2를 "불명"으로 본 것이 대표적이며, 다르게 판단하면 17개와 2개가 바뀝니다.
위키 grep의 "단서 줄 3개"는 파일마다 줄 수를 센 값이어서 모델 3개와 우연히 맞았습니다. 한 줄에 모델이 둘 이상 있었다면 달랐을 수 있습니다.
이 측정은 2026-10-13에 ~/knowledge-hub의 md 781개 가운데 노션 덤프 604개, 레인 index 17개, 설정 4개를 뺀 노트 156개와 index 파일의 링크 426건, 그리고 wiki/literature/bio-fm-* 노트 4개의 모델 표 26행을 Python과 grep으로 센 결과입니다. 노션 덤프의 내용, 모델 표가 없는 노트 3개, 1주차 시점의 노트별 링크는 보지 않았습니다. 개인 온톨로지 인터뷰 스킬은 실행하지 않았습니다.
도움 받은 글
24기 AI지식관리 2주차 강의 (스터디장 DECK): 값, 클래스, 관계 세 재료, 열린 세계 가정, 한쪽으로만 이어진 노드를 보여 준 개인 온톨로지 시연, "온톨로지와 위키는 상호 보완"이라는 정리, 정책자금 공고 사례의 질문 유형별 비교
24기 AI지식관리 1주차 사례글 (본인): 이번에 다시 센 지표와 정의, 다음 주 계획 네 가지
허브의 결정 노트
graph-rag-and-ontology-deferred.md(본인, 2026-10-10): 관계 종류 도입을 미루는 결정과 재검토 조건

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


결과가 0쌍이면 저는 곧바로 같은 데이터를 쓴 모델이 없다고 읽을 뻔했어요. 이름을 맞춰 연결하지 못한 상태일 수도 있다는 데서, 숫자 0만 보고 제가 내리려던 결론을 멈추게 됐습니다.