개인 블로그의 이미지, 글 연결, 스킬화 상태 점검하기
2026.10.15
소개
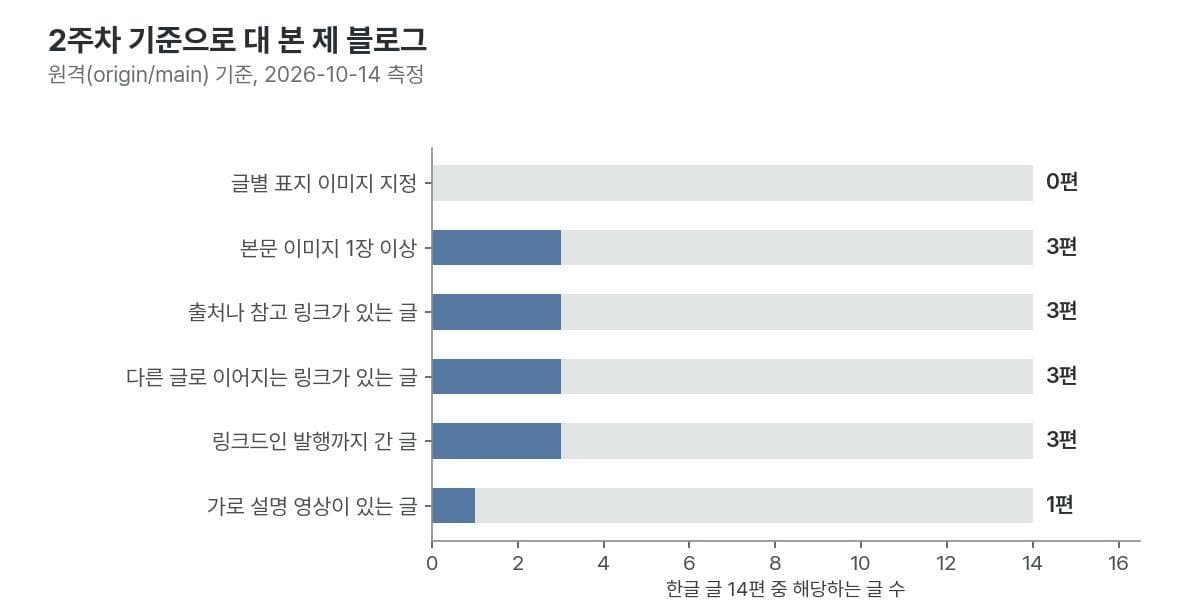
블로그 글에 AI로 이미지를 붙이고 글 쓰는 과정을 스킬로 묶기 전에, 내 블로그가 지금 어디까지 와 있는지 2주차 강의 기준으로 재 보았습니다. 한글 글 14편 가운데 글별 표지는 0편이었고, 본문 이미지 27장 중 두 글 이상이 함께 쓴 이미지도 0장이었습니다. 블로그를 꾸준히 운영하면서 글마다 이미지를 새로 만들어야 하나, 이 작업을 스킬로 굳히면 무엇이 달라지나 고민하는 분께 도움이 될 것 같습니다.
청강생으로 24기 콘텐츠발행자동화 2주차(2026-10-08)를 들었습니다. 이안 스터디장의 강의는 지난주 키워드 분석기가 고른 글감 하나로 글, 이미지, HTML을 만들고 그 과정을 스킬로 묶는 순서였습니다. 이미지는 예전 이미지 폴더에서 재사용할 수 있는지 먼저 보고, 새로 만들 때는 한 장으로 톤을 맞춘 뒤 나머지를 같은 톤으로 만들며, 커버에는 한글을 넣지 않고 제목은 나중에 얹으라는 기준을 줬습니다. 만든 글과 이미지와 키워드 결과는 한 번 쓰고 버리지 말고 폴더에 계속 쌓으라는 말도 했습니다.
조셉 조 공동 스터디장은 네이버의 C-Rank(블로그가 한 주제에 집중하는지, 글이 다음 글로 이어지는지)와 D.I.A.(글 한 편에 직접 해 본 흔적이 있는지), 구글의 E-E-A-T를 짚었습니다. 그리고 AI의 속도 위에 내 경험을 얹지 않으면 확장성도 평균에 머문다는 취지로 이렇게 정리했습니다.
AI는 평균과 속도로 나한테 제공해 주지만 결국 내가 해 줄 건 뭐냐면 나의 구체성을 만들어 줘야 된다는 겁니다.
이번 주 과제(글감 하나로 글, 이미지, HTML을 만들고 스킬로 묶기)는 청강이라 제출하지 않았습니다. 대신 1주차에 쓴 측정 방식을 그대로 다시 돌려 이 블로그에 이미지와 연결, 스킬이 얼마나 갖춰져 있는지 재 보았습니다. 측정일은 2026-10-14입니다. 블로그의 검색 노출 설정은 GEO실험실 사례글에서 따로 재므로 여기서는 다루지 않았습니다.
ㄱ기
진행 방법
사용 도구: Claude Code, git, grep, Python 3
범위
구분 | 대상 |
|---|---|
블로그 글 |
|
링크드인 | 초안 폴더 4곳의 md 파일, 발행 원장( |
영상 | mp4와 이력 문서가 같은 폴더에 있는 곳 |
스킬 | 블로그 발행 스킬( |
1주차 산출물 | 대시보드 최소판 HTML과 1주차 계획 메모 |
1주차에는 로컬 저장소가 원격보다 1커밋 뒤처져 있었습니다. 이번에도 먼저 원격을 받았고, 읽기 명령만 썼습니다. 블로그 저장소, 스킬, 링크드인 폴더는 고치지 않았습니다. 측정은 한 스크립트(24기콘텐츠발행자동화_2주차_측정.py)로 묶어 결과를 측정결과.json에 두고, 그림도 그 파일에서 읽어 그렸습니다.
cd ~/kakyungkim.github.io && git fetch -q
git rev-list --count main..origin/main                   # 7  (전부 econ-radar 자동 발행 커밋)
git diff --stat main origin/main -- _posts               # 차이 없음
git ls-tree --name-only origin/main _posts/kr/ | wc -l   # 14
git ls-tree --name-only origin/main _posts/en/ | wc -l   # 13
git log origin/main --since=2026-10-04 --format=%h -- _posts | wc -l   # 0
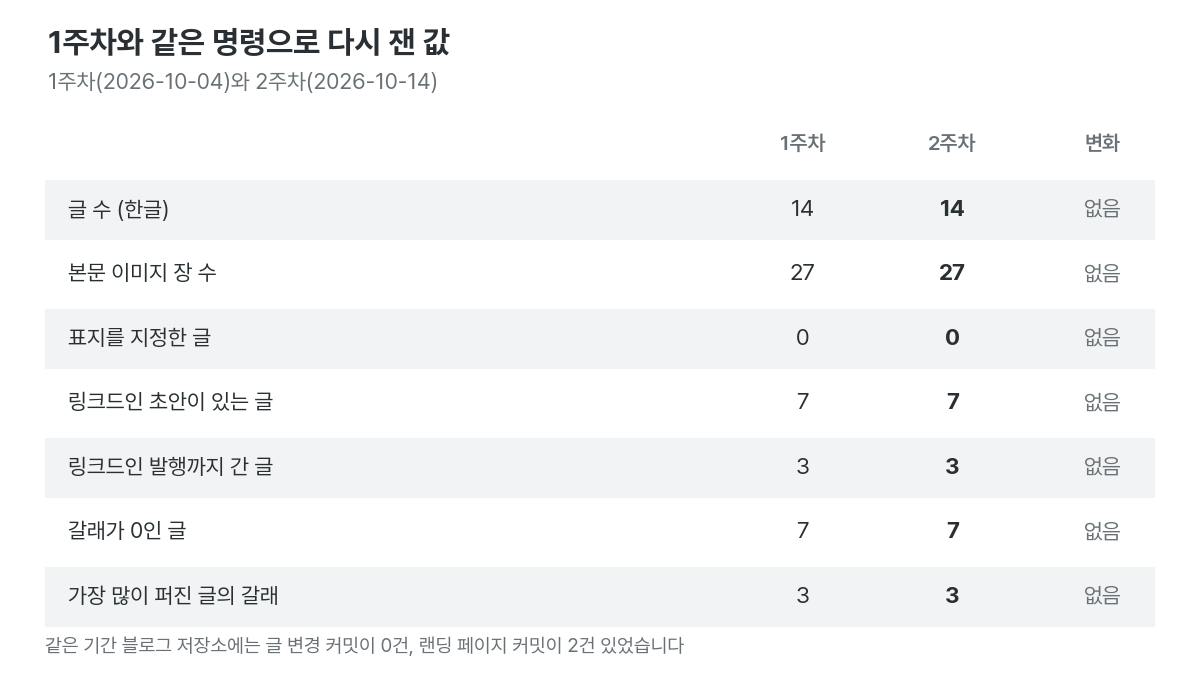
1주차(10/4) 이후 _posts를 바꾼 커밋은 0건이고, 로컬이 뒤처진 7커밋도 _posts 차이가 없습니다. 같은 기간 원격에는 econ-radar 자동 발행 커밋 외에 첫 화면(랜딩 페이지)을 고친 커밋이 2건 있었습니다.
Step 1. 강의 기준과 측정 항목
강의 말씀을 내 블로그에서 잴 수 있는 항목으로 옮겼습니다. 측정할 수 없는 항목은 뺐습니다. 아래 표에서 "측정"은 명령으로 센 값이고, "추정"은 제가 해석한 부분입니다.
강의 기준 | 잴 것 | 구분 |
|---|---|---|
이미지는 재사용부터, 톤을 맞춰 만들기 | 같은 이미지 파일을 쓰는 글이 둘 이상인가, 글마다 표지가 있는가 | 측정 |
글 만드는 과정을 스킬로 묶고 자연어로도 호출하기 | 블로그 스킬의 호출 문구, 실행 단계에 이미지가 있는가 | 측정 |
데이터는 폴더에 계속 쌓기 | 키워드 결과가 다시 쌓이는 구조인가, 반응이 기록되는가 | 측정 |
C-Rank: 한 주제에 집중하고 글을 다음 글로 잇기 | 글 사이 링크 수, 카테고리와 태그의 쏠림 | 측정 |
D.I.A., E-E-A-T: 경험과 신뢰 | 글에 직접 해 본 흔적이 있는가 | 이번에는 재지 않음 |
1주차에 적은 계획 | 네 가지의 실행 여부 | 측정 |
D.I.A.와 E-E-A-T의 "경험의 흔적"은 센 수치로 바꿀 방법이 마땅치 않아 이번에는 재지 않았습니다. 스터디원 이유경 님의 사례글에서 수치를 측정값, 직접 관찰, 분석 가설, 확인 필요로 나눈다는 방식을 가져와, 위 표에 측정과 추정 구분을 달았습니다.
Step 2. 1주차 계획의 실행 여부
1주차 사례글 뒤에 적어 둔 다음 주 계획 네 가지를 하나씩 확인했습니다.
# 계획 1: 다음 글에 표지 1장과 대제목당 1장. 새 글이 있었나
git log origin/main --since=2026-10-04 --format=%h -- _posts | wc -l       # 0
git ls-tree --name-only origin/main _posts/kr/ | tail -1                  # 2026-09-11-gen-ai-drug-discovery-evidence.md

# 계획 3: 블로그 스킬에 티저 저장 위치 한 줄
stat -f '%Sm' -t '%F' ~/.claude/skills/blog-post/SKILL.md                 # 2026-07-01
grep -c "linkedin-archive/drafts" ~/.claude/skills/blog-post/SKILL.md     # 0

# 계획 2: 대시보드 최소판의 세 사람 공식 질문
grep -c -E "처음 해 보는|시간이 없는|고르는" ~/Documents/Study/GPTers/24기/03_Thur/24기콘텐츠발행자동화/1주차/assets/keyword_dashboard.html   # 0

# 계획 4: 초안만 있는 링크드인 4편이 발행됐나
grep -n '^## 2026-10' ~/knowledge-hub/publications/linkedin-archive/posts.md   # 10-03(1주차 이전), 10-07, 10-11. 모두 블로그 글과 무관
계획 | 결과 |
|---|---|
다음 글에 표지 1장과 대제목당 1장 | 실행하지 못했습니다. 1주차 이후 새 글이 0편이고 마지막 글은 2026-09-11입니다 |
대시보드 최소판 | 태그 빈도와 글 목록까지 만든 최소판은 있고, 세 사람 공식 질문은 아직 없습니다(일부) |
스킬에 티저 저장 위치 한 줄 | 실행하지 못했습니다. 스킬 수정일이 7월 1일 그대로이고 저장 위치 규칙이 0건입니다 |
초안만 있는 4편 처리 | 발행도 폐기도 하지 않았습니다. 원장에 1주차 뒤 새로 올라온 두 건(10월 7일, 11일)은 해커톤 결선 진출 소식과 심사위원 후기라 블로그 글과 무관합니다 |
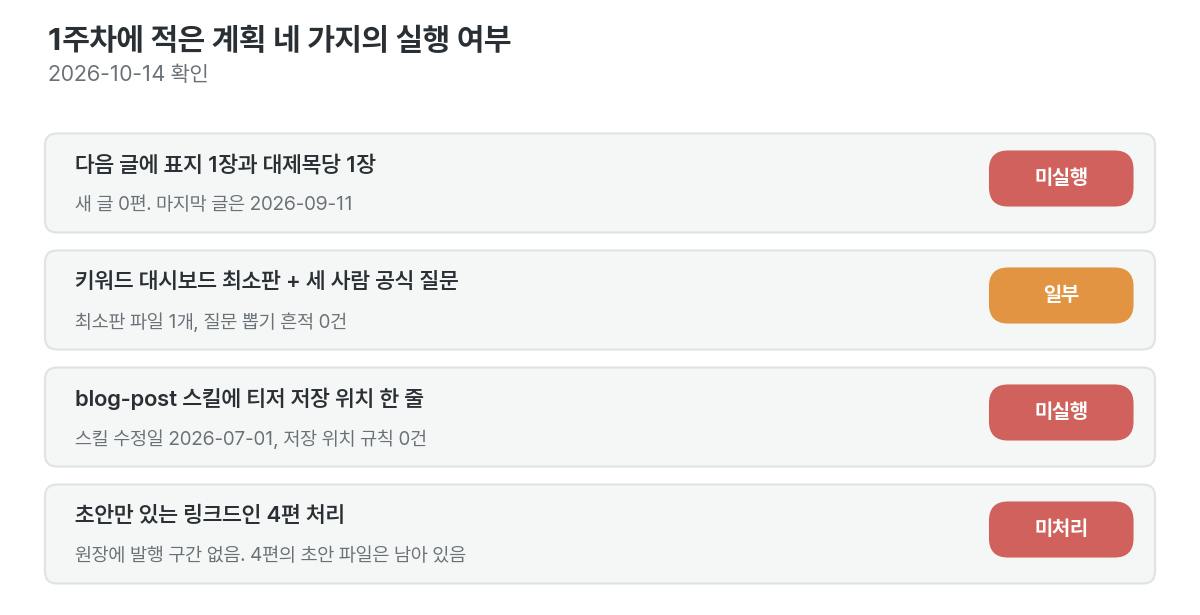
계획 네 가지 가운데 완전히 한 것이 없습니다. "다음 글에 적용"이라는 계획은 다음 글이 없으면 실행될 수 없는 계획이었습니다. 이 점은 아래 배운 점에서 다시 짚었습니다.
Step 3. 1주차 명령의 재측정
1주차 사례글에 적은 명령을 같은 정의로 다시 돌렸습니다. 키워드 흔적은 같은 경로와 같은 검색어로 찾았습니다.
# 키워드 분석 흔적 (경로 6곳, 검색어 8개는 1주차와 같음)
grep -rIl -i -E --exclude='*.jsonl' "검색량|search volume|키워드 분석|keyword research|searchad|datalab|google trends|구글 트렌드" \
  ~/knowledge-hub ~/projects/econ-radar ~/projects/paper-radar ~/kakyungkim.github.io \
  ~/.claude/skills/blog-post ~/Documents/Study/GPTers/23기/03_Thur | wc -l          # 24
# 그중 23기 목요일 스터디 폴더 밖: 0건

# 인스타, 쓰레드, 쇼츠, 릴스
grep -rIl -i -E "instagram|인스타|threads\.net|쓰레드|youtube shorts|쇼츠|릴스" \
  ~/knowledge-hub/publications ~/projects/econ-radar/vault ~/kakyungkim.github.io/_posts | wc -l   # 11
인스타 계열 검색은 1주차에 3건이었는데 이번에는 11건입니다. 11건은 모두 econ-radar vault/의 수집 뉴스, 분석, 일일 발행 파일이고, 매일 파일이 쌓이는 폴더라 늘어난 것으로 보입니다. publications 폴더와 블로그 _posts에서는 여전히 0건이라 "블로그 글에서 만든 인스타 카드나 쓰레드 글은 0편"이라는 1주차 결론은 그대로입니다.
글마다 이미지, 링크드인 초안과 발행, 영상으로 뻗은 갈래를 1주차와 같은 규칙으로 세었습니다(영문판은 번역이라 제외).
항목 | 1주차 (10/4) | 2주차 (10/14) |
|---|---|---|
한글 글, 영문 글 | 14편, 13편 | 14편, 13편 |
본문 이미지, 이미지가 있는 글 | 27장, 3편 | 27장, 3편 |
표지를 지정한 글 | 0편 | 0편 |
링크드인 초안이 있는 글, 발행까지 간 글 | 7편, 3편 | 7편, 3편 |
블로그 글을 대본으로 쓴 영상 | 1편 (가로 3분 58초) | 1편 |
갈래가 0인 글 | 7편 | 7편 |
가장 많이 퍼진 글의 갈래 수 | 3 | 3 |
mp4와 이력 문서가 함께 있는 폴더 | 8곳 | 10곳 (블로그 글을 대본으로 쓴 영상은 그대로 1편) |
Step 4. 이미지: 표지와 재사용
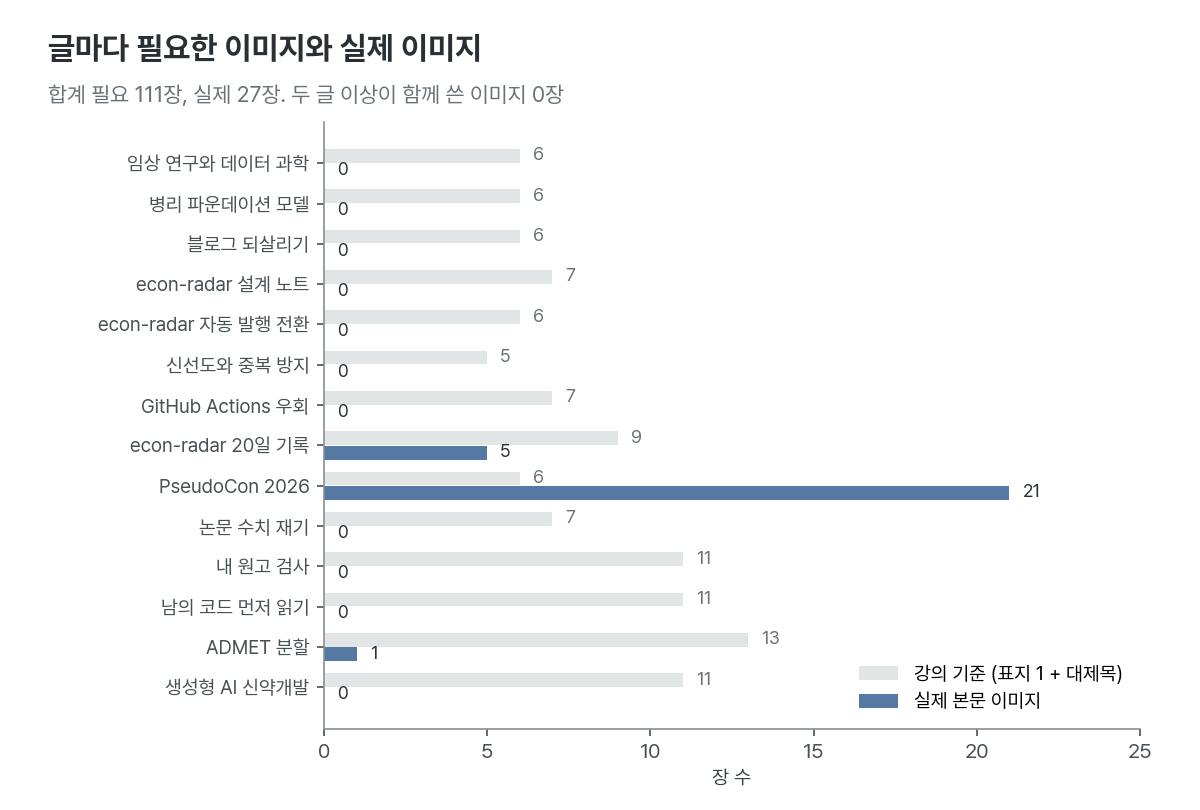
강의의 이미지 기준은 두 가지입니다. 한 번 만든 이미지는 다시 쓸 수 있는지 먼저 보고, 글마다 같은 톤으로 만들라는 것입니다. 글 본문과 이미지 폴더에서 이를 잴 수 있는 만큼 쟀습니다.
use = {}   # 이미지 파일명 -> 그 이미지를 쓰는 글(ref)의 집합
for p in kr_posts + en_posts:
    for src in set(p["img_srcs"]):
        use.setdefault(os.path.basename(src), set()).add(p["ref"])
reused = sum(1 for v in use.values() if len(v) >= 2)     # 0
git ls-tree -r --name-only origin/main assets/images | sed 's|assets/images/||' | cut -d/ -f1 | sort | uniq -c
#  21 pseudocon-2026
#   5 econ-radar
#   1 posts
항목 | 값 |
|---|---|
본문 이미지 파일 | 27개. 모두 본문에서 참조됩니다 |
둘 이상의 글이 함께 쓴 이미지 | 0개 (한글판과 영문판이 같은 파일을 쓰는 것은 한 글로 셌습니다) |
이미지 폴더 | 글 단위로 3개(행사 사진 21장, 발표 덱 캡처 5장, 그래프 1장) |
글별 표지 지정 | 0편. 사이트 전체의 링크 미리보기 카드는 1장이 있고 10월 5일에 추가됐습니다 |
폴더가 글마다 따로라 이안 스터디장의 "예전 이미지 폴더를 먼저 확인하고 재사용"은 지금 구조에서는 확인할 폴더 자체가 없습니다. 재사용할 이미지가 쌓이려면 글 단위가 아니라 용도 단위(표지 톤, 다이어그램 틀, 반복해서 쓰는 도식)로 모으는 폴더가 먼저 필요합니다. 이 판단은 구조를 보고 낸 추정입니다.
Step 5. 스킬: 강의가 말한 단계와 내 블로그 스킬
강의는 글, 이미지, HTML을 한 번 끝까지 만들어 본 뒤 대화를 되짚어 스킬로 만들고, 슬래시와 자연어 호출을 둘 다 걸어 두라고 했습니다. 이미 있는 블로그 발행 스킬이 어디까지 닿는지 읽었습니다.
S=~/.claude/skills/blog-post/SKILL.md
grep -c -E "이미지|image|표지|cover|썸네일" $S                 # 0
sed -n '/^## 실행 흐름/,/^## 발행 전/p' $S | grep -c -E "^[0-9]+\. "                      # 7 (실행 흐름 단계)
sed -n '/^## 실행 흐름/,/^## 발행 전/p' $S | grep -c -E "^[0-9]+\. .*(이미지|표지|썸네일)"   # 0
python3 -c "import re;d=re.search(r'^description:(.*)$',open('$S').read(),re.M).group(1);print(len(re.findall(r'\"[^\"]+\"',d)))"   # 5 (자연어 호출 문구)
강의가 말한 것 | 내 블로그 스킬 |
|---|---|
자연어 호출을 걸어 둔다 | 호출 문구 5개("이 프로젝트로 블로그 글 써줘", "블로그에 올려줘" 등)가 이미 있습니다 |
말투를 지정한다 | 문체 절이 있습니다(AI 상투구 금지, 본인 기여는 능동형) |
이미지는 재사용부터, 톤 통일 | 실행 단계 7개 중 이미지가 들어간 단계가 0개입니다 |
결과를 폴더에 계속 쌓는다 | 링크드인 티저를 어디에 저장할지 규칙이 없습니다 |
글, 이미지, HTML을 한 번 끝까지 만든 뒤 스킬화 | 이 스킬은 수정일이 7월 1일 그대로입니다 |
강의가 말한 흐름에서 내 스킬에 빠진 곳이 이미지 단계와 저장 규칙 둘이라는 점은 분명하지만, 이미지가 필요한 글에서만 필요한 단계입니다. 제 글은 표와 코드가 많은 기술 글이라 모든 H2에 장면 이미지를 붙이는 것이 맞는지는 이번 측정으로 판단할 수 없습니다.
Step 6. 글 사이 연결과 주제 집중
C-Rank를 두고 조셉은 "블로그 글 하단에 다음 글로 이어지게 연결할수록 좋아진다", 그리고 한 주제에 집중하는 "단골집"이어야 한다고 했습니다. 두 가지를 센 값으로 바꿨습니다.
own = re.findall(r"\]\((?:https://kakyungkim\.github\.io)?/(?:kr|en)/20\d\d/\d\d/\d\d/([a-z0-9-]+)/", body)
# 글 본문에서 다른 글 주소를 거는 마크다운 링크
git show origin/main:_config.yml | grep -n "related" # 74: related: true
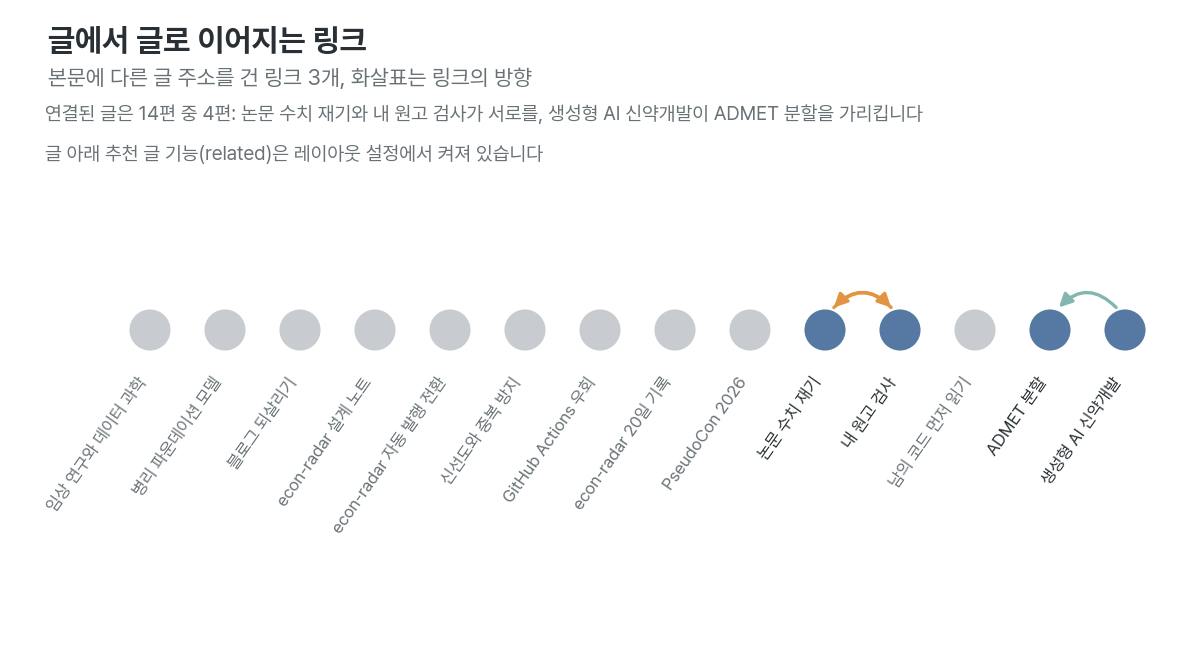
다른 글로 이어지는 링크가 있는 글은 14편 중 3편입니다. 논문 수치 재기와 내 원고 검사가 서로를 가리키고, 생성형 AI 신약개발 글이 ADMET 분할 글을 가리킵니다. 링크는 모두 3개이고 14편이 한 줄로 이어지지는 않습니다.
레이아웃에는 글 아래 추천 글(
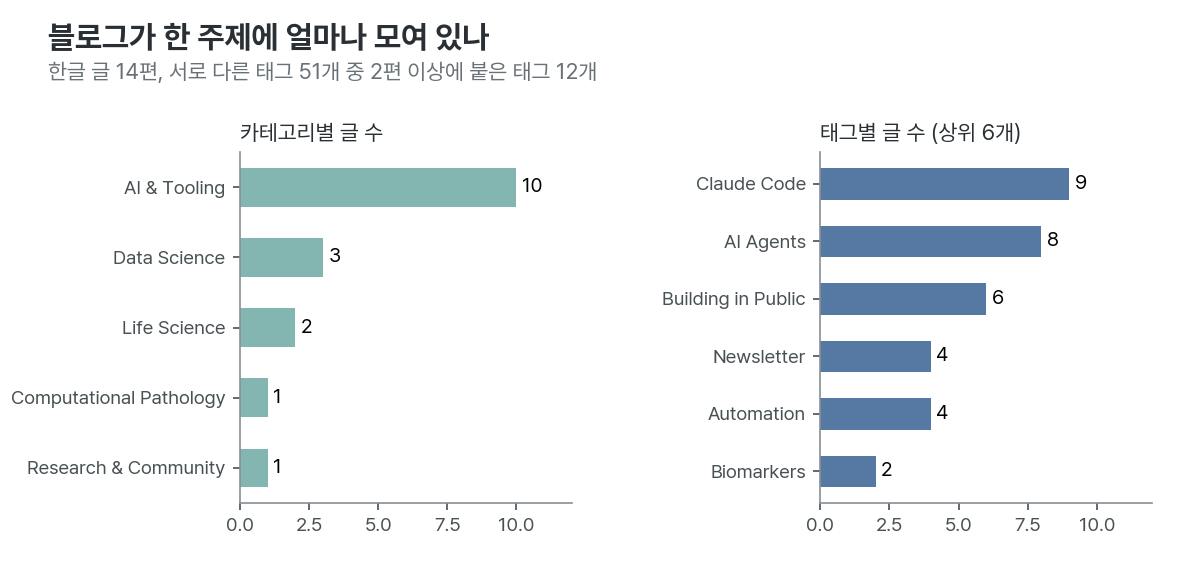
related)이 켜져 있어 링크가 없는 글도 추천 영역은 나옵니다. 이 영역이 실제로 같은 주제 글을 보여 주는지는 화면을 열어 보지 못했습니다.카테고리는 AI & Tooling이 10편, Data Science 3편, Life Science 2편입니다(한 글이 여러 카테고리를 가질 수 있어 합이 14를 넘습니다). 태그는 Claude Code 9편, AI Agents 8편, Building in Public 6편이 앞섭니다. 서로 다른 태그 51개 중 2편 이상에 붙은 태그가 12개이고 39개는 한 편에만 붙었습니다.
한 가지 한계가 있습니다. 위 숫자는 마크다운 링크만 센 것이라 HTML 태그로 건 링크는 빠졌을 수 있습니다. 네이버 C-Rank의 실제 평가에 이 수치가 얼마나 닿는지도 이 블로그가 네이버가 아닌 GitHub Pages이므로 이번 측정만으로 알 수 없습니다.
Step 7. 저장과 선순환
조셉의 선순환은 "발행하고, 반응을 보고, 패턴을 다시 재료에 반영한다"는 흐름입니다. 반응이 어디에 기록되는지 먼저 봤습니다.
grep -c "노출 [0-9]" ~/knowledge-hub/publications/linkedin-archive/posts.md # 1
링크드인 발행 원장 전체에서 노출과 반응 수치가 적힌 곳은 1건(10월 3일 해커톤 리포스트)입니다. 블로그 글과 이어진 발행 3편(PseudoCon, ADMET, 생성형 AI 신약개발)에는 수치가 없습니다. 발행은 3편 있었지만 그 뒤 반응이 기록되지 않아 "반응을 보고 패턴을 분석"하는 단계로 갈 자료가 없다는 뜻입니다.
1주차에 만든 키워드 대시보드 최소판은 정적 HTML 파일 1개입니다.
ls ~/Documents/Study/GPTers/24기/03_Thur/24기콘텐츠발행자동화/1주차/assets/keyword_dashboard*   # 1개
grep -c "<script" .../keyword_dashboard.html                                                    # 0
스크립트 태그가 0개이고 이 파일을 만든 스크립트가 폴더에 남아 있지 않아, 새 글이 올라와도 같은 방식으로 다시 만들어 날짜별로 쌓을 구조는 아직 없습니다. 강의가 말한 "폴더를 지정해서 계속 저장해 줘"가 빠진 상태입니다.
결과와 배운 점
측정 결과
항목 | 2주차 기준 | 내 블로그 (원격 기준 한글 14편) |
|---|---|---|
글별 표지 | 글마다 1장, 한글은 후처리 | 0편 |
이미지 재사용 | 예전 이미지 폴더부터 확인 | 두 글 이상이 함께 쓴 이미지 0장. 폴더가 글 단위 |
이미지 필요량 대 실제 | 표지 1장과 대제목당 1장 | 111장 필요, 27장 있음(1주차와 같음) |
스킬의 이미지 단계 | 이미지와 톤 지정 포함 | 실행 단계 7개 중 0개 |
글 사이 연결 | 글 끝에서 다음 글로 | 3편에 링크 3개 |
반응 기록 | 반응을 폴더에 되돌려 넣기 | 블로그 연결 발행 3편 중 0편 |
1주차 계획 네 가지 | 완전한 실행 0, 일부 1 | |
갈래가 0인 글 | 7편(1주차와 같음) |
배운 점
다음 글에 적용하겠다는 계획은 다음 글이 없으면 실행되지 않습니다. 1주차 이후 글이 0편이라 표지와 이미지 계획은 시작조차 못 했습니다. 이안 스터디장이 "한 번 끝까지 만들어 본 뒤 스킬로 만든다"고 한 순서가 이 블로그에서는 첫 단계에서 멈춰 있습니다. 새 글을 기다리지 않고, 이미 쓴 글 한 편에 표지와 이미지만 얹어 먼저 해 보는 쪽이 현실적인 순서로 보입니다. 이 판단은 측정이 아니라 추정입니다.
스킬에 없는 단계는 글에도 없었습니다. 블로그 스킬의 7개 단계에 이미지가 없고, 블로그 글 14편 가운데 표지가 있는 글도 0편입니다. 1주차에도 "스킬에 들어간 단계만 퍼졌다"고 적었는데, 2주차 측정도 같은 방향을 가리킵니다. 두 값이 함께 움직였다는 것까지가 측정이고, 원인이 스킬이라는 확정은 아닙니다.
이미지 재사용에는 폴더 구조가 먼저입니다. 이미지가 글 단위 폴더 3곳에 흩어져 있고, 한 번 쓴 이미지를 다른 글에서 다시 쓴 적이 없습니다. 강의의 "예전 이미지 폴더부터 확인"을 따르려면 확인할 폴더부터 만들어야 합니다.
발행한 뒤 반응을 적어 두지 않으면 선순환의 입구가 닫힙니다. 조셉의 흐름에서 발행 다음 단계는 반응 분석인데, 링크드인 발행 3편에는 반응 숫자가 한 줄도 없습니다. 반응 기록 칸을 먼저 만들면 되는 문제로 보이나, 어떤 지표를 적을지는 아직 정하지 못했습니다.
강의의 "구체성"은 센 수치로 바꾸기 어렵습니다. D.I.A.와 E-E-A-T의 경험의 흔적을 이번에는 재지 않았습니다. 제 글이 직접 해 본 일을 쓴 글이라는 인상은 있으나 측정한 값이 아니라 인상입니다.
시행착오
처음에는
rg로 키워드와 인스타 계열을 찾는 1주차 명령을 그대로 스크립트에 넣었는데, 이 환경에서rg가 셸 함수라 스크립트 안에서 실행되지 않아 0건이 나왔습니다. 1주차에 24건과 3건이던 값이 0건으로 나온 것을 보고 이상하다고 판단해 검색을 파이썬 함수로 바꿨고, 24건은 같고 인스타 계열은 11건이 되었습니다. 같은 정의라도 도구가 달라지면 값이 어긋날 수 있어 1주차 값과 대조한 덕에 걸렀습니다.인스타 계열이 3건에서 11건으로 늘어난 것을 처음에는 블로그의 새 갈래가 생긴 것으로 읽을 뻔했습니다. 파일 경로를 보니 전부 수집 뉴스와 분석 파일이었고, 범위를
publications와_posts로 좁혀서 센 결과는 0건이었습니다.영상 폴더가 8곳에서 10곳으로 늘어 영상이 새로 생겼나 싶었지만, 폴더마다 문서에 글 이름이 나오는지 다시 보니 블로그 글을 대본으로 쓴 영상은 1편 그대로였습니다.
사이트 전체 링크 미리보기 카드가 10월 5일에 추가된 것을 보고 "표지가 생겼다"로 셀 뻔했습니다. 글별 표지 지정이 아니므로 표지 0편으로 두었습니다.
이 측정은 2026년 10월 14일 git fetch 후 kakyungkim.github.io 원격(origin/main)의 한글 글 14편과 영문 글 13편, 제 컴퓨터의 링크드인 초안 폴더 4곳과 발행 원장, mp4와 이력 문서가 함께 있는 폴더 10곳, 블로그 발행 스킬 파일을 대상으로 센 결과입니다. 링크드인과 유튜브 사이트는 직접 조회하지 않았고, 다른 기기에 있는 초안은 보지 않았습니다.
도움 받은 글
24기 콘텐츠발행자동화 2주차 강의 (이안, 조셉 조): 이미지 재사용과 톤 통일, 커버에는 한글을 넣지 않고 제목은 후처리, 결과를 폴더에 계속 쌓기, 두 스킬 잇기, C-Rank와 D.I.A.와 E-E-A-T, "나의 구체성" 한 문장, 콘텐츠 선순환 워크플로우의 6단계
24기 콘텐츠발행자동화 2주차 사례 발표, 글 쓰는 글로벌 마케터: "검색량 등은 거짓이 있으면 안 돼, 부족한 것은 용서가 되지만 거짓말은 용서가 안 되잖아"라는 규칙. 이번 사례글에서 재지 못한 것을 재지 못했다고 적는 기준으로 삼았습니다
같은 스터디 사례글, 이유경 님의 「키워드 분석용 대시보드 만들기 (어찌어찌 따라했어요)」: 수치를 측정값, 직접 관찰, 분석 가설, 확인 필요로 나누는 방식
지피터스 뽀짝이 요약본(24기 콘텐츠발행자동화 2주차): 강의와 발표의 구성과 발표자 표시명 확인
로그인하고 댓글을 남겨 주세요

Fri-mer님, 안녕하세요.
조셉입니다. ^^
“스킬에 없는 단계는 글에도 없었습니다”라는 발견이 날카로웠습니다. 일하는 방식은 결국 절차에 적힌 만큼 반복되고, 적히지 않은 단계는 바쁠 때 가장 먼저 빠진다고 저는 봅니다. 그러면서도 두 값이 함께 움직였다는 데까지만 측정으로 두고 원인을 확정하지 않으신 선 긋기에 믿음이 갔습니다.
개발에 관련한 인프라 지식이 있는 것으로 보이네요. 배경지식이 있으면 구체화하기에 유리한 건 사실입니다.
1주차와 같은 정의로 다시 재다가 0건이 나온 값을 이상하게 여겨 도구 문제까지 찾아내신 과정도 꼼꼼했습니다. 측정과 추정을 끝까지 나눠 적으셨으니 어디까지가 확인된 사실인지 안심하고 따라가게 됩니다.
2주차 강의의 선순환을 숫자로 재 보시니 반응 기록이 비어 있다는 점이 드러났네요. 반응 기록 칸을 만드신다면, 노출 수 옆에 어떤 한 줄이 함께 있어야 다음 글의 재료로 쓸 수 있다고 보십니까?
이번 점검이 기존 글 한 편에서 작은 변화로 먼저 이어지기를 바랍니다.
수고하셨습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
Fri-mer님, 지난주와 같은 정의로 다시 측정해 실제로 달라진 것과 그대로인 것을 나누어 주셨네요. 원격의 글을 기준으로 삼고, 자동 발행 커밋이 늘어도 블로그 본문이 바뀐 것은 아니라는 점까지 확인한 과정이 꼼꼼했습니다. 실행하지 못한 계획도 그대로 남겨 현재 위치가 잘 보입니다.
검색 결과가 0건으로 나왔을 때 자료가 없다고 결론 내리지 않고 도구 문제를 찾아낸 대목이 특히 유용했습니다. 인스타 관련 파일과 영상 폴더가 늘어난 이유도 실제 경로와 원본 글의 연결을 다시 확인하셨으니, 숫자가 늘었다는 사실만으로 콘텐츠 확장으로 보지 않는 기준이 분명하네요.
기술 글의 모든 소제목에 이미지를 붙이는 것이 맞는지는 아직 판단할 수 없다고 적어 주신 부분에도 공감했습니다. 이미지 수를 채우기보다 표나 코드만으로 이해하기 어려운 관계 한 곳을 골라 도식으로 바꾸면, 독자에게 필요한 그림인지 확인하기 좋을 듯합니다. 이미지 재사용도 그 설명 목적에 맞을 때 의미가 있겠어요.
말씀하신 대로 새 글을 기다리지 않고 기존 글 한 편에 적용해 보는 방식이 좋은 다음 실험이 될 것 같습니다. 연결할 후속 글 하나와 이해를 돕는 도식 하나를 추가한 뒤 실제 화면에서 확인해 보셔도 좋겠어요. 이번 측정이 더 많은 점검 항목을 만드는 데서 멈추지 않고 작은 개선 한 건으로 이어지는 모습을 보고 싶습니다.