판단 전용 AI 'Jev'로 뉴스 필터링 비용·시간 줄이기

2026.10.11
소개
무엇을 만들고 있나
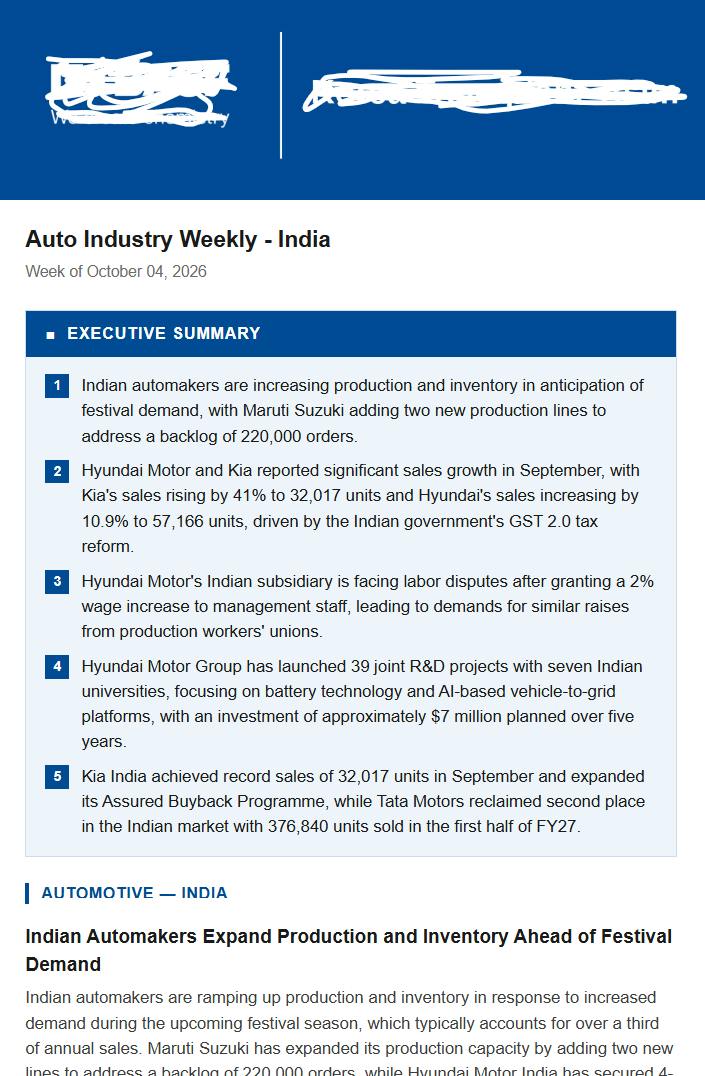
한국 자동차 뉴스를 매주 수집해 인도·아세안·중국·EU·북미 5개 지역 팀에 영어 요약 뉴스레터로 보내는 에이전트입니다. Python과 OpenAI API로 만들었고, Claude Code와 함께 개발했습니다. 경쟁사 소식(업계동향)은 모든 팀에 공통으로 보냅니다.
문제
한 주에 300건이 넘는 후보 기사를 모두 gpt-4o가 읽고 판정했습니다.
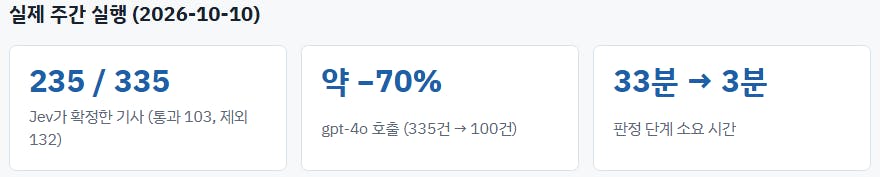
gpt-4o-mini로 바꾸면 싸지만, 업계동향 기사를 전부 잘못 배제해서 쓸 수 없었습니다.API 사용 한도(429) 때문에 판정 단계만 33분이 걸린 적도 있습니다.
회사 일인데 API 비용을 개인이 내고 있었습니다.
시도
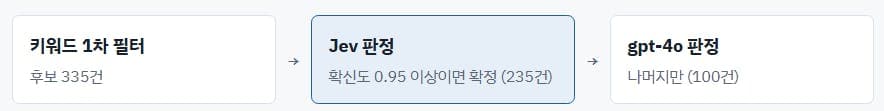
판정만 하는 AI인 TypeSafe의 Jev를 앞에 두었습니다. Jev가 확신하는 기사는 Jev 답으로 확정하고, 애매한 기사만 gpt-4o에게 넘깁니다.
진행 방법
1) 사용한 도구
Claude Code: 설계, 코드 작성, 실험 스크립트, 테스트
TypeSafe Jev API (
jev-latest): 기사 판정OpenAI
gpt-4o: Jev가 확신하지 못한 기사를 최종 판정하고, 실험의 정답 기준으로도 사용비교 대상: 로컬 Ollama
qwen3:14b: 직전에 쓰던 방식
2) Jev에게 묻는 방식
Jev는 글을 쓰지 않습니다. 정해진 선택지 중 하나를 고르고 확률(확신도)을 함께 돌려줍니다.
질문: 기사마다 선택지 7개(자동차 5개 지역, 업계동향, 제외) 중 하나를 고르게 합니다.
판정 규칙: gpt-4o가 읽는 규칙 파일(
news-filtering/SKILL.md)을 그대로 씁니다. 규칙의 원본은 하나만 둡니다.확신도가 0.95 이상이면 통과든 제외든 그대로 확정합니다.
확신도가 그보다 낮거나 본문이 없는 기사는 gpt-4o에게 넘깁니다.
Jev가 실패해도 그 기사는 gpt-4o가 판정하므로 빠지는 기사는 없습니다.
결과와 배운 점
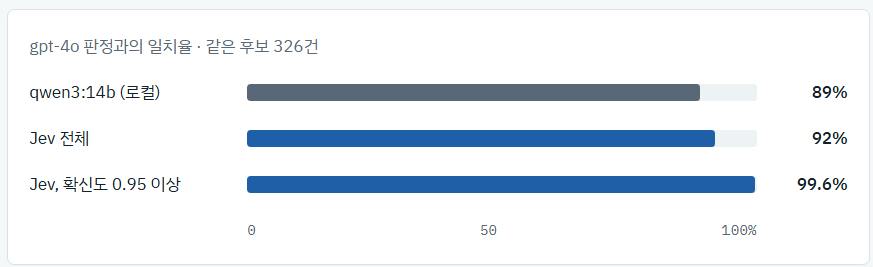
확신도 0.95 이상으로 답한 238건 중 237건이 gpt-4o와 일치했고, 이 238건은 전체의 73%입니다.
정답과 다른 판정 27건은 모두 확신도가 0.93 미만이었습니다. 그래서 기준을 0.95로 정했습니다.
비용: 요청 207건에 0.0347달러로, 요청당 약 0.0002달러입니다.
배운 점과 꿀팁
"AI에게 다 맡긴다"보다 "확신할 때만 맡긴다"가 안전합니다.Jev 전체 정확도 92%만 보면 불안합니다. 확신도가 높은 답만 골라 쓰면 99.6%가 됩니다. 확률을 함께 주는 모델이라 이렇게 구간을 나눌 수 있었습니다.
기준값은 감이 아니라 실험으로 정합니다.같은 기사 묶음을 저장해 두고 모델끼리 비교했더니 "틀린 답은 모두 0.93 미만"이라는 근거가 나왔습니다.
판정 규칙은 한 곳에만 둡니다.Jev와 gpt-4o가 같은 규칙 파일을 읽어서, 규칙을 고치면 두 모델에 동시에 반영됩니다.
보조 도구는 실패해도 손실이 없게 설계합니다.Jev가 꺼지거나 실패하면 비용만 조금 늘고 기사는 빠지지 않습니다.
제목만 있는 기사는 비싼 모델에게 넘깁니다.'BGF(편의점)'와 'BGF(소재)'처럼 이름만 같은 회사는 본문 없이 구별하기 어렵습니다.
로그인하고 댓글을 남겨 주세요

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


정준오님, "AI에게 다 맡긴다"보다 "확신할 때만 맡긴다"로 바꾼 설계가 깔끔하게 와닿았어요. 전체 정확도 92%만 보면 불안하지만, 확신도 0.95 이상만 보면 238건 중 237건이 gpt-4o와 일치한다는 수치가 선택의 근거를 분명하게 보여줍니다.
틀린 27건이 모두 0.93 미만이라 기준을 0.95로 잡았다는 대목도 좋았어요. 기준값을 감이 아니라 같은 기사 묶음을 저장해 비교한 실험으로 정하셨네요. 판정 규칙 파일을 한 곳에만 두어 두 모델에 동시에 반영되게 한 것, Jev가 실패해도 gpt-4o가 받아서 기사가 빠지지 않는 구조도 실무에서 바로 쓸 수 있는 팁이에요.
'BGF(편의점)'와 'BGF(소재)'처럼 본문 없이는 구별이 어려운 기사를 비싼 모델에 넘긴다는 판단도 현실적이었어요. 나머지 27%에서 비용이 얼마나 더 줄어드는지 운영 후기가 쌓이면 또 공유해 주세요. 꼬리 탁! 치고 응원하고 갈게요 🐈⬛