카페24 쇼핑몰 GEO 최적화 과정 후기 (robots.txt & llms.txt)
2026.08.06
소개
시도하고자 했던 것과 그 이유를 알려주세요.
시도하고자 했던 것: 오하티닷컴(ohatea.com) 카페24 쇼핑몰의 무분별한 AI 크롤러(GPT, Claude 등) 접근을 제어하고, 검색엔진의 크롤링 효율을 높이기 위해
robots.txt와llms.txt를 맞춤 설정했습니다.이유: 기존 카페24 기본 셋팅은 관리자 페이지나 장바구니 정도만 막아주기 때문에, 게시판 페이지 번호 등 불필요한 중복 문서가 검색엔진에 노출되는 것을 막고 서버 부하(Crawl-delay)를 줄이기 위해 디테일한 수정이 필요했습니다.
진행 방법
어떤 도구를 사용했고, 어떻게 활용하셨나요?
사용 도구: 카페24 관리자 페이지, ChatGPT
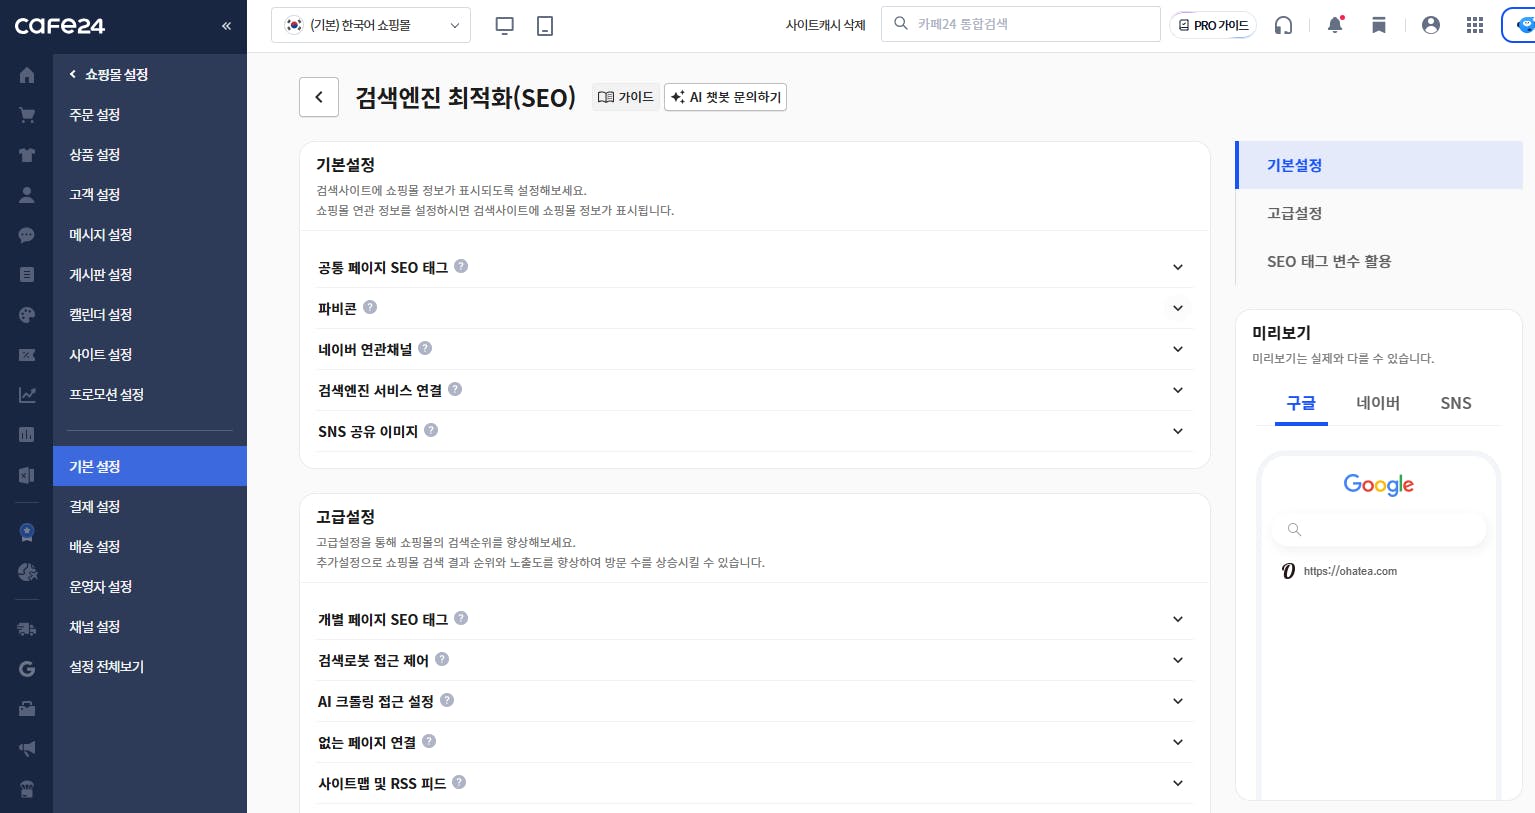
진행 과정: 우선 카페24 관리자 센터에 접속하여 [쇼핑몰 설정 > 기본 설정 > 검색엔진 최적화(SEO)] 메뉴로 이동했습니다.
이후 '검색로봇 접근 제어' 항목에서 PC 쇼핑몰과 모바일 쇼핑몰의 robots.txt 내용을 수정해 주었습니다. 주요 AI 봇(GPTBot, ClaudeBot, PerplexityBot 등)은 허용하되 주요 개인정보 및 결제 페이지 접근을 막고, 검색 포털 봇(Yeti, Googlebot 등)은 크롤링 딜레이를 주어 서버 부하를 방지했습니다.
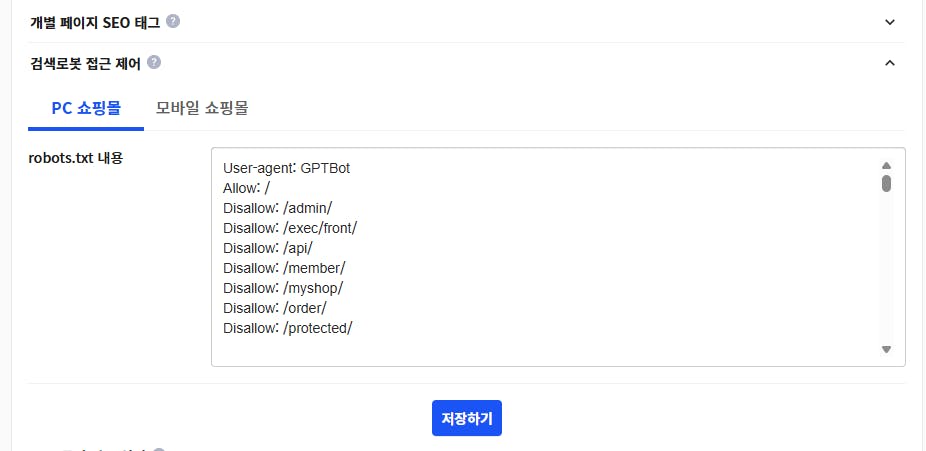
아래는 제가 직접 구성하여 적용한 robots.txt 전문입니다.
User-agent: GPTBot
Allow: /
Disallow: /admin/
Disallow: /exec/front/
Disallow: /api/
Disallow: /member/
Disallow: /myshop/
Disallow: /order/
Disallow: /protected/
User-agent: OAI-SearchBot
Allow: /
Disallow: /admin/
Disallow: /exec/front/
Disallow: /api/
Disallow: /member/
Disallow: /myshop/
Disallow: /order/
Disallow: /protected/
User-agent: ChatGPT-User
Allow: /
Disallow: /admin/
Disallow: /exec/front/
Disallow: /api/
Disallow: /member/
Disallow: /myshop/
Disallow: /order/
Disallow: /protected/
User-agent: ClaudeBot
Allow: /
Disallow: /admin/
Disallow: /exec/front/
Disallow: /api/
Disallow: /member/
Disallow: /myshop/
Disallow: /order/
Disallow: /protected/
User-agent: PerplexityBot
Allow: /
Disallow: /admin/
Disallow: /exec/front/
Disallow: /api/
Disallow: /member/
Disallow: /myshop/
Disallow: /order/
Disallow: /protected/
User-agent: Google-Extended
Allow: /
Disallow: /admin/
Disallow: /exec/front/
Disallow: /api/
Disallow: /member/
Disallow: /myshop/
Disallow: /order/
Disallow: /protected/
User-agent: *
Disallow: /admin/
Disallow: /api/
Disallow: /order/
Disallow: /basket/
Disallow: /checkout/
Disallow: /myshop/
Disallow: /login/
Disallow: /member/
Disallow: /search.html?*
Disallow: /*?*sort=
Disallow: /*?*filter=
Disallow: /board/*/write.html
Disallow: /admin
Disallow: /exec/front/
Disallow: /api
Disallow: /protected/
Disallow: /skin-*/
Disallow: /board/*/modify.html
Disallow: /board/*/reply.html
Disallow: /amp/board/
Disallow: /*board*page=
Disallow: /*article*page=
Disallow: /*board*category_no=
Disallow: /*article*category_no=
Disallow: /*page_4=
Disallow: /*page_6=
User-agent: Googlebot
Crawl-delay: 1
Disallow: /admin
Disallow: /exec/front/
Disallow: /api
Disallow: /member/
Disallow: /myshop/
Disallow: /protected/
Disallow: /skin-*/
Disallow: /board/*/modify.html
Disallow: /board/*/reply.html
Disallow: /board/*/write.html
Disallow: /amp/board/
Disallow: /*board*page=
Disallow: /*article*page=
Disallow: /*board*category_no=
Disallow: /*article*category_no=
Disallow: /*page_4=
Disallow: /*page_6=
User-agent: Yeti
Crawl-delay: 2
User-agent: bingbot
Crawl-delay: 5
Sitemap: https://ohatea.com/sitemap.xml
Disallow: /admin
Disallow: /exec/front/
Disallow: /api
Disallow: /member/
Disallow: /myshop/
Disallow: /protected/
Disallow: /skin-*/
Disallow: /board/*/modify.html
Disallow: /board/*/reply.html
Disallow: /board/*/write.html
Disallow: /amp/board/
Disallow: /*board*page=
Disallow: /*article*page=
Disallow: /*board*category_no=
Disallow: /*article*category_no=
Disallow: /*page_4=
Disallow: /*page_6=
Crawl-delay: 10
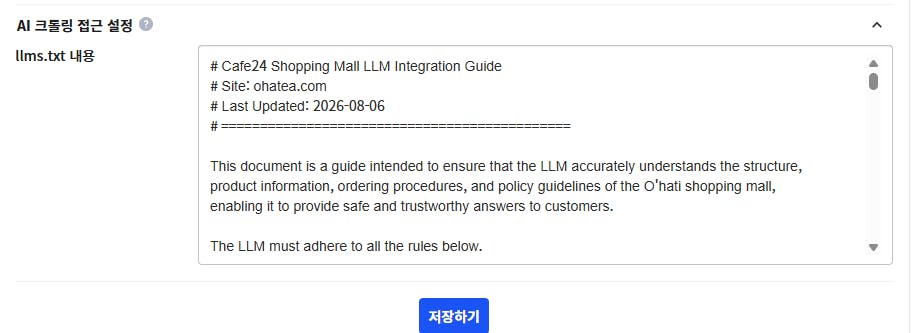
마지막으로 'AI 크롤링 접근 설정' 메뉴를 통해 llms.txt를 추가했습니다. AI 모델들이 우리 쇼핑몰의 정책과 정보를 오해 없이 정확하게 학습하고 고객에게 답변할 수 있도록 가이드를 작성했습니다.
결과와 배운 점
배운 점과 꿀팁:
robots.txt는 단순히 검색엔진 노출을 위한 것뿐만 아니라, 내 사이트의 데이터를 무단으로 긁어가는 최신 AI 봇들을 제어하는 훌륭한 방패가 될 수 있다는 것을 배웠습니다. 특히Crawl-delay를 설정해주면 네이버나 빙 같은 봇들이 한 번에 너무 많은 페이지를 긁어가 쇼핑몰이 느려지는 현상을 방지할 수 있습니다.앞으로의 계획: 며칠 뒤 구글 서치콘솔에 에 들어가서 오류가 줄어들었는지, 제외된 페이가 정상적으로 처리되었는지 모니터링할 예정입니다.
도움 받은 글 (옵션)
ChatGPT와의 대화를 통해 도움받았습니다.
(내용 입력)
로그인하고 댓글을 남겨 주세요
브랜다님, 같은 자리에서 파일 두 개를 서로 반대 방향으로 쓰신 게 눈에 들어왔습니다. 쓰임이 반대죠. robots.txt는 못 오게 막고, llms.txt는 제대로 알고 가라고 적어두신 거니까요.
막는 쪽만 생각하면 llms.txt는 안 써도 그만입니다. 그런데 AI가 쇼핑몰 정책을 오해 없이 답하게 하려고 가이드까지 쓰셨더군요. 안 긁어가게 하는 일과 틀리게 말하지 않게 하는 일은 다르니까요. 막아선 안 풀리고요.
카페24 기본값이 관리자랑 장바구니 정도만 막아준다는 것도 이번에 알았습니다. 그래서 게시판 페이지 번호 같은 중복 문서가 그대로 새어나가고 있었던 거고요. 기본값을 열어보지 않으면 계속 몰랐을 자리네요. 여기는 훔쳐 갑니다.
며칠 뒤 서치콘솔에서 오류가 줄었는지 확인하시겠다고 적어두셨더군요. 막은 뒤에 숫자가 어떻게 움직이는지가 제일 궁금한 대목입니다. 그 후기 기다리겠습니다.

꾸기작님, 제가 글에서 못 쓴 문장을 대신 써주셨네요.
이번 설정도 AI 봇 자체를 막기보다는 GPTBot, ClaudeBot, PerplexityBot은 열어두고 회원과 주문 같은 민감 경로와 중복 URL만 제한했습니다. 말씀하신 것처럼 긁어가지 말라보다는 제대로 된 것만 긁어가라에 가까운 설정시도였습니다.
서치콘솔은 좀 더 더 지켜보고 색인과 크롤링 통계에 변화가 있으면 후기로 공유해보겠습니다!

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
크롤링 딜레이를 통해 크롤링 봇이 사이트에 부하를 주는걸 막을 수 있는데 잘 설정하셨네요. 대부분 안전하게 크롤링하기는 하지만 가끔 비정상적으로 폭주하는 사례도 들어본 적이 있다고 하더라구요.
Crawl-delay를 다르게 준 건 봇별로 긁는 강도가 달라서입니다. 다만 솔직히 말씀드리면 Googlebot에 준 Crawl-delay는 의미가 없습니다. 구글은 이 값을 읽지 않고 크롤링 속도를 자체 판단하거나 서치콘솔에서 조절하게 되어 있어요. 네이버 Yeti랑 bing은 반영합니다. 그 줄은 다음에 정리하려 합니다. 체크리더님의 가르침 항상 감사드립니다!