같은 AI, 질문만 바꿨더니 — 모델보다 프롬프트가 중요했던 순간

2026.07.25
배경
논문을 쓰면 인용이 정확한지 일일이 원문과 대조해야 한다. 내가 인용한 수십 개 문장을 선행연구 논문과 하나씩 맞춰보는 작업인데, 시간도 오래 걸리고 눈으로는 놓치기 쉽다.
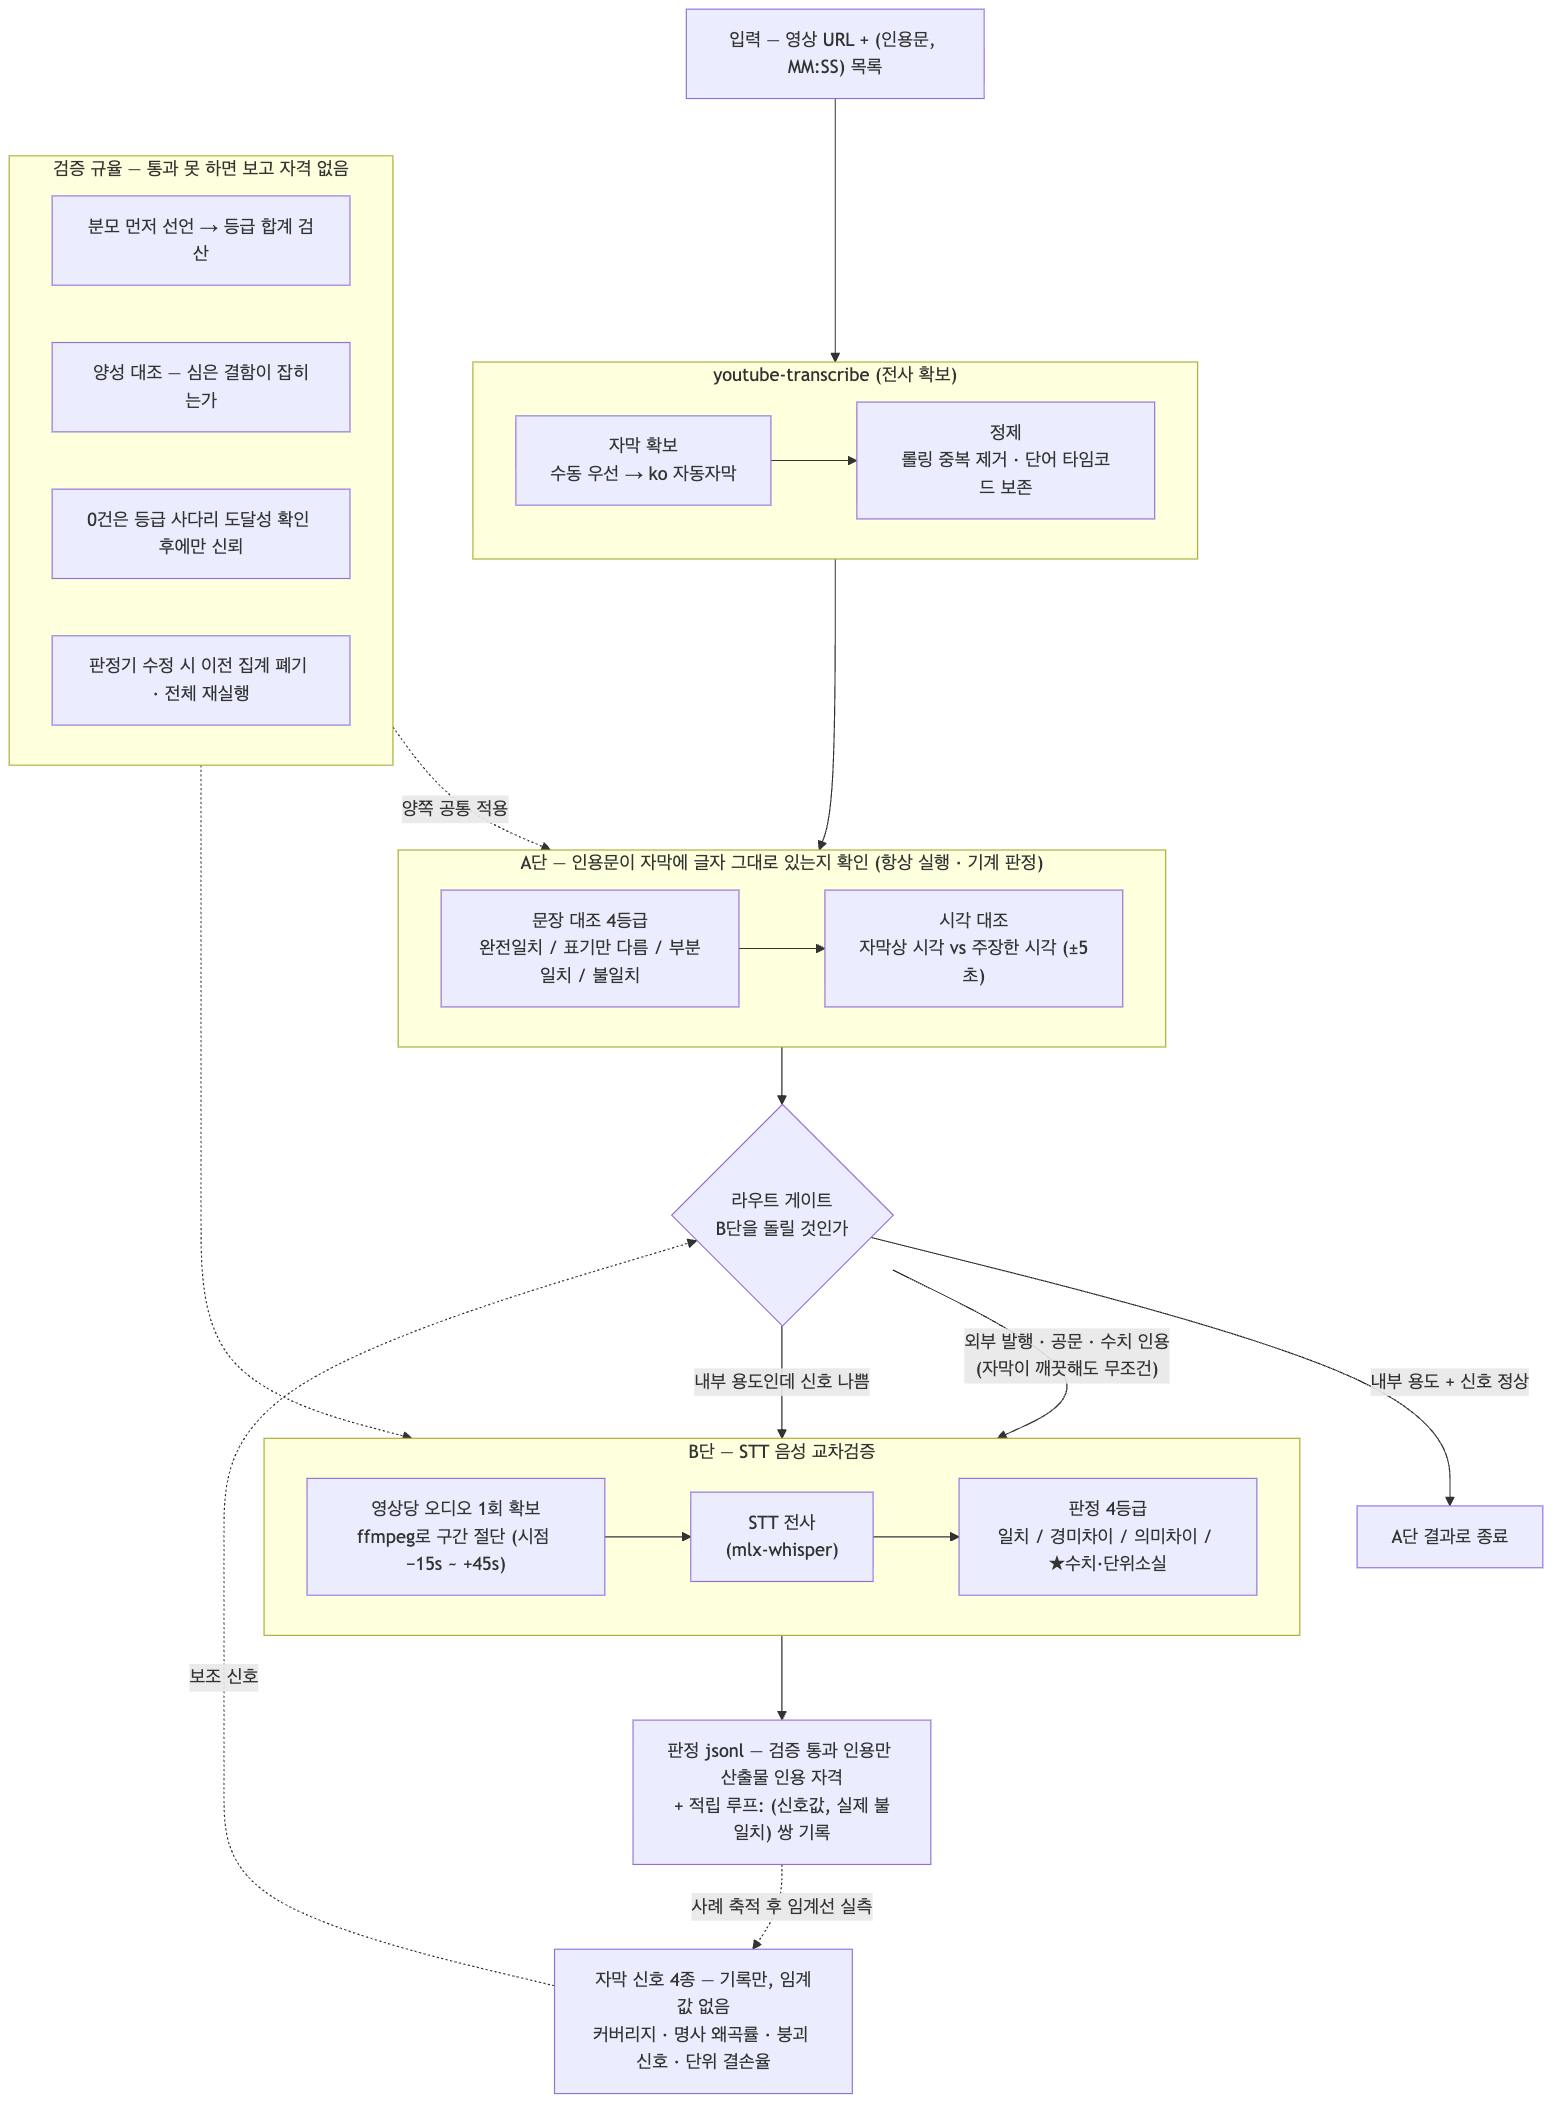
그래서 이 검증을 AI로 한다. 1차로 클로드(Claude), 2차로 코덱스(Codex·ChatGPT) 에게 "이 인용이 원문과 맞는지 확인해줘"라며 교차검증을 시켰다. 두 AI 모두 "다 맞다"고 통과시켰다.
과정
1주차 AI 검수 스터디에 참가를 한 다음에, 다른 방식으로 해보기로 했다.
찜찜해서 3차로 한 번 더, 이번엔 방식을 바꿔서 돌렸다. 그랬더니 앞의 두 AI가 통과시킨 문장에서 오류가 5개나 나왔다.
예를 들어 내 논문엔 인용한 연구를 "마카오의 한 카지노 호텔 방문객 500명"이라 썼는데, 원문을 열어보니 "네 개의 카지노 호텔"이었다. 숫자가 틀린 사실 오류. 앞선 두 AI는 이걸 그냥 넘겼다.
처음엔 "3차가 더 좋은 모델(FABLE5)이라서 잡았나?" 싶었다. 확인하려고 작은 실험을 했다. 2차에서 오류를 하나도 못 잡은 바로 그 코덱스에게, 모델은 그대로 두고 딱 하나만 바꿨다 — 내가 시키는 말투.
2차 때: "이 문장이 원문과 맞는지 확인해줘." 실험 때: "이 문장에서 틀린 데를 찾아서 공격해봐. 변호하고, 공격하고, 판정해."
결과
같은 코덱스, 같은 논문, 같은 원문. 질문만 '확인'에서 '공격'으로 바꿨더니:
"확인해줘" → 오류 0개
"공격해봐" → 오류 2개
더 확실히 하려고 모델 2종 × 프롬프트 2종으로 교차 실험까지 했다. 결론은 명확했다. 오류를 잡은 건 '더 똑똑한 모델'이 아니라 '공격하라는 프롬프트'였다. 모델을 바꿔도 "확인해"로는 못 잡았고, 같은 모델도 "공격해"로 바꾸니 잡기 시작했다.
배운 점
AI 결과물 검수 1주차 강의 기반.
AI가 오류를 못 잡는 건 AI가 멍청해서가 아니라, 우리가 "맞는지 확인해"라고만 물어서다.
"맞지?"라고 물으면 → AI는 맞는 근거를 찾는다 (변호사 모드)
"틀린 데 찾아봐"라고 물으면 → AI는 틀린 데를 판다 (검사 모드)
검증은 변호가 아니라 반대신문이어야 한다.
로그인하고 댓글을 남겨 주세요

찜찜함을 그냥 넘기지 않고 3차 검증에서 질문 방식 자체를 바꿔 다시 확인하신 과정이 인상적이에요. AI의 답변을 그대로 믿는 대신, 실제 논문 검수에 바로 적용할 수 있는 질문의 방향을 찾아내신 점이 특히 실용적으로 느껴졌습니다. 논문 인용 검수에서 질문을 어떻게 설계해야 하는지 선명한 기준을 남겨주신 공유라서 도움이 됐습니다.

같은 모델, 같은 논문, 같은 원문인데 질문만 확인에서 공격으로 바꾸자 결과가 갈렸다는 실험이 이 글의 전부입니다. 그리고 이 글이 강한 이유는 결론이 아니라 설계입니다.
처음 관측은 3차에서 오류 5개가 나온 것이었고, 자연스러운 해석은 3차가 더 좋은 모델이었다는 것입니다. 이 글은 거기서 멈추지 않고 모델을 고정한 채 프롬프트만 바꿔 다시 돌렸습니다. 같은 도구에서 확인 요청은 0개, 공격 요청은 2개. 그다음 모델 2종과 프롬프트 2종으로 교차까지 했습니다. 교란요인을 통제한 요인실험이고, 자기 가설을 자기 실험으로 부정한 기록입니다. 그럴듯한 설명을 얻은 뒤에 그것을 다시 검증하는 경우는 드뭅니다. 대개는 설명이 생기면 그 자리에서 끝냅니다.
"AI가 오류를 못 잡는 건 AI가 멍청해서가 아니라" 로 시작하는 진단도 그래서 무게가 다릅니다. 실험 없이 같은 문장을 썼으면 의견이었을 것이고, 실험이 붙어서 관측이 됐습니다.
잡힌 오류가 구체적인 것도 좋았습니다. 인용한 연구의 대상이 방문객 수로 적혀 있었는데 원문은 카지노 호텔 네 개였다는 것 — 앞선 두 검증이 그냥 넘긴 종류입니다. 확인 요청은 맞는 근거를 찾는 방향으로 움직이니 이런 불일치를 지나칩니다.
투입 대비 산출이 이 글에서 가장 인상적입니다. 코드가 없고, 도구를 새로 만들지 않고, 프롬프트 한 줄만 바꿉니다. 그래서 읽는 사람이 오늘 적용할 수 있습니다.
옮겨갈 범위는 검증 작업 전체입니다. 계약서 검토, 보고서 팩트체크, 코드 리뷰처럼 틀린 곳을 찾아야 하는 작업은 전부 질문의 극성에 걸립니다. 다만 조건이 하나 붙습니다 — 공격 요청은 오탐도 함께 늘리므로, 판정 라벨에 확인불가를 두거나 지적마다 근거 위치를 요구하는 장치가 같이 있어야 합니다. 공격만 시키고 근거를 안 받으면 없는 결함이 올라옵니다.
두 검증이 통과시킨 뒤에도 넘기지 않고 방식을 바꿔 한 번 더 돌린 판단이 이 글의 출발점입니다. "검증은 변호가 아니라 반대신문이어야 한다" 는 결론보다, 그 앞의 한 번 더가 오래 남을 것 같습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


"마카오의 한 카지노 호텔"이라고 썼는데 원문이 "네 개의 카지노 호텔"이었다는 사실 오류를, Claude·Codex 두 AI가 "확인해줘"로는 그냥 넘겼다가 "공격해봐"로 바꾸니 잡아냈다는 사례가 설득력 있어요. 숫자 하나가 바뀌는 오류라서 더 날카롭게 다가오네요.
모델 2종 × 프롬프트 2종 교차 실험으로 "더 좋은 모델이라서가 아니다"를 직접 검증하셨잖아요. 이걸 그냥 체감으로 넘기지 않고 변수를 하나씩 통제해서 확인한 게 이 글을 믿게 만드는 이유예요.
검증은 변호가 아니라 반대신문이어야 한다 — 이 한 줄로 정리가 되네요. 다른 스터디원분들한테도 전달력 있을 것 같아요. 고롱고롱 ✨