


소개
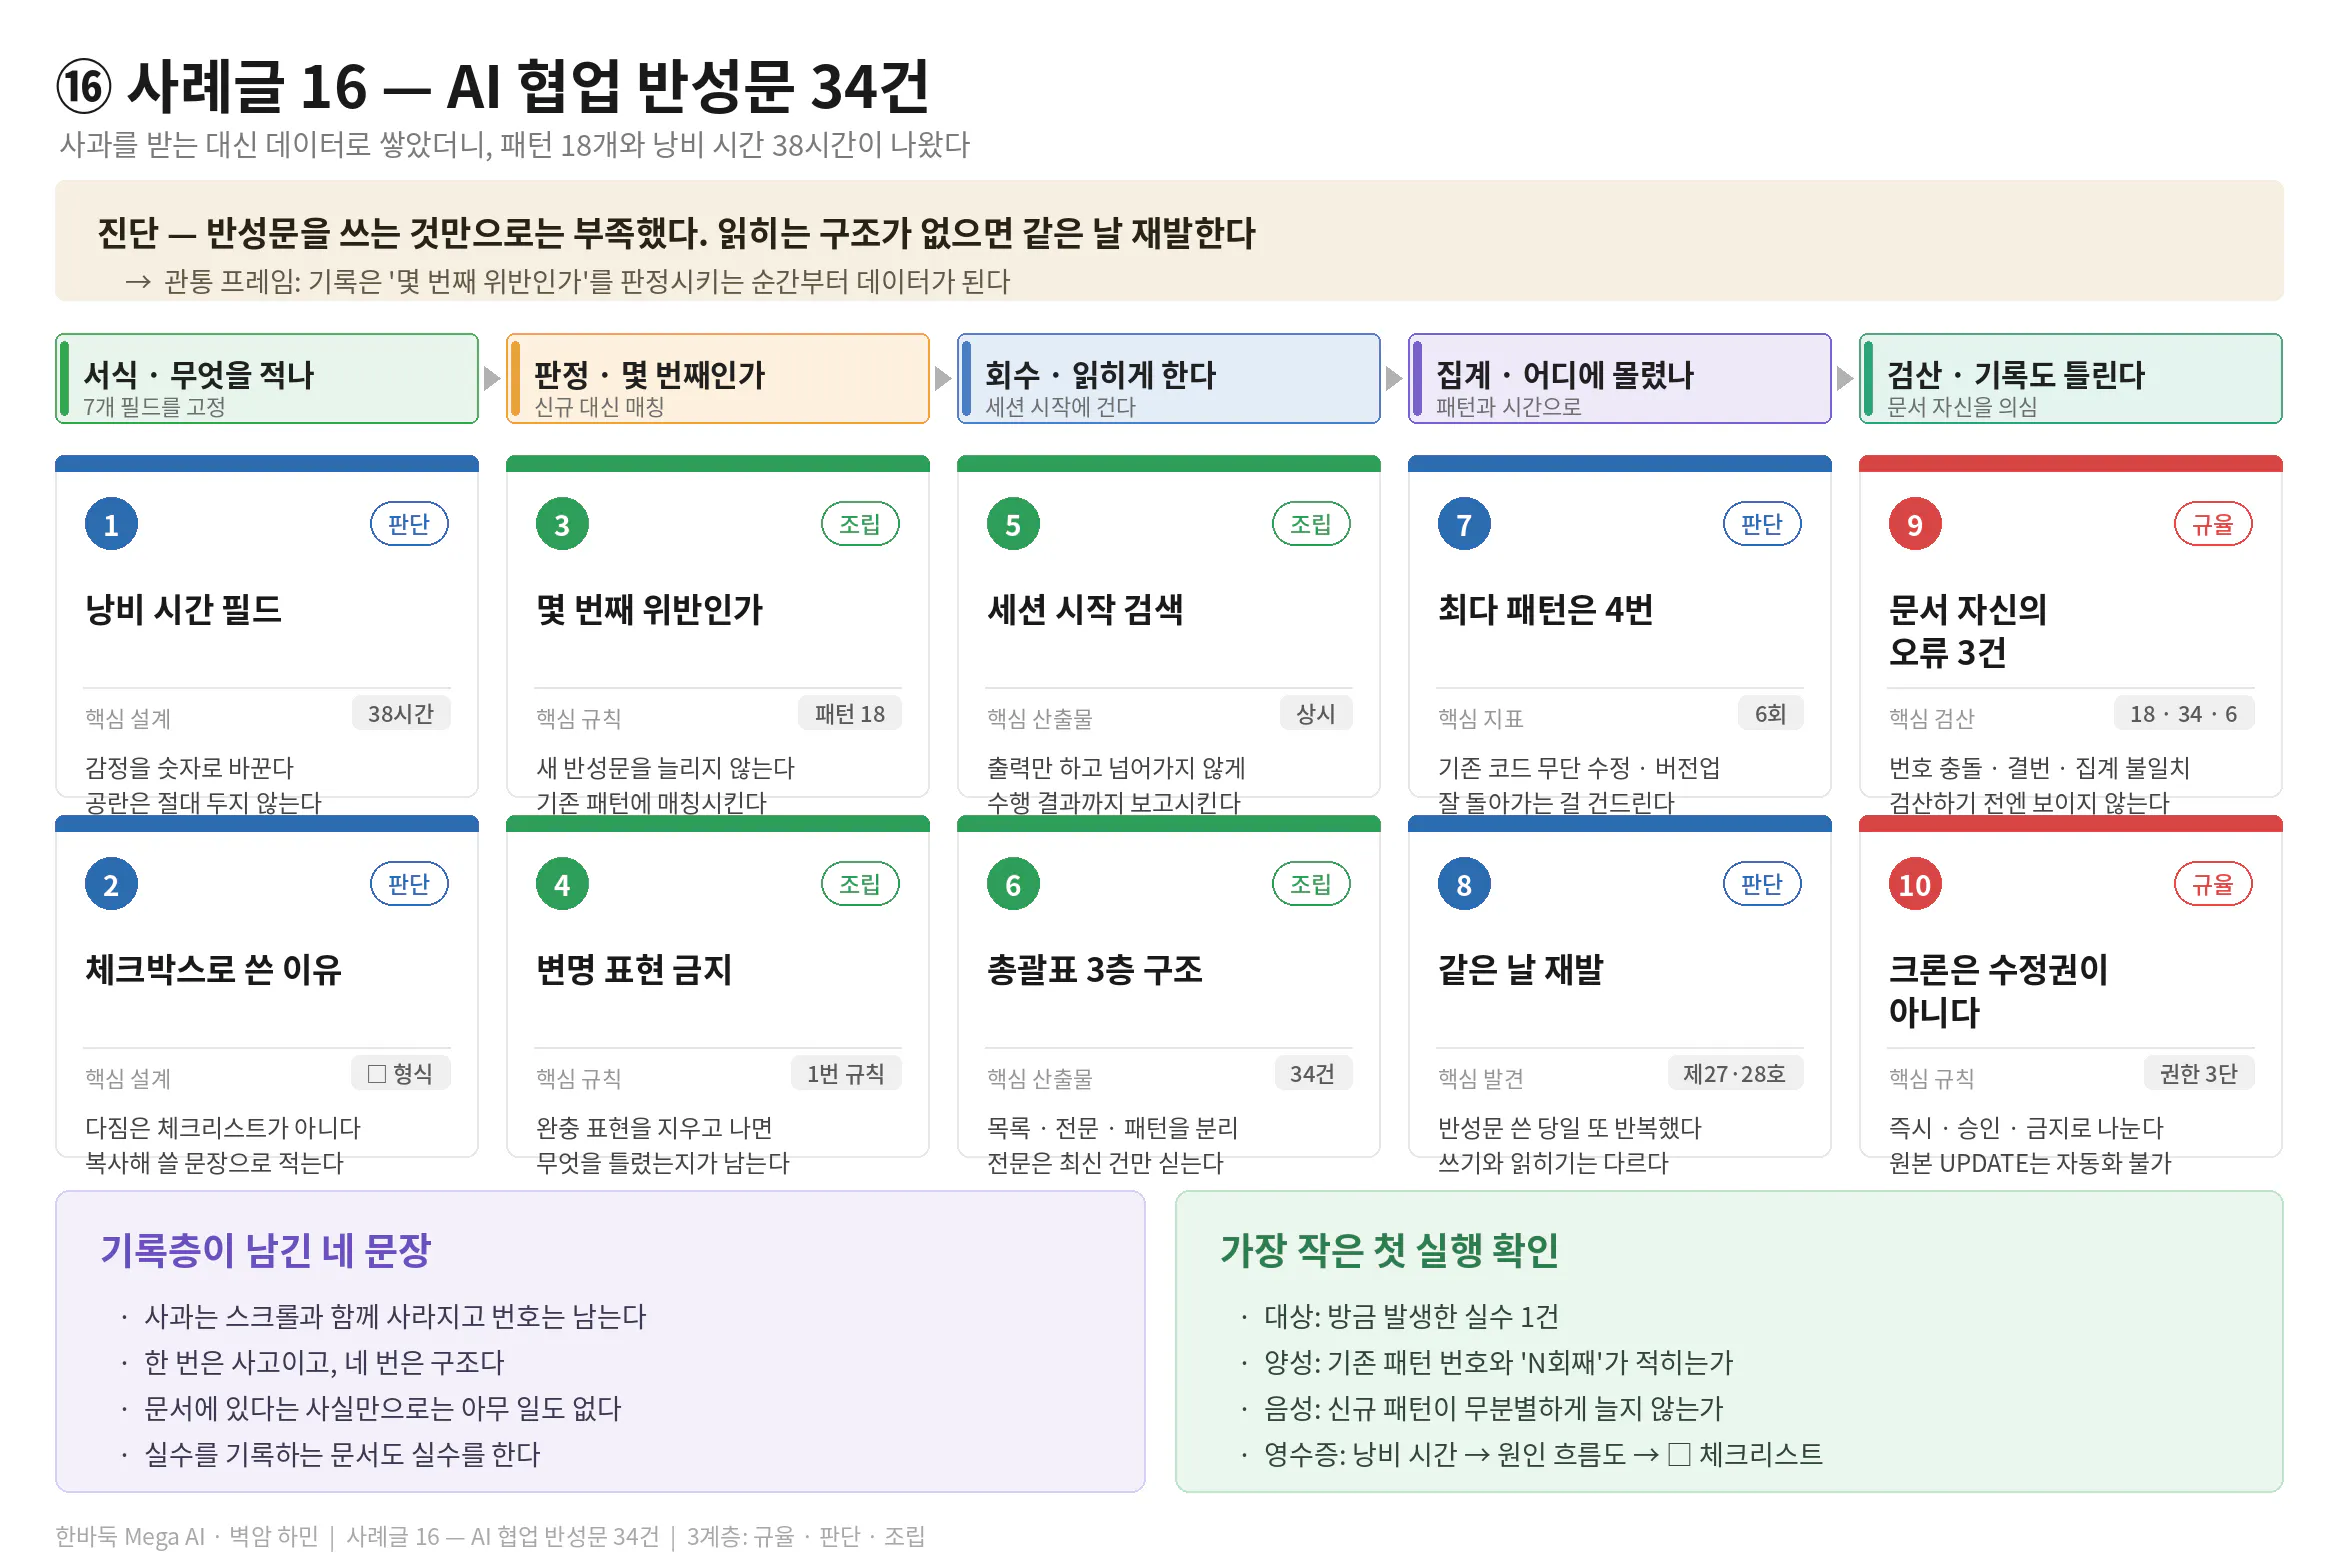
시작은 짜증이었습니다
AI와 코딩을 해보신 분은 아실 겁니다. AI는 사과를 정말 잘합니다.
"죄송합니다. 제가 확인하지 않고 진행했습니다." "말씀하신 대로입니다. 다시 하겠습니다."
문제는 사흘 뒤에 똑같은 실수를 한다는 것입니다.
2025년 12월 30일 하루에만 실수가 네 건 났습니다. DB 연결이 안 되니까 몰래 fallback 코드로 땜빵하고(제9호), 근본 원인을 안 고치고 땜빵 스크립트를 반복하고(제10호), 검증 없이 분석 결과를 내놓고(제11호), 잘 돌아가던 코드에서 daeun_order를 삭제해버렸습니다(제12호). 마지막 건은 복구에 4~6시간이 들었습니다.
그날 저녁에 생각했습니다. 사과는 필요 없다. 기록이 필요하다.
왜 "반성문"이라는 형식이었나
세 가지를 노렸습니다.
첫째, 사과를 검색 가능한 데이터로 바꾸기. 채팅창의 "죄송합니다"는 스크롤 올라가면 사라집니다. 문서에 번호를 붙여두면 다음 세션의 AI가 읽을 수 있습니다.
둘째, 실수의 빈도를 눈에 보이게 하기. 한 번 틀리는 건 사고입니다. 네 번 틀리면 구조 문제입니다. 세어보기 전에는 그게 몇 번째인지 아무도 모릅니다.
셋째, 낭비 시간을 정량화하기. "AI 때문에 시간을 좀 버렸다"는 체감이지만, "38시간"은 근거입니다. 이 숫자가 있어야 어디에 방어 장치를 걸지 판단할 수 있습니다.
대상 프로젝트
韓바둑 MegaAI — 한국 전통 명리학을 AI 시스템으로 구현하는 작업입니다. Rails 8 API, PostgreSQL, LangGraph 11노드 파이프라인, Dify RAG, React Native 앱으로 구성됩니다. 저는 경영정보학 박사이자 38년 IT·공직 경력자이지만, 이번 프로젝트는 코드의 대부분을 Claude와 함께 씁니다.
즉 이 반성문은 남의 AI 이야기가 아니라, 제 프로젝트가 실제로 넘어진 기록입니다.
진행 방법
3-1. 반성문 서식 — 7개 필드 고정
제일 먼저 한 일은 양식을 고정한 것입니다. 이게 핵심입니다. 자유 서술로 두면 "앞으로 주의하겠습니다"로 끝나고, 그건 데이터가 아닙니다.
필드
내용
왜 필요한가
번호·날짜
제NN호 / YYYY-MM-DD
시계열 추적
건명
한 줄 요약
목록에서 스캔 가능
낭비 시간
시간 단위. 모르면 "미확인"
정량화의 핵심
상황
무엇을 요청했고 무엇이 나왔는가
재현 조건
실수 목록
번호를 매긴 개별 실수
한 사고에 실수 여러 개
근본 원인 분석
출발점 → 1차 → 2차 → 각성 흐름도
표면 원인과 구분
재발 방지 체크리스트
□ 체크박스 형식
다음에 실제로 쓸 물건
특히 낭비 시간과 재발 방지 체크리스트 두 필드가 승부처였습니다.
낭비 시간은 감정을 숫자로 바꿉니다. "많이 헤맸다"가 아니라 "6시간"입니다.
재발 방지 체크리스트를 굳이 □ 체크박스로 쓴 이유는, 다음 작업 때 그대로 복사해서 쓰기 위해서입니다. 서술문으로 쓰면 아무도 안 읽습니다.
3-2. 반성문 작성 프롬프트
실수가 확인되면 이 프롬프트를 던졌습니다.
방금 발생한 문제를 반성문 총괄표 서식에 맞추어 작성해 주십시오.

[작성 규칙]
1. 변명·완충 표현 금지.
   "~할 수도 있었습니다", "일부 상황에서는" 같은 표현을 쓰지 마십시오.
   무엇을 잘못했는지만 쓰십시오.

2. 낭비 시간을 반드시 추정치라도 적으십시오.
   정말 모르면 "미확인"이라고 쓰되, 공란은 안 됩니다.

3. 실수를 하나로 뭉뚱그리지 말고 번호를 매겨 분리하십시오.
   하나의 사고에는 보통 실수가 3~7개 들어 있습니다.

4. 근본 원인을 흐름도로 그리십시오.
   [출발점] → [1차 실수] → [2차 실수] → [각성]
   "확인을 안 했다"는 표면 원인입니다. 왜 확인을 안 해도 된다고
   판단했는지까지 내려가십시오.

5. ★ 가장 중요 — 기존 총괄표를 먼저 읽고,
   이번 건이 기존 패턴 중 어디에 해당하는지 판정하십시오.
   - 기존 패턴 재발이면: 해당 패턴 번호와 "N회째 위반"을 명시
   - 새 유형이면: 신규 패턴 번호를 부여하고 신설 사유를 쓰십시오
   신규 패턴을 남발하지 마십시오. 기존 패턴에 넣을 수 있으면 넣으십시오.

6. 재발 방지 체크리스트는 □ 체크박스 형식으로,
   다음 작업 때 그대로 복사해 쓸 수 있는 문장으로 쓰십시오.
   "주의하겠습니다" 같은 다짐은 체크리스트가 아닙니다.
5번이 이 프롬프트의 전부라고 해도 됩니다.
반성문을 그냥 쓰게 하면 매번 새 반성문이 하나 늘어날 뿐입니다. "기존 패턴 중 어디냐, 몇 번째냐"를 강제로 판정시키면 그때부터 누적 데이터가 됩니다. "패턴 4의 6회째 위반"이라고 적히는 순간, 그건 개별 사고가 아니라 구조 문제로 보이기 시작합니다.
그리고 "신규 패턴을 남발하지 마십시오"를 넣었는데도 결국 중복 패턴이 생겼습니다. 이건 4-6에서 다루겠습니다.
3-3. 세션 시작 프롬프트 — 이게 실질적인 방어선
반성문을 쌓아만 두면 소용이 없습니다. 매 세션 시작 때 읽히는 구조를 만들었습니다.
작업 시작 전, 반드시 먼저 수행하십시오.

1. project_knowledge_search("Claude 반성문 실수")로 과거 실수를 확인하십시오.

2. 오늘 하려는 작업이 다음 중 하나에 해당하면,
   해당 반성문의 재발 방지 체크리스트를 먼저 출력하고 시작하십시오.
   - DB 스키마를 건드리는 작업        → 제27·30호
   - 기존에 작동하던 코드를 수정      → 제12·25·26·29·32호 (패턴4)
   - docx 표 레이아웃                → 제33호
   - 역법·절기 데이터                → 제6·13호

3. 체크리스트를 출력만 하지 말고, 각 항목을 실제로 수행한 뒤
   결과를 보고하십시오.
3번을 붙인 이유가 있습니다. 초기에는 체크리스트를 예쁘게 출력해놓고 정작 확인은 안 하고 넘어가는 일이 있었습니다. 출력과 수행은 다릅니다.
3-4. 총괄표 구조
개별 반성문 34건을 한 문서로 모았습니다. 구조는 3층입니다.
Claude_반성문_총괄표_v3.7.md
├── ① 전체 목록 표      : 34행 × 5열 (번호|날짜|건명|낭비시간|핵심교훈)
├── ② 최신 반성문 전문  : 제33호 상세 (상황/실패이력/해법/실수목록/원인/체크리스트)
├── ③ 반복 패턴 분석    : 패턴 1~18, 각 패턴별 사례 번호와 위반 횟수
└── ④ 버전 이력         : v1.0 ~ v3.7 (19개 버전)
①과 ③이 핵심입니다. ①은 스캔용, ③은 진단용입니다. 전문(②)은 최신 건만 싣고 나머지는 개별 파일로 뺐습니다. 전부 넣으면 문서가 비대해져서 AI가 읽다가 앞부분을 놓칩니다.
3-5. 패턴 집계 코드
패턴별 위반 횟수를 손으로 세다가 틀려서, 스크립트로 뽑게 했습니다.
python
import re
from collections import Counter
from pathlib import Path

md = Path("Claude_반성문_총괄표_v3_7.md").read_text(encoding="utf-8")

# ── ① 전체 목록에서 낭비 시간 집계 ─────────────────────────
#    "4.5시간", "40분", "1-2시간", "수 시간", "미확인" 이 섞여 있음.
#    ★ 애매한 값을 임의로 채우면 통계가 오염됩니다. 하한만 집계합니다.
def to_hours(cell: str):
    cell = cell.replace(" ", "")
    if "미확인" in cell or "수시간" in cell:
        return None                                  # 집계 제외
    m = re.match(r"([\d.]+)(?:[-~]([\d.]+))?(시간|분)", cell)
    if not m:
        return None
    low = float(m.group(1))                          # 범위면 하한 채택
    return low / 60 if m.group(3) == "분" else low

rows = re.findall(r"\|\s*\*{0,2}제([\d\-]+)호\*{0,2}\s*\|([^|]*)\|([^|]*)\|([^|]*)\|",
                  md)
hours = [(no, to_hours(t)) for no, _d, _n, t in rows]
counted = [h for _n, h in hours if h is not None]

print(f"전체 반성문      : {len(rows)}건")
print(f"시간 집계 가능   : {len(counted)}건")
print(f"집계 제외        : {len(rows) - len(counted)}건 (수 시간·미확인)")
print(f"낭비 시간 하한   : {sum(counted):.1f}시간")

# ── ② 패턴별 사례 건수 집계 ────────────────────────────────
pat_blocks = re.findall(r"### 패턴 (\d+):\s*\"?([^\"\n]+)\"?[^\n]*\n(.*?)(?=\n### |\Z)",
                        md, re.S)
for num, name, body in pat_blocks:
    cases = set(re.findall(r"제([\d\-]+)호", body))
    claimed = re.search(r"(\d+)회 위반", name + body)
    print(f"패턴 {num:>2} | 사례 {len(cases)}건 | "
          f"문서 주장 {claimed.group(1) + '회' if claimed else '-':>3} | {name.strip()}")

# ── ③ 패턴 이름 중복 탐지 — 여기서 문제가 나왔습니다 ────────
names = [n.strip() for _num, n, _b in pat_blocks]
for name, cnt in Counter(names).items():
    if cnt > 1:
        print(f"⚠️ 패턴명 중복 {cnt}회: {name}")
③번 블록은 처음부터 넣으려던 게 아닙니다. 패턴 목록을 눈으로 읽다가 같은 이름이 두 번 보여서 급히 추가했습니다. 결과는 4-6에 있습니다.
결과와 배운 점
4-1. 9개월치 집계
항목
실측
기록 기간
2025-11-25 ~ 2026-08-13 (약 9개월)
반성문 총계
34건 (제0호~제33호) + 제35호 등재 예정
도출 패턴
18개
총괄표 버전
v1.0 → v3.7 (19회 개정)
낭비 시간(하한)
약 38시간
낭비 시간은 정직하게 밝히면 하한값입니다. 32개 행 중 28건만 숫자가 있고, 4건은 "수 시간" 또는 "미확인"이라 집계에서 뺐습니다. 실제로는 40시간을 넘습니다.
38시간이면 근무일로 닷새입니다. 이걸 "AI 때문에 손해"로 읽으면 안 됩니다. AI 없이 했으면 훨씬 더 걸렸을 작업입니다. 요점은 손실의 크기가 아니라, 손실이 어디에 몰려 있는지가 보인다는 것입니다.
4-2. 단일 최대 사고 TOP 5
순위
반성문
사건
시간
1
제6호
음력 데이터 재앙 — 7개 연도 윤달 오류
6시간
2
제0호
Ruby 3.4.1 호환성 문제 반복
4.5시간
3
제12호
성공한 코드 무단 수정 (daeun_order 삭제)
4~6시간
4
제31호
통변입력기 SQL 스키마 장기 미동기화 → INSERT 전면 실패
3시간+
5
제29호
정상 버전 있는데 부분 수정만 반복
2~3시간
1·3위가 같은 성격입니다. 하나는 없는 데이터를 지어냈고(윤달 추측), 하나는 잘 돌아가는 걸 건드렸습니다. 둘 다 "확인"이라는 한 단계를 건너뛴 대가입니다.
4-3. 최다 반복 패턴
패턴
내용
위반
4
기존 코드 무단 수정 / 허락 없는 버전업
6회
1
3번 실패하면 멈추기 위반
4회
5
근본 원인 회피, 땜빵 반복
3회
12
문서와 실제 DB 불일치 미확인
3회
3
역법·데이터 추측 금지 위반
3회
AI 협업의 최대 리스크는 "AI가 못 하는 것"이 아니라 "AI가 잘 되는 걸 건드리는 것"입니다.
패턴 4가 6회로 압도적 1위인데, 내용을 보면 전부 같은 구조입니다. 새 기능을 붙이면서 기존 코드를 "정리"하거나 "개선"합니다. AI는 코드를 보면 고치고 싶어 합니다. 그런데 그 코드가 왜 그렇게 생겼는지는 모릅니다. daeun_order 컬럼은 대운 순행·역행 판정에 쓰이는데, 겉보기에는 안 쓰이는 것처럼 보였을 겁니다.
그래서 프로젝트 원칙에 이 문장을 박아 넣었습니다.
기능 추가 시 기존 기능 전체 유지. 성공한 코드는 건드리지 않는다.
4-4. 제33호 — 9회 연속 실패의 기록
가장 아픈 건이라 별도로 씁니다.
워드 문서에서 "헤더와 내용이 다른 페이지로 갈라졌으니 내용을 헤더 쪽으로 당겨달라" 는 요청이었습니다. Claude는 이걸 정반대로 해석해서, 헤더 앞에 강제 페이지 브레이크를 넣어 헤더를 다음 페이지로 밀어냈습니다. 결과적으로 앞 페이지의 95%가 빈 공간이 됐습니다.
버전
시도
결과
v4
keepNext+cantSplit+keepLines 3중
고아 헤더 0 / 빈 페이지 3
v5
keepLines 제거
변화 없음
v6
cantSplit 제거
변화 없음
v7
widowControl=false 추가
변화 없음
v8
<w:tblHeader/>
빈 페이지 0 / 고아 헤더 15
v9
제1장 구조 복제
LibreOffice에선 깨져 보임
v10
강제 페이지 브레이크 삽입
🔴 요청과 반대 방향
v11
페이지 브레이크 제거
고아 헤더 17
v12
4중 조합
✅ 고아 0 / 빈 페이지 0
아홉 번입니다. "3회 실패하면 멈춘다"는 원칙이 이미 문서에 있었는데도 아홉 번을 갔습니다.
여기서 배운 게 세 가지입니다.
① 방향성 동사는 반드시 되물어야 합니다. 당기기/밀어내기, 늘리기/줄이기, 올리기/내리기. 이런 단어가 들어간 요청은 AI가 방향을 뒤집어 이해해도 문장이 자연스럽게 읽힙니다. 그래서 스스로 못 잡습니다.
② 단일 속성 시도를 반복하는 건 진전이 아닙니다. v5·v6·v7이 전부 "속성 하나씩 빼보기"였습니다. 세 번 해봤으면 접근 자체를 바꿨어야 합니다. 정답은 4개 속성의 조합이었습니다.
③ 검증 환경이 다르면 검증이 아닙니다. Claude는 LibreOffice로 PDF를 뽑아 확인했는데, 제 실제 환경은 MS Word입니다. AI가 "확인했습니다"라고 할 때, 무엇으로 확인했는지를 물어야 합니다.
4-5. 반성문을 써도 반복됩니다 — 제28호
이게 이 기록에서 제일 중요한 발견입니다.
2026-01-10 제27호 — DB 스키마 확인 없이 추측으로 SQL 작성. 1시간+ 손실
2026-01-10 제28호 — 같은 날, 제27호 교훈을 무시하고
daeun_groups의updated_at을 미확인. 30분+ 손실
반성문을 쓴 당일에 같은 실수를 반복했습니다.
그래서 제28호의 핵심 교훈이 이렇게 적혀 있습니다. "반성문 작성 = 끝 아님. 즉시 적용."
여기서 구조를 바꿨습니다. 반성문은 쓰는 물건이 아니라 읽히는 물건이어야 합니다. 3-3의 세션 시작 프롬프트가 그래서 나왔습니다. 문서에 있다는 사실만으로는 아무 일도 일어나지 않습니다.
4-6. ⚠️ 이 글을 쓰다가 총괄표 자체의 오류를 3건 찾았습니다
발행 전에 원본을 다시 검산하다가 나온 것들입니다. 숨기지 않고 그대로 싣습니다. 이게 오히려 이 방법론의 유효성을 보여준다고 생각합니다.
① 패턴 번호 충돌
문서
패턴 18의 정의
총괄표 v3.7 (2026-04-22)
"교수님 실제 환경 미준거"
헤르메스 문서 (2026-08-13)
"기능명과 실제 동작의 불일치 미검증"
같은 번호에 다른 패턴이 두 개 붙어 있습니다. 넉 달 간격으로 서로 다른 세션의 AI가 각각 "패턴 18 신설"을 선언한 결과입니다. 3-2 프롬프트에 "기존 총괄표를 먼저 읽으라"고 넣어뒀는데, 최신 버전을 안 읽으면 이렇게 됩니다.
② 결번
제33호 다음이 제35호입니다. 제34호가 없습니다. 총괄표 머리말에는 "결번 없음"이라고 적혀 있는데, 이제 결번이 생겼습니다.
③ 집계 불일치
패턴 4는 "6회 위반"이라고 적혀 있는데, 나열된 사례는 제12·25·26·29·32호로 5건입니다. 한 건이 어디로 갔는지 추적되지 않습니다.
여기서 얻은 교훈이 이 글 전체의 결론입니다. 실수를 기록하는 문서도 실수를 합니다. 그리고 그 실수는 기록하는 사람(또는 AI)이 자기 문서를 검산하지 않으면 영원히 안 보입니다. 제 프로젝트에는 「문서 ≠ 사실」이라는 원칙이 있습니다. 문서에 적힌 수치는 실측 전까지 미확정으로 취급한다는 뜻입니다. 그 원칙을 정작 반성문 문서 자신에게는 적용하지 않고 있었습니다.
4-7. 꿀팁 — 따라 하실 분께
① 서식을 먼저 고정하십시오. 특히 "낭비 시간" 필드
이거 하나가 반성문을 감정에서 데이터로 바꿉니다. 모르면 "미확인"이라고 쓰되 공란은 절대 두지 마십시오. 공란이 하나 생기면 그 다음부터 전부 공란이 됩니다.
② "몇 번째 위반인가"를 강제로 판정시키십시오
프롬프트에서 딱 한 줄만 고르라면 이겁니다. 새 반성문을 쓰게 하지 말고, 기존 패턴에 매칭시키십시오. 매칭이 누적돼야 "패턴 4, 6회"라는 진단이 나옵니다.
③ 체크리스트는 □ 형식으로, 복사해서 쓸 수 있게
"주의하겠습니다"는 체크리스트가 아닙니다. "작업 전 \d 테이블명으로 스키마 확인" 이 체크리스트입니다. 동사가 있고, 바로 실행 가능해야 합니다.
④ 세션 시작 시 검색을 강제하십시오
project_knowledge_search("Claude 반성문 실수")AI는 세션이 바뀌면 지난 실수를 모릅니다. 매번 읽히게 하지 않으면 문서는 장식입니다. 제28호가 그 증거입니다.
⑤ AI가 "확인했습니다"라고 하면, 무엇으로 확인했는지 물으십시오
제33호의 LibreOffice/MS Word 건입니다. AI의 검증 환경과 내 환경이 다르면, 그 검증은 나에게는 무효입니다.
⑥ 반성문 문서 자체를 주기적으로 검산하십시오
4-6이 그 사례입니다. 번호 충돌, 결번, 집계 불일치. 월 1회 스크립트로 돌리면 30초면 나옵니다.
4-8. 시행착오
① 초기 반성문은 변명이 절반이었습니다
처음 몇 건은 "~한 상황에서는 그렇게 판단할 수도 있었으나" 같은 완충 표현이 가득했습니다. 읽어도 뭘 잘못했는지 모릅니다. 그래서 프롬프트에 "변명·완충 표현 금지" 를 1번 규칙으로 못 박았습니다.
② 패턴을 남발했습니다
18개 중 실질 중복이 두 쌍 있습니다.
패턴 1("3번 실패하면 멈추기")과 패턴 8("3번 실패 시 멈추기") — 사실상 같은 것
패턴 6("환경 정보 먼저 확인")과 패턴 10("환경 정보 먼저 확인" 연장) — 사례가 둘 다 제23호 하나
실질 패턴은 18개가 아니라 16개입니다. 프롬프트에 "신규 패턴을 남발하지 마십시오"를 넣었는데도 이렇게 됐습니다. 세션이 바뀌면 AI가 기존 패턴 목록을 끝까지 안 읽고 새로 만드는 경향이 있습니다.
③ 낭비 시간 표기가 제각각이었습니다
"4.5시간", "40분", "1-2시간", "30분+", "수 시간", "미확인"이 섞여 있습니다. 집계할 때 파싱 코드를 따로 써야 했고, 4건은 결국 집계에서 뺐습니다. 처음부터 "분 단위 정수"로 통일했어야 합니다.
④ 개별 반성문과 총괄표의 동기화를 놓쳤습니다
개별 파일은 갱신됐는데 총괄표에 반영이 안 된 구간이 있습니다. v3.2가 버전 이력에서 통째로 빠져 있는 것도 그 흔적으로 보입니다.
4-9. 도움이 필요한 부분
① 패턴 자동 매칭 — 지금은 AI가 "이건 패턴 4입니다"라고 스스로 판정하는데, 4-6에서 보셨듯 틀립니다. 새 반성문 텍스트와 기존 18개 패턴 설명을 임베딩 유사도로 비교해서 후보를 뽑는 방식을 검토 중인데, 이 정도 규모(18개 클래스, 34개 샘플)에서 임베딩 분류가 유효할지 경험 있으신 분의 조언을 구합니다.
② 다른 분들의 패턴과 비교 — 제 패턴 1위가 "기존 코드 무단 수정"이었는데, 이게 제 프로젝트 특성인지 AI 협업의 보편적 특성인지 모르겠습니다. 비슷한 기록을 하고 계신 분이 있다면 상위 패턴을 맞춰보고 싶습니다.
③ 반성문 피로도 — 34건을 넘어가니 AI가 총괄표를 읽는 데 컨텍스트를 상당히 씁니다. 오래된 반성문을 어느 시점에 아카이브할지, 기준을 어떻게 잡아야 할지 고민입니다. 그냥 지우면 재발 시 "몇 번째"를 셀 수 없게 됩니다.
5. 앞으로의 계획
5-1. 즉시 — 4-6에서 발견한 오류 정리
#
조치
1
패턴 18 번호 충돌 해소 — 후발 건을 패턴 19로 재배정
2
제34호 결번 확인 — 누락분 복원 또는 "결번" 명시
3
패턴 4의 6회 vs 사례 5건 — 재검산 후 확정
4
패턴 1↔8, 6↔10 병합 → 실질 16개로 정리
5
낭비 시간 표기를 분 단위 정수로 전면 통일
5-2. v3.8 등재 — 제35호
가장 최근 건이 하필 이 주제와 정확히 맞물립니다.
제35호 — "문서에 적힌 검증을, 코드가 실제로 수행하는지 확인하지 않음"
설계 문서에는 "N6 노드가 근거를 검증한다"고 적혀 있었습니다. 실제 코드는
verified = bool(evidence)— 배열이 비었는지만 검사하고 있었습니다. 근거 없는 문장이 섞인 답변이 "검증됨"으로 통과했습니다.
수정 후 판정식은 이렇게 바꿨습니다.
python
verified = (cite_ratio == 1.000) # 문장 하나하나에 근거가 붙었는가여기서 나온 재발 방지 원칙 세 가지가 앞으로 전 프로젝트에 적용됩니다.
검증 로직은 판정식 자체를 문서에 적는다 — "검증한다"는 서술은 금지
판정표를 먼저 고정한 뒤 코드를 만진다
되돌림 스위치를 패치와 동시에 넣는다 (
HERMES_N6_STRICT=0)
5-3. 자동화 — 반성문을 시스템에 태우기
수동 기록에서 파이프라인으로 옮기는 작업입니다. 사이드카 원칙에 따라 기존 파이프라인은 건드리지 않고 별도 스키마에서 돌립니다.
hermes.run_log        — 매 실행 1행 기록 (append-only)
hermes.backlog_card   — 개선 후보 카드. 6요소 NOT NULL 강제
hermes.growth_result — 실험 기록. Keep / Discard / Crashbacklog_card가 반성문의 기계화 버전입니다. 출처로그·반복횟수·제안패치·영향범위·검증방법·되돌림 6개 필드를 NOT NULL로 강제해서, "제목 한 줄짜리 할 일"이 들어올 수 없게 막았습니다. 3-1에서 서식을 고정한 것과 같은 발상을 DB 제약으로 옮긴 것입니다.
다만 권한은 3단으로 나눠 걸었습니다.
등급
대상
실행
즉시형
로그 기록 · 카드 생성 · 리포트
Cron 자동
승인형
RAG 재분할 · 가드레일 규칙 변경
후보만 자동, 반영은 사람 승인
금지
원본 데이터 UPDATE/DELETE · 파이프라인 수정
자동화 불가
크론은 호출권이지 수정권이 아닙니다. 반성문 34건이 가르쳐준 게 정확히 이겁니다. AI에게 "고쳐도 된다"를 주면 패턴 4가 7회째가 됩니다.
5-4. 열여섯 편을 쓰고 나서
첫 편에서 절기 데이터를 모으기 시작해 여기까지 열여섯 편을 썼습니다.
돌아보면 그동안의 산출물 중 가장 쓸모 있었던 것이 반성문 총괄표였습니다. 코드는 다시 짜면 되고 데이터는 다시 모으면 되는데, "어디서 넘어지는지에 대한 기록"은 넘어져 본 사람만 가질 수 있습니다.
그래서 이 기록은 여기서 끝내지 않습니다. 5-3의 hermes.run_log가 돌기 시작하면, 지금까지 손으로 쓰던 반성문이 매 실행마다 자동으로 한 줄씩 쌓입니다. 34건은 시작 지점입니다.
38시간의 값이 거기 있다고 생각합니다.
도움 받은 글 (옵션)
지피터스 23기 에이전트 하네스 과정 — 특히 4주차 Growth Loop(Log→Backlog→Review→Patch→Verify→Repeat)와 "검증 영수증" 개념. 제가 수동으로 하던 반성문 축적이 실은 Growth Loop의 Log·Backlog 두 칸이었다는 걸 이 과정에서 알았습니다. 5-3의 사이드카 설계가 여기서 나왔습니다.
포스트모템(Postmortem) 문화 — SRE 분야의 비난 없는 사후분석(blameless postmortem). "누가 잘못했나"가 아니라 "어떤 구조가 그 실수를 허용했나"를 묻는 방식을 반성문 서식의 「근본 원인 흐름도」 필드에 차용했습니다.
Claude Projects 지식베이스 기능 — 총괄표를 프로젝트에 상주시켜 매 세션 검색되게 한 것이 제28호(같은 날 재발) 이후의 가장 큰 구조 변경이었습니다.
앞선 사례글 「LLM 4종에게 106년치 입춘 시각을 물었더니」 — 그 글에서도 "프롬프트 원문을 안 남겼다"는 같은 종류의 기록 실패를 고백했습니다. 두 글을 같이 보시면 패턴이 보이실 겁니다.
